扩散模型路线之争可以停了?Latent‑Pixel混合扩散生成新范式上线 | ECCV'26 (opens in a new tab)
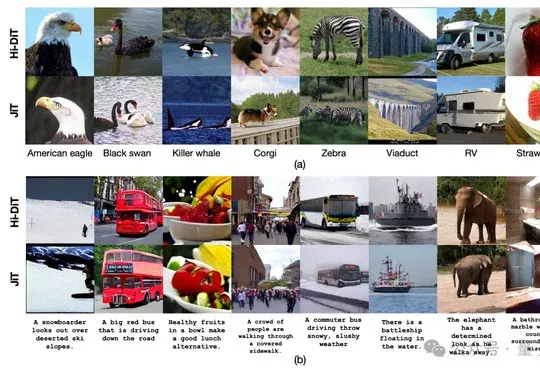
中科大与智象HiDream.ai团队提出Hi-DiT,采用时间门控机制在共享Transformer中分阶段协调Latent与Pixel双流以兼顾生成效率与细节保留,在ImageNet 256×256上达到1.06 FID,论文已被ECCV 2026接收。
Total 19 articles
中科大与智象HiDream.ai团队提出Hi-DiT,采用时间门控机制在共享Transformer中分阶段协调Latent与Pixel双流以兼顾生成效率与细节保留,在ImageNet 256×256上达到1.06 FID,论文已被ECCV 2026接收。
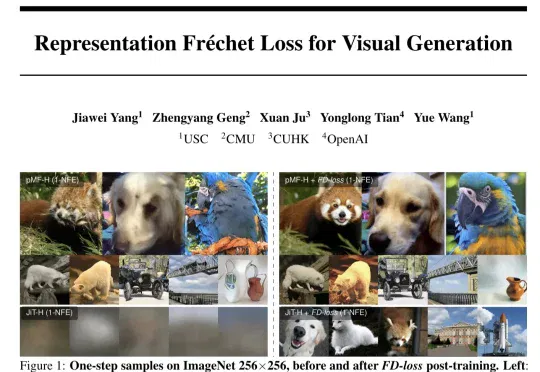
来自USC、CMU、CUHK和OpenAI的全华阵容研究团队,提出了一种叫FD-loss的方法,把“算统计的样本池”和“算梯度的batch”彻底解耦。依靠数万张图像组成的大容量缓存队列或指数移动平均机制,稳定完成分布估算,仅针对当下小批量数据开展梯度回传。
要说真学术,还得看推特。 刚刚,谢赛宁自曝团队新作iREPA其实来自4个多月前的,一次与网友的辩论。 这场短暂的线上辩论虽然以谢赛宁被网友说服告终,但在3个多月后,居然有了意料之外的后续—— 多个团队合作,沿着这一思路写出了一篇完整的论文,而且核心框架仅需3行代码。 致谢部分还感谢了当时参与讨论的网友。 一篇推特引发的学术论文 事情是这样的。 一位网友在8月份表示: 别再痴迷于ImageNet-1K的分类分数了!自监督学习(SSL)模型应该专门为稠密任务(如REPA、VLM等)进行训练,因为这些任务真正依赖的是patch tokens中的空间和局部信息,而不是[CLS]token所代表的全局分
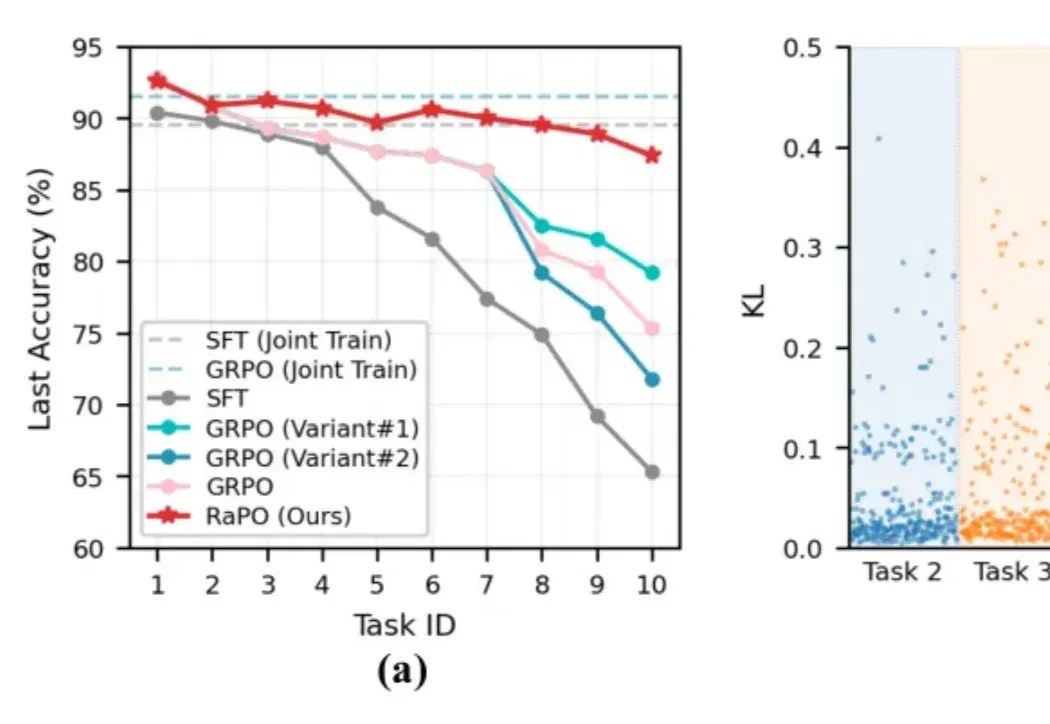
论文用轨迹级保留奖励和跨任务优势归一化,在无旧数据回放的连续视觉任务中评估微调。以 ImageNet-R 的 10 任务设定为例,报告遗忘率由标准 GRPO 的 20.02% 降到 4.69%。
2009年,李飞飞团队正式发布ImageNet。
具身智能领域论文被引次数最高的华人学者,带着十七年海外积淀,回来了。
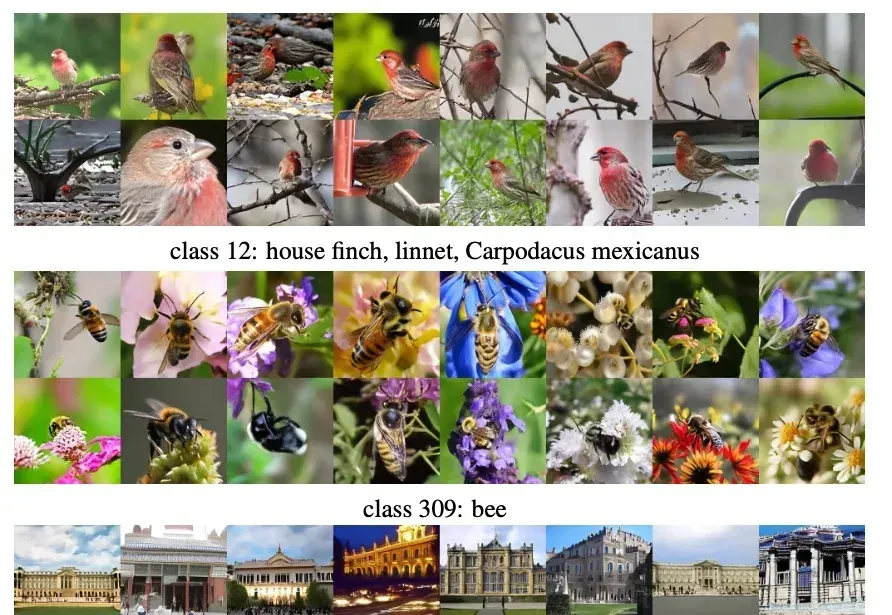
何恺明,再次出手精简架构。 新方法Pixel Mean Flow(pMF),突破传统扩散模型/流模型限制。 两大传统组件多步采样和潜空间都被砍了,现在只需一步,直接在像素空间生成图像。 在ImageNet 256×256分辨率上,pMF达到了2.22 FID;512×512分辨率上则是2.48 FID。这是目前单步、无潜空间扩散模型在该基准上取得的最佳成绩之一。 砍掉扩散模型的两大件 现代扩散模型生成图像,一直离不开多步采样和潜空间编码。 多步采样意味着生成一张图需要跑几十甚至上百次神经网络,潜空间则需要先把图像压缩到一个低维空间再进行操作。两者的共同目的是把一个极度复杂的生成问题拆解成若干个
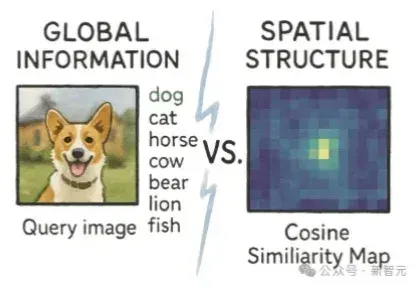
学霸的谎言被揭穿!一篇来自Adobe Research的论文发现,高语义理解并不会提升生成质量,反而可能破坏空间结构。用iREPA简单修改,削弱全局干扰,生成质量立即飙升 。
李飞飞要用ImageNet的方式,推动具身智能了。就在最近,由李飞飞团队发起、英伟达赞助(其中之一)的首届BEHAVIOR家务挑战赛正式启动。这一次,他们下定决心凝聚学术界和产业界的力量,共同向机器人做家务这一高地发起冲击。