阶跃发布Step 3.7 Flash:一款为「烧钱时代」准备的Agent模型 (opens in a new tab)
继 Step 3.5 Flash 后,阶跃星辰最近又推出新一代高效率 Flash 开源模型 ——Step 3.7 Flash。该模型最大特点就是多(模)、快(速)、好(用)、省(钱)。总参数 196B,采用稀疏 MoE 架构,推理激活参数仅 11B,配备 1.88B ViT 视觉编码器,推理速度最高 400 TPS,支持 256K 上下文。
Total 235 articles
继 Step 3.5 Flash 后,阶跃星辰最近又推出新一代高效率 Flash 开源模型 ——Step 3.7 Flash。该模型最大特点就是多(模)、快(速)、好(用)、省(钱)。总参数 196B,采用稀疏 MoE 架构,推理激活参数仅 11B,配备 1.88B ViT 视觉编码器,推理速度最高 400 TPS,支持 256K 上下文。
天下武功,唯快不破。 本周 Google I/O 大会上,谷歌发布了最新模型 Gemini 3.5 Flash。 Google I/O 大会发布 Gemini 3.5 Flash|图片来源:youtube 有趣的是,隔一天国内 Qwen3.7-Max 也发布了,并且两个模型都号称自己在 Agent 场景上做了深度优化。 我看到他们的第一反应是:又是新一轮「模型大战」,国内外厂商再次开启跑分竞赛。 但这次我花了两天时间实测之后,我发现Gemini 3.5 Flash 给我最大的感受不是它有多聪明,而是它的速度快到让我不得不重新想一个问题: 当模型的响应速度从「能用」变成「实时」,整个 Agent
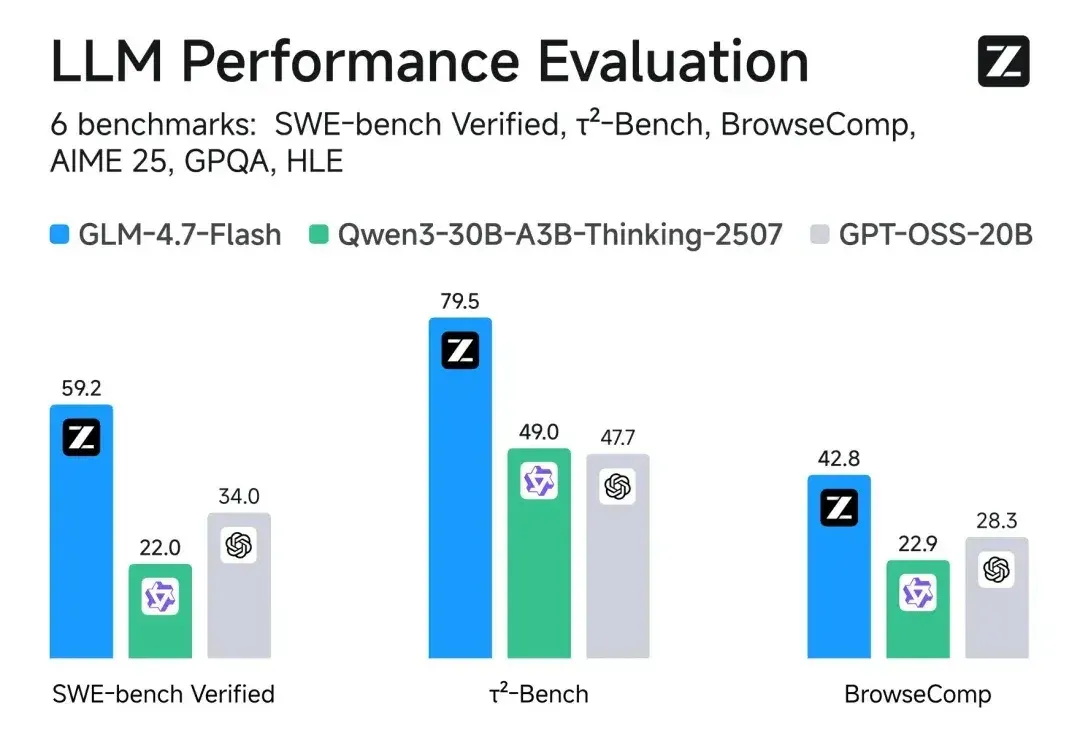
智谱AI上市后,再发新成果。 开源轻量级大语言模型GLM-4.7-Flash,直接替代前代GLM-4.5-Flash,API免费开放调用。 这是一个30B总参数、仅3B激活参数的混合专家(MoE)架构模型,官方给它的定位是“本地编程与智能体助手”。 在SWE-bench Verified代码修复测试中,GLM-4.7-Flash拿下59.2分,“人类最后的考试”等评测中也显著超越同规模的Qwen3-30B和GPT-OSS-20B。 作为去年12月发布的旗舰模型GLM-4.7的轻量化版本,GLM-4.7-Flash继承了GLM-4系列在编码和推理上的核心能力,同时针对效率做了专门优化。 除了编程
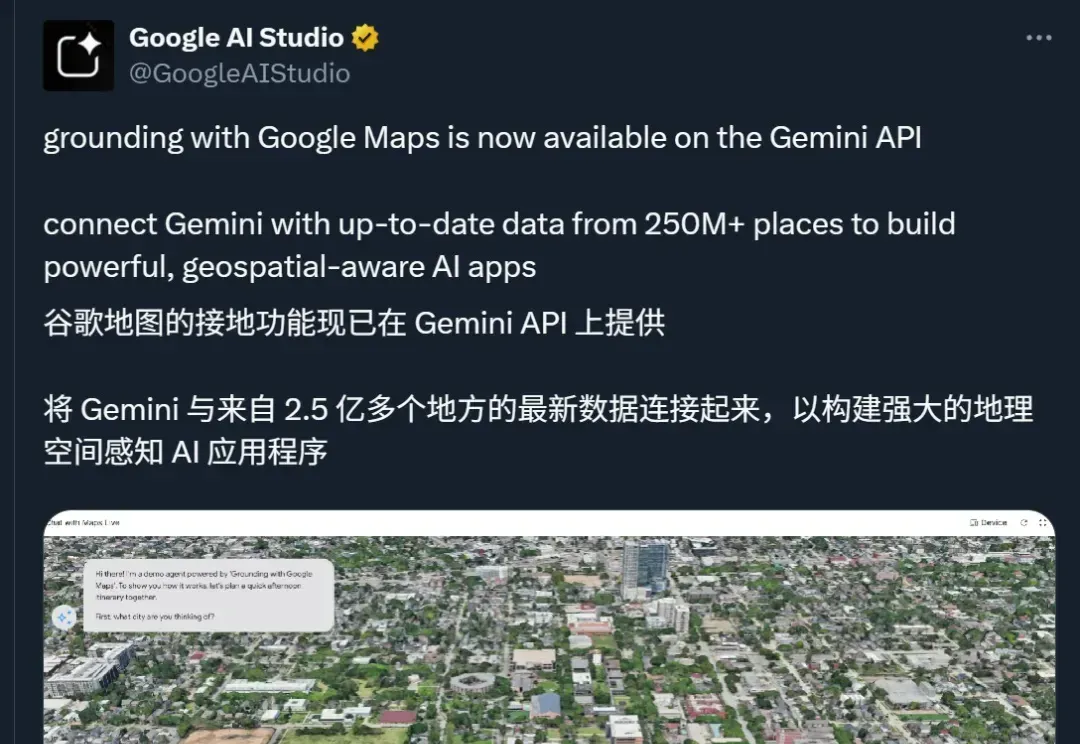
谷歌这回整了个大活儿! 即日起,所有开发者可通过Gemini API调用谷歌地图工具,以便轻松将位置感知功能整合进其应用中。 简单粗暴地说,现在但凡你的应用跟“位置”沾边,Gemini都能立刻调用谷歌地图那套庞大的地理数据库——2.5亿个地点全给它接通了。 这意味着,无论是餐馆推荐、路线规划,还是房产选址、旅行行程规划,AI都能基于实时地图数据直接回答。 根据谷歌文档,目前支持这项功能的模型包括:Gemini 2.5 Flash-Lite、Gemini 2.5 Pro、Gemini 2.5 Flash和 Gemini 2.0 Flash(但不包括2.0 Flash Lite)。 而且是基于查询
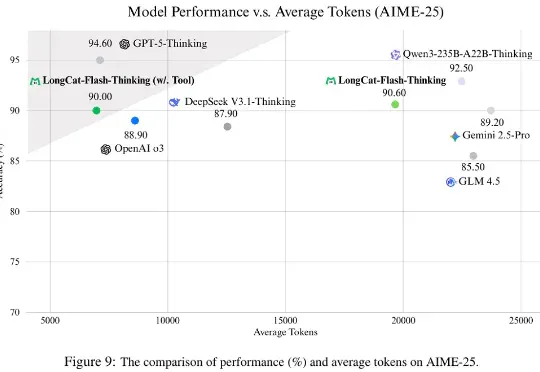
最近,美团在AI开源赛道上在猛踩加速。今天,在开源其首款大语言模型仅仅24天后,美团又开源了其首款自研推理模型LongCat-Flash-Thinking。与其基础模型LongCat-Flash类似,效率也是LongCat-Flash-Thinking的最大特点。美团在技术报告中透露,LongCat-Flash-Thinking在自研的DORA强化学习基础设施完成训练
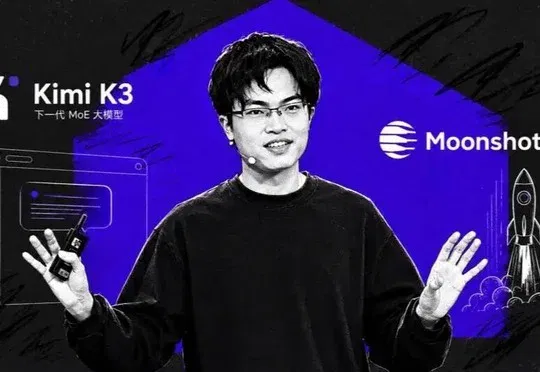
月之暗面发布2.8万亿参数后训练模型Kimi K3.1 Pro,其综合智能指数领先DeepSeek V4.1 Flash-1017和MiniMax M3.1 Flash,但API费用最高,并正研发Flash版本以平衡能力、成本与商业化。
近期,六角未来沿着 Physical Coding 的思路,进一步构建了 HexaShell-Preview。根据官方评测结果,在 RoboDojo 全部 42 项任务上,HexaShell-Preview 取得了 46.9% 的成功率、53.2 的进度得分,成功率高出第二名 7.5 个百分点,领跑 RoboDojo-Agent 榜单。
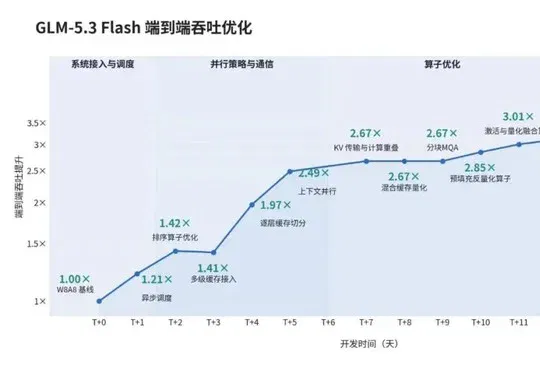
智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
43页财报一句话变带图表网页。 一款模型“好不好”,究竟该如何定义? 显然,Agent正在改变人们评价大模型的方式。过去,判断模型强不强,往往看参数规模、Benchmark成绩和上下文长度。 而在Agent时代,一款能够又快又好地解决问题、完成任务,且token花得起的模型,才是很多用户眼中的好模型。 顶级模型固然能力更强,但往往思考和执行时间长、成本高昂,而快速模型生成token很快,却容易走错路、反复尝试,甚至需要人工接手,任务完成速度根本没快多少。 用更少的计算和无效尝试,更快更好地完成任务,是如今用户对Flash级别模型的期待,也让Flash级别模型逐渐从旗舰模型的轻量版本,走向一条独

DeepSeek 突然上线限时内测模型 DeepSeek V4.1 Flash,采用新模型结构并原生支持多模态,在生成速度、使用成本和中文长文写作等实测中表现优于以往版本,DeepSeek 期望其在保持 Flash 速度与价格优势的同时,能力向 V4 Pro 靠拢。