GLM-5.3-FlashX 上线:200 tokens/s
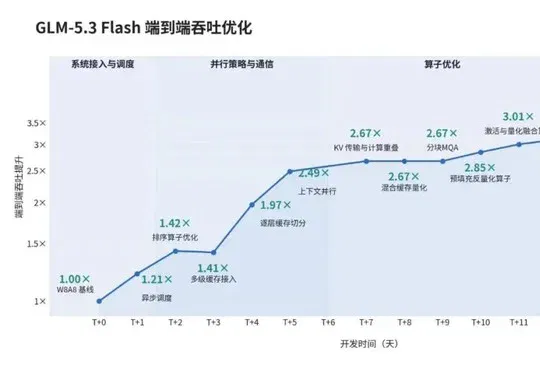
智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
智谱今天上线GLM-5.3-FlashX,推理速度最高200 tokens/s,较 GLM-5.3-Flash 模型提速 5 倍、提价 2.5 倍,API 同步开放,模型名称:GLM-5.3-FlashX
在这背后,是在10万张国产芯片提供的推理算力基础上,进一步加大对 Infra 侧的投入与推理优化
GLM 的 Infra,由 GLM 构建
跑 Flash 的这套 Infra,是由 GLM-5.3 驱动 Agent 构建的,从模型适配一路做到生产上线,前后不到两周,端到端吞吐做到了初始基线的3 倍
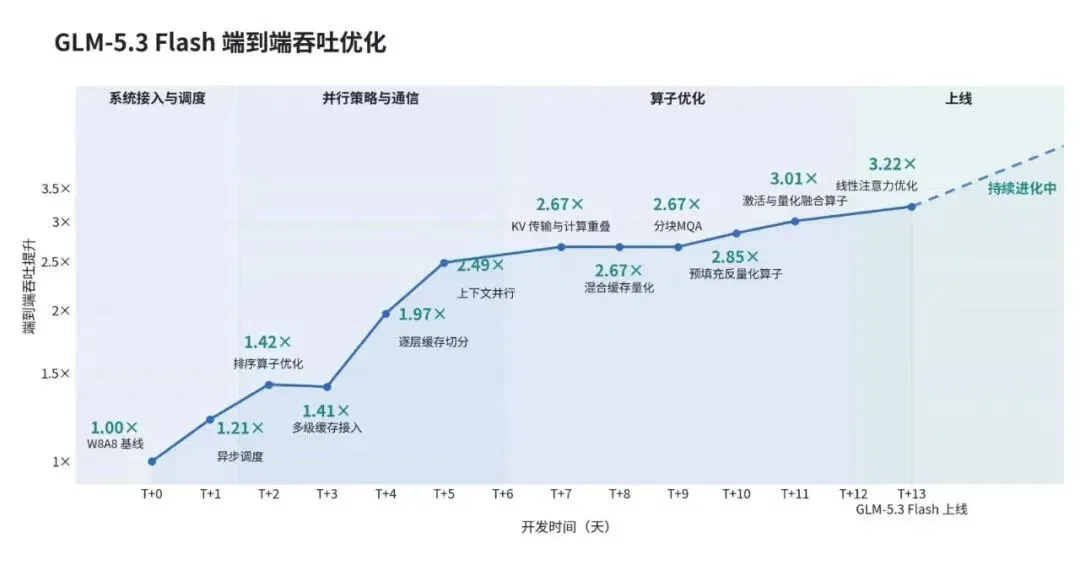
GLM-5.3-Flash 从首次运行到正式上线的性能演进
在构建的过程中,人负责定目标、设边界,搭好反馈环境,以及关键的修改审核 而对于测试、日志、Trace、微基准都接给 Agent,它自己查问题、改代码、跑实验,局部验证通过,再放回完整服务里验收,完成「稠密反馈」
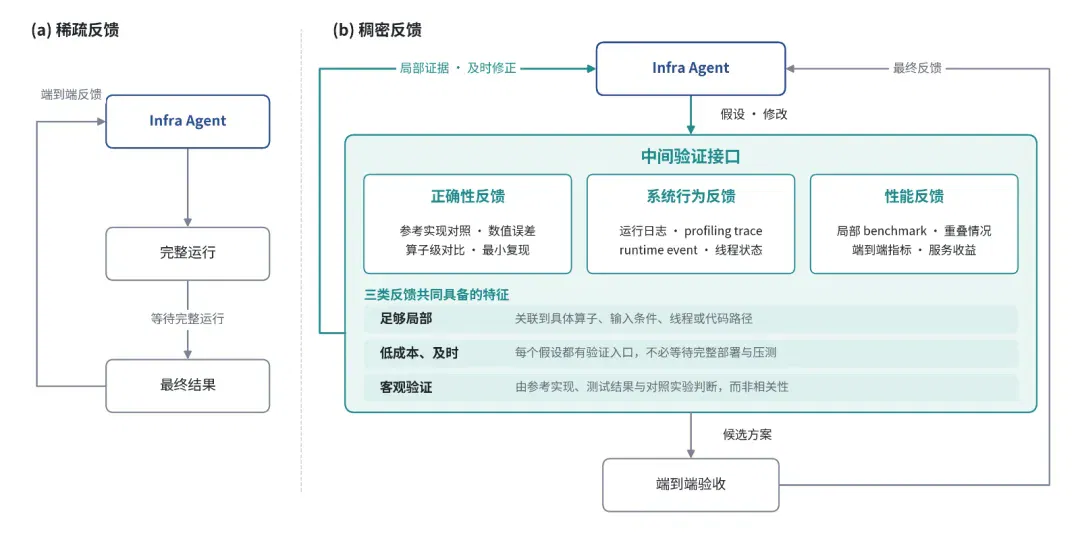
基于稠密反馈的 Infra Agent 优化闭环
下面是构建、优化这套推理系统时的三个案例。
案例一:输入是 FP32,计算却用了 TF32
KDA 的 CP 路径出了精度偏差,长上下文下尤其明显。Agent 顺着状态合并、更新的过程查下去,问题落在两处tl.dot上:输入是 FP32,计算却默认用了 TF32,误差逐步积了起来。
这两处都显式加上了input_precision="tf32x3"。修复已合入 Flash Linear Attention 上游。
案例二:KV Transfer 被 GIL 卡住了
同样的 workload,Prefill 加上传输后,与单独 Prefill 的性能差距要求不超过5%,测试却跑出了20% 以上。Agent 翻看 Trace,发现 KV Transfer 的 Python 侧执行,始终没能和 DeepEP 的 dispatch/combine 调用重叠。
再往下查,DeepEP v1.2.1 的两处 C++ 调用没有释放 GIL,负责 Mooncake Transfer 的 Python 线程拿不到锁,传输任务迟迟交不出去。改完,同样测试条件下,性能差距降到了1% 以内。
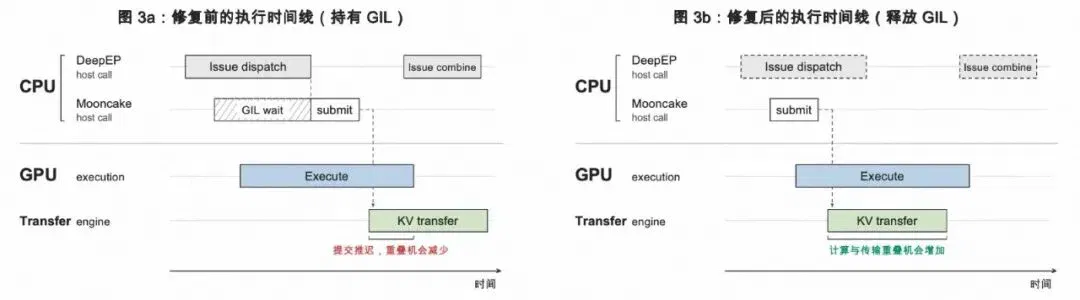
KV Transfer 并发瓶颈的排查与修复
案例三:同一组计算,做了四遍
KDA Decode 沿 V 维度分块,同一组 FP32 归一化和门控计算,被不同分块重复做了四遍。
Agent 把这些分块合到同一线程块里,提前批量计算,共享中间结果。并行度少了一些,重复计算也去掉了;这一步,算子性能提高到优化前的1.71 倍。
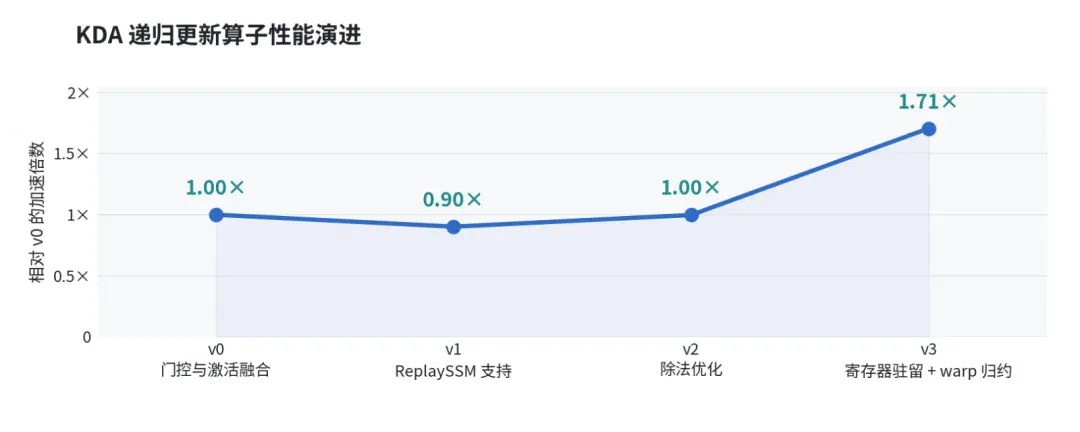
KDA Decode 算子从基础实现到生产版本的性能演进
文章来自于微信公众号 “赛博禅心”,作者 “赛博禅心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
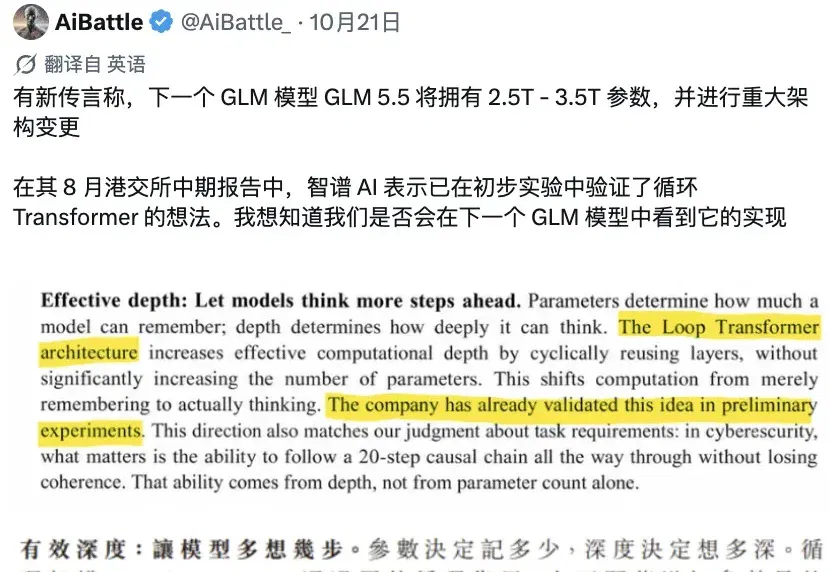
GLM-5.5最新曝光!「降智」问题3张重置卡已到位 (opens in a new tab)
GLM-5.5,真的马上就来了?! 这不嘛,网上有GLM Coding Plan用户收到官方补偿通知,原因是此前部分用户遭遇了模型「降智」问题。 但比补偿本身更有看头的,是智谱在公告里留下的一句话—— 新模型发布后,还会额外赠送一次额度重置机会哈! 好啊好啊,一份补偿通知,竟然顺手把下一代模型给剧透了。(doge) 而且巧了,最近关于GLM-5.5的爆料,也开始一波接一波冒出来了。 有小道消息称,GLM-5.5的参数规模可能达到2.5万亿—3.5万亿,比此前传闻的1.6万亿还要大上一截! 还有友友猜测,智谱此前初步验证的循环Transformer架构,会不会也用在下一代GLM上??? 这...
智谱新模型,懂法方面全球第一了 (opens in a new tab)
智谱推出法律专用开源模型GLM-Legal,可处理合同审查、证据分析和跨境合规,并在Vals AI法律测评中以19.2%的任务全通过率和86.23%的准确率位居Harvey LAB与LegalBench双榜开放权重模型榜首。
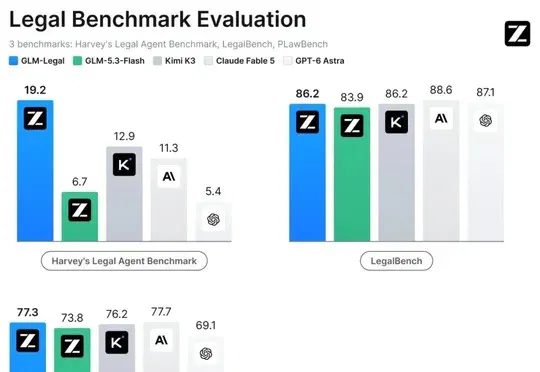
智谱发布 GLM-Legal:专攻法律的大模型,合同审查、证据梳理都能干 (opens in a new tab)
智谱旗下Z.ai发布基于GLM-5.3-Flash的法律专用模型GLM-Legal,面向合同审查、证据分析和合规研究,官方评测显示其在Harvey LAB明显领先、其余两项接近一线,目前需申请API权限且未开源。
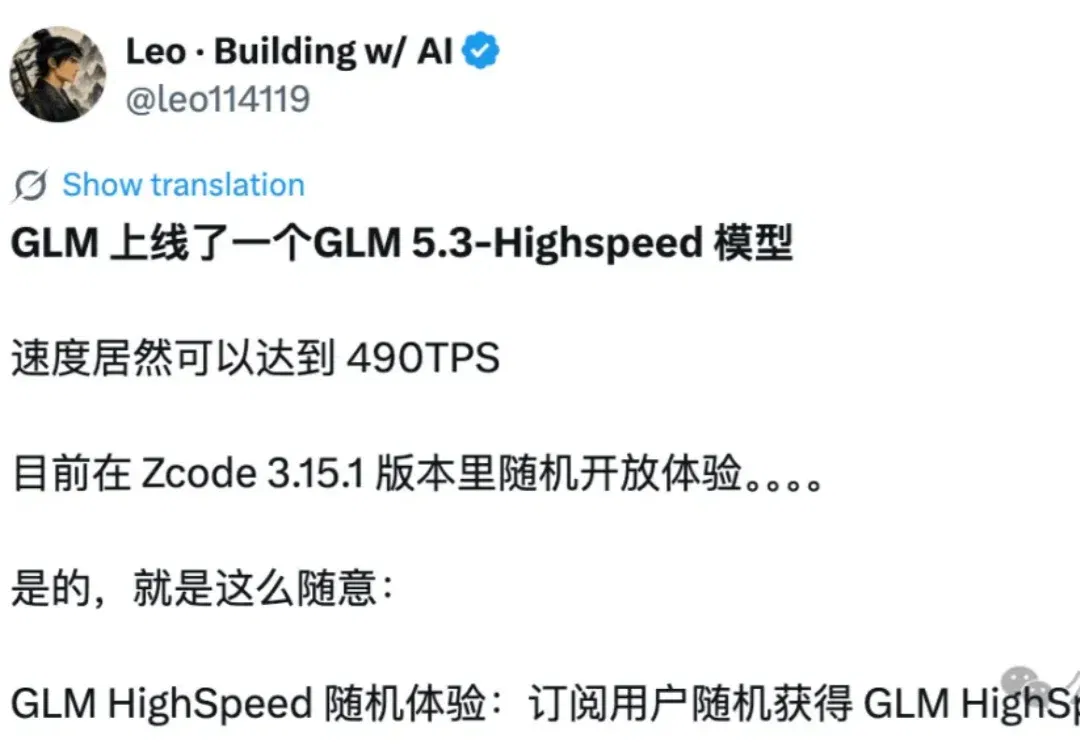
智谱新模型GLM-5.3-Highspeed,490 tokens/s! (opens in a new tab)
智谱上新了一个GLM-5.3-Highspeed模型,就在Zcode里。
开源之后再补偿,智谱 ZCode 能否重建信任? (opens in a new tab)
智谱针对ZCode数据上传争议事件公布补偿方案并将产品以Apache 2.0协议整体开源,但因开源仓库未保留事故前Git history、第三方核查覆盖范围披露有限,外界对其能否真正重建信任仍存疑问。