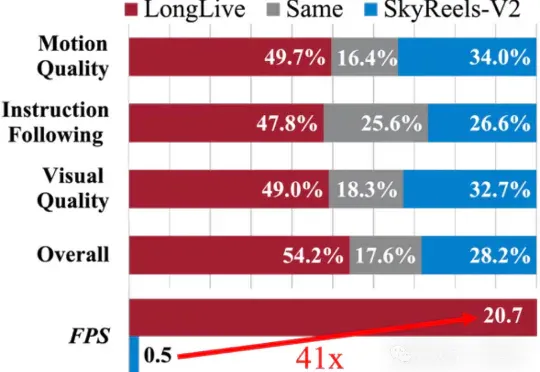
边打字边出片,交互式生成长视频!英伟达联合MIT开源新SOTA (opens in a new tab)
AI拍长视频不再是难事!LongLive通过实时交互生成流畅画面,解决了传统方法的卡顿、不连贯等痛点,让普通人都能轻松拍大片。无论是15秒短片还是240秒长片,画面连贯、节奏流畅,让创作变得像打字一样简单。
Total 37 articles
AI拍长视频不再是难事!LongLive通过实时交互生成流畅画面,解决了传统方法的卡顿、不连贯等痛点,让普通人都能轻松拍大片。无论是15秒短片还是240秒长片,画面连贯、节奏流畅,让创作变得像打字一样简单。
让想象成为画面。 AI视频这半年有一个很明显的变化,模型带来提升是重要的一点。 现在的视频创作产品里,Agent出现得很频繁,从剧本,再处理角色、场景和分镜,随后生成多集视频;通过无限画布里加入Agent,同时提供大量Skill,让创作者围绕一张画布处理素材和工作流。 视频Agent已经也很难再算一个新的方向,围绕几分钟甚至更长视频的制作流程,也已经成为不少团队关注的重点。 在这样的情况下,AZ8开始频繁出现在AI视频创作者面前。 6月份,团队推出AZ8 Theater,给AI原生短片和创作者作品提供一个展示空间。7月,AZ8 Studio开始转向Agentic Studio,并推出创作Age

现场火速实测vivago R1。 智东西9月8日报道,智象未来今日宣布,其无限时长创作智能体vivago R1正式上线。这款产品此前于7月发布,历经近两个月内测打磨后正式对外开放。 智象未来称,这是全球首个具备无限时长视频生成与编辑能力的多模态创作智能体。 据现场工作人员介绍,vivago R1可以通过Agent模式,让视频生成突破30秒的限制,一次性生成时间更长的完整视频,并提供更稳定的输出,让商业化创作更便捷、成本更低。 智东西在现场进行了简单的实测,用vivago R1创作了一段60秒的华强卖瓜鬼畜视频。 01.通用Agent轻松调用现场演示跑步视频 产品设计思路上,vivago产品负责
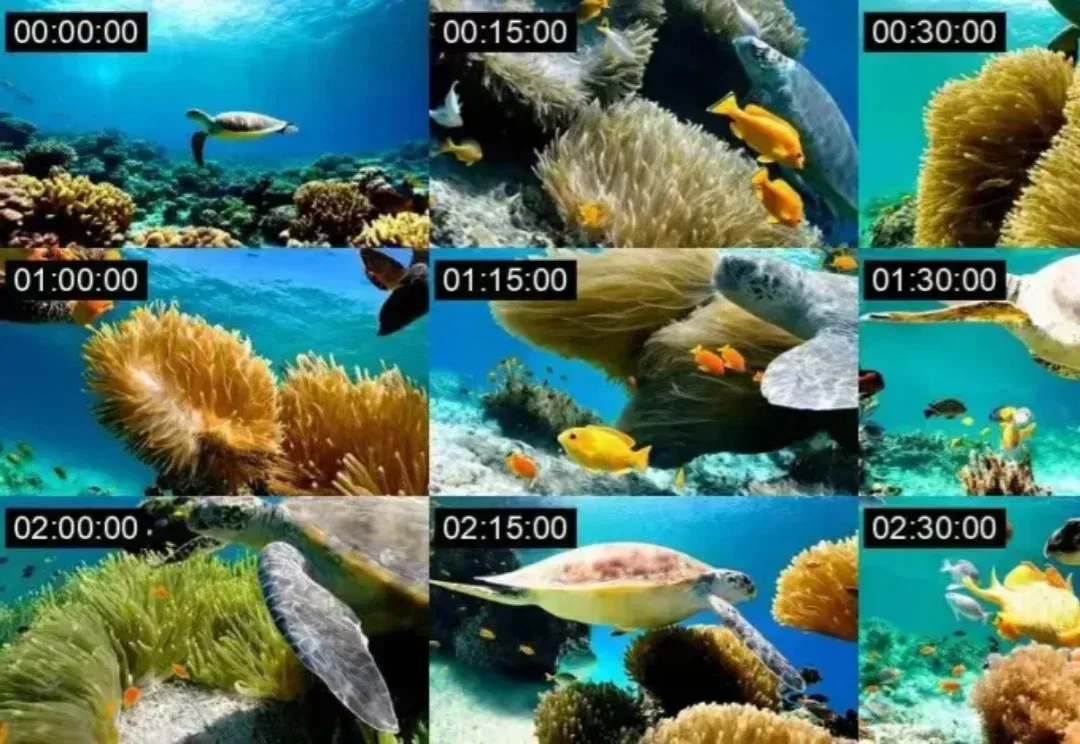
自回归视频生成越往后越崩的问题有救了! 随着视频生成向长时序演进,自回归(AR)扩散模型因其支持流式输出的特性,受到了学术界和工业界的广泛关注。然而,现有的AR生成范式在迈向“无限长”时,始终面临一个核心痛点:训推不一致导致的误差累积。这使得生成的视频越往后,时序漂移和画面崩坏问题(drift)就越严重。 为了缓解这一退化问题,现有的方法尝试了多种路径,例如模拟预测误差、引入First frame sink或者Self-rollout机制。但这些修补方案都存在各自的局限性,比如使用frame sink往往会导致视频的场景变化受到严重限制。 长时序下的漂移问题,其根源到底在哪里? 「自回归生成的
把你的想象拍成影片。 这两年,AI视频模型的进步已经很直观。几秒钟的画面可以做得很好,人物动作和镜头运动也越来越自然。 可一条作品只要达到几分钟,创作者面对的事情就会明显变多,有时候一个镜头生成得不错,并不代表接下来的几十个镜头都能顺利衔接。 十分钟左右的视频,往往要处理很多彼此关联的素材,已经确定的人物设定需要贯穿整条视频,中途改了剧情,相关片段也得重新处理。 腾讯混元最近公开的HyCreator,做的就是让Agent接手这些长时间的工作。 官方把它定义为一套面向长视频生成的Agent Harness。 用户先给出故事设定,HyCreator会继续处理脚本和分镜,再调用视频生成能力完成整套制
随着视频生成技术的发展,模型正在从短视频片段合成,向流式长视频生成演进。然而,仅仅做到视觉上的逼真是不够的。一个功能完备的视频世界模型,必须能够在长时序交互中保持稳定的内部状态,并遵循真实世界的物理定律与逻辑规则。
「建议出 480P」 从来没聊过可灵。 可灵给我的感觉,就像是老家那个县城刀枪炮同学。你对他只有个模糊的印象,知道他在特定场合很有能量,但平时办事也想不起来找他。 Be like:对的,我不像即梦一样做社交,我不像xx一样刷榜单,我只是专注服务专业创作者做专业视频的三专视频大模型一枚呀。你们普通用户对我没印象也正常的。 先前他们宣传的就是物理模拟、电影质感、长视频,反正就是暗示你,用别人家模型玩玩还行,真想做个正经片子还得找可灵。最近他们又上线了原生4K功能,可以说是继续朝着垄断商业化AI视频制作的方向显化中。 最近可灵又小火了一把,说是老外天天沉迷用它做什么韩女球场观赛视频,逼真程度又赶超英
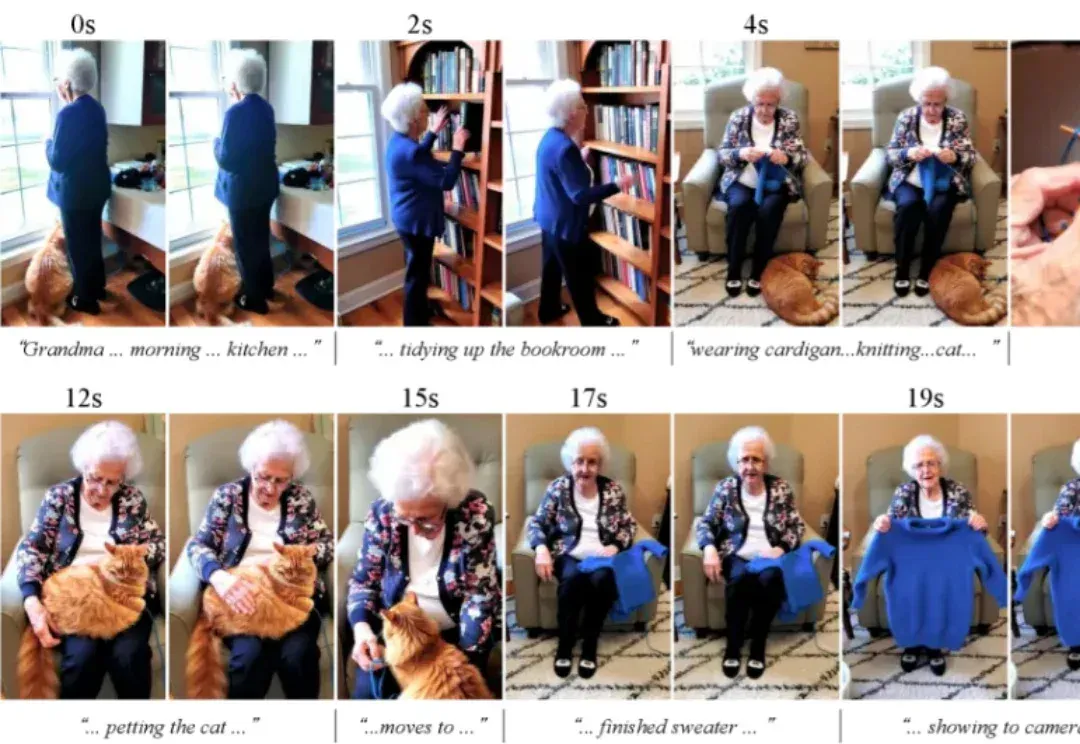
大部分的高质量视频生成模型,都只能生成上限约15秒的视频。清晰度提高之后,生成的视频时长还会再一次缩短。
“寒武纪”这个名字在AI圈里火得发烫。 由谢赛宁牵头,李飞飞和Yann LeCun站台搞的“寒武纪”,大获好评。 此寒武纪究竟是什么? Cambrian-S(寒武纪-S),不造硅基芯片,而是专注于解决AI领域一个更核心的问题:让人工智能真正学会感知世界。 它的具体成果,是一款主打空间感知的多模态视频大模型,还兼顾了通用视频、图像理解能力,在短视频空间推理中拿下了SOTA。 更厉害的是,加了预测感知模块后,连超长视频的空间任务都能扛下来——要知道,这可是很多主流模型的软肋。 这个李飞飞和LeCun都关注的空间智能领域的新模型,到底有哪些突破? 超感知:让数字生命真正体验世界 先从它的发展历程说起
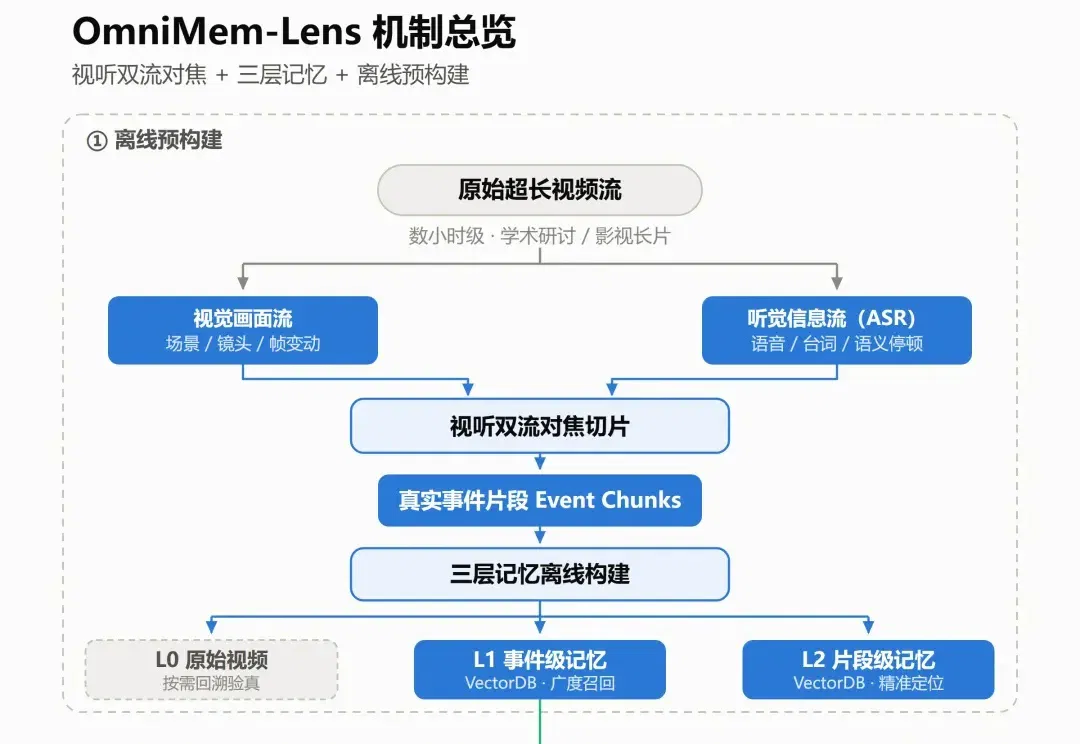
OmniMem-Lens 在 AgentMemory 0.2.0 中结合视觉变化与语音转录划分事件,并分层建立文本索引及原始视频证据。团队在三项长视频问答基准上报告精度和在线时延改善;收益依赖离线预处理,不能理解为关键事件绝不遗漏。