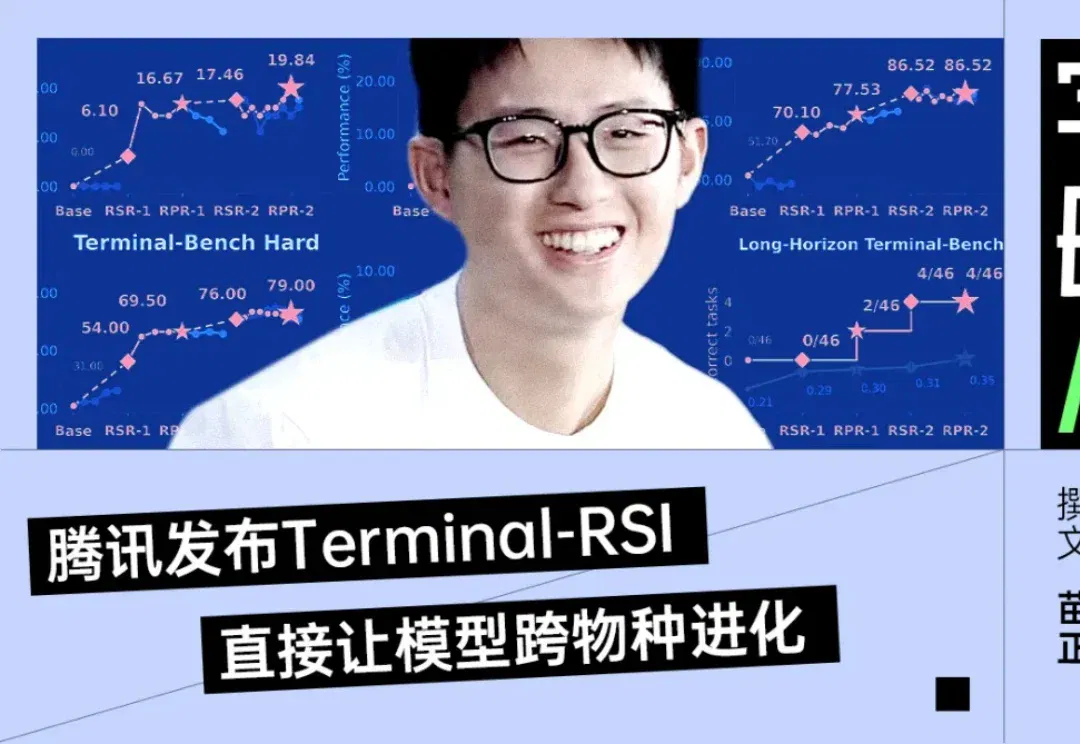
用阿里当基座,腾讯混元实现了“小RSI” (opens in a new tab)
自Hy4 Preview发布以来,它最受人关注的地方就是全链路RSI,这也是腾讯混元首个自己全程参与研发的模型。通过全链路RSI能给模型带来大幅性能提升。
Total 48 articles
自Hy4 Preview发布以来,它最受人关注的地方就是全链路RSI,这也是腾讯混元首个自己全程参与研发的模型。通过全链路RSI能给模型带来大幅性能提升。
把你的想象拍成影片。 这两年,AI视频模型的进步已经很直观。几秒钟的画面可以做得很好,人物动作和镜头运动也越来越自然。 可一条作品只要达到几分钟,创作者面对的事情就会明显变多,有时候一个镜头生成得不错,并不代表接下来的几十个镜头都能顺利衔接。 十分钟左右的视频,往往要处理很多彼此关联的素材,已经确定的人物设定需要贯穿整条视频,中途改了剧情,相关片段也得重新处理。 腾讯混元最近公开的HyCreator,做的就是让Agent接手这些长时间的工作。 官方把它定义为一套面向长视频生成的Agent Harness。 用户先给出故事设定,HyCreator会继续处理脚本和分镜,再调用视频生成能力完成整套制
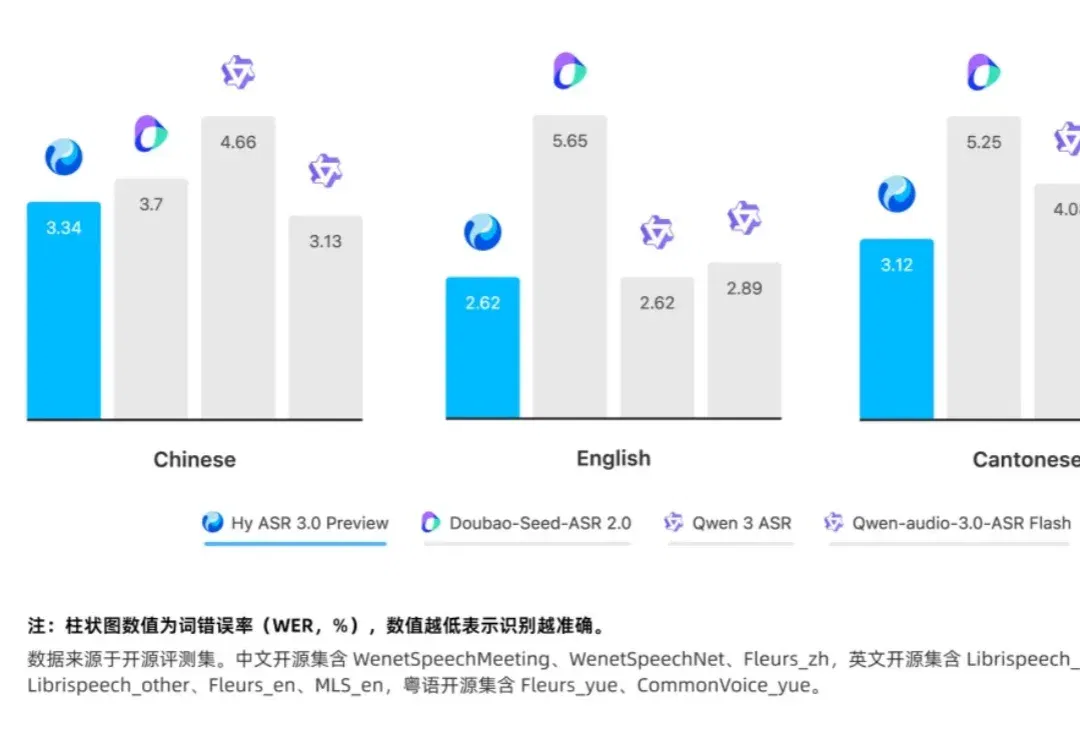
8 月 4 日,腾讯混元正式发布新一代语音识别模型 Hy ASR 3.0 preview。基于最新一代大语言模型 Hy3 的语言理解能力,Hy ASR 3.0 preview 融合高精度语音识别与深度语义理解能力,在通用识别、上下文感知、多场景鲁棒性以及方言覆盖等核心维度实现全面提升,
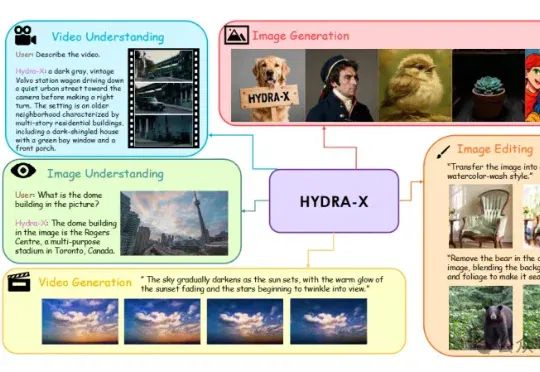
南大王利民团队&腾讯混元的HYDRA系列(HYDRA,HYDRA-X)工作挑战了这个惯例,用一个基于ViT的统一视觉Tokenizer,帮助原生多模态模型更好地“看懂”和“创作”。训练一个基于ViT的Unified Tokenizer,使其同时具有理解和生成的能力,进而同时作为理解和生成的Autoencoder,来支持原生多模态模型(Unified Multimodal Models)的训练。
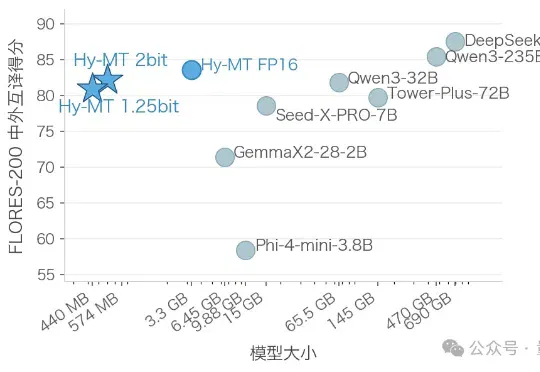
腾讯混元团队刚刚开源了一份硬核解决方案:推出极致量化压缩版本翻译模型Hy-MT1.5-1.8B-1.25bit,把支持33种语言的翻译大模型压缩至440MB。无需联网,下载后即可在手机本地运行 。官方测试显示,其翻译质量优于谷歌翻译。
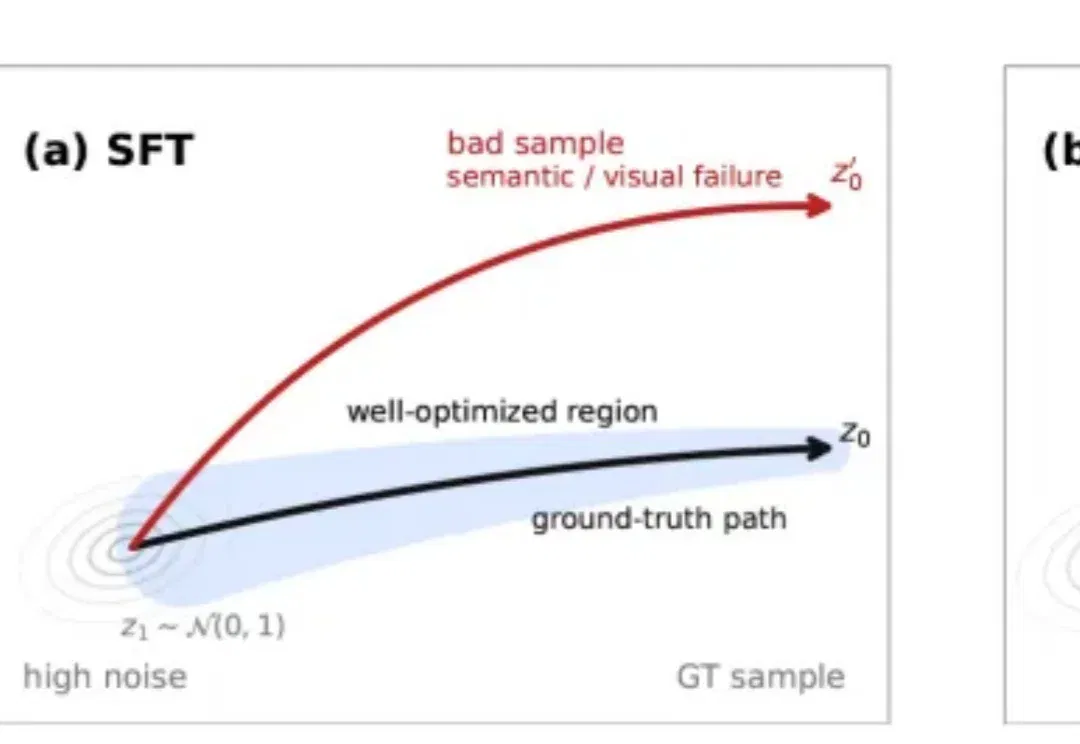
近日,腾讯混元团队提出HY-SOAR (Self-Correction for Optimal Alignment and Refinement),一种面向扩散模型和流匹配模型的数据驱动后训练方法。
3月6日,腾讯混元发布了一篇名为“HY-WU (Part I): An Extensible Functional Neural Memory Framework and An Instantiation in Text-Guided Image Editing”的技术报告。提出了一种崭新的功能性记忆(functional neural memory)范式(weight unleashing),
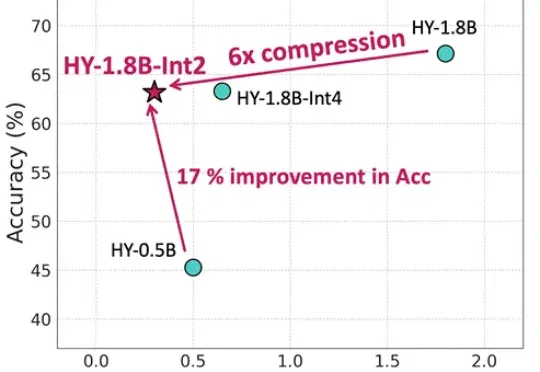
等效参数量仅0.3B,内存占用仅600MB,更适合端侧部署还带思维链的模型来了。腾讯混元最新推出面向消费级硬件场景的“极小”模型HY-1.8B-2Bit,体量甚至比常用的一些手机应用还小。
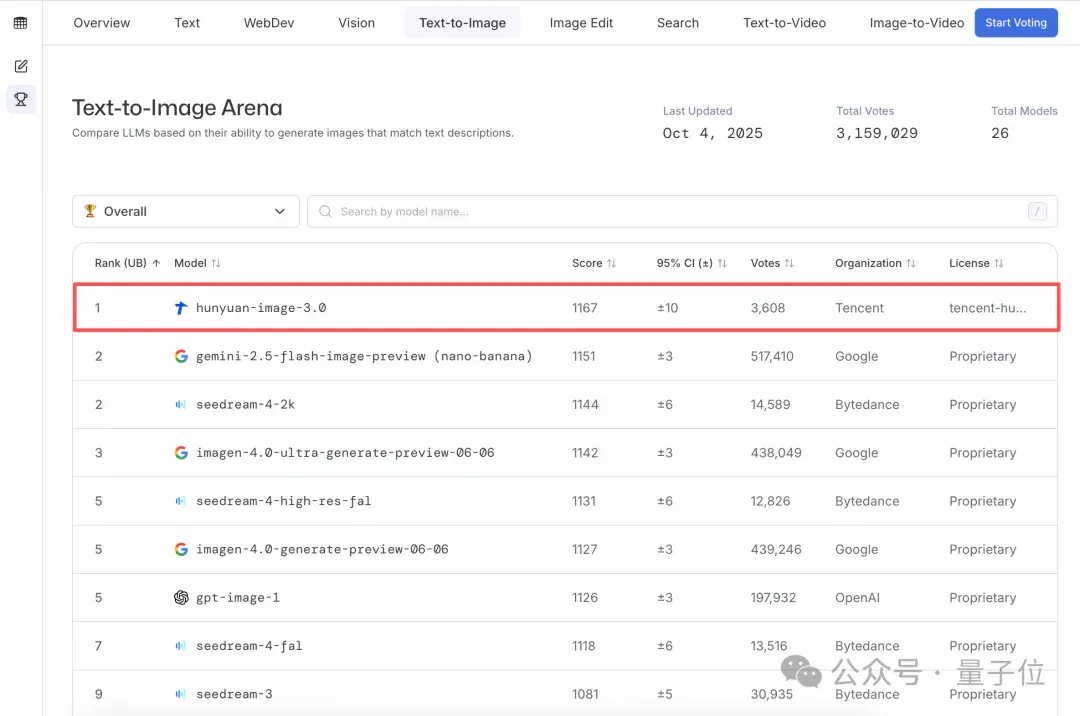
全球文生图大模型王座,易主了。就在刚刚,LMArena竞技场发布了最新的文生图榜单,第一名来自中国,属于腾讯混元图像3.0!不仅超越了谷歌的Nano Banana,也超越了字节的Seedream和OpenAI的gpt-Image,在全球26个大模型中稳居第一。
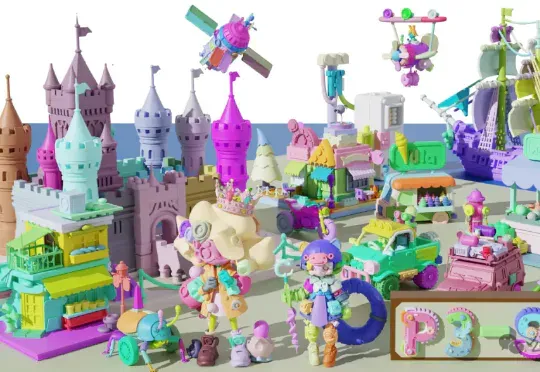
业界首个高质量原生3D组件生成模型来了!来自腾讯混元3D团队。现有的3D生成算法通常会生成一体化的3D模型,而下游应用通常需要语义可分解的3D形状,即3D物体的每一个组件需要单独地生成出来。