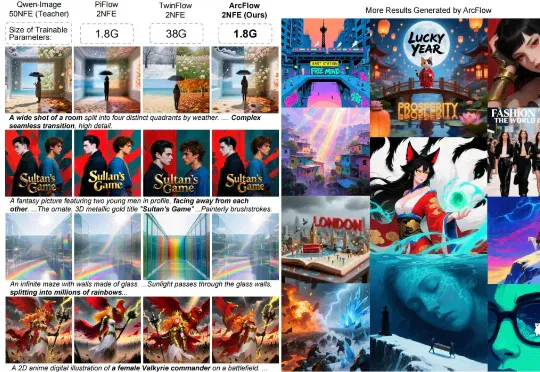
又快又省?仅5%参数、训练快4倍!ArcFlow用「非线性」魔法实现FLUX/Qwen推理40倍加速 (opens in a new tab)
复旦大学与微软亚洲研究院带来的 ArcFlow 给出了答案:如果路是弯的,那就学会 “漂移”,而不是把路修直。在扩散模型中,教师模型(Pre-trained Teacher)的生成过程本质上是在高维空间中求解微分方程并进行多步积分。由于图像流形的复杂性,教师模型原本的采样轨迹通常是一条蜿蜒的曲线,其切线方向(即速度场)随时间步不断变化。
Total 219 articles
复旦大学与微软亚洲研究院带来的 ArcFlow 给出了答案:如果路是弯的,那就学会 “漂移”,而不是把路修直。在扩散模型中,教师模型(Pre-trained Teacher)的生成过程本质上是在高维空间中求解微分方程并进行多步积分。由于图像流形的复杂性,教师模型原本的采样轨迹通常是一条蜿蜒的曲线,其切线方向(即速度场)随时间步不断变化。
千问 3.5 总参数量仅 3970 亿,激活参数更是只有 170 亿,不到上一代万亿参数模型 Qwen3-Max 的四分之一,性能大幅提升、还顺带实现了原生多模态能力的代际跃迁。
春节还没到,「过年的气氛」已经渗入科技圈每个人的毛孔。单说 AI 大模型这一块,刚刚发布的有 kimi 2.5 和 Step 3.5 Flash,即将发布的据说还有 DeepSeek V4,GPT-5.3、Claude Sonnet 5、Qwen 3.5,GLM-5,说不定一觉醒来,现有的技术就要被颠覆。
BUBBLE 2026 — ISSUE #18 家人们, 马上没几天快过年了,明显各个厂商已经开始疯狂卷了。 上周到现在,让我们来算算有多少东西了, 5.3 Codex,4.6 Opus, 可灵3.0
这个春节,中国 AI 迎来「决战时刻」。据《The Information》援引内部消息人士透露:字节或将祭出全模态三件套;阿里除了或将发布强大的全新旗舰模型 Qwen 3.5 外,也会让千问打通支付与电商,挑战豆包;DeepSeek V4 或将携最强代码能力突袭。这不仅是技术竞赛,更是对 14 亿用户生活入口与未来互联网秩序的终极争夺。
假如你是一个致力于将 AI 引入传统行业的工程团队。现在,你有一个问题:训练一个能看懂复杂机械图纸、设备维护手册或金融研报图表的多模态助手。这个助手不仅要能专业陪聊,更要能精准地识别图纸上的零件标注,或者从密密麻麻的财报截图中提取关键数据。
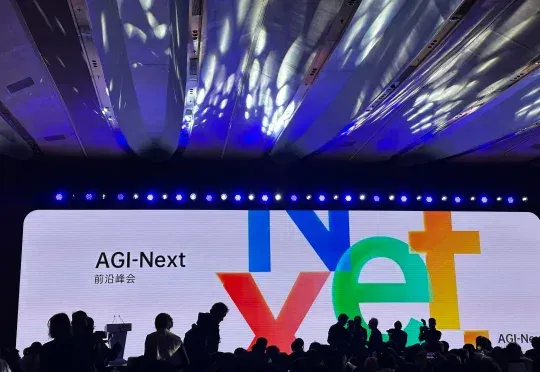
今天受邀,参加了一个非常有趣的活动,现场人真的爆满了,很多人都是从外地特意赶过来的。 这个活动,叫AGI-NEXT。 主要是几个演讲的嘉宾,过于重磅了。 开源四巨头除了DeepSeek没来,智谱的唐杰老师、Kimi的杨植麟、Qwen的林俊旸,齐聚一堂。
你知道吗,DeepSeekTwitter、Mac、Qwen,最初都只是副项目?真正改变世界的产品,可能根本不在公司的PPT路线图上。
2025最后几天,是时候来看点年度宝藏论文了。
能翻译33语种+5方言,医学术语/粤语翻译实测“能打”。