1.8B!腾讯开源新模型,1GB内存手机离线跑,媲美Qwen3-235B
能翻译33语种+5方言,医学术语/粤语翻译实测“能打”。
能翻译33语种+5方言,医学术语/粤语翻译实测“能打”。
智东西12月30日报道,刚刚,腾讯混元开源翻译模型1.5版本,共包含两个模型:Tencent-HY-MT1.5-1.8B和Tencent-HY-MT1.5-7B,支持33个语种互译以及5种民汉/方言,除了中文、英语、日语等常见语种,也包含捷克语、马拉地语、爱沙尼亚语、冰岛语等小语种。
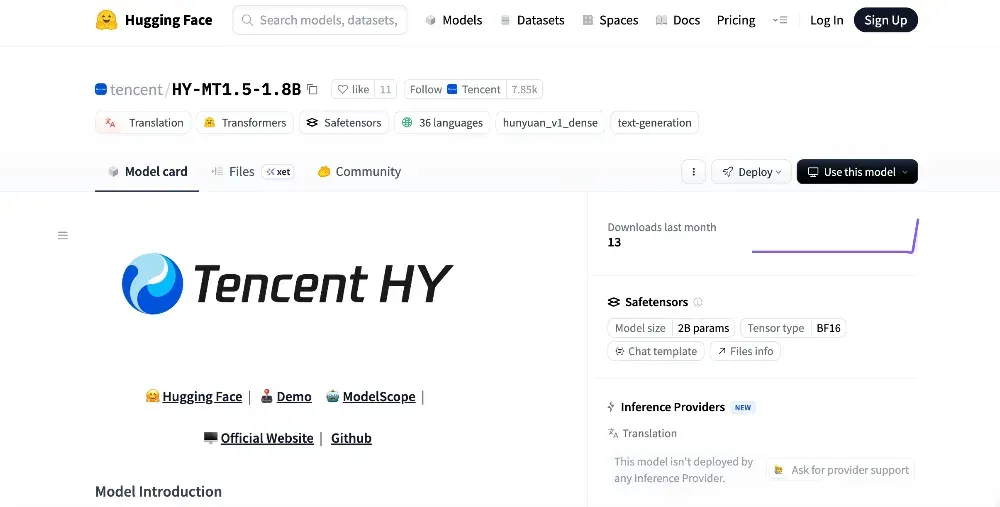
▲Tencent-HY-MT1.5-1.8B开源(来源:Hugging Face)
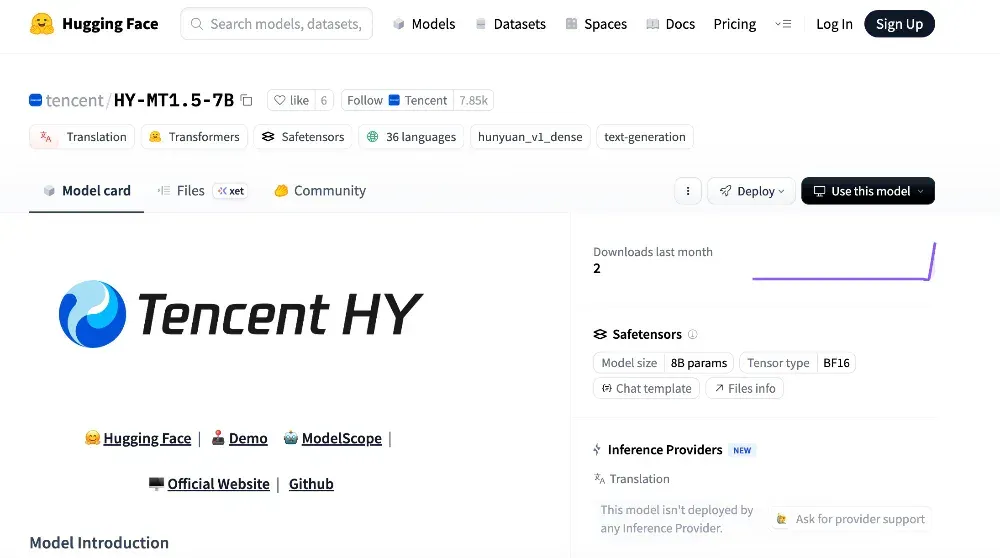
▲Tencent-HY-MT1.5-7B开源(来源:Hugging Face)
HY-MT1.5-1.8B主要面向手机等消费级设备场景,支持端侧直接部署和离线实时翻译,仅需1GB内存即可流畅运行。
HY-MT1.5-7B模型是此前获得WMT25比赛30个语种翻译冠军模型的升级版,重点提升了翻译准确率,大幅减少了译文中夹带注释和语种混杂的情况,实用性进一步增加。
在部分用户实际使用场景下,混元翻译1.8B和7B两个尺寸模型同时使用,可以实现端侧和云侧模型的协同部署,提升模型的效果的一致性和稳定性。
基准测试方面,在中外互译和英外互译测试集Flores200、WMT25以及民汉语言的测试集中,Tencent-HY-MT1.5-1.8B全面超越Qwen3-32B,与Qwen3-235B-A22B等大尺寸闭源模型成绩不相上下。
同时,在处理效率上,与主流商用翻译模型API对比,HY-MT1.5-1.8B处理50个tokens的平均耗时只有0.18秒,其他模型的时间在0.4秒左右。
技术方面,HY-MT1.5-1.8B能够用小尺寸实现大尺寸模型的效果,得益于On-Policy Distillation(大尺寸模型蒸馏)策略的引入,HY-MT1.5-7B作为Teacher,能够实时引导1.8B的Student模型,让其避免死记硬背标准答案,通过纠正在预测序列分布时的偏移,让小模型从错误中学习,进而提升能力。
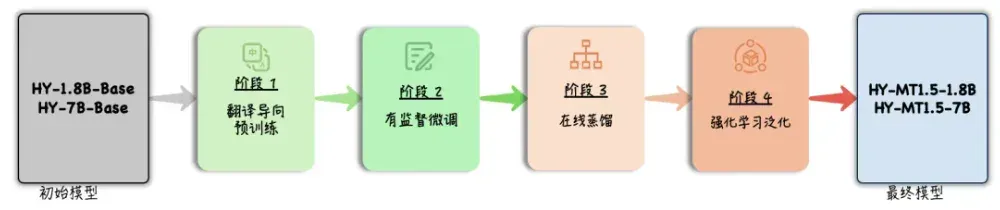
▲On-Policy Distillation(大尺寸模型蒸馏)策略(来源:腾讯混元)
目前两个模型均已在腾讯混元官网上线,在GitHub和Hugging Face等开源社区也可直接下载使用,Arm、高通、Intel、沐曦等多个平台均支持部署。
混元官网:
https://hunyuan.tencent.com/modelSquare/home/list
GitHub链接:
https://github.com/Tencent-Hunyuan/HY-MT
Hugging Face链接:
https://huggingface.co/collections/tencent/hy-mt15
01.
互译成绩超越Qwen3-32B
响应速度仅0.18秒
在常用的中外互译和英外互译测试集Flores200、WMT25以及民汉语言的测试集中,Tencent-HY-MT1.5-1.8B全面超越Qwen3-32B等中等尺寸开源模型和主流商用翻译API,达到Qwen3-235B-A22B等大尺寸闭源模型的90分位水平。
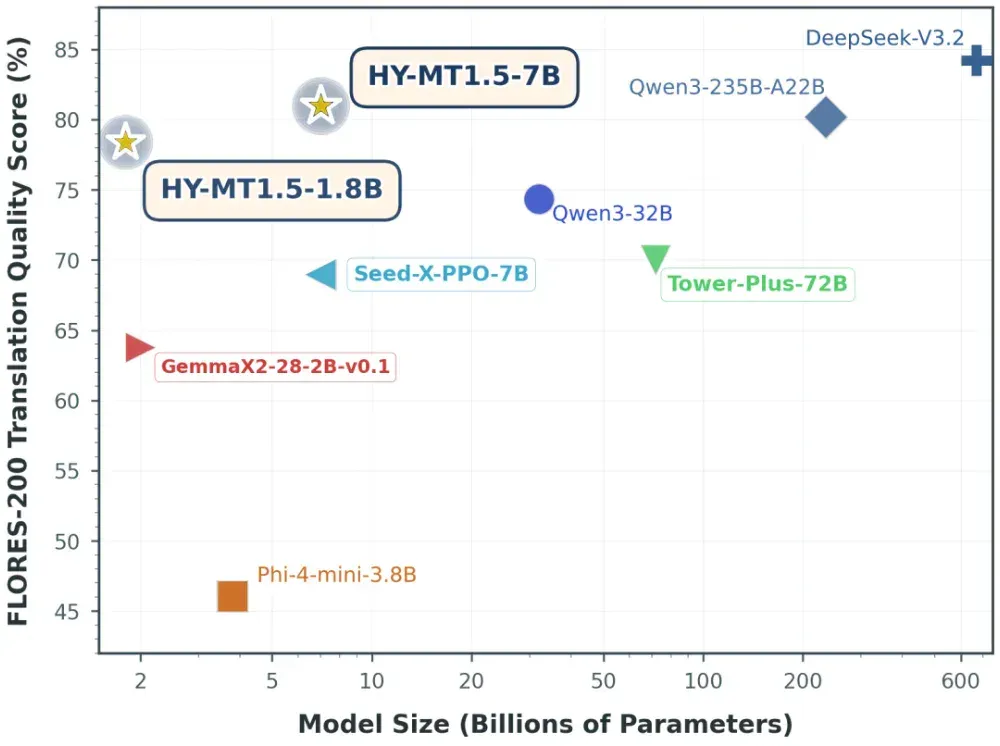
▲Flores200、WMT25以及民汉语言的测试集成绩(来源:腾讯混元)
在翻译质量与响应效率上,HY-MT1.5-1.8B模型在FLORES-200质量评估中取得了约78%的分数,同时平均响应时间仅为0.18秒,超越主流商用翻译API。
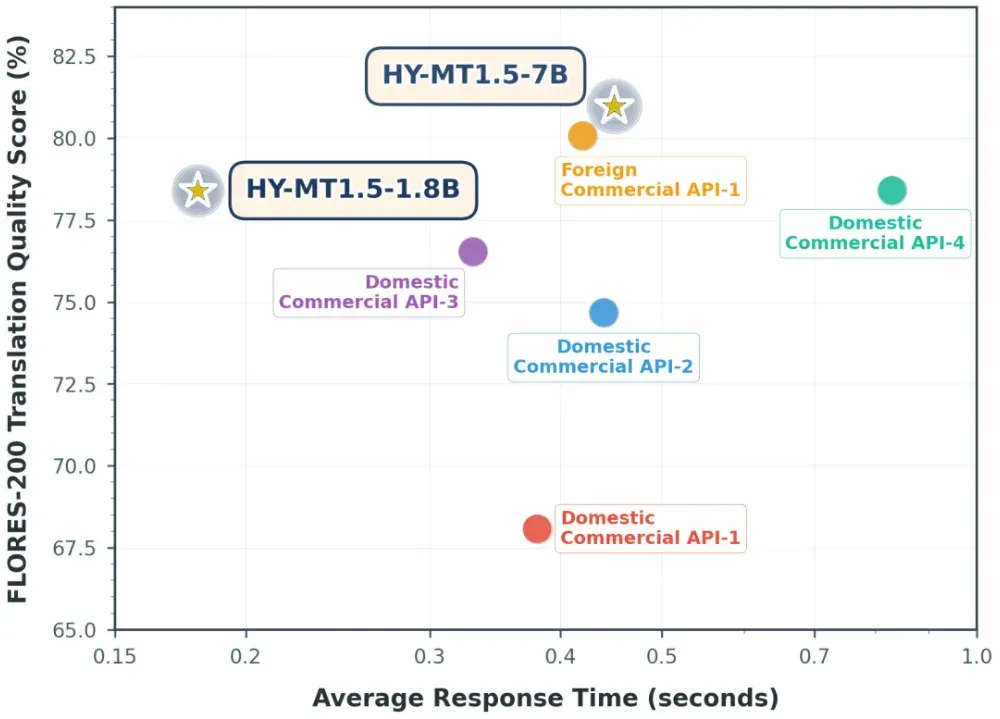
▲FLORES-200质量评估成绩(来源:腾讯混元)
02.
从术语到上下文翻译
腾讯混元翻译模型1.5
反应迅捷、准确率“能打”
凭借优化的模型设计和推理逻辑,腾讯混元翻译模型1.5适用于即时通讯、智能客服、移动翻译应用等高吞吐、实时翻译场景。
首先是术语,腾讯混元翻译模型1.5具备术语库自定义能力,用户可针对不同行业与专业场景(如医学、法律、金融、科技等)提前构建专属术语对照表,确保关键术语在翻译中保持高度一致与准确性。
这一功能有效弥补了小尺寸模型在处理专业领域文本时的词汇短板,使其在保障轻量化部署的同时,也能胜任高要求的行业翻译任务。
用户可通过简单配置导入术语库,模型将在翻译过程中优先采纳用户定义的标准术语,从而提升专业文档、技术手册、合同文本等内容翻译的可靠性与权威性。
▲术语翻译(来源:腾讯混元)
智东西也上手尝试了一下,我们上传了一系列医学术语,让其翻译成中文。在反应速度上,腾讯混元翻译模型1.5就很快输出了翻译结果,几乎没有反应时间。与原文对照看,其翻译的成果准确度为100%。
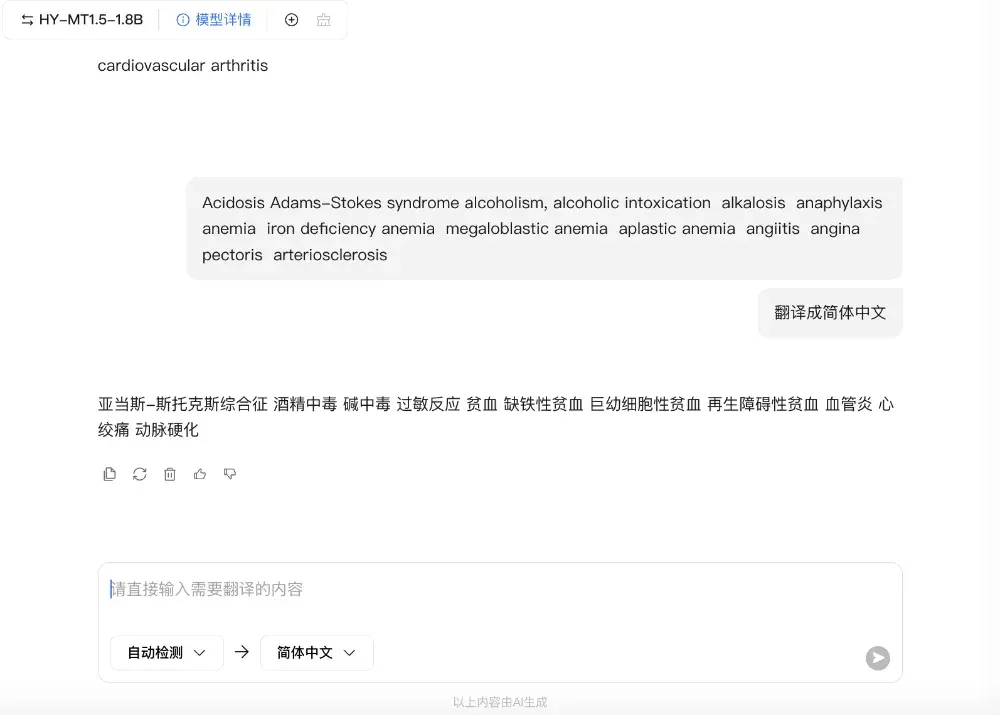
▲术语翻译(来源:智东西实测)
除了英语外,我们还上传了5句职场中高频出现的粤语对话,看看腾讯混元翻译模型1.5的方言翻译效果如何。结果显示,腾讯混元翻译模型1.5也可以很准确地翻译出粤语用词和语气,准确度同样“能打”。
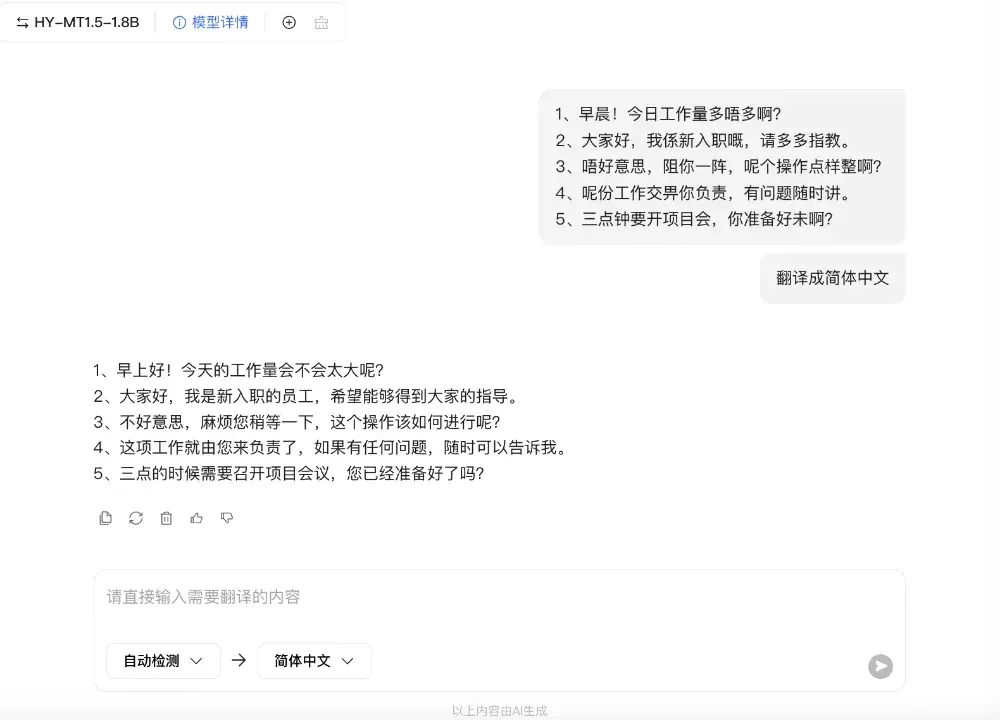
▲粤语翻译(来源:智东西实测)
其次是上下文翻译能力。该能力适用于实时对话翻译、长篇文献翻译及多轮交互场景。混元翻译模型模型具备较好的长文本与对话上下文理解能力,可基于前文语境持续优化后续翻译结果,显著提升长对话、多轮问答、连续段落等场景下的翻译连贯性与一致性。
无论是会议记录、访谈内容、小说章节还是技术文档的长篇翻译,模型均能有效捕捉并保持上下文逻辑关系,避免出现指代不清、语义断裂或风格不统一的问题。
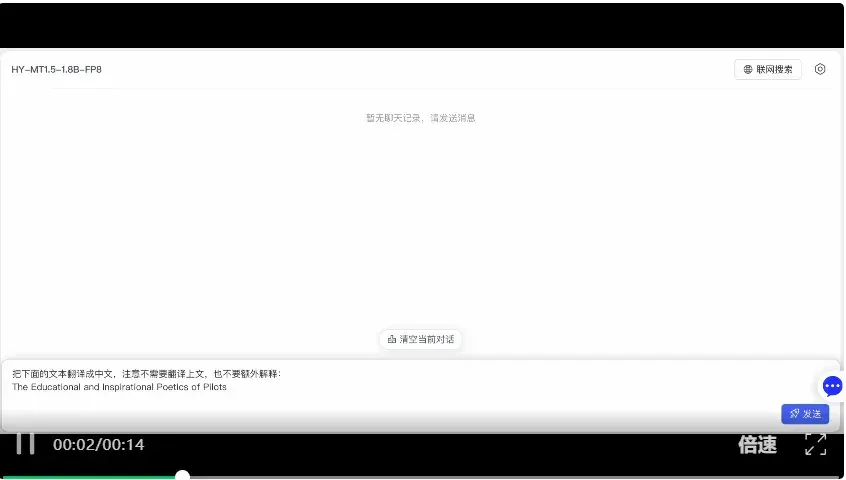
▲上下文翻译(来源:腾讯混元)
第三是,带格式翻译能力,通过精准的指令遵循能力,混元翻译模型得以保持翻译前后的格式信息不变,让翻译结果更加准确实用。
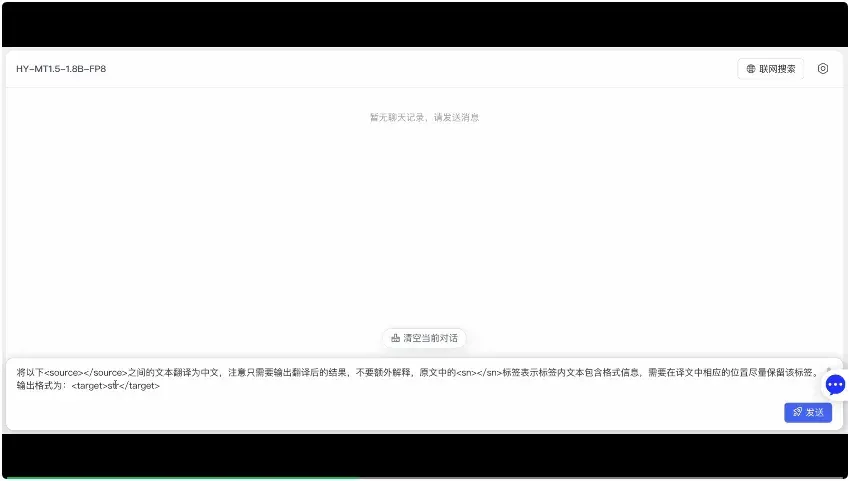
▲带格式翻译(来源:腾讯混元)
为了直观展示混元Tencent-HY-MT1.5-1.8B的翻译效果,下面展示了与苹果手机自带离线翻译的结果对比:
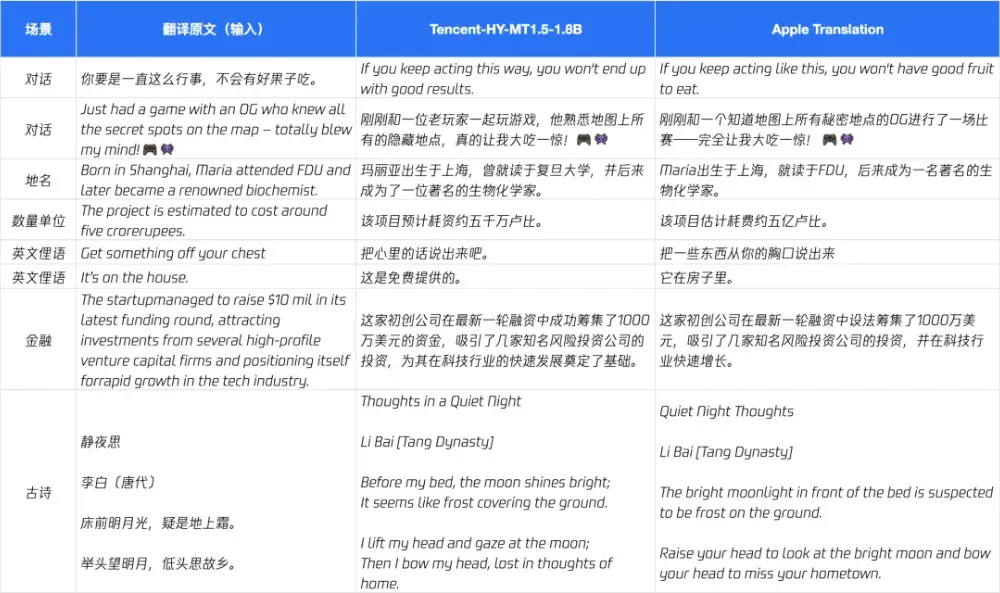
▲与苹果自带翻译对比(来源:腾讯混元)
03.
结语:腾讯开源降低了翻译模型应用门槛
腾讯此次开源的小尺寸翻译模型,降低了翻译模型在手机等终端上运行的门槛。
腾讯混元翻译模型此前不仅在国际机器翻译比赛拿下30个第1名,也在首次开源一周内便登上Hugging Face模型趋势榜第一位。
混元翻译模型已经在腾讯内部多个业务场景落地应用,包括腾讯会议、企业微信、QQ浏览器、客服翻译等。
文章来自于“智东西”,作者 “王涵”。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
蚂蚁与西湖心辰介绍Duo v1,探索全双工视听交互 (opens in a new tab)
Duo v1通过Intent与Realization模块衔接交互决策和音视频生成。文章报告30组交互、180项检查中通过168项,内容响应度为73.3%;复杂意图理解与长程一致性仍是团队后续优化方向。
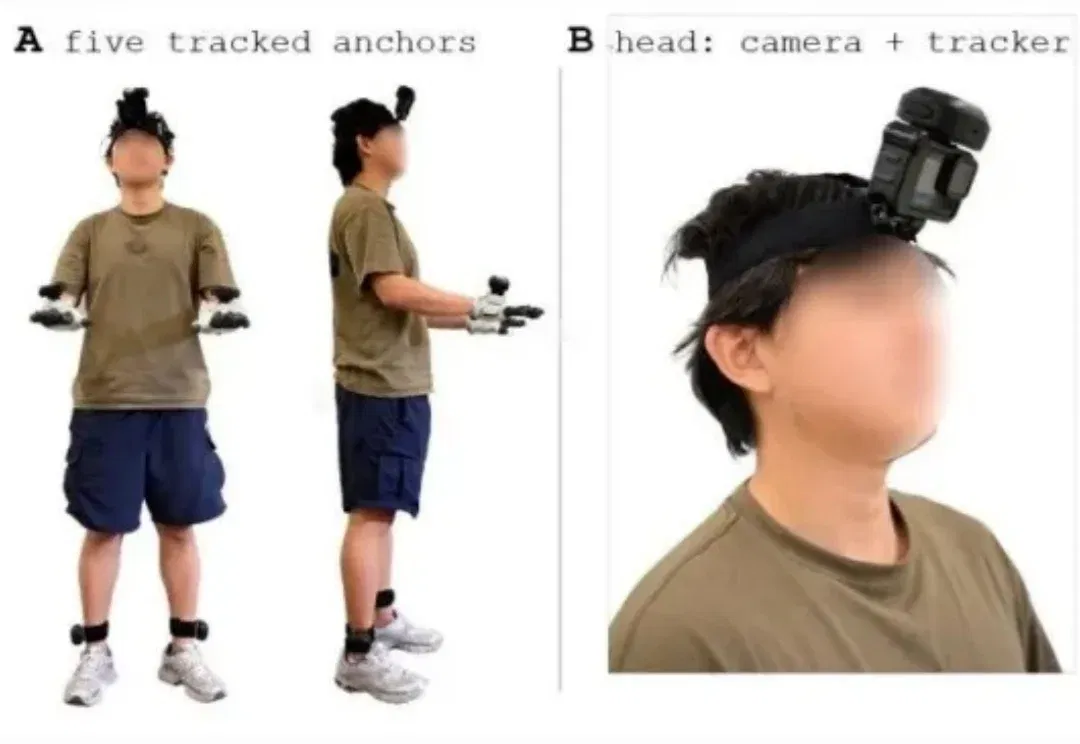
EgoExplorer captures mobile manipulation with five trackers and a camera (opens in a new tab)
Shanghai AI Lab presents a wearable capture system using trackers, gloves and a camera, plus C³ motion reconstruction, and releases 100 hours of data and code. Reconstruction and multimodal generation are assessed separately; humanoid transfer is shown only in simulation.

ConvexLLM connects speech to language models through frozen text embeddings (opens in a new tab)
Researchers at CUHK-Shenzhen and Microsoft propose C-Gate, mapping audio into convex combinations of frozen text embeddings. The paper reports VoiceBench gains against its listed open-model baselines, while audio understanding and transcription still involve trade-offs.

CWM2.0 open-sources generative rendering with a 30-minute racing demo (opens in a new tab)
Teams from Ant, Westlake University and Zhejiang University use a structured Proxy to control scene state and Invoker-Render to generate visuals, releasing eight-GPU streaming inference. The long demo and 140 evaluations cover specified scenes, not arbitrary stable worlds.

openJiuwen presents a Harnessless approach for reusing AgentOS execution tools (opens in a new tab)
openJiuwen uses app-development and swarm demos to show how built-in harness capabilities support sessions, tools and app management. Applications still define business rules and permissions; remote deployment and some capabilities remain planned or exploratory.