快一点!再快一点!快到世界能实时生成|和生数科技张金涛聊:Vidu S1、推理加速、实时交互模型 (opens in a new tab)
金涛今年 26 岁,还是清华在读博士。真正把他带进「推理加速」的,是一个很朴素的判断——当大家都默认 FlashAttention 已经把 Attention 算子做到极致时,他却发现:显卡上明明还有更快的计算单元没被用起来 ——「这么明显的收益,为什么没人做?」
Total 235 articles
金涛今年 26 岁,还是清华在读博士。真正把他带进「推理加速」的,是一个很朴素的判断——当大家都默认 FlashAttention 已经把 Attention 算子做到极致时,他却发现:显卡上明明还有更快的计算单元没被用起来 ——「这么明显的收益,为什么没人做?」
谷歌的前端功底有多深,不需要任何人来认证。
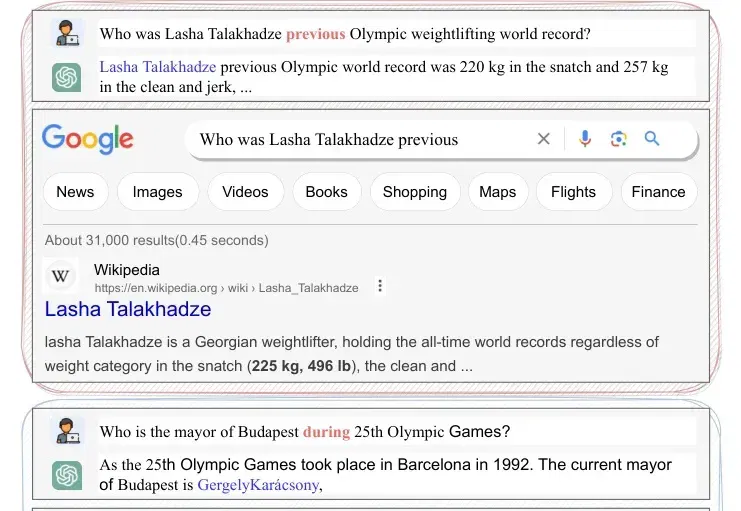
向ChatGPT问一个看起来挺简单的问题:“Lasha Talakhadze之前的奥运举重纪录是多少?”
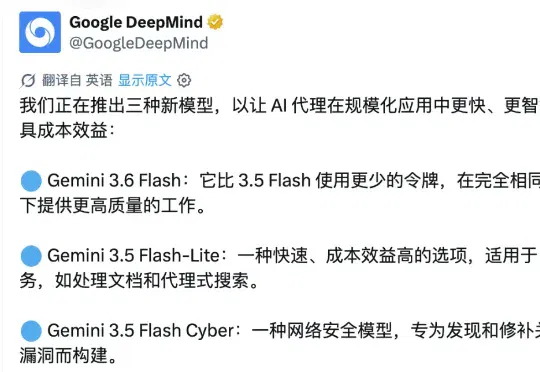
如果你从去年就开始用 Gemini,那感觉就像看着自家兄弟慢慢得了阿尔茨海默症。按理说,一家公司发新模型,通常是来打脸这种调侃的。可就在刚刚,Google 一口气发了三个新模型之后,网友非但没收回这句话,反而笑得更大声了。多少有种他们都不看好你,可偏偏你最不争气的即视感。
全网等了快三个月!DeepSeek V4正式版,可能最早明日发布,最迟不过这几天。目前,一部分人已提前拿到了DeepSeek V4(GA)灰度测试的权限。一共有两个版本:DeepSeek V4 Flash,DeepSeek V4 Pro。
图片来源:Unsplash 在 ChatGPT 的发布将生成式人工智能带入主流市场三年多之后,OpenAI 正将其关注点从个人用户扩展到家庭。 OpenAI 正在旧金山招聘一名专职产品经理,负责在其产
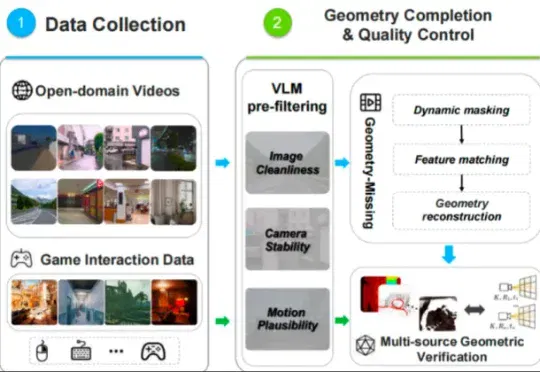
专注于4D世界模型研发和产业化的魔芯科技联合浙江大学潘云鹤院士团队发布MoWorld——全球首个Flash World Model,也是首个全栈基于国产NPU构建的实时交互世界模型。
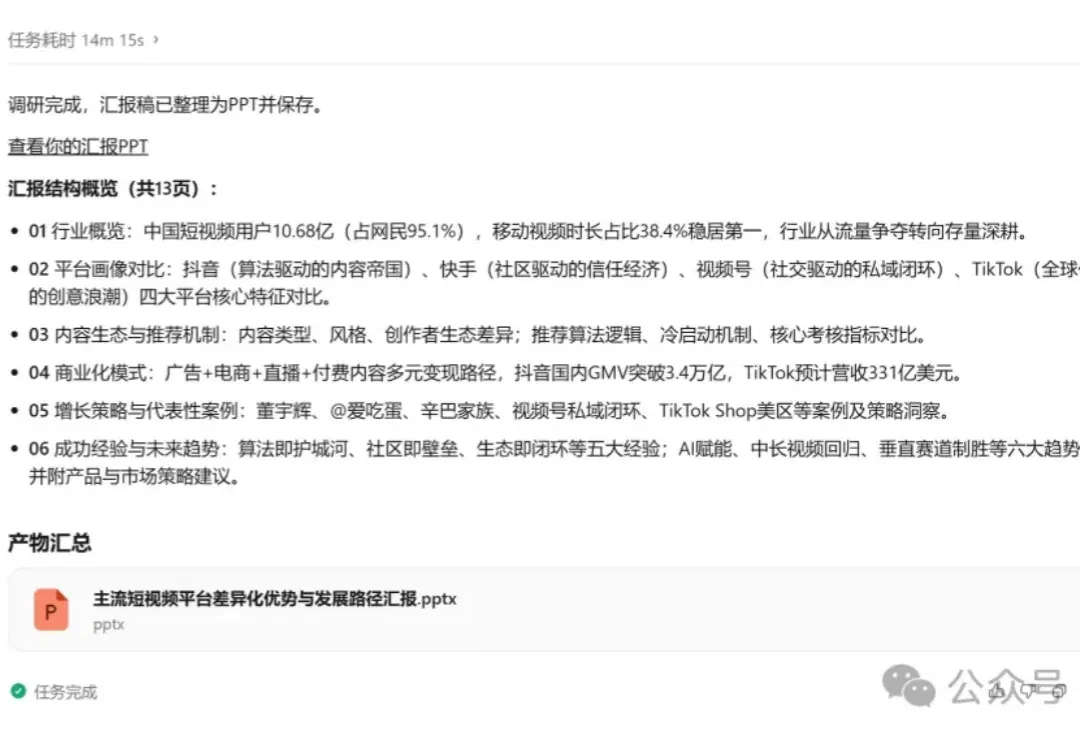
最近这段时间,国内外模型更新得很快。 如果只看发布会和榜单,大家都会觉得每个模型都很强。参数更大、上下文更长、推理更强、价格更低,听起来都挺猛。 但真正用到工作流里,会发现另一件事:模型强不强,不只看它会不会回答问题,还要看它能不能把一个任务完整跑完。 尤其是 Agent 场景。 一个复合任务需要大模型去调用多个工具,比如让模型做一份 PPT,它并不是简单写几页文字。中间要先理解需求,再去搜索资料,阅读网页,提取关键信息,整理成汇报结构,必要时还要生成代码或调用插件,最后产出一个可以正常使用的PPT文件。 下面测试两个Agent任务,使用同样的提示词,相同的Agent工具-Trae Work。
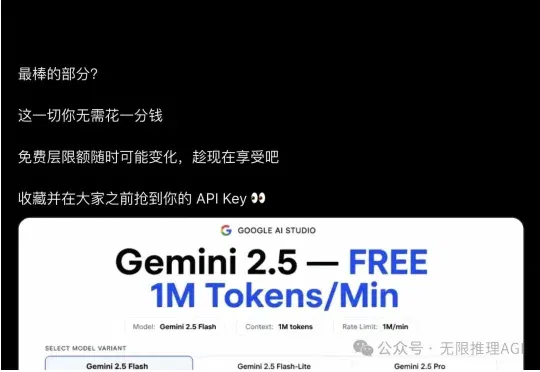
0 美元你能得到什么——Gemini 2.5 Flash 和 Pro 均可用,每分钟 1M tokens,原生支持文本、图像、音频、视频多模态输入 ,几秒钟生成 API Key,即开即用
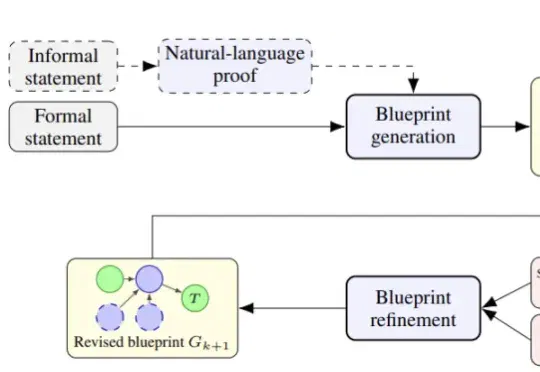
近日,普林斯顿大学的研究团队发布了一篇新论文,提出了一个名为 Goedel-Architect 的智能体框架。他们用的核心模型,是国内开源大模型 DeepSeek-V4-Flash。