国内大模型厂商 Token/Coding Plan 汇总对比:MiniMax、智谱、阶跃、Kimi 怎么选 (opens in a new tab)
我自己用 Coding Plan 也有一段时间了,最开始只是为了省点 API 钱,后来各家陆续推出固定月费套餐,我发现选起来比想象中复杂。Codex、Claude Code、Cline、OpenClaw 这些工具让开发者越来越习惯用自然语言驱动代码生成和任务执行,但高频调用带来的 API 成本也成了一笔固定开销。
Total 212 articles
我自己用 Coding Plan 也有一段时间了,最开始只是为了省点 API 钱,后来各家陆续推出固定月费套餐,我发现选起来比想象中复杂。Codex、Claude Code、Cline、OpenClaw 这些工具让开发者越来越习惯用自然语言驱动代码生成和任务执行,但高频调用带来的 API 成本也成了一笔固定开销。
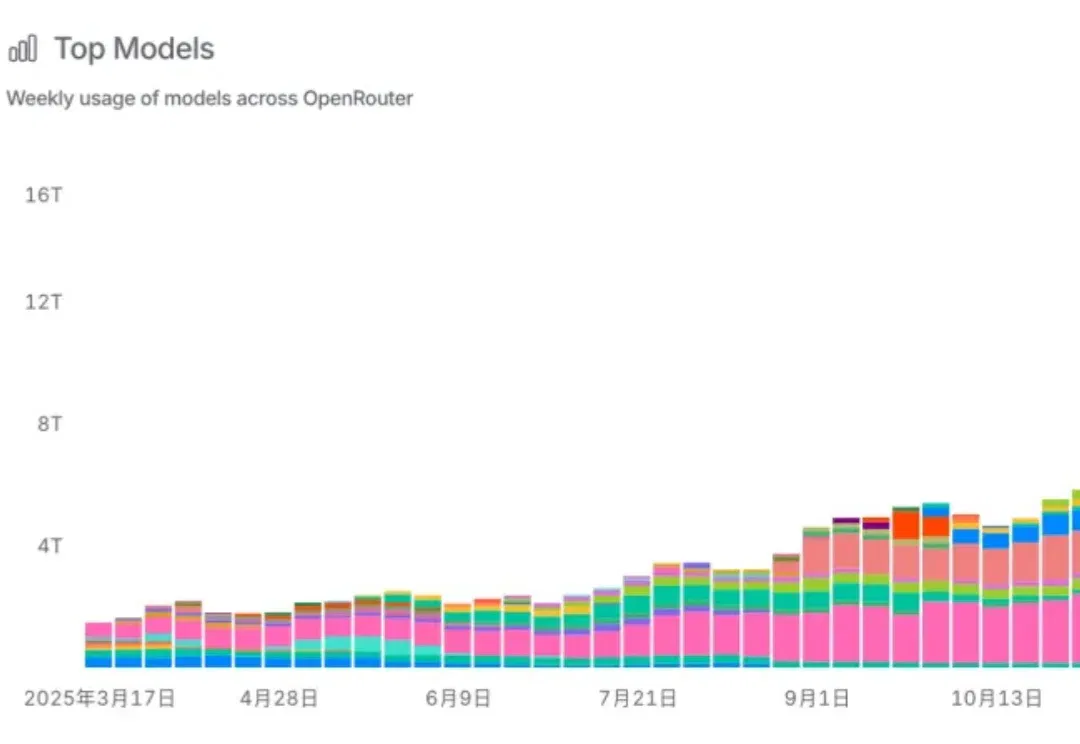
好家伙!龙虾老吃家还得看中国。 全民“养虾”热潮直接带动国产大模型喜迎黄金周。 根据OpenRouter最新数据,上周中国大模型的周调用总量飙升至4.19万亿Token。 这是继今年2月首度反超美国后,中国大模型再度强势登顶,重回全球榜首。 OpenClaw继续霸榜热门应用第一,其中本月最受养虾人青睐的算力搭子中,国产大模型依旧遥遥领先。 榜单前三分别是Kimi K2.5、Step 3.5 Flash和MiniMax M2.5,均超1T tokens。 果然在吃这回事上,国产玩家真夯!喝完奶茶吃龙虾,妙哉妙哉~(doge) 🦞爱吃中国大模型 整体来讲,上周3月2日-8日,中美大模型活跃度出现
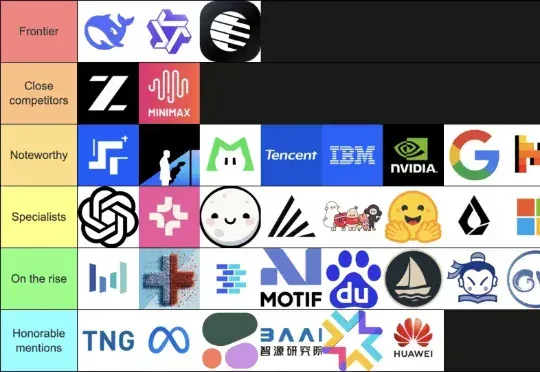
最近几天,一张开源模型的等级列表在 X 上被疯狂转载。 从夯到拉,国产开源模型排在了数一数二的位置,DeepSeek、Qwen、Kimi、智谱、还有 MiniMax 是全球开源模型的前五名。
从未见过如此凡尔赛的名场面。云计算一哥亚马逊云科技CEO Matt Garman,在自家年度盛宴re:Invent 2025中,因为还要发布的新产品太多了,于是他在现场来了一句: 我挑战一下10分钟内发布25个产品!
月之暗面融资传闻升级,估值或逼近MiniMax。Kimi产品因MAU下滑、DeepSeek冲击失速,战略转向Coding和Agent方向,推出分层会员订阅商业化。杨植麟在开源上妥协,但坚持基座模型和toC路线,面临分发弱势和高昂成本,未来半年需明确定位应对激烈竞争。
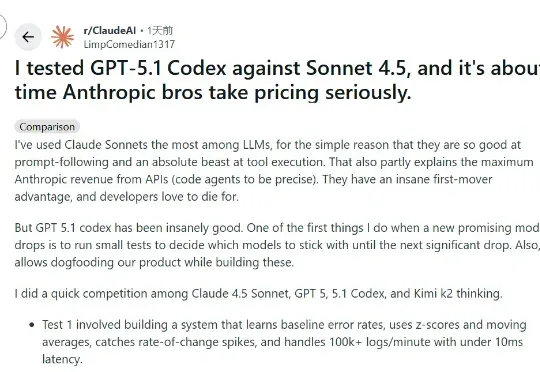
最近,小编注意到一位全栈工程师 Rohith Singh 在Reddit上发表了一篇帖子,介绍他如何对四个模型(Kimi K2 Thinking、Sonnet 4.5、GPT-5 Codex 和 GPT-5.1 Codex)进行了实测。
前段时间Trae下架了Claude,标志着但凡跟中国沾边AI工具都禁止使用 Claude 但我一点都不慌,因为已经很久没用 Claude 了 尤其在编程赛道上,国产大模型已经通过内部互卷站起来了。
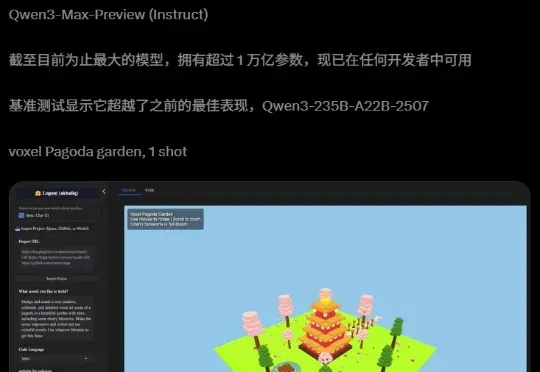
阿里迄今为止,参数最大的模型诞生了!昨夜,Qwen3-Max-Preview(Instruct)官宣上线,超1万亿参数性能爆表。在全球主流权威基准测试中,Qwen3-Max-Preview狂揽非推理模型「C」位,直接碾压Claude-Opus 4(Non-Thinking)、Kimi-K2、DeepSeek-V3.1。
机器之心发布 随着 ChatGPT、Gemini、DeepSeek-V3、Kimi-K2 等主流大模型纷纷采用混合专家架构(Mixture-of-Experts, MoE)及专家并行策略(Expert
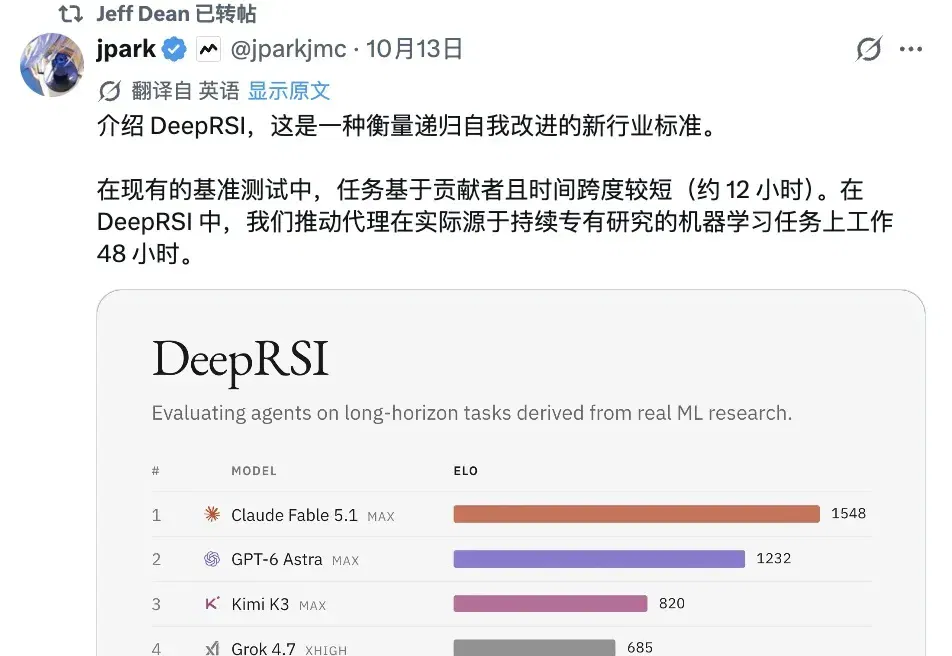
好嘛,咱姐夫(Jeff Dean)投资的AI初创公司hillclimb,搞的RSI新基准终于出成绩了!