国内大模型厂商 Token/Coding Plan 汇总对比:MiniMax、智谱、阶跃、Kimi 怎么选
我自己用 Coding Plan 也有一段时间了,最开始只是为了省点 API 钱,后来各家陆续推出固定月费套餐,我发现选起来比想象中复杂。Codex、Claude Code、Cline、OpenClaw 这些工具让开发者越来越习惯用自然语言驱动代码生成和任务执行,但高频调用带来的 API 成本也成了一笔固定开销。
我自己用 Coding Plan 也有一段时间了,最开始只是为了省点 API 钱,后来各家陆续推出固定月费套餐,我发现选起来比想象中复杂。Codex、Claude Code、Cline、OpenClaw 这些工具让开发者越来越习惯用自然语言驱动代码生成和任务执行,但高频调用带来的 API 成本也成了一笔固定开销。为此,国内主流大模型厂商纷纷推出了面向开发者的固定月费套餐,业内统称为 Coding Plan。
这类套餐的本质是用一笔可预期的月费,换取远高于按量付费的调用额度。但各家在模型规模、开源策略、模态支持、计费方式和限额透明度上差异明显。这篇文章是我基于厂商官网和公开文档,对 MiniMax、智谱 GLM、阶跃星辰和 Kimi 四家方案做的一次系统梳理,方便我自己后续回看,也分享给你参考。
一、MiniMax Token Plan
MiniMax 在 2026 年 3 月将 Coding Plan 升级为 Token Plan,把文本、语音、图像、视频等能力打包进同一订阅。
模型与开源情况
MiniMax Token Plan 的核心模型是 MiniMax-M2.7,官方未公开其具体总参数量,M2 系列采用 MoE 架构。开源方面,MiniMax-M2(230B 总参数 / 10B 激活参数)和 MiniMax-M2.5(229B 总参数)均已开源,遵循 MIT License;而 MiniMax-M2.7 目前保持闭源,仅通过 API 提供服务。
开源地址如下:
- MiniMax-M2 GitHub[1]
- MiniMax-M2 Hugging Face[2]
模态支持上,M2.7 是文本单模态模型。套餐中提到的图像理解、语音合成、视频生成等能力,是通过平台集成的其他多模态 API 实现,而非 M2.7 模型本身具备多模态输入能力。
套餐档位
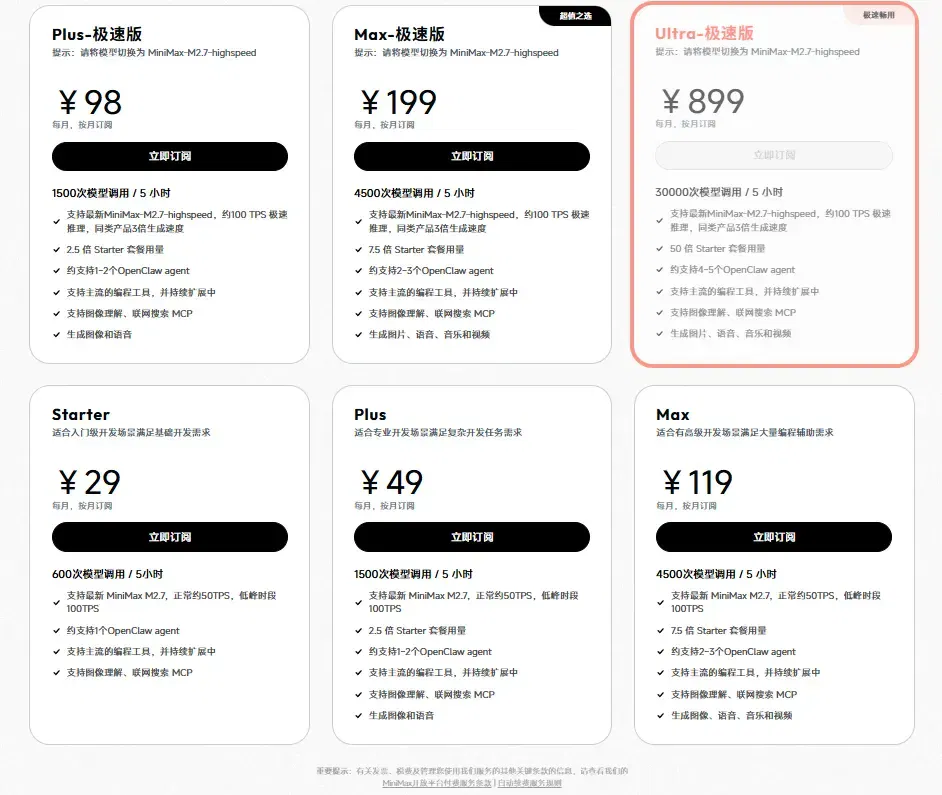
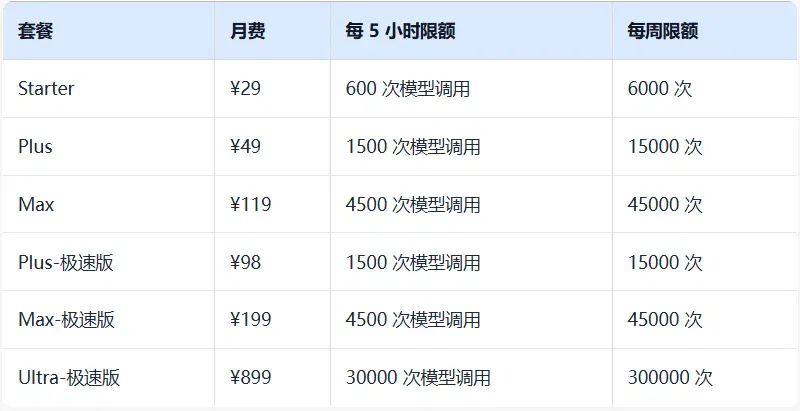
计费方式上,文本模型按请求次数计费,每 5 小时滚动重置,周限额约为每 5 小时限额的 10 倍。这种计费方式额度透明,不需要额外折算。API 参考价为输入未命中缓存 2.1 元/百万 tokens,命中缓存 0.42 元/百万 tokens,输出 8.4 元/百万 tokens。
MiniMax 的入门价最低(¥29),计费单位简单直接。如果你更看重额度透明度和低门槛尝鲜,这是目前友好的选择之一。
来源:MiniMax 开放平台定价[3]
二、智谱 GLM Coding Plan
智谱是国内最早推出 Coding Plan 的厂商之一,主打自研 GLM 系列模型。
模型与开源情况
智谱 GLM Coding Plan 的核心模型包括 GLM-4.7(355B 总参数,MoE 架构)、GLM-5.1、GLM-5-Turbo 和 GLM-5。其中 GLM-4.7 为 355B 总参数;GLM-5 为 744B 总参数 / 40B 激活参数;GLM-5.1 与 GLM-5 同架构,是后训练升级版本。开源方面,GLM-4.5、GLM-4.7 和 GLM-5 均已开源(MIT License);GLM-5.1 截至 2026 年 3 月 30 日尚未开源,但智谱官方已确认将遵循 MIT License 开源,具体日期未公布。
开源地址如下:
- GLM-5 GitHub[4]
- GLM-5 Hugging Face[5]
- GLM-4.5 GitHub[6]
模态支持上,GLM-4.7 及以下是文本模型。套餐中包含的视觉理解、联网搜索、网页读取等 MCP 工具,是通过平台集成的额外服务实现。
套餐档位
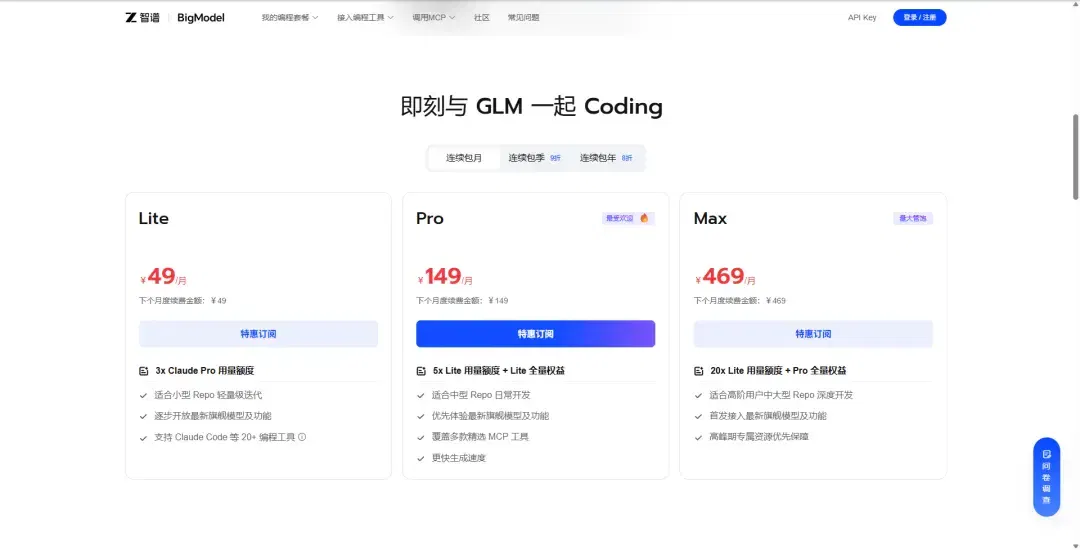
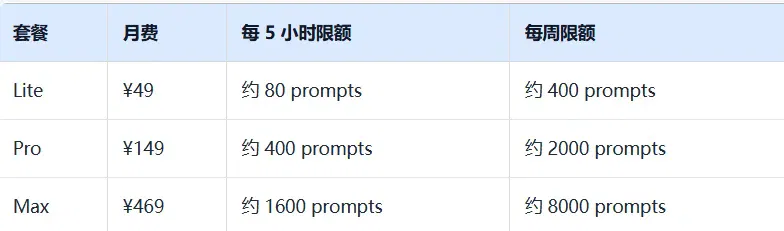
计费方式按 prompts 计费。官方说明一次 prompt 约对应 15-20 次模型调用,每月可用额度按 API 定价折算,约为月订阅费的 15-30 倍。GLM-5 系列作为旗舰模型,调用时会按倍数消耗额度:高峰期(每日 14:00-18:00)按 3 倍抵扣,非高峰期按 2 倍抵扣。截至 2026 年 4 月底的限时福利是,GLM-5.1 和 GLM-5-Turbo 在非高峰期按 1 倍抵扣。
价格方面,2026 年 2 月 12 日起智谱对 GLM Coding Plan 涨价并取消首购优惠,Lite 从 ¥40 涨至 ¥49,Max 涨至 ¥469,2 月 12 日前订阅的老用户仍保留原价格和额度。
智谱的关键特点是工具适配数量最多(20+ 款),自带 MCP 工具链。但计费单位是 prompts,需要折算成实际请求次数,额度透明度不如按请求次数计费的方案。
MCP 额度限制:
- Lite 套餐:联网搜索 / 网页读取 / 开源仓库 MCP 每月合计 100 次
- Pro 套餐:每月合计 1000 次
- Max 套餐:每月合计 4000 次
OpenClaw 使用策略上,套餐支持 OpenClaw,但采用次级调度与尽力交付策略。Coding Agent 任务享有资源抢占优先权,高负载下 OpenClaw 任务将自动触发动态排队、限流等公平使用策略。
来源:智谱 GLM Coding Plan 官网[7]、智谱开放平台文档[8]
三、阶跃星辰 Step Plan
阶跃星辰在 2026 年 3 月 23 日正式推出 Step Plan,主打 Agent场景,速度实测非常快,在OpenClaw 和 AI Coding 场景表现也不错。
模型与开源情况
阶跃星辰 Step Plan 的核心模型是 Step 3.5 Flash,参数规模为 196B 总参数、11B 激活参数,采用 MoE 架构。该模型已开源,阶跃星辰开源了 Step 3.5 Flash 的 Base 和 Midtrain 权重,以及官方同款训练框架 Steptron。开源地址为 Step 3.5 Flash Hugging Face[9]。模态支持上,当前 Step Plan 仅支持 step-3.5-flash,属于文本单模态模型,多模态能力将在后续更新中逐步扩展。
套餐档位
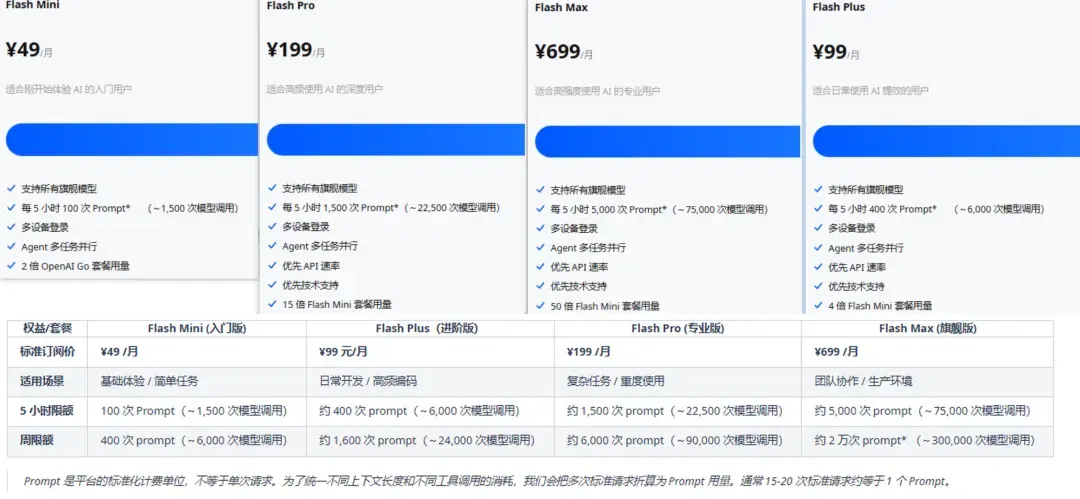
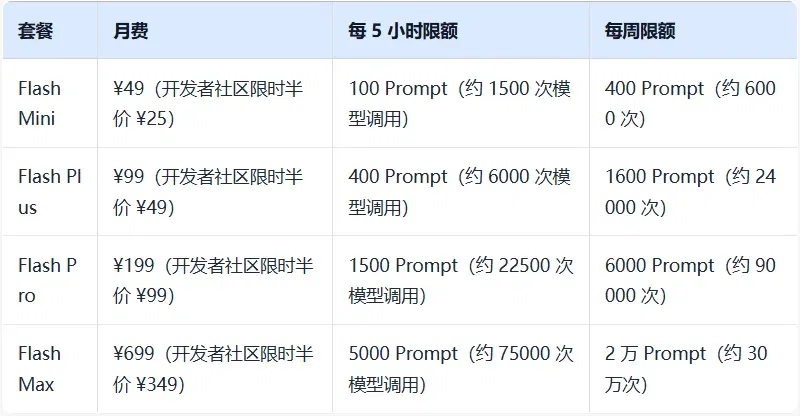
计费方式按 Prompt 计费,1 Prompt 约等于 15-20 次标准模型调用。官方宣称同档价位下,实际模型调用次数可达竞品的 2 倍以上。
阶跃星辰 Step Plan 的关键特点包括:全档位标配高速推理,不设普通版与极速版之分;模型开源,开发者可以下载权重进行本地部署或二次研究;兼容 Claude Code、OpenClaw、Cline、RooCode 等 9 款主流工具;有独立的 Base URL(https://api.stepfun.com/step_plan/v1),与普通 API 地址不同。
来源:阶跃星辰 Step Plan 官方文档[10]
四、Kimi 登月计划 / Kimi Code
月之暗面的 Kimi Code 采用 Token 计量模式,额度设计与缓存机制强相关。
模型与开源情况
Kimi Code 的核心模型是 Kimi K2.5,参数规模为 1T 总参数,采用 MoE 架构,是目前国内公开参数规模最大的模型之一。K2.5 模型权重已开源。模态支持上,K2.5 支持文本和图像输入,是国内 Coding Plan 中少数具备原生视觉理解能力的模型。
套餐档位
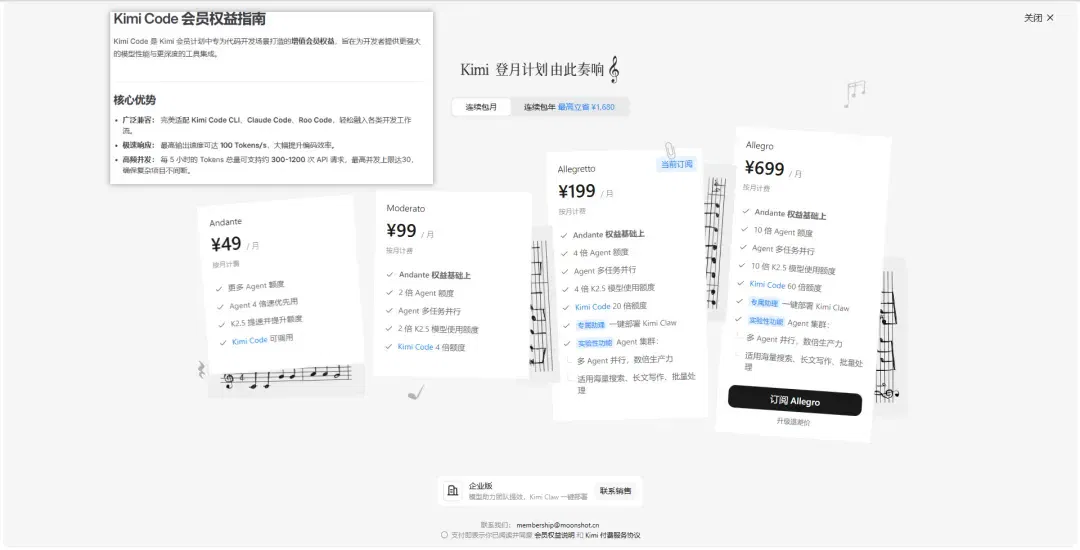
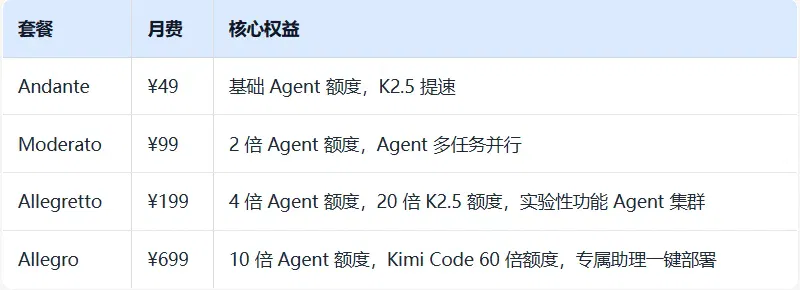
计费方式按 uncached input + output tokens 计量,缓存命中的部分不计入限额。在典型的 Vibe Coding 场景中,input tokens 占总量的 99.5% 左右,其中缓存命中部分约占 90%-95%。实际可用请求数与缓存命中率强相关。API 参考价为输入未命中缓存 4 元/百万 tokens,命中缓存 0.7 元/百万 tokens,输出 21 元/百万 tokens。
Kimi 的关键特点是原生多模态能力最强,支持截图输入进行视觉编程;参数规模最大(1T);Allegretto 档支持 Agent 集群(多 Agent 并行)。但计费方式最复杂,额度受缓存命中率影响大,透明度较低。
来源:Kimi Code 会员权益指南[11]、Coding Plan 汇总参考[12]
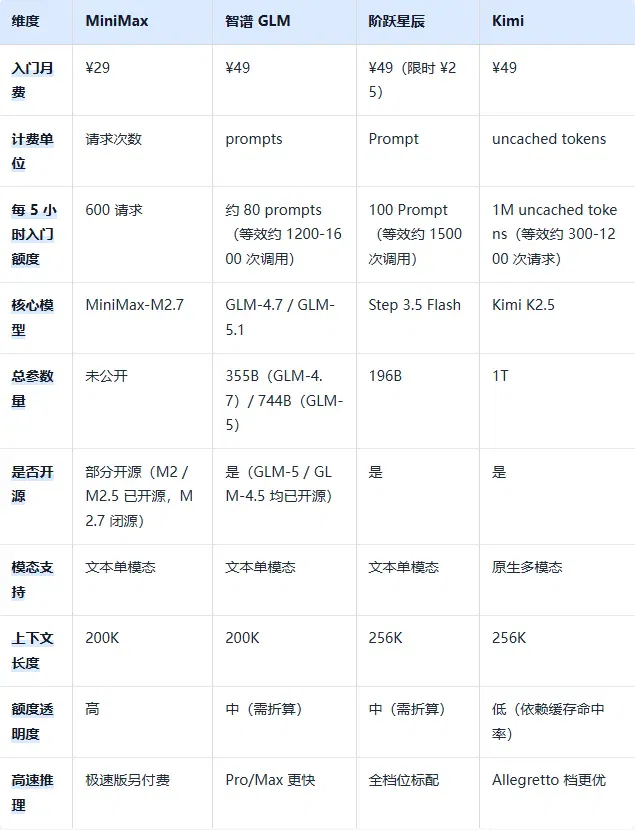
五、横向对比一览
六、关于选购建议的说明
需要说明的是,目前我实际购买并长期使用的只有 Kimi K2.5 的 Coding Plan,其他三家(MiniMax、智谱 GLM、阶跃星辰)的方案尚未深度体验。因此本文不做具体的选购推荐,只把各家的官方参数、计费规则和特点摆出来,方便你根据自己的使用习惯和预算做判断。如果你已经用过其中某一家,也欢迎在评论区分享实际体验。
七、注意事项
各家 Coding Plan 的计费单位差异很大,MiniMax 按请求次数计费,智谱和阶跃按 Prompt 计费(需要折算成 15-20 次调用),Kimi 则按 uncached tokens 计费。选择前建议先估算自己的使用模式与计费单位的匹配度,避免买完后发现额度消耗比预期快。
Kimi 的额度与缓存机制强挂钩。如果上下文重复率低,uncached tokens 会快速消耗额度,实际可用次数可能远低于理论值。智谱的 GLM-5 系列在高峰期按 3 倍抵扣,使用旗舰模型时需留意额度消耗速度,非高峰期则相对划算。
开源不等于免费商用。阶跃和 Kimi 的模型权重虽然开源,但本地部署仍需考虑硬件成本。阶跃的 Step 3.5 Flash BF16 版本需要约 642GB 显存,FP8 版本需要约 326GB,普通开发者很难在本地跑起来。
阶跃星辰 Step Plan 有独立的 Base URL(https://api.stepfun.com/step_plan/v1),与普通 API 地址不同,在配置 Claude Code、Cline 等工具时需要注意区分。智谱的 MCP 服务有月度上限,Lite、Pro、Max 套餐的联网搜索、网页读取、开源仓库 MCP 分别有 100、1000、4000 次的月度合计上限,不是无限使用。此外,智谱 GLM Coding Plan 虽然支持 OpenClaw,但高负载时会触发排队和限流,Coding Agent 任务优先级更高,OpenClaw 任务可能需要等待。
八、限时薅羊毛
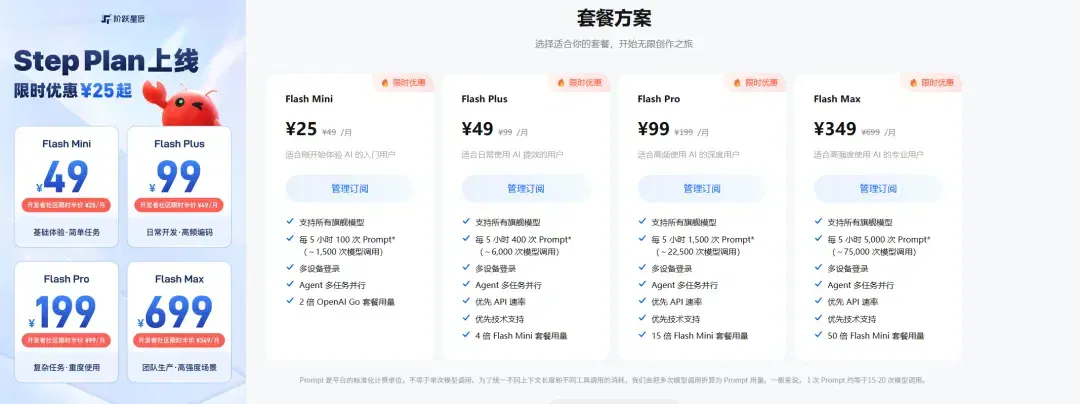
如果你还在犹豫从哪家开始尝鲜,阶跃星辰目前有一个不错的限时窗口:Step Plan 开发者社区四个档次都在打半折,Flash Mini 只要 ¥25/月,Flash Plus ¥49/月,Flash Pro ¥99/月,Flash Max ¥349/月。对于想低成本体验高速推理 + 开源模型背书的开发者来说,这个入门门槛已经相当低了。
引用链接
[1]MiniMax-M2 GitHub:https://github.com/MiniMax-AI/MiniMax-M2
[2]MiniMax-M2 Hugging Face:https://huggingface.co/MiniMaxAI/MiniMax-M2
[3]MiniMax 开放平台定价:https://www.minimaxi.com/pricing
[4]GLM-5 GitHub:https://github.com/zai-org/GLM-5
[5]GLM-5 Hugging Face:https://huggingface.co/zai-org/GLM-5
[6]GLM-4.5 GitHub:https://github.com/zai-org/GLM-4.5
[7]智谱 GLM Coding Plan 官网:https://www.bigmodel.cn/glm-coding
[8]智谱开放平台文档:https://docs.bigmodel.cn/cn/coding-plan/overview
[9]Step 3.5 Flash Hugging Face:https://huggingface.co/stepfun-ai/Step-3.5-Flash-Base
[10]阶跃星辰 Step Plan 官方文档:https://platform.stepfun.com/docs/zh/step-plan/overview
[11]Kimi Code 会员权益指南:https://www.kimi.com/code/docs/
[12]Coding Plan 汇总参考:https://jia.je/kb/software/coding_plan.html
文章来自于“筱可AI”,作者“筱可AI”。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
3.9元搞定Codex!国内也能畅用~(附教程,超简单) (opens in a new tab)
大家好,我是袋鼠帝 我发现,最近很多朋友貌似都把自己的主力Agent换成了Codex

姜宇辉的AI分身:知识助手与“另一个自己”之间 (opens in a new tab)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署 (opens in a new tab)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。

范式智能介绍Phai-A1与Phai-M1,强调国产算力后训练优化 (opens in a new tab)
范式智能介绍面向代码与Agent场景的Phai-A1,以及面向真人影视的音画同步模型Phai-M1。公司展示了单卡运行和视频生成能力,并称模型在昇腾平台完成专项后训练优化。

腾讯Q3资本开支814亿元,称WorkBuddy日Token用量居国内首位 (opens in a new tab)
腾讯三季报显示营收2073.36亿元、资本开支814.33亿元。公司称WorkBuddy日活超1000万,按用户每日大语言模型Token消耗总量居国内首位;报道还讨论云业务增收与AI投入对盈利、现金流的影响。