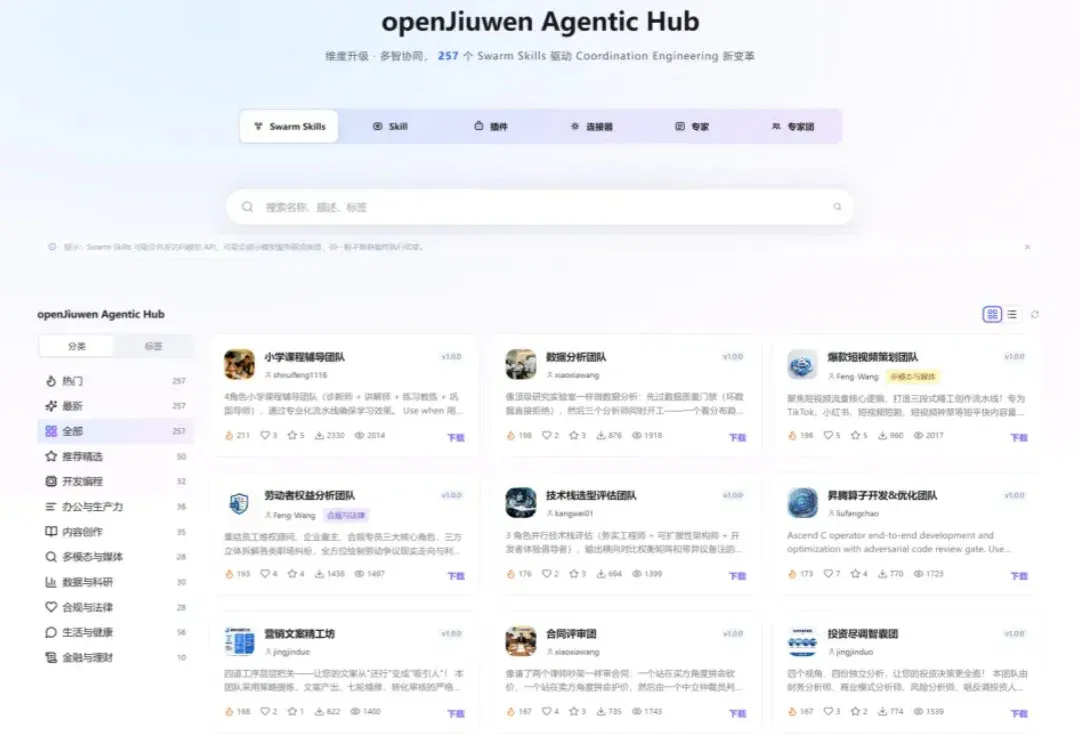
Agent版Hugging Face来了,openJiuwen发布首个开源智能体资产平台 (opens in a new tab)
过去一年,Agent 的讨论大多围绕模型本身展开:推理能力更强、上下文更长、工具调用更稳定。但进入真实工作流后,另一个问题开始变得更关键:Agent 的能力从哪里来,又如何被持续复用。
Total 348 articles
过去一年,Agent 的讨论大多围绕模型本身展开:推理能力更强、上下文更长、工具调用更稳定。但进入真实工作流后,另一个问题开始变得更关键:Agent 的能力从哪里来,又如何被持续复用。
剪映的 AI 边界,正不断延展。 在刚刚结束的 2026 剪映 AI 新创作发布会上,剪映发布了全新 AI 能力,让专业创作者和普通用户的创作效率和创作体验,都有了一次明显提升。 一方面是 PC 专业版的升级。这方面的关键词是“提效”。剪映 Hub 是这方面最亮眼的更新。这是个一站式的 AI 创作平台。通过将 AI 创作与多轨道剪辑连接起来,剪映 Hub 让脚本、素材与创作上下文在同一个项目中延续,大大减少了跨工具切换带来的断点与重复操作。 剪映助手 Agent 则进一步介入到专业创作流程,承担起素材整理、粗剪、包装等高频而繁琐的工作。Agent 可根据创作目标规划任务,串联模型、工具和 Sk
在大模型在拼命刷 Benchmark 卷编程的时候,「不能说话」的 Jev 却意外成了 AI 圈的新顶流,究其原因,大模型应用的价值正在从「生成什么」,进一步延伸到「能否理解复杂信息,并据此做出可靠判断」。
谷歌DeepMind掌门人首次确认Gemini 4 Pro已进入后训练早期阶段,开发者在实测中发现其新检查点在3D物理模拟、代码生成等任务上表现碾压Opus 5.5,且泄露参数显示其具备1000万Token上下文窗口和极具攻击性的定价,谷歌力争在年底前正式发布。
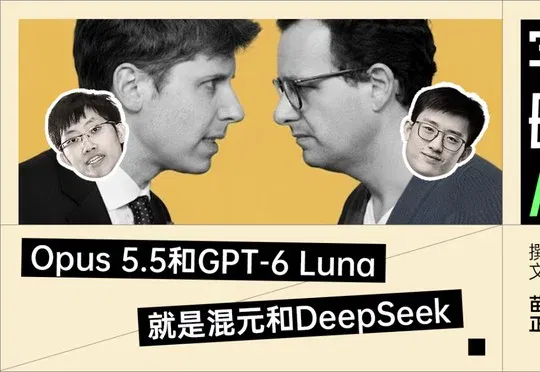
Anthropic的Opus 5.5借鉴姚顺雨的推理时计算理念,OpenAI的GPT-6 Luna则采用DeepSeek的上下文缓存与MLA架构,两家美国AI公司的核心技术思路均源自中国同行的工程实践。
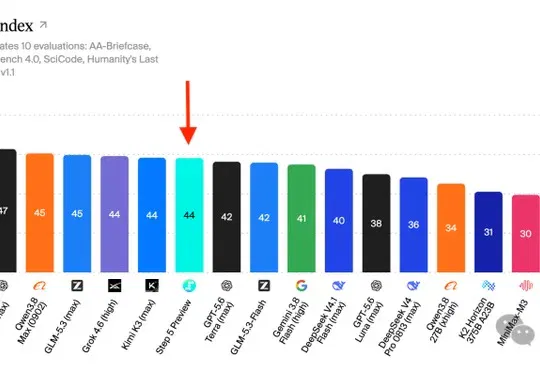
阶跃星辰发布新一代旗舰基座模型Step 5 Preview,以44分的AA智能指数成绩跻身全球开源模型前三,采用600B总参数/27B激活的稀疏MoE架构并原生支持1M上下文,在代码生成、长程Agent、深度研究与金融尽调等场景表现突出。
原生全模态模型Qwen3.8-Omni-Flash正式上线千问AI平台,支持文本、图像、音频、视频输入及1M长上下文,在30项评测中平均得分较上一代Qwen3.5-Omni-Plus提升超26%,在音视频Agent、剪辑、创作等场景效果显著,API每小时音频输入价格降幅超98%。
43页财报一句话变带图表网页。 一款模型“好不好”,究竟该如何定义? 显然,Agent正在改变人们评价大模型的方式。过去,判断模型强不强,往往看参数规模、Benchmark成绩和上下文长度。 而在Agent时代,一款能够又快又好地解决问题、完成任务,且token花得起的模型,才是很多用户眼中的好模型。 顶级模型固然能力更强,但往往思考和执行时间长、成本高昂,而快速模型生成token很快,却容易走错路、反复尝试,甚至需要人工接手,任务完成速度根本没快多少。 用更少的计算和无效尝试,更快更好地完成任务,是如今用户对Flash级别模型的期待,也让Flash级别模型逐渐从旗舰模型的轻量版本,走向一条独
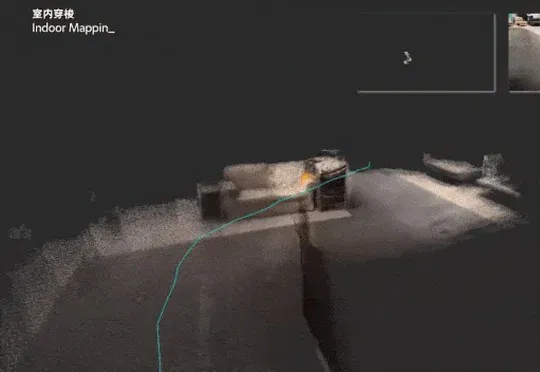
蚂蚁灵波开源的流式3D重建模型LingBot-Map凭借几何上下文注意力机制在GitHub获16.9K Stars后,其论文入选ECCV 2026 Oral,全球开发者围绕该项目完成Apple Silicon桌面前端、RTX 4060低显存适配及Ray-Ban Meta智能眼镜采集等多种二次开发。
Kimi K2.8 Preview 编程模型全量上线 Kimi Code,支持 1M 超长上下文并向所有会员档位开放,综合性能接近 K3,默认采用 Max 思考档位,编码和智能体能力较 K2.7 Code 有所提升。