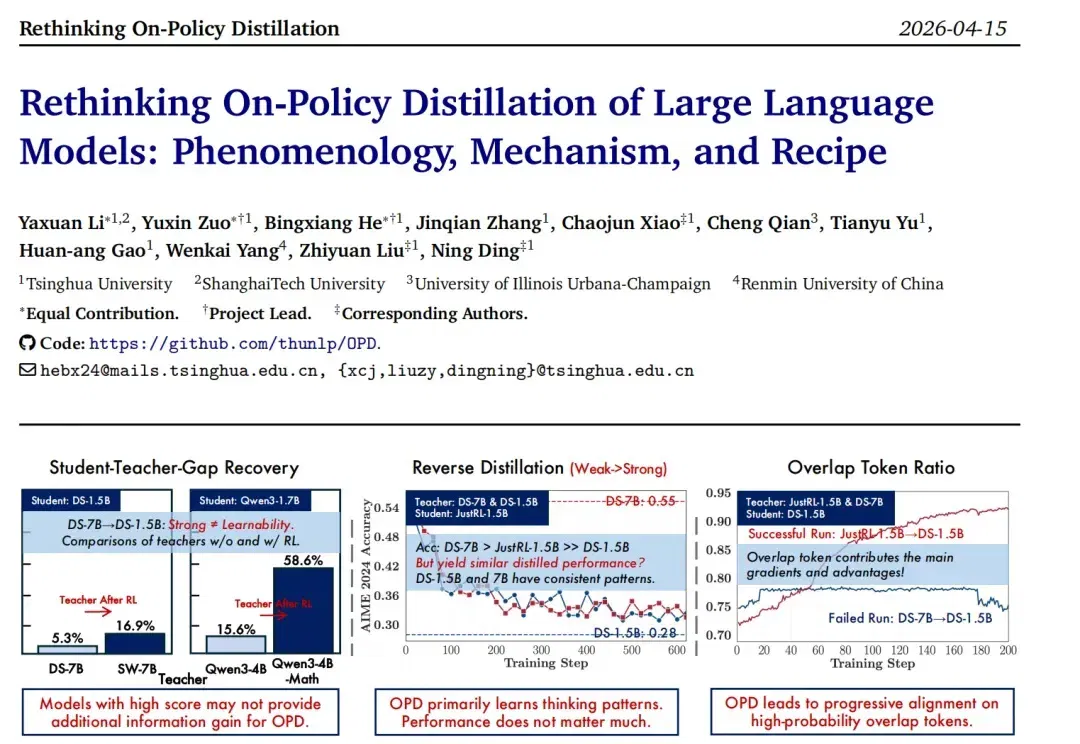
名师一定出高徒?清华团队最新揭秘:别再迷信大模型蒸馏的「免费午餐」 (opens in a new tab)
当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。
Total 198 articles
当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。
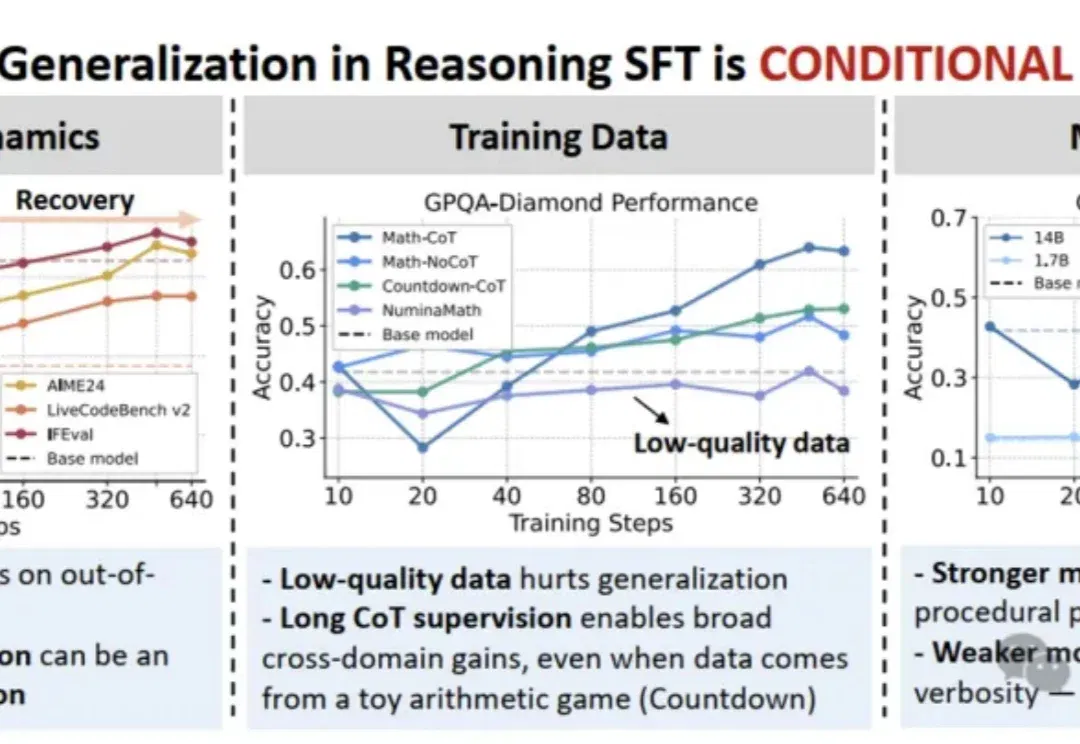
随着大模型后训练(Post-training)技术的发展,强化学习(RL)在提升模型推理能力方面的表现备受瞩目。
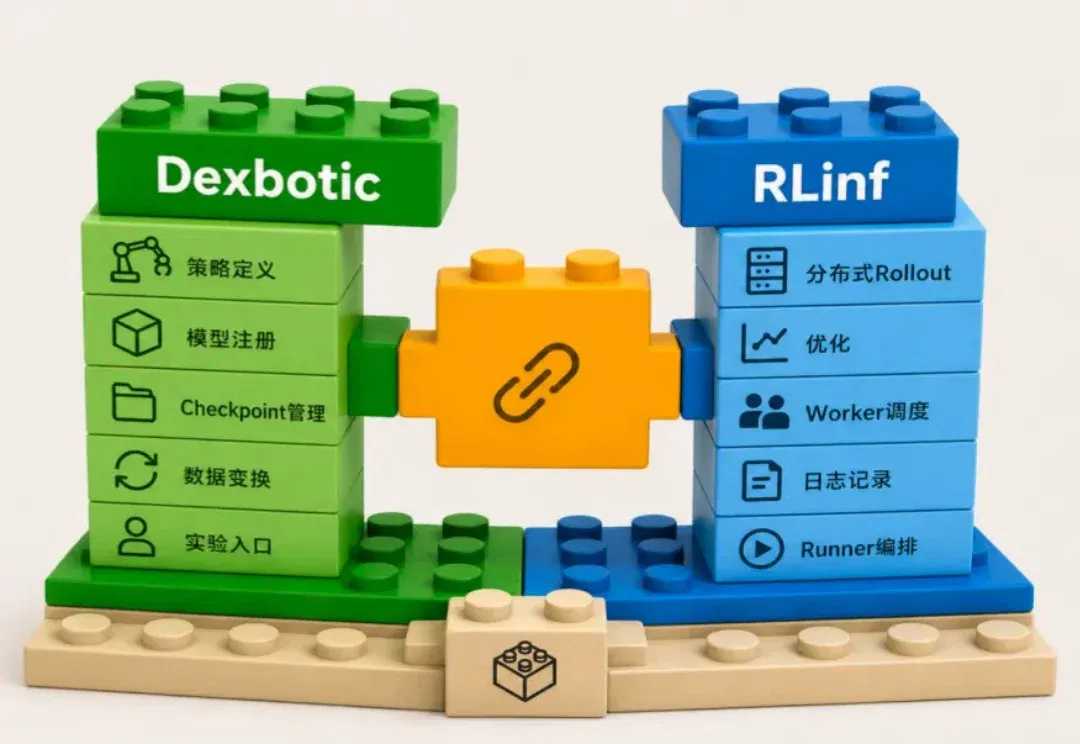
近日,原力灵机开源的具身智能原生框架 Dexbotic 宣布正式支持以 RLinf 作为其分布式强化学习后端。对具身智能开发者而言,这不仅是一次普通的工程适配,更意味着 VLA 模型研发中长期存在的「SFT 与 RL 割裂」问题,正在被真正打通。
机器人拉个拉链,到底需不需要“脑子”? 过去几年,从OpenVLA到π0、π0.5,具身大模型已经能让机器人把指令和动作连得有模有样。 但一旦包的位置挪了几厘米,或者光照暗了一点,它们往往就会“大脑宕机”。 究其原因,是因为这些机器人大多在玩“连连看”:看到观察结果,直接输出动作。 它们只是记住了轨迹,却并不理解背后的物理逻辑。 现在,一种让机器人“先想明白,再稳定行动”的新范式来了。 由至简动力、北大、港中文联合提出的LaST-R1,首次将隐空间物理推理塞进了强化学习的闭环。 同时,LaST-R1作为LaST₀基座模型的物理世界后训练范式,LaST₀首创面向机器人的隐空间物理思维链推理,并已
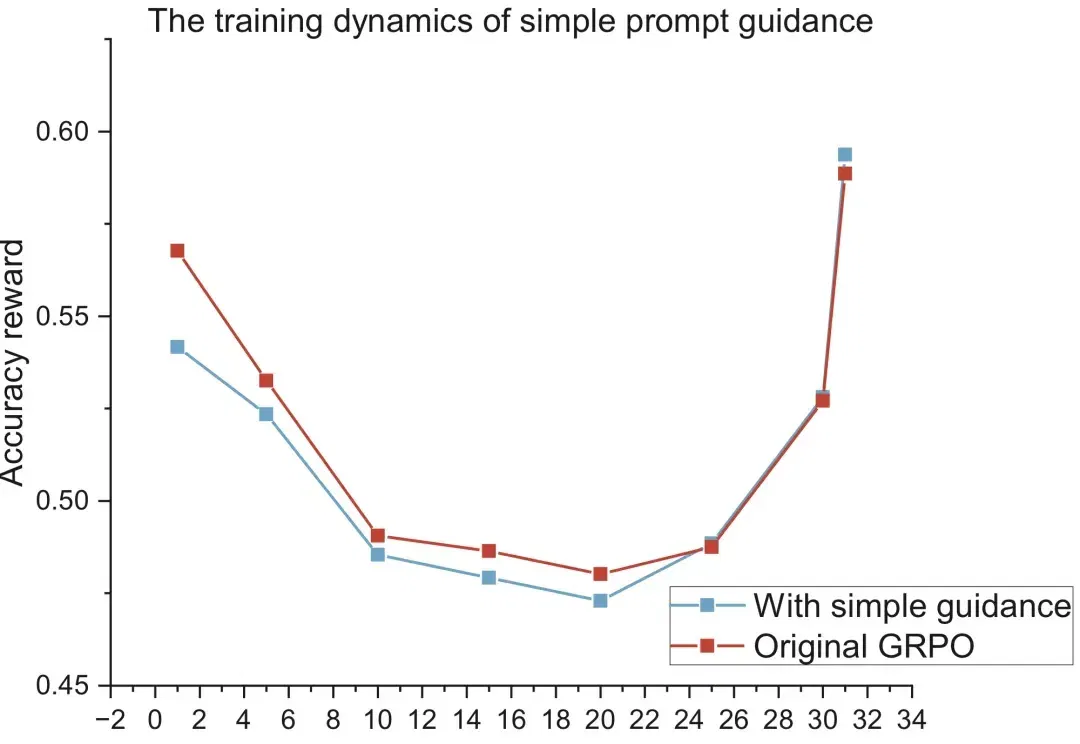
大模型时代的「炼金术师」们,或许都曾面临一个共同的困扰:当我们试图将 DeepSeek-R1、OpenAI-o1 那种惊艳的推理能力迁移到小规模语言模型(SLMs)时,效果却总是差强人意。现有的强化学习方法如 GRPO 在 7B+ 的大模型上效果显著,但一旦应用到 1.7B 甚至更小参数的模型上,性能提升就微乎其微。
用强化学习(RL)优化文生图模型的 prompt following 能力,是一条被广泛验证的路径 —— 让模型根据 prompt 用不同随机种子生成多张图片,通过 reward model 计算 reward,再利用相关 RL 算法优化模型。
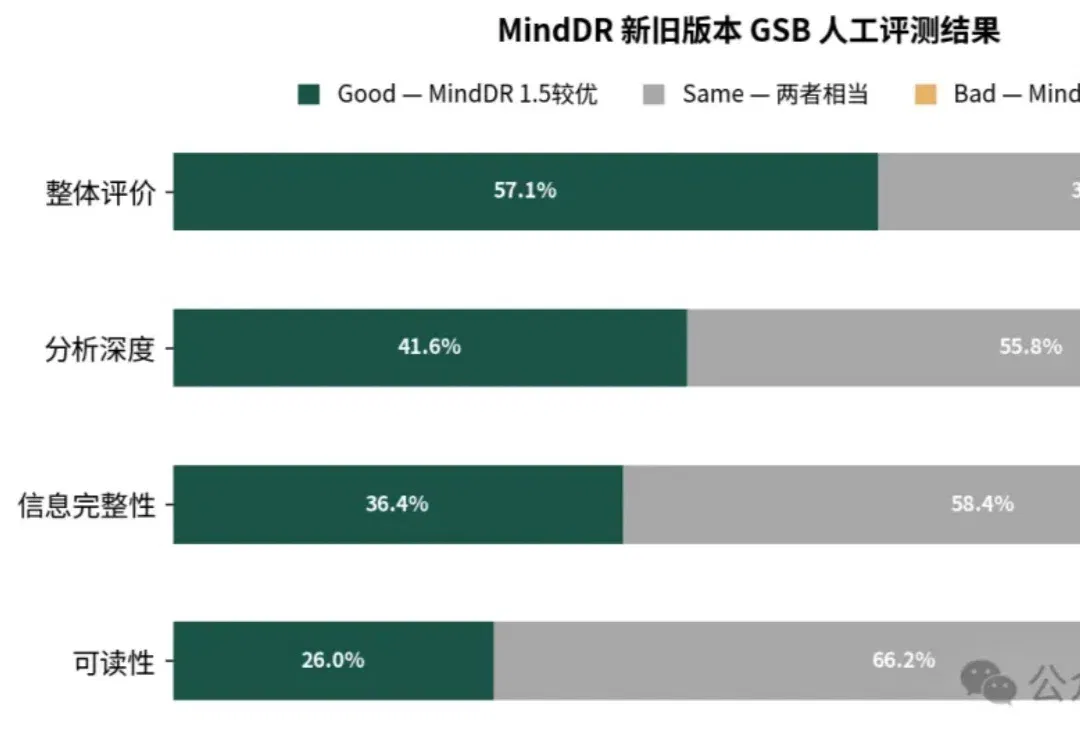
理想汽车信息智能体团队发布 MindDR 1.5,在 DeepResearch Bench 榜单中取得 52.54 分,以 30B 参数规模达到业界领先水平,性能优于同等规模的开源智能体系统。
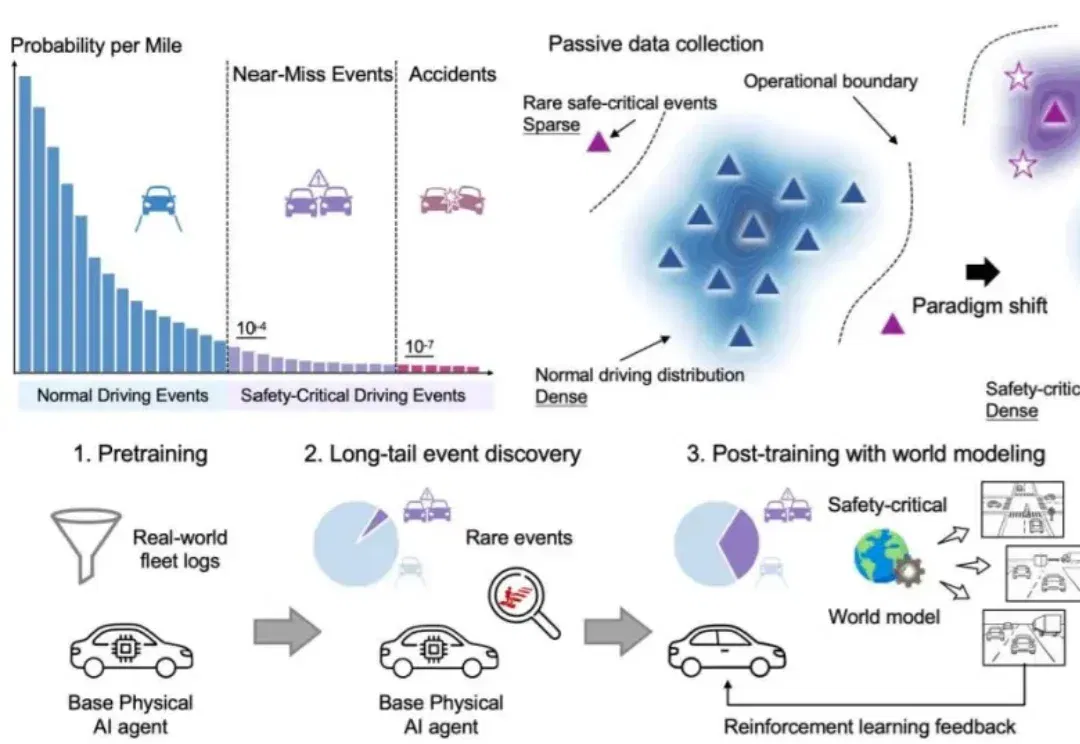
一年前,DeepSeek R1 横空出世,人们才意识到,真正让模型产生推理能力质变的,不必是更大的预训练规模 —— 后训练,用强化学习、过程奖励、闭环反馈,以极低的代价解锁了原本需要数倍算力才能触达的能力边界。
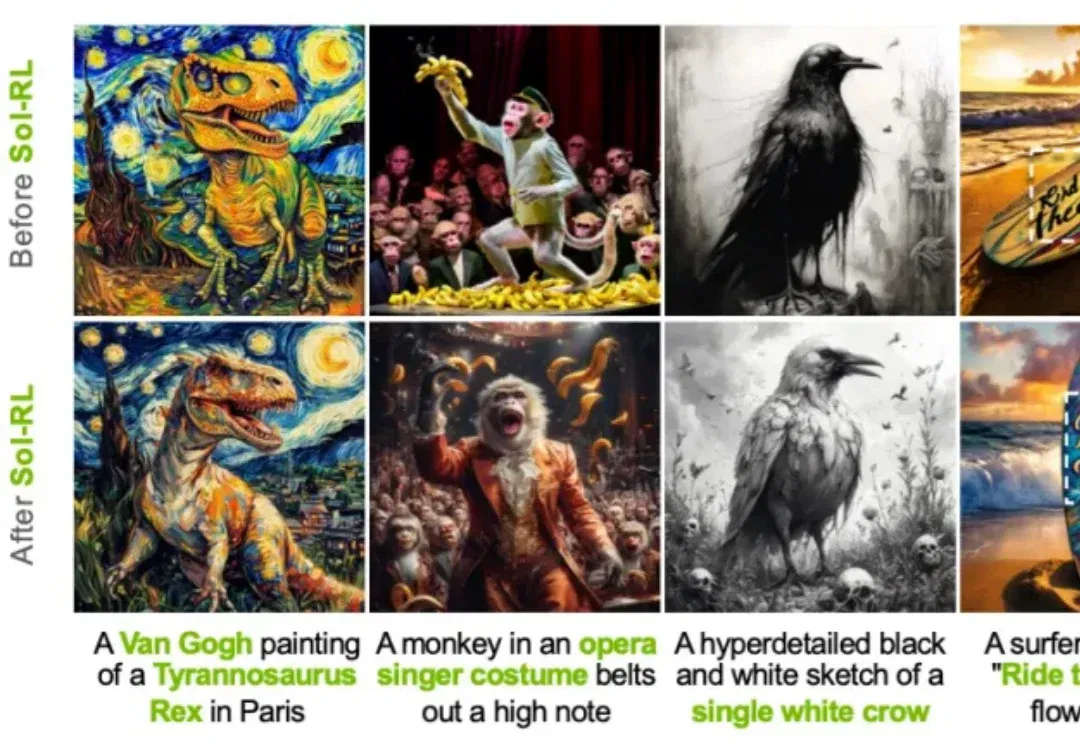
当强化学习后训练的大规模 rollout 已经被证明能够提升图像生成模型的偏好对齐能力,推理负担就成了制约训练速度的核心瓶颈。来自 NVIDIA、港大和 MIT 的团队提出的 Sol-RL,通过「FP4 先探索、BF16 再训练」的后训练框架,将达到等效 reward 水平的收敛速度最高提升到 4.64x,在训练速度与对齐效果之间给出了一条更具工程可行性的解法。
腾讯云“防爆箱”护航百万“龙虾”上岗,已助力MiniMax强化学习训练。