理想同学 MindDR 1.5 发布:多智能体强化学习加持,深度研究更可靠
理想汽车信息智能体团队发布 MindDR 1.5,在 DeepResearch Bench 榜单中取得 52.54 分,以 30B 参数规模达到业界领先水平,性能优于同等规模的开源智能体系统。
理想汽车信息智能体团队发布 MindDR 1.5,在 DeepResearch Bench 榜单中取得 52.54 分,以 30B 参数规模达到业界领先水平,性能优于同等规模的开源智能体系统。
相比上代,MindDR 1.5 的训练 token 数量减少 71.4%,训练卡时降低 60%,在性能与成本之间实现了更优平衡。以下是团队带来的技术解读,相关论文也已登上 Hugging Face 日榜。
25 年 12 月我们上线了 MindDR 1.0,实现了从信息获取、推理分析到报告生成的自主深度研究能力。今天,我们正式介绍全新升级的MindDR 1.5,为用户带来更强大、更高效、更易用的使用体验。
基于严格的双盲专家评测,MindDR 1.5 整体效果相比上个版本提升 50.6%,在分析深度、信息完整性、可读性3 个维度的GSB指标均有显著优化。
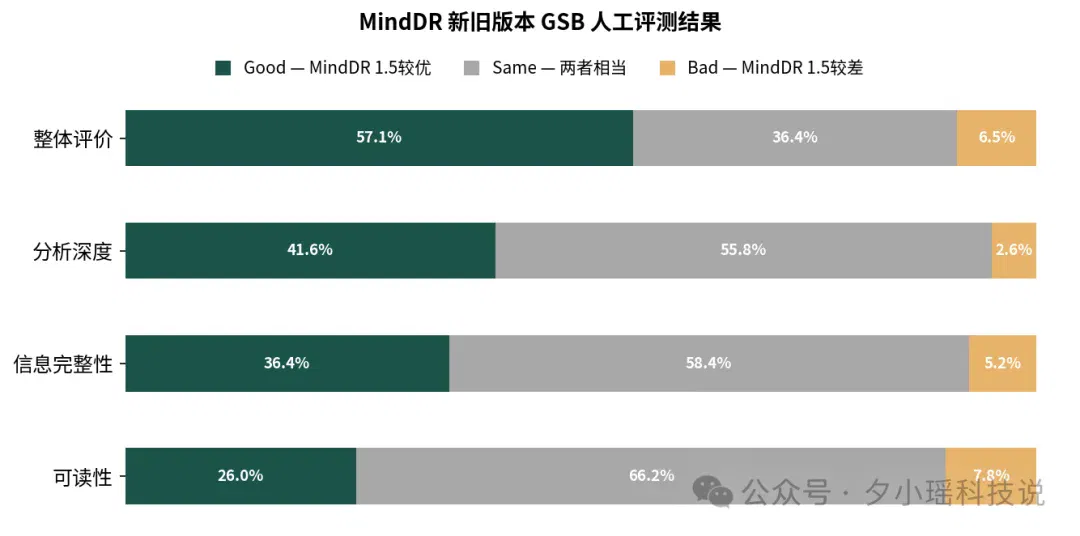
MindDR 1.5 与 1.0 版本双盲GSB评测,共收集 220 份有效结果
MindDR 1.5在下面两个基准上进行了评测:
DeepResearch Bench: 深度研究的公开评估基准,并设有官方排行榜:https://huggingface.co/spaces/muset-ai/DeepResearch-Bench-Leaderboard
MindDR Bench: 基于理想同学海量真实用户行为日志构建的中文深度研究评测基准,包含由专家团队严格筛选出的500条复杂开放性用户查询,兼具真实性、权威性与应用价值。
在DeepResearch Bench上,MindDR 1.5取得52.54分,超越国内外主流 Deep Research 产品,深度研究能力达到行业顶尖水平;在MindDR Bench上,MindDR 1.5以51.77分位居首位,验证了其在真实用户场景中稳定、优异的表现。
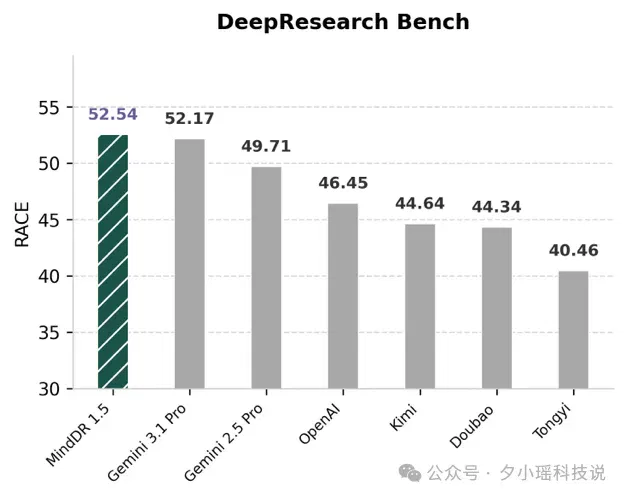
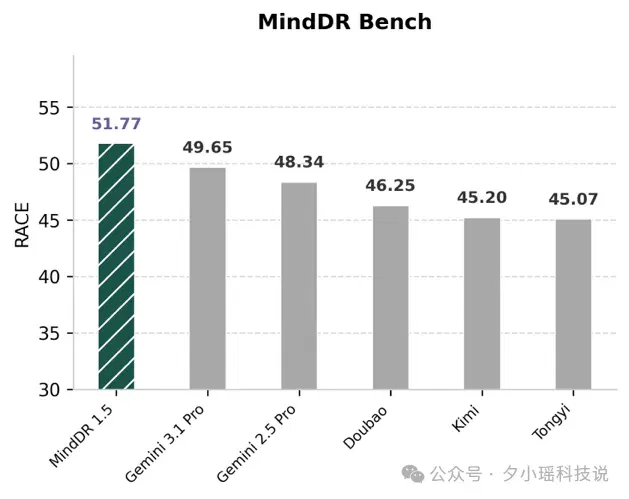
MindDR 1.5在DeepResearch Bench和MindDR Bench上的评测结果(评测时间:2026 年 04 月 13 日)说明:不同评测方法在测试集、参数配置、更新时间等方面存在差异,结果仅用于对比参考。
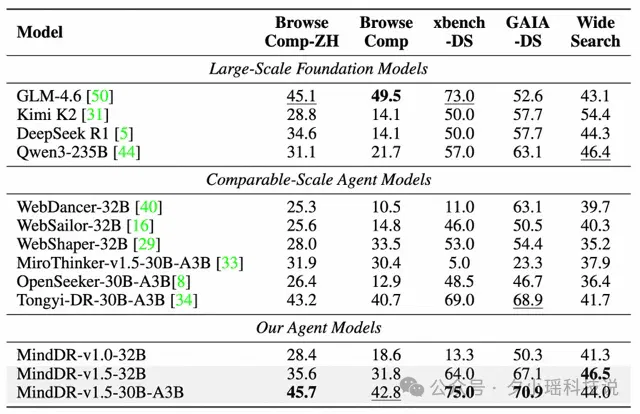
同时,在深度搜索的各项公开评测基准中,MindDR 1.5 均在同参数规模模型中处于领先地位,具备强大的信息检索与复杂推理能力,在 BrowseComp-ZH、BrowseComp、xbench-DS 与 WideSearch 基准上,MindDR 1.5 分别取得 45.7、42.8、75.0、46.5 的成绩。
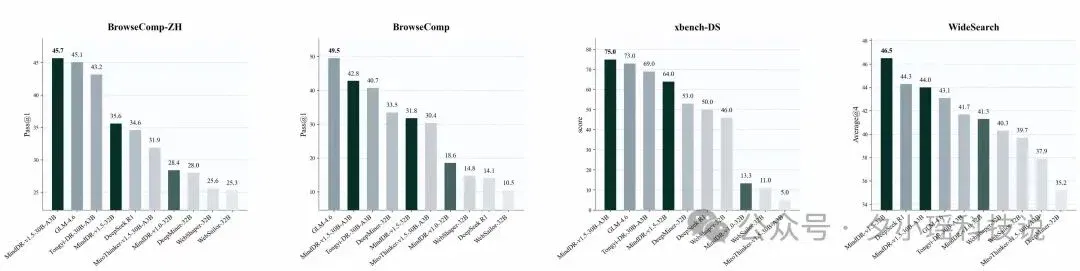
MindDR 1.5在搜索能力导向的公开基准上的评测结果
◈MindDR 1.5 技术解读
自 2024 年 Google 与 OpenAI 相继推出 Deep Research 产品以来,深度研究行业迎来快速发展。现有开源路线大多采用以下做法:一是在 mid-training 阶段通过大量数据扩展模型推理能力;二是在 post-training 阶段直接对“信息获取—分析整合—报告生成”的完整链路进行端到端训练。这会带来两个现实问题:训练成本高,以及搜索与写作耦合过深导致奖励稀疏、训练稳定性差。
为此我们推出MindDR 1.5,它基于自研模型和多智能体协作架构,在训练上跳过 mid-training 阶段,采用多阶段训练替代端到端优化,以较低成本在相对较小规模(30B)的模型上取得业界领先水平,性能优于同等规模的开源智能体系统,并能超越部分更大规模模型的效果。
下面我们将展开介绍多智能体架构和多阶段训练路线。关于 MindDR 1.5 的完整技术实现细节,欢迎阅读我们的论文:
Huggingface:
https://huggingface.co/papers/2604.14518
Arxiv:
https://arxiv.org/abs/2604.14518
◽多智能体协作架构
深度研究任务通常需要复杂任务拆解、多轮工具调用、跨来源验证,以及最终的长报告生成。如果把这些环节用单一智能体实现,不仅长上下文管理困难,也容易让搜索、推理和写作彼此干扰。
因此,MindDR 1.5 将完整流程拆分为三个分工明确的协作智能体:
- 规划者:Planning Agent,负责理解用户意图并拆解为独立子任务;
- 搜索者:DeepSearch Agent,负责接收子任务执行并行多轮检索、验证与长程推理,专注于信息获取与事实校验;
- 撰写者:Report Agent,负责整合搜索者提供的多来源证据,生成结构化高质量长报告。
三者之间通过Memory模块共享关键信息。其中,Extended Chain-of-Thought(XoT)负责记录工具调用结果、中间结论和关键推理线索,并对冗长信息进行结构化压缩。这样既能保留结果的可追溯性,也能避免长链路任务中上下文持续膨胀。
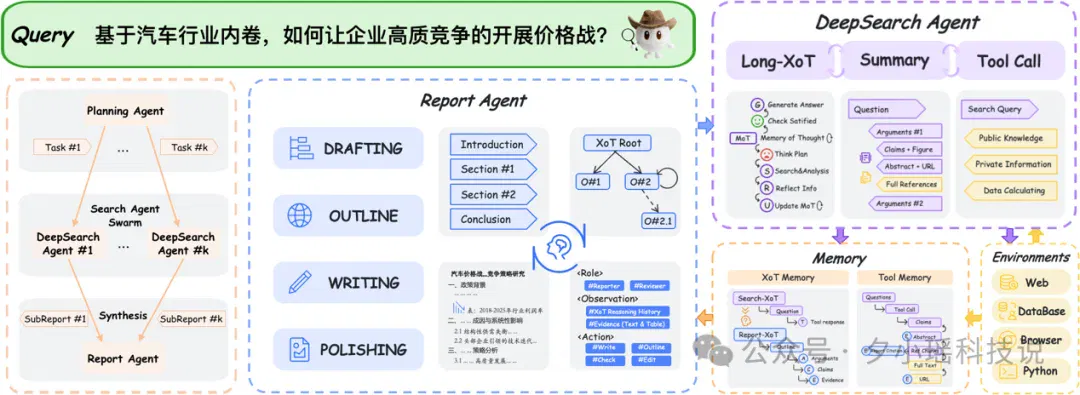
MindDR 1.5多智能体协作架构图
◽多阶段训练路线
多智能体架构解决的是“任务如何分工协作”,而多阶段训练解决的是“如何提升模型能力以完成分工”。
深度研究模型需要同时具备长程推理、工具调用、深度检索和长报告写作等多种能力。如果直接做端到端训练,模型必须在长任务链路里同时学会“怎么搜”和“怎么写”,而奖励往往要到整条链路结束后才能反馈。这会导致中间步骤监督不足、训练效率低且难以准确归因问题。
针对该问题,MindDR 1.5 将端到端训练拆分为功能独立的四阶段训练管线,每阶段构建不同的核心能力:
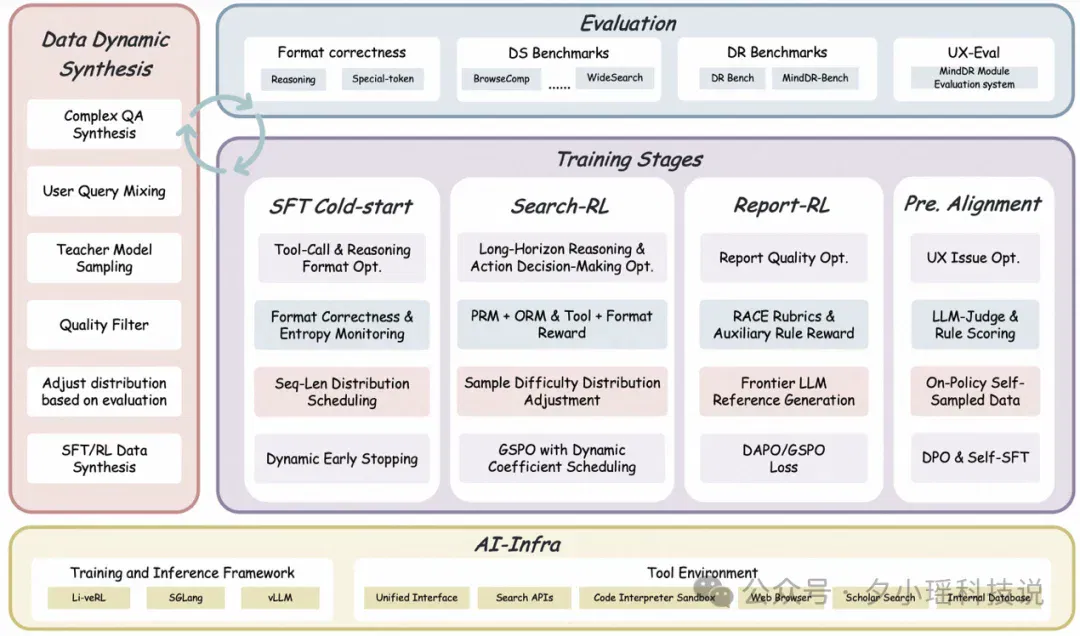
MindDR四阶段训练管线架构图
- SFT:负责模型冷启动,通过模仿学习建立工具调用、格式遵循与多轮推理的基础能力。
- Search-RL:专注优化深度搜索、信息获取能力。强化长链路深度搜索与自主决策能力,基于真实工具调用环境实现在线学习,结合奖励机制设计和动态调度,实现能力的渐进式提升。
- Report-RL:专注优化长篇报告撰写能力,以 RACE Rubrics 为核心牵引,结合引用格式作为辅助奖励,全面优化报告生成质量。
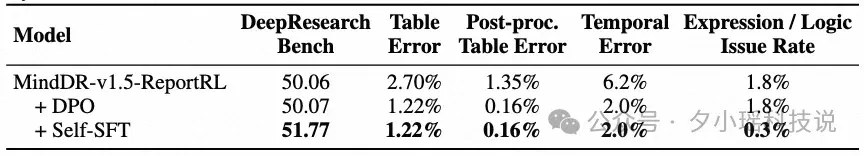
- 偏好对齐:进一步优化细粒度用户体验。包括时态一致性、表格格式正确率等,通过自采样 DPO 和 Self-SFT 将模型输出对齐到人类偏好分布,同时避免出现灾难性遗忘。
每个阶段仅围绕自身任务设计奖励机制,使模型能够获得更密集、明确的训练信号,从而更快速收敛,避免在长链路的稀疏反馈中缓慢探索。
该训练方式在性能和效率上带来了双重收益。在效率层面,MindDR 1.5 跳过了业界普遍采用的 mid-training 阶段,从流程上显著减少了训练资源消耗,同时相较于 MindDR 1.0 中以 RFT 为主的训练方式,训练 token 数量减少 71.4%,训练卡时降低 60%。
性能层面,我们同时探索了基于稠密模型和MoE模型多阶段训练的搜索和报告撰写性能。结果表明:经过 SFT 和 Search-RL 训练阶段,模型性能稳定提升;Report-RL 和对齐阶段由于灾难性遗忘导致搜索性能微降,但报告质量持续提升,以 30B 左右的小尺寸模型取得了业界领先水平。
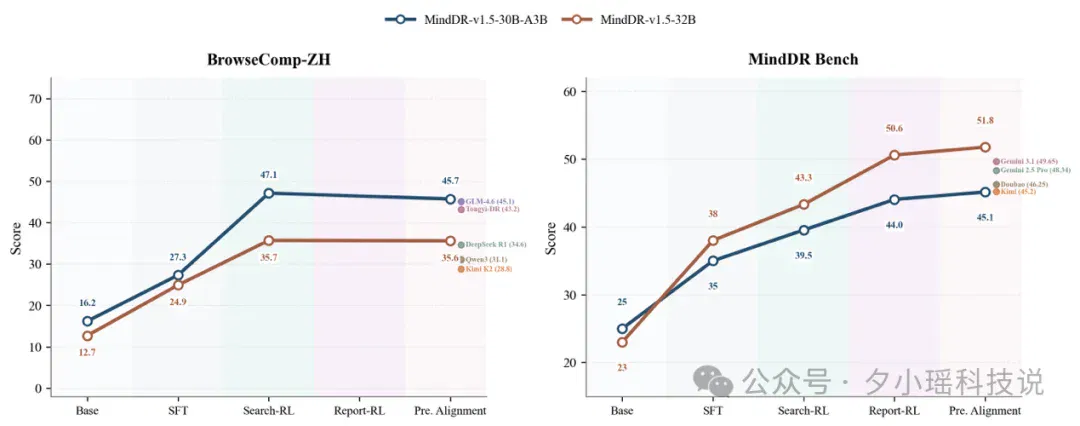
稠密模型和MoE模型多阶段训练性能与竞品对比
下面我们主要围绕RL及偏好对齐训练管线进行详细介绍。
Search-RL:深度搜索能力
在 SFT 奠定基础能力之后,Search-RL 进一步强化模型的长链路搜索与自主决策能力,使其从简单的动作模仿逐步演进为具备自主规划、检索、修正与判断的复杂决策系统。我们通过以下核心环节实现这一能力跃升。
数据合成
为满足深度搜索中长程推理的训练数据需求,我们构建了一套数据合成管线。该管线包含图谱构建、多跳子图采样、QA 生成与数据过滤四个阶段,用于生成高质量的复杂多跳问答对,从而支撑Search-RL训练。我们还在训练中集成了动态数据合成,随训练进程逐步增加数据难度,避免数据简单或者过难导致的训练不稳定问题。
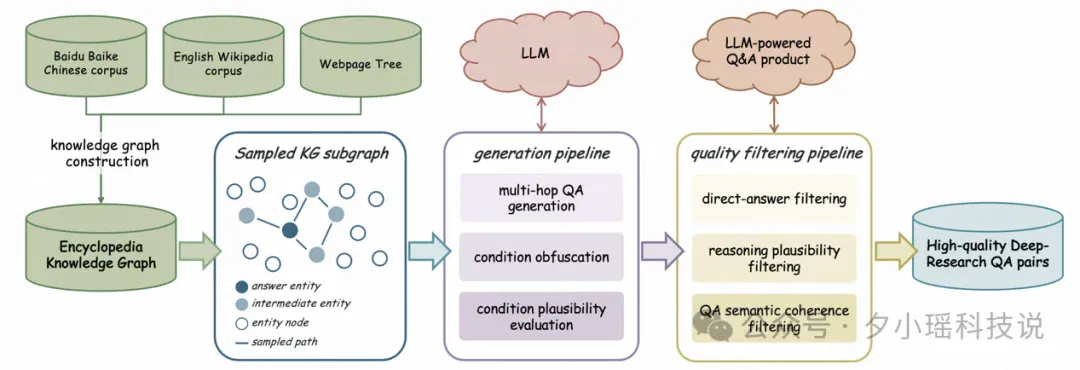
面向MindDR 1.5的复杂QA合成流程图
动态奖励:从基础行为到结果判断的能力递进
奖励机制是强化学习的核心驱动力。Search-RL 的奖励由四类信号构成:
- 工具调用奖励:逐步评估工具调用成功与否,对连续失败施加更强惩罚,引导模型快速规避错误行为;
- 格式奖励:逐步检查输出结构的规范性,同样采用不对称惩罚策略加速格式收敛;
- 过程奖励 PRM:基于查询关联的关键中间实体集合,通过字符串匹配统计推理过程中累计覆盖的实体比例 ,无需额外 LLM 推理即可提供低成本、可扩展的过程监督信号;
- 结果奖励 ORM:对最终答案的整体正确性进行端到端评估,输出二值判定 。
四类奖励通过归一化系数加权为轨迹级复合奖励:
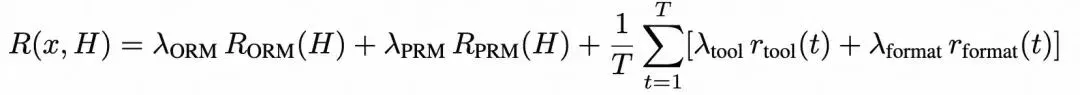
关键设计在于,四项系数并非固定不变,而是采用阈值触发的动态调度策略,遵循"从基础行为到深层推理"的递进逻辑:训练初期以工具调用与格式奖励为主,当基础能力饱和后,权重逐步向过程奖励和结果奖励转移,最终由 ORM 主导优化方向。这一自适应耦合机制确保每项能力在其对应的训练阶段获得集中监督,模拟了从基础技能到深度推理的"顿悟式"能力递进。
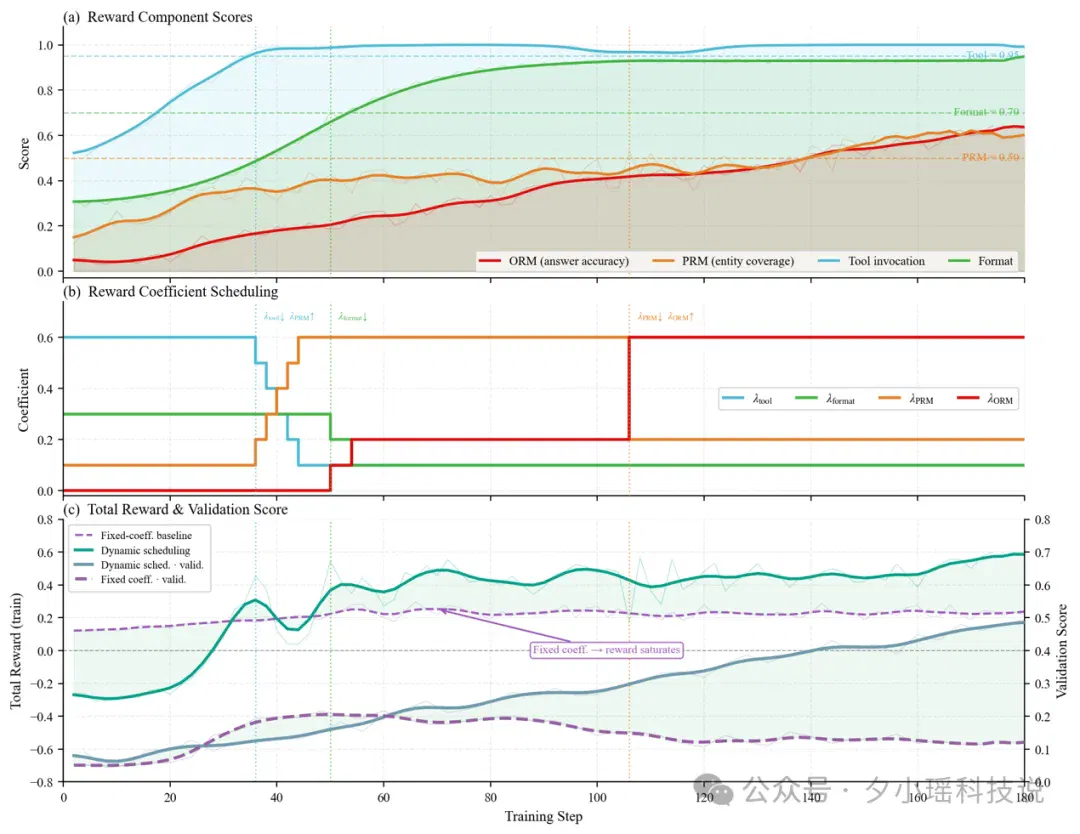
真实训练过程中各分项系数与总奖励的变化曲线,相比固定系数基线,动态调度能持续推动模型能力优化
训练推理性能
Search-RL的训练获得了明显的效果增幅,在各个DS测试集上,MindDR 1.5所属模型均取得了同参数量领先地位,并接近了大参数量开源模型水平。
而在不同的上下文长度、工具调用次数限制条件下,MindDR 1.5模型都展现了领先的深度搜索性能。
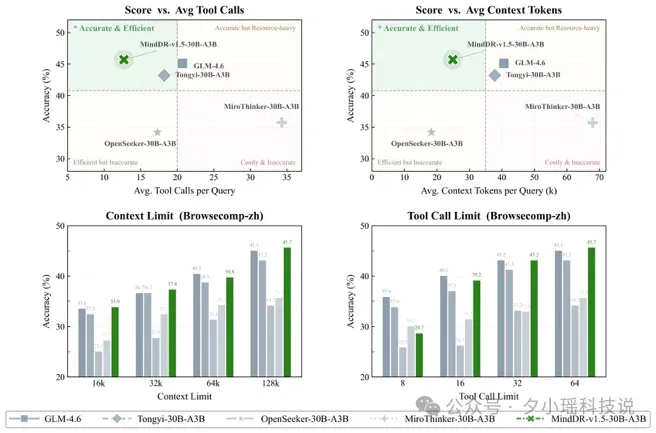
模型得分与工具调用次数预算、上下文长度预算的关系
Report-RL:优质报告生成能力
Search-RL 解决了“如何找到答案”的问题,Report-RL需要解决“如何将复杂检索结果整合成一篇高质量长报告”的问题。MindDR 1.5 以RACE Rubrics为核心奖励机制,围绕全面性、指令遵循、洞察力、可读性四个维度建立长报告质量优化目标,并进一步引入引用和格式奖励以优化用户体验。主要训练流程如下:长短文本输入策略模型生成报告,与前沿大模型生成的参考报告和rubrics进行对比,获取RACE得分奖励和辅助引用、格式奖励,通过RL算法优化策略模型参数。
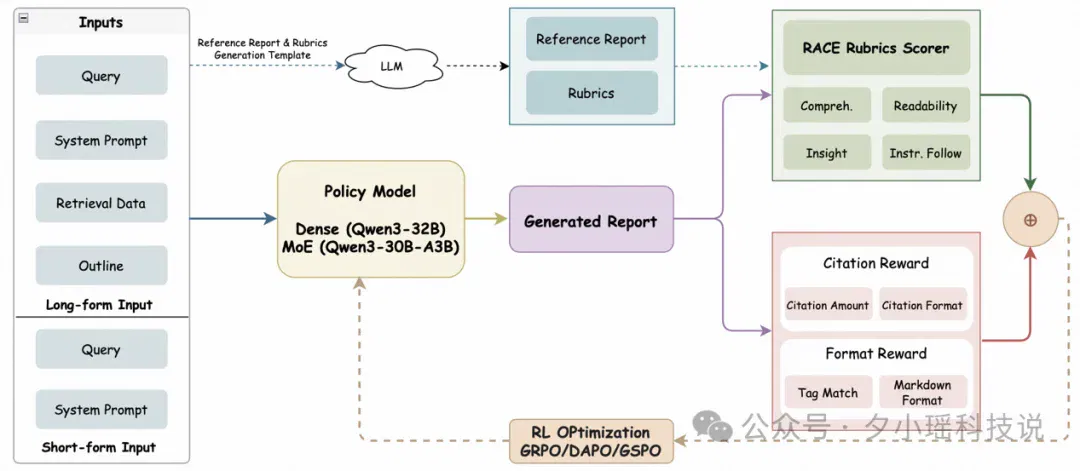
Report-RL训练框架图
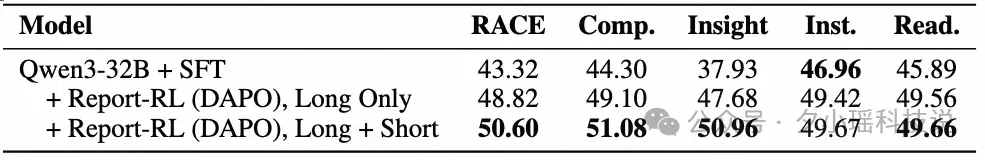
长短上下文数据混合训练
Report-RL 的训练数据融合了两种优势互补的形式:一类是包含完整检索结果的长上下文数据,能够最大程度还原真实检索与推理环境;另一类是仅由 Query 和系统提示词构成的短上下文数据,更聚焦于写作能力。在 MindDR Bench 上的对照实验评估中,模型得分由 48.82 提升至 50.60,验证了混合训练的互补优势。
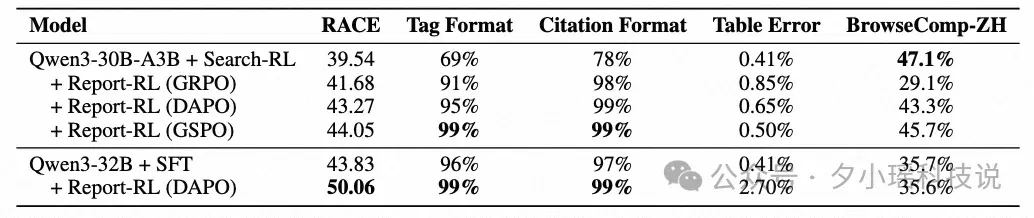
主奖励与辅助奖励协同作用
Report-RL 以深度研究评测基准中的 RACE Rubrics 作为核心奖励,优化长文本报告的生成质量,同时训练中加入了两类辅助奖励:引用奖励用于约束引用数量与有效性,格式奖励用于约束Markdown 结构与引用格式等问题,兼顾了内容质量和结构规范。
偏好对齐:细粒度体验优化
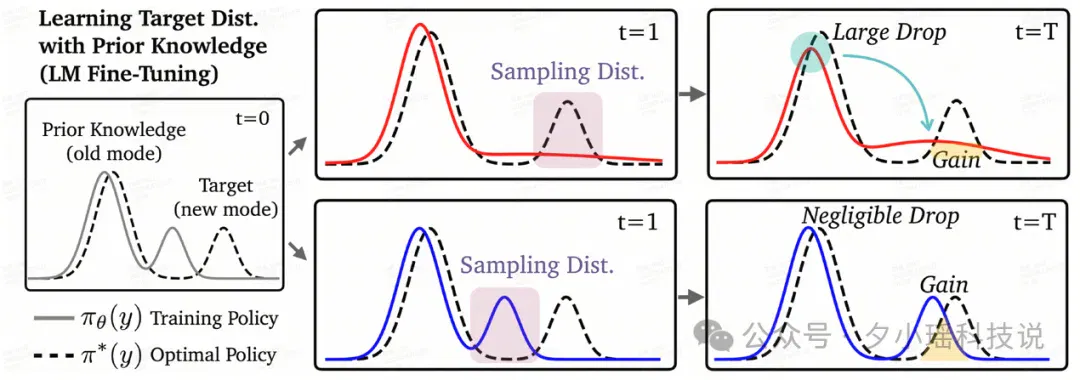
Self-SFT稳定训练防止灾难性遗忘原理。图片改自Self-SFT原论文(https://arxiv.org/pdf/2510.18874)
经过前面训练阶段后,模型在真实线上环境仍会出现一些细粒度用户体验问题,例如报告中时态不一致、表格格式错误、语言逻辑不够顺畅等。这类问题通常需要大模型配合prompt进行检测,因此不适合在RL阶段通过Reward子项进行优化。为此,MindDR 1.5 在最后加入偏好对齐阶段,采用“自采样 - 质量筛选 - 自采样DPO / Self-SFT 联合优化” 的技术方案,在避免灾难性遗忘的前提下实现模型稳定优化。使用Self-SFT方法和自采样数据能在较好保留模型原有模式分布基础上实现新能力构建(如上图右侧蓝色曲线所示),避免了使用分布外的蒸馏数据导致原有能力灾难性遗忘(如上图右侧红色曲线所示)。具体训练过程如下:
- 自采样 DPO 适合处理局部、模式明确的问题,我们用来修复时态和表格排版错误等问题;
- Self-SFT 能优化更整体的效果表现,我们用来提升逻辑和表达一致性,使报告更自然、连贯。
两种方法的接续训练有效优化了用户体验问题,并进一步优化了Benchmark成绩。
◽总结
MindDR为深度研究领域提供了一套「小模型、低成本、高性能」的训推范式,通过多智能体协作推理框架以及多阶段训练管线在小尺寸模型上取得业界领先性能,为深度研究智能体以及通用智能体发展探索了新的技术路径。
文章来自于"夕小瑶科技说",作者 "夕小瑶科技说"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
NVIDIA GTC上登顶的DeepResearch Bench,到底在评什么? (opens in a new tab)
3 月 16 日,在刚刚结束的 NVIDIA GTC 2026 大会上,黄仁勋在长达三小时的 Keynote 演讲中发布了 NVIDIA Agent Toolkit 和 AI-Q 开放智能体蓝图,将 AI Agent 定位为下一个重大前沿。
21独家|AI人才失血之际,“世界模型大将”加盟理想,向詹锟汇报 (opens in a new tab)
理想汽车在AI人才离职潮中引入世界模型专家刘宇,任具身行为部负责人,专注研发机器人基座模型并向詹锟汇报。
蚂蚁与西湖心辰介绍Duo v1,探索全双工视听交互 (opens in a new tab)
Duo v1通过Intent与Realization模块衔接交互决策和音视频生成。文章报告30组交互、180项检查中通过168项,内容响应度为73.3%;复杂意图理解与长程一致性仍是团队后续优化方向。
EgoExplorer captures mobile manipulation with five trackers and a camera (opens in a new tab)
Shanghai AI Lab presents a wearable capture system using trackers, gloves and a camera, plus C³ motion reconstruction, and releases 100 hours of data and code. Reconstruction and multimodal generation are assessed separately; humanoid transfer is shown only in simulation.

ConvexLLM connects speech to language models through frozen text embeddings (opens in a new tab)
Researchers at CUHK-Shenzhen and Microsoft propose C-Gate, mapping audio into convex combinations of frozen text embeddings. The paper reports VoiceBench gains against its listed open-model baselines, while audio understanding and transcription still involve trade-offs.