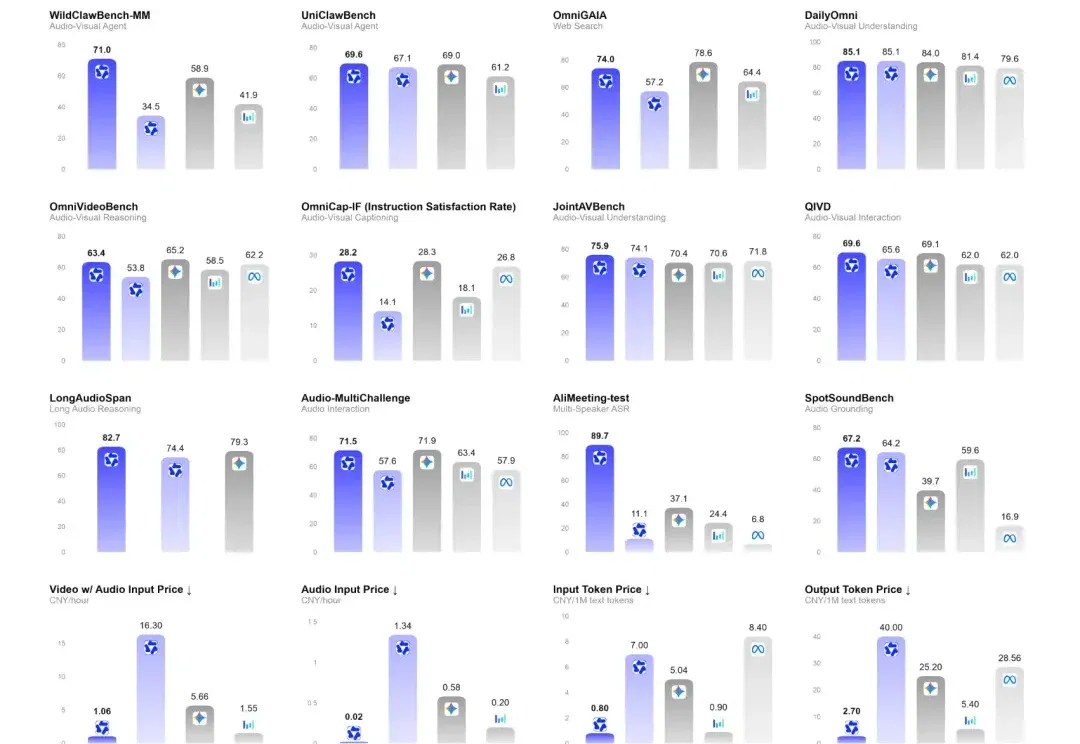
实测Qwen3.8-Omni-Flash:全模态Agent有了“白菜价” (opens in a new tab)
千问把全模态Agent的使用成本,直接砍掉了90%!
Total 219 articles
千问把全模态Agent的使用成本,直接砍掉了90%!
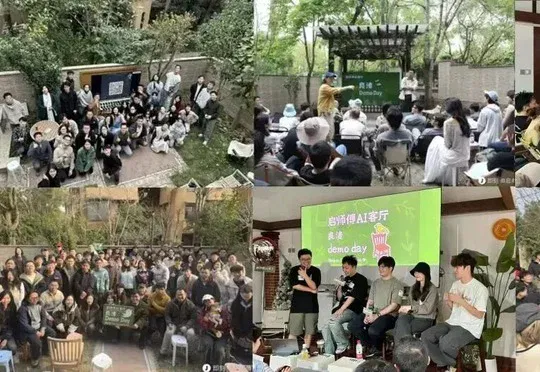
杭州自9月20日起向35家市级大学生创业园每人发放一张含1万积分的千问办公token卡,这是千问办公接入Qwen3.8-Max一个月后杭州首次将算力帮扶平铺到个人,标志着其AI产业思路从支持做模型的企业转变为支持用模型的人。
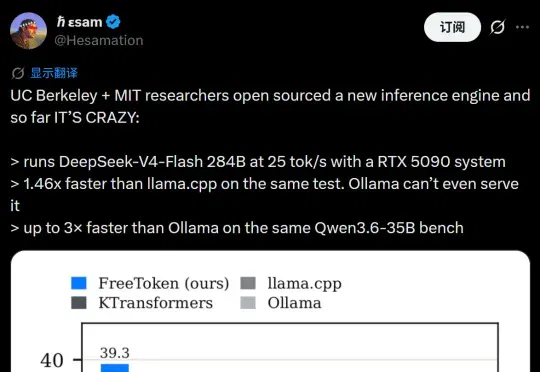
本周五,AI 社区热烈讨论的是一个端侧大模型部署技术,它能让笔记本 RTX 4060 跑 Qwen 3.6-35B,桌面 RTX 5090 跑得起 DeepSeek-V4-Flash 284B。而且都是单卡,模型都是满血的。Codex 生产 trace 的中位 decode 速度是 33 token/s
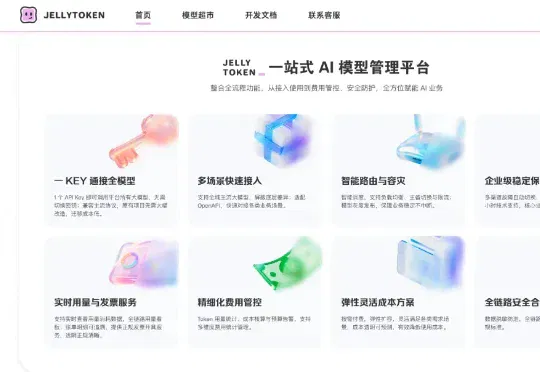
由阿里巴巴集团孵化的空间智能企业“元境”,正在内测“JellyToken”,平台定位AI大模型一站式超市,支持一套密钥调用多款模型。该平台整合了Qwen3.7、Seedance2.0等多款国产大模型,面向个人创作者、中小团队、企业推出付费统一调用服务。
全球最强编程模型,中国造。 你可以从同事.skill 的爆火中看到两种截然不同的时代情绪,其一固然是对 Markdown 文件“大变活人”这一魔幻现实的试探,而反面则是如今对模型能力的评价,已经离不开工作级任务的场景。 “AI 能不能替代程序员”的老生常谈之下,今天的真问题是,国产大模型能在多大程度上接管开发工作流。 这背后是一个被反复验证的痛点:当 AI Agent 被放进真实项目,它并没有想象中那么“能扛活”。它能开始任务,但执行过程反复中断,多轮对话后上下文丢失,结果前后不一致。面对非标准需求时,工具调用也频频失误。你一觉醒来,发现流程早已卡死,标准结局总是如此。 问题的根源不在 Age
刚刚,谷歌正式发布 Gemma 4,称“这是其迄今为止最智能的开放模型系列”。该系列面向复杂推理与智能体工作流设计,采用商业许可的 Apache 2.0 许可证开源。Gemma 4 提供四种规格:Effective 2B(E2B)、Effective 4B(E4B)、26B 混合专家模型(MoE)和 31B 稠密模型(Dense)。
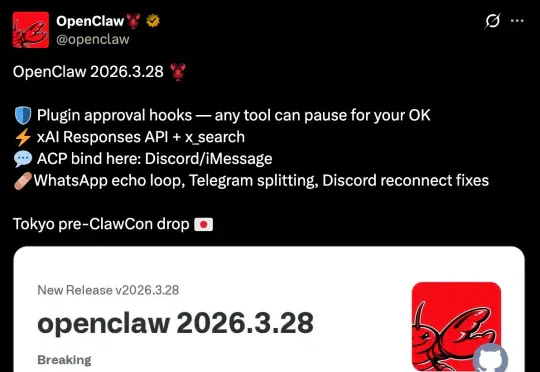
今天,OpenClaw 直接推送了最新的 3.28 版本。这次更新的内容也是格外丰富,简直是底层能力的全面大解放。简单挑几个跟日常体验关系最大的。Qwen 模型正式迁移到了 Model Studio,直接走新的认证选项,干净利落。
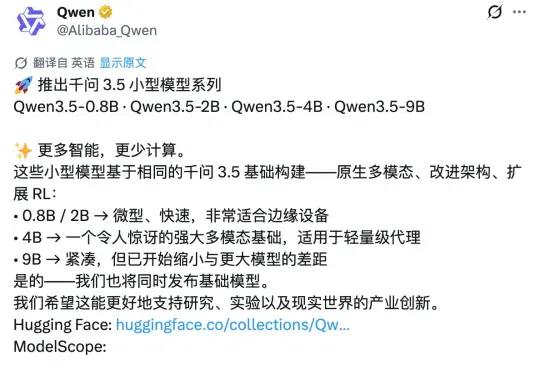
昨天深夜,阿里通义千问团队在 X 平台正式发布了 Qwen3.5 小模型系列,覆盖 0.8B、2B、4B 和 9B 四个参数规格。甫一发布,便在海外科技圈引发强烈反响。马斯克也在该推文下评论称:「Impressive intelligence density」(令人印象深刻的智能密度)。这股热度的背后,APPSO 也好奇,为什么这几款小模型能够激起如此大的波澜?
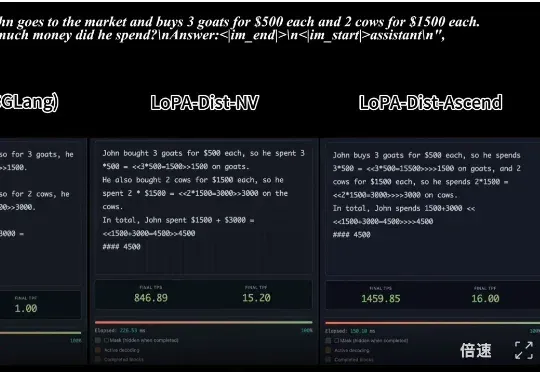
,时长 00:20 视频 1:单样例推理速度对比:SGLang 部署的 Qwen3-8B (NVIDIA) vs. LoPA-Dist 部署 (NVIDIA & Ascend)(注:NVIDIA 平台
当前,AI 领域的研究者与开发者在关注 OpenAI、Google 等领先机构最新进展的同时,也将目光投向了由前 OpenAI CTO Mira Murati 创办的 Thinking Machines Lab。