Thinking Machines首款产品重大更新:K2 Thinking、Qwen3-VL都可以微调了
当前,AI 领域的研究者与开发者在关注 OpenAI、Google 等领先机构最新进展的同时,也将目光投向了由前 OpenAI CTO Mira Murati 创办的 Thinking Machines Lab。
当前,AI 领域的研究者与开发者在关注 OpenAI、Google 等领先机构最新进展的同时,也将目光投向了由前 OpenAI CTO Mira Murati 创办的 Thinking Machines Lab。
今年早些时候,他们推出了首款产品Tinker(在新窗口打开):这是一个 API,用于帮开发者 / 研究人员微调语言模型。你只需要专注于训练数据和算法,而你不擅长的关于 Infra 的部分 —— 调度、调优、资源管理和 Infra 可靠性 —— 统统由 Tinker 来搞定,从而大大简化了 LLM 的后训练过程。
此前,Tinker 仅向研究人员和开发者开放内部测试;而如今,Thinking Machines 宣布正式取消候选名单,所有用户都可以直接使用 Tinker。
除此以外,Tinker 还带来了其他三项更新:
首先,更强推理能力:用户现在可以在 Tinker 上对 Kimi K2 Thinking 进行微调。 Kimi K2 拥有万亿参数规模,是 Thinking Machines 目前规模最大的模型,专为长链推理和工具调用场景而设计。
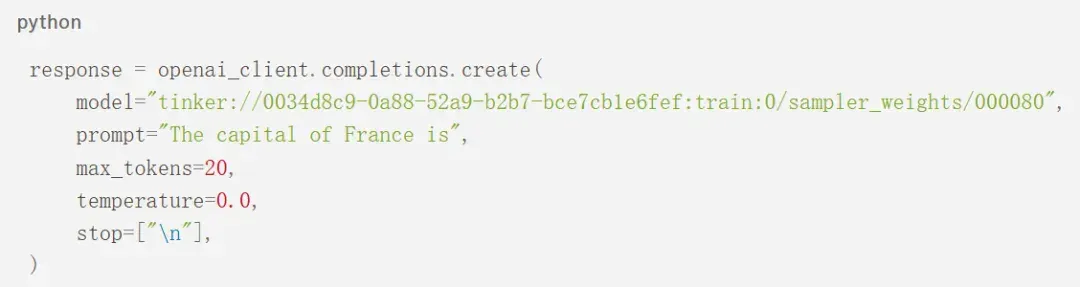
其次,兼容 OpenAI API 的全新推理接口:Tinker 提供了标准的推理接口,例如:
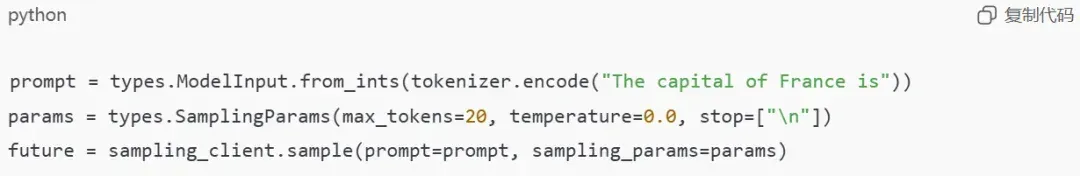
借助本次发布,Tinker 还新增了兼容 OpenAI API 的接口封装,用户只需通过指定模型路径,即可对模型进行快速采样,即使模型仍处于训练过程中也可以使用。
这也意味着,Tinker 现在可以即插即用地接入任何兼容 OpenAI API 的平台。
最后,Qwen3-VL 支持视觉输入。Tinker 新增了两款视觉模型:Qwen3-VL-30B-A3B-Instruct 和 Qwen3-VL-235B-A22B-Instruct。借助这些模型,用户可以在多种应用场景中处理图片、截图以及示意图等视觉内容。
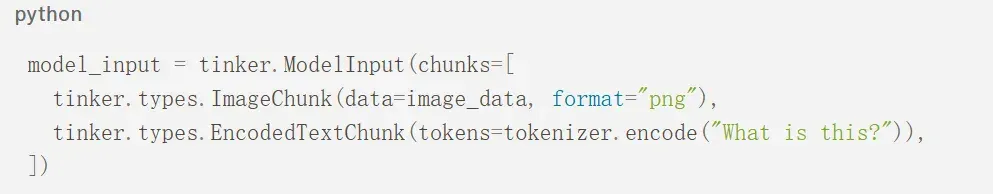
这些视觉输入开箱即用,可直接应用于多种任务场景,包括监督微调和强化学习微调。
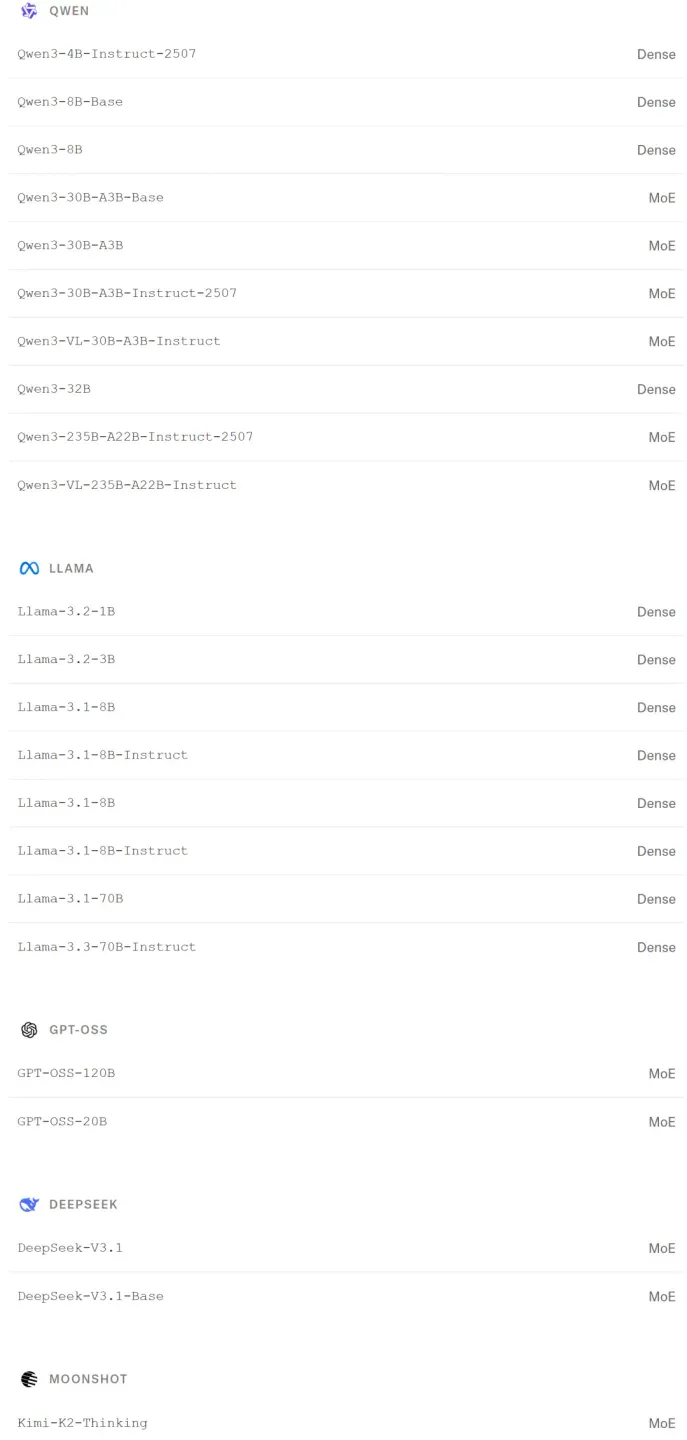
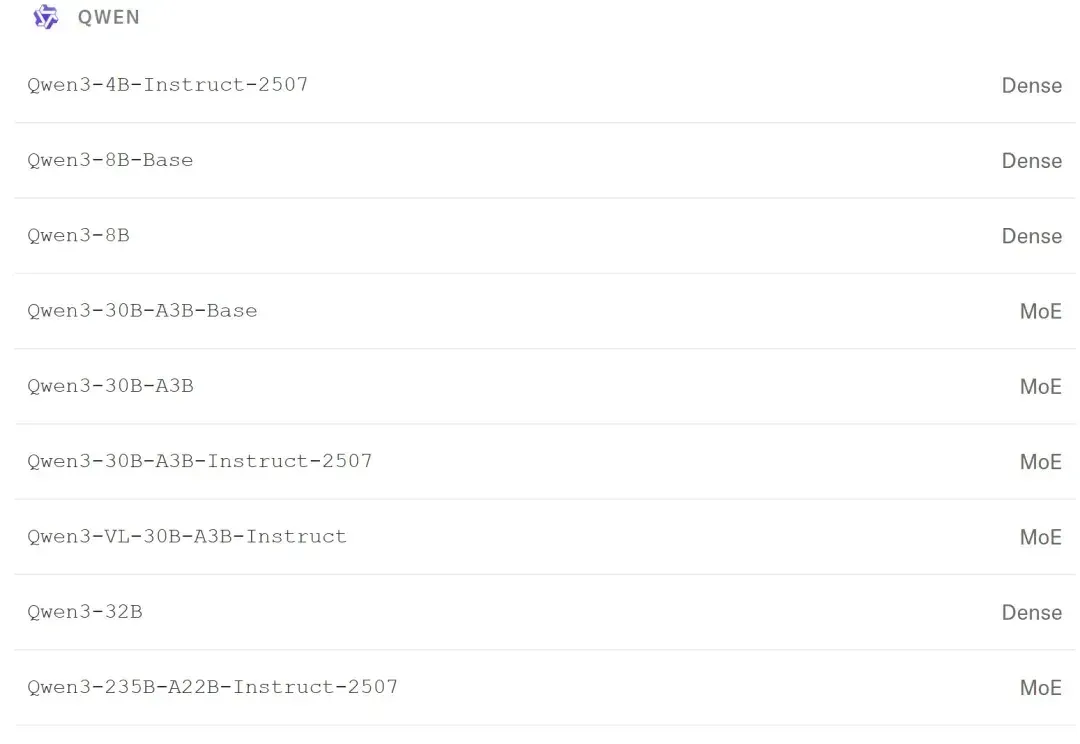
Tinker支持的模型
过去,开发者若想训练或微调前沿大模型,必须自行采购 GPU、搭建集群、处理 CUDA/NCCL 环境、维护分布式训练稳定性,门槛极高且成本巨大。
而 Tinker 通过将所有训练基础设施抽象为一个 API,使开发者无需管理任何算力资源,只需准备数据和算法即可训练模型。更重要的是,此次更新首次让普通开发者能够微调万亿参数的 Kimi K2 Thinking,这本来是只有顶级实验室才能掌握的能力,视觉输入的加入进一步降低了 VLM 应用门槛。
对此,研究者纷纷表示:「能够在无需自行管理 GPU 基础设施的情况下训练自定义图文数据,对开发者来说是一项巨大的进步。」
使用 Tinker 训练图像分类模型
为了展示 Tinker 新增的视觉能力,Thinking Machines Lab 对 Qwen3-VL-235B-A22B-Instruct 进行了微调,并将其应用于多项经典图像分类基准测试中。
具体而言,研究团队选择了四个常用的数据集进行评估,包括:
- Caltech-101:包含 101 类常见物体的数据集
- Stanford Cars:涵盖汽车品牌、型号和年份的数据集
- Oxford Flowers:花卉品种数据集
- Oxford Pets:宠物品种数据集
由于 Qwen3-VL 本质上是语言模型,研究中将图像分类任务建模为文本生成问题:给定一张图片,模型直接输出对应的类别名称。研究人员将这一方法与传统的视觉基线方案 DINOv2 进行了对比。
DINOv2 是一种通过自监督方式训练的视觉 Transformer,常被用作纯计算机视觉任务的 backbone。对于 DINOv2,研究中在其模型之上添加了一个分类头,用于预测所有 N 个类别的概率分布。两种模型均采用 LoRA 方式进行微调。
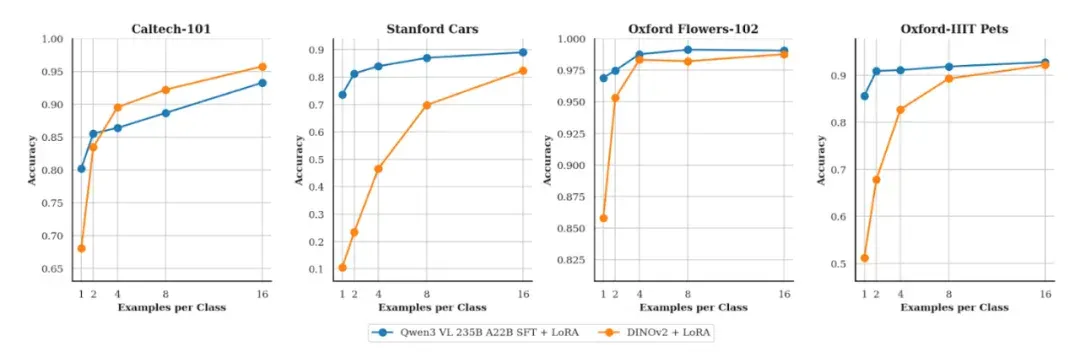
图中展示了经过微调的 Qwen3-VL-235B-A22B 与 DINOv2 在简单图像分类任务上的性能对比。
在小样本数据场景下,Qwen3-VL-235B-A22B 的表现优于 DINOv2。这不仅是因为其模型规模更大,更重要的是,作为视觉语言模型(VLM),它天然具备语言知识(例如知道「向日葵」指代什么)。正是这种通用的语言与视觉联合能力,使得 Qwen3-VL 在图像分类之外,也能够更方便地迁移到其他视觉任务中。
还没体验的小伙伴,Tinker 绝对值得一试。
参考链接:
https://thinkingmachines.ai/tinker/
https://thinkingmachines.ai/blog/tinker-general-availability/
文章来自于“机器之心”,作者 “机器之心编辑部”。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Thinking Machines 刚发的「边听边说」,让我想到了几个月前的面壁智能 (opens in a new tab)
OpenAI 前 CTO Mira Murati 和前应用研究负责人翁荔(Lilian Weng)创立的 Thinking Machines Lab,也就是 TML,刚刚发布了一个叫「Interaction Models」的研究
真·养虾!3步让龙虾边聊边进化,不用GPU不用数据集就能强化学习 (opens in a new tab)
让OpenClaw帮干活还不够,现在,程序员们正想方设法让🦞自己变强。
Thinking Machines曝LoRA终极指南:10倍学习率,媲美全参微调 (opens in a new tab)
LoRA能否与全参微调性能相当?在Thinking Machines的最新论文中,他们研究了LoRA与FullFT达到相近表现的条件。Thinking Machines关注LoRA,旨在推动其更广泛地应用于各种按需定制的场景,同时也有助于我们更深入审视机器学习中的一些基本问题。
翁荔陈丹琦加盟的840亿AI公司,公开第二篇论文 (opens in a new tab)
明星创业公司Thinking Machines,第二篇研究论文热乎出炉!公司创始人、OpenAI前CTO Mira Murati依旧亲自站台,翁荔等一众大佬也纷纷转发支持:论文主题为“Modular Manifolds”,通过让整个网络的不同层/模块在统一框架下进行约束和优化,来提升训练的稳定性和效率。
她们估值840亿,刚发了第一个AI成果 (opens in a new tab)
刚刚,0产出估值就已冲破120亿美元的Thinking Machines,终于发布首篇研究博客。