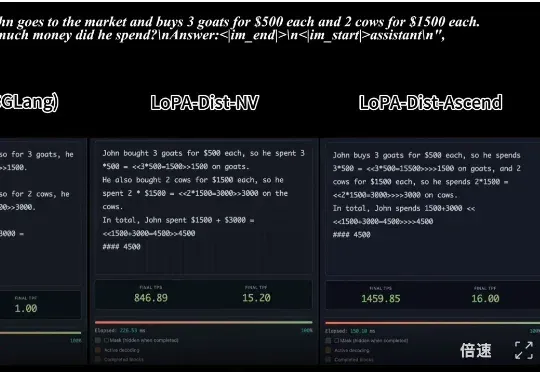
7B扩散语言模型单样例1000+ tokens/s!上交大联合华为推出LoPA (opens in a new tab)
,时长 00:20 视频 1:单样例推理速度对比:SGLang 部署的 Qwen3-8B (NVIDIA) vs. LoPA-Dist 部署 (NVIDIA & Ascend)(注:NVIDIA 平台
Total 62 articles
,时长 00:20 视频 1:单样例推理速度对比:SGLang 部署的 Qwen3-8B (NVIDIA) vs. LoPA-Dist 部署 (NVIDIA & Ascend)(注:NVIDIA 平台
近日,垂直于招投标领域的 AI 科技领军企业“深入云境”正式宣布:旗下核心产品 “云境标书AI” 成功入选 NVIDIA 初创加速计划(NVIDIA Inception)。这一里程碑式的进展,标志着云境标书AI在技术创新性、行业应用前景及商业潜力方面获得了全球顶级算力与AI生态巨头的权威认可。
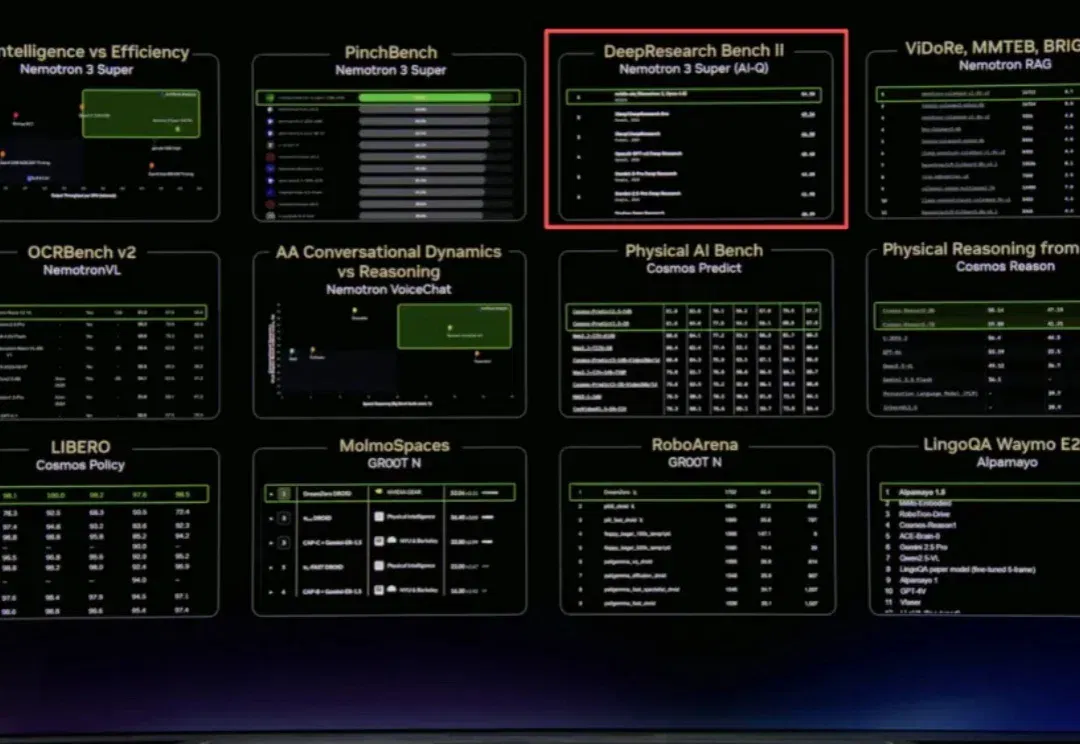
3 月 16 日,在刚刚结束的 NVIDIA GTC 2026 大会上,黄仁勋在长达三小时的 Keynote 演讲中发布了 NVIDIA Agent Toolkit 和 AI-Q 开放智能体蓝图,将 AI Agent 定位为下一个重大前沿。
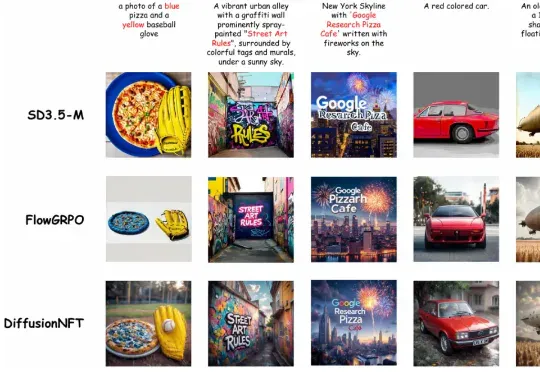
清华大学朱军教授团队,NVIDIA Deep Imagination 研究组与斯坦福 Stefano Ermon 团队联合提出了一种全新的扩散模型强化学习(RL)范式 ——Diffusion Negative-aware FineTuning (DiffusionNFT)。该方法首次突破现有 RL 对扩散模型的基本假设,直接在前向加噪过程(forward process)上进行优化
Gradium 是一家总部位于巴黎、提供语音 AI 模型的初创公司,其对种子轮向包括 NVIDIA 在内的新投资者重新开放后,本轮融资总额现已达 1 亿美元,该公司周四表示 。这家初创公司是从法国 AI 实验室 Kyutai 分拆出来的(该实验室由 Niel 支持)。
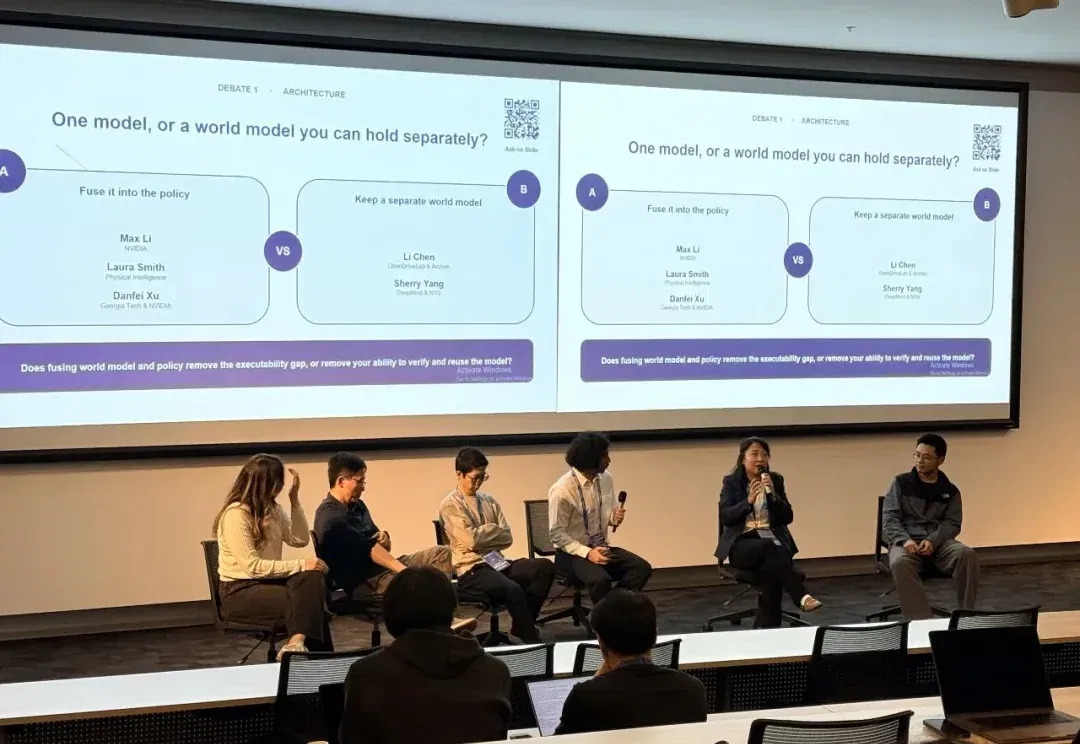
数据从哪来?控制靠像素还是动作? 在具身智能与机器人领域迅速演进的今天,一个问题正在浮出水面: 要想让机器人真正走进千家万户,我们到底该靠特定硬件采集的“具身数据”,还是该拥抱浩瀚如海的“互联网与人类行为数据”? 2026年RSS大会最后一天的workshop圆桌讨论,现场火药味十足。五位专家围绕世界模型的实际落地展开激烈交锋。 来自Georgia Tech和Nvidia的徐丹飞,以组合世界模型的研究闻名;Google与NYU的Sherry Yang,专注物理代理的世界模型评估与改进;Physical Intelligence的Laura Smith,强调具身智能的实践落地;NVIDIA的Ma
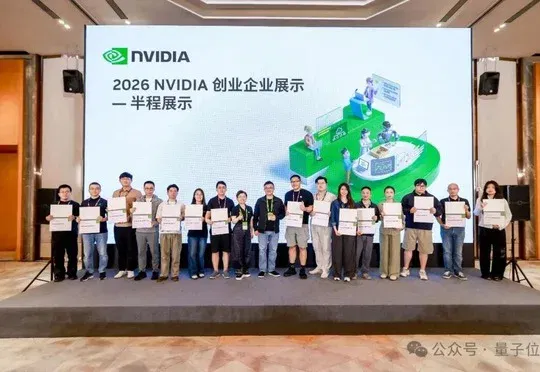
达瓦科技凭借实时世界模型产品Scenes AI拿下NVIDIA半程展示卓越企业奖,其34B模型在单张NVIDIA GeForce RTX消费级显卡上实现720P、25帧实时输出。
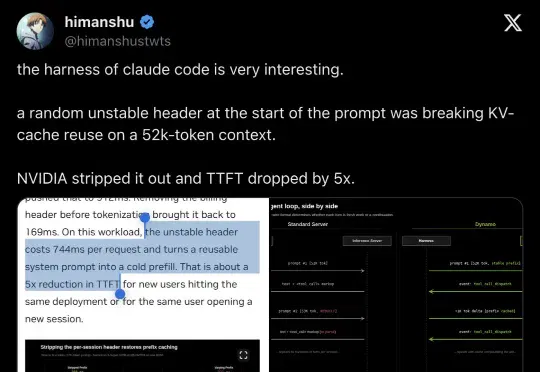
NVIDIA Dynamo 团队发现,Claude Code 向自定义端点发送请求时,prompt 最前面会带一行 session-specific billing header。这行 header 每个 session 都变,导致 52K token 的稳定前缀在 KV cache 中无法复用——TTFT 从 168ms 飙到 912ms。Dynamo 加了一个 `
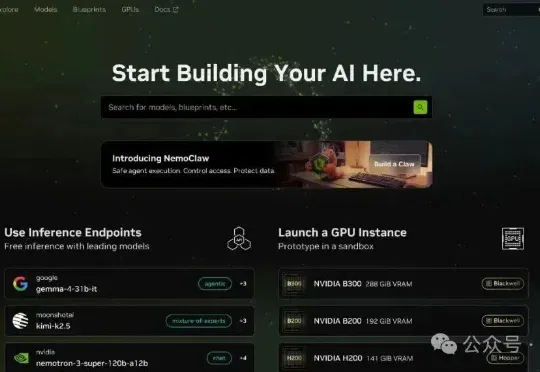
英伟达良心福利!免费领一年顶级大模型订阅,MiniMax / Kimi / DeepSeek 全都能用!NVIDIA 官方平台build.nvidia.com开放了一批"Free Endpoint"模型,注册账号、验证手机号后就能生成一把最长有效期12 个月的 API Key,免费调用几十个当下最火的大模型——不计 Token、无余额限制、无需信用卡。
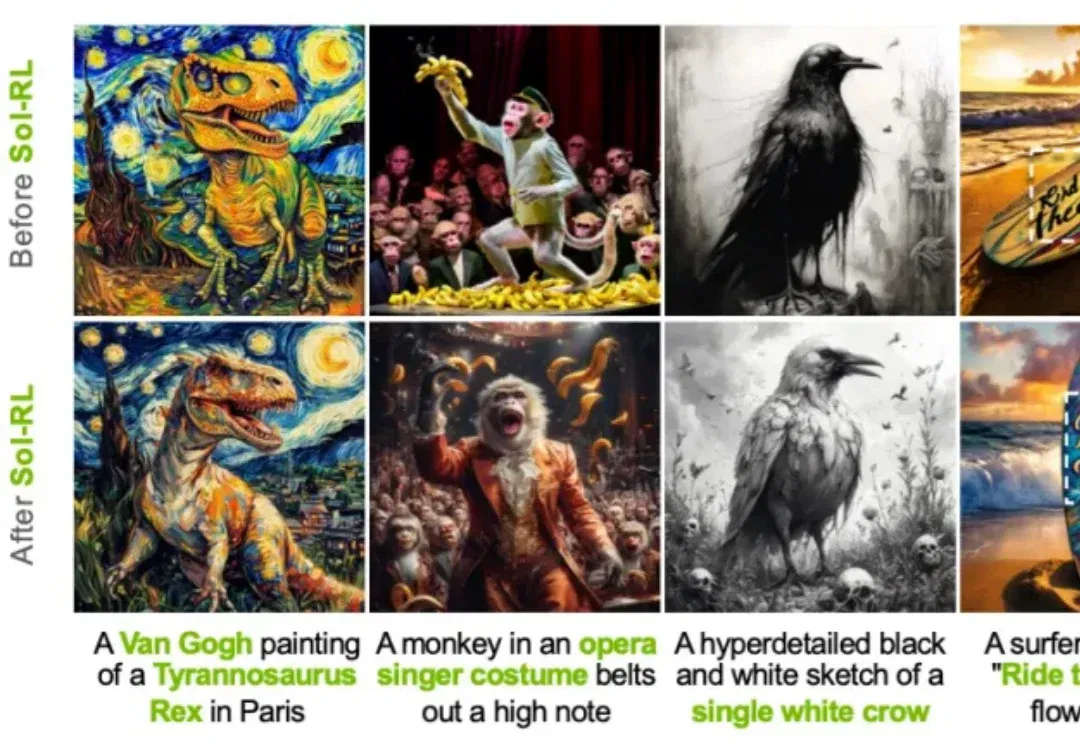
当强化学习后训练的大规模 rollout 已经被证明能够提升图像生成模型的偏好对齐能力,推理负担就成了制约训练速度的核心瓶颈。来自 NVIDIA、港大和 MIT 的团队提出的 Sol-RL,通过「FP4 先探索、BF16 再训练」的后训练框架,将达到等效 reward 水平的收敛速度最高提升到 4.64x,在训练速度与对齐效果之间给出了一条更具工程可行性的解法。