具身大模型R1时刻:LIBERO终结者,99.9%背后的物理推理新范式 (opens in a new tab)
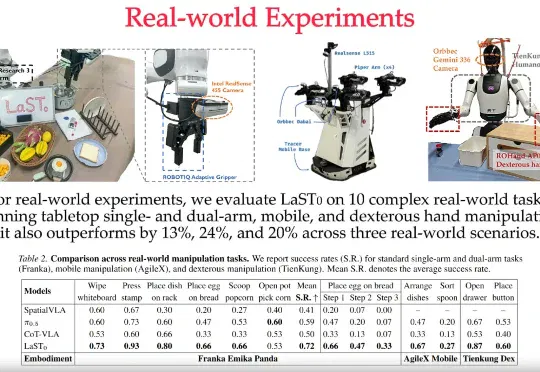
机器人拉个拉链,到底需不需要“脑子”? 过去几年,从OpenVLA到π0、π0.5,具身大模型已经能让机器人把指令和动作连得有模有样。 但一旦包的位置挪了几厘米,或者光照暗了一点,它们往往就会“大脑宕机”。 究其原因,是因为这些机器人大多在玩“连连看”:看到观察结果,直接输出动作。 它们只是记住了轨迹,却并不理解背后的物理逻辑。 现在,一种让机器人“先想明白,再稳定行动”的新范式来了。 由至简动力、北大、港中文联合提出的LaST-R1,首次将隐空间物理推理塞进了强化学习的闭环。 同时,LaST-R1作为LaST₀基座模型的物理世界后训练范式,LaST₀首创面向机器人的隐空间物理思维链推理,并已