刚刚,DeepSeek开始频繁更新:Tile Kernels、DeepEP V2 (opens in a new tab)
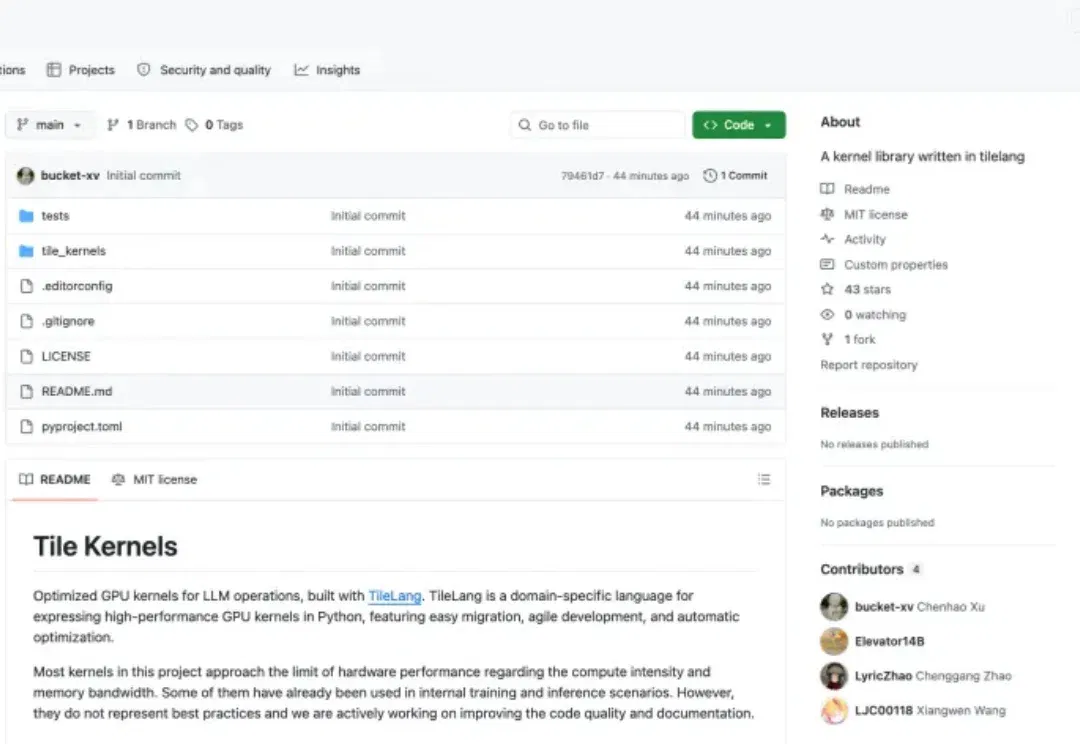
就在刚刚,DeepSeek 的 GitHub 开始了频繁更新,上线开源了一个新的代码库 Tile Kernels,同时并对 DeepEP 代码库进行了更新,上线了 DeepEP V2。距离上次 DeepSeek 悄悄更新 Mega MoE、FP4 Indexer 还不到一周。
Total 13 articles
就在刚刚,DeepSeek 的 GitHub 开始了频繁更新,上线开源了一个新的代码库 Tile Kernels,同时并对 DeepEP 代码库进行了更新,上线了 DeepEP V2。距离上次 DeepSeek 悄悄更新 Mega MoE、FP4 Indexer 还不到一周。
ForgeKernel 通过架构里程碑、硬件经验积累和实测反馈生成优化算子。团队展示了在 B200 上从数学定义出发优化 FlashMLA Prefill 的过程,并介绍昇腾评测与训练框架接入;单个算子的加速幅度不能直接折算为整机性能或全球算力开支节省。
Thinking Machines Lab成立7个月,估值120亿美元,首次公开研究成果:LLM每次回答不一样的真凶——kernel缺乏批处理不变性。Lilian Weng更是爆猛料:首代旗舰叫 Connection Machine,还有更多在路上。
DeepSeek开源面向华为昇腾算力平台的基础设施组件,涵盖TileLang编译工具及DeepGEMM、DeepEP、TileKernels、FlashMLA、DeepSelect等计算与通信库,华为亦在CANN社区开源双方围绕昇腾950及超节点的联合创新实践。
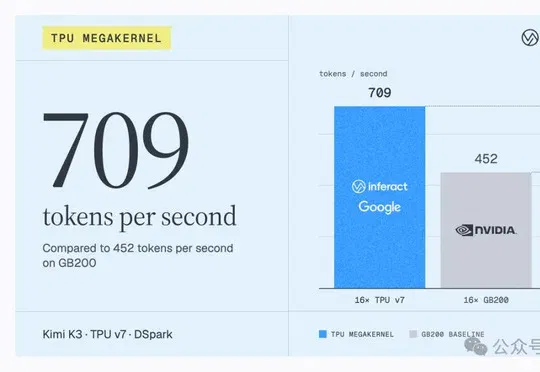
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
CUDA又双叒叕被创了… 这回动手的,还是英伟达亲手喂大的AI。 一家成立仅一年的小公司,用AI编程Agent,只花10小时,就搭出了一套「类CUDA软件」。 停停停。 你是说这套英伟达花了近20年搭起来的软件帝国,就这么被复刻了?? 不止如此。DeepSeek也在尝试少写一点底层CUDA。 他们已经开源了一套名为TileKernels的GPU算子库,用TileLang来编写,省去了大量手写底层CUDA代码的工作。 不过类似的「CUDA危机」,咱也不是第一次听了。 每隔一段时间,CUDA都要被拎出来鞭打一番,动辄替代了、击穿了、护城河又被颠覆了… 真的是这样么? 10小时「复刻」CUDA 提起
虽然浏览器 AI agent 的概念听起来很美好,但实际构建这样的系统却面临巨大挑战。这正是 Kernel 要解决的核心问题。我发现很多开发者想要构建 AI agent,但却在基础设施层面遇到了各种障碍:性能不稳定、运行时间不可靠、定价不合理、身份认证复杂、权限管理混乱,以及一个本来就不是为 agent 设计的互联网世界。
CaveAgent的核心思想很简单:与其让LLM费力地去“读”数据的文本快照,不如给它一个如果不手动重启、变量就永远“活着”的 Jupyter Kernel。这项由香港科技大学(HKUST)领衔的研究,为我们展示了一种“Code as Action, State as Memory”的全新可能性。它解决了所有开发过复杂Agent的工程师最头疼的多轮对话中的“失忆”与“漂移”问题。
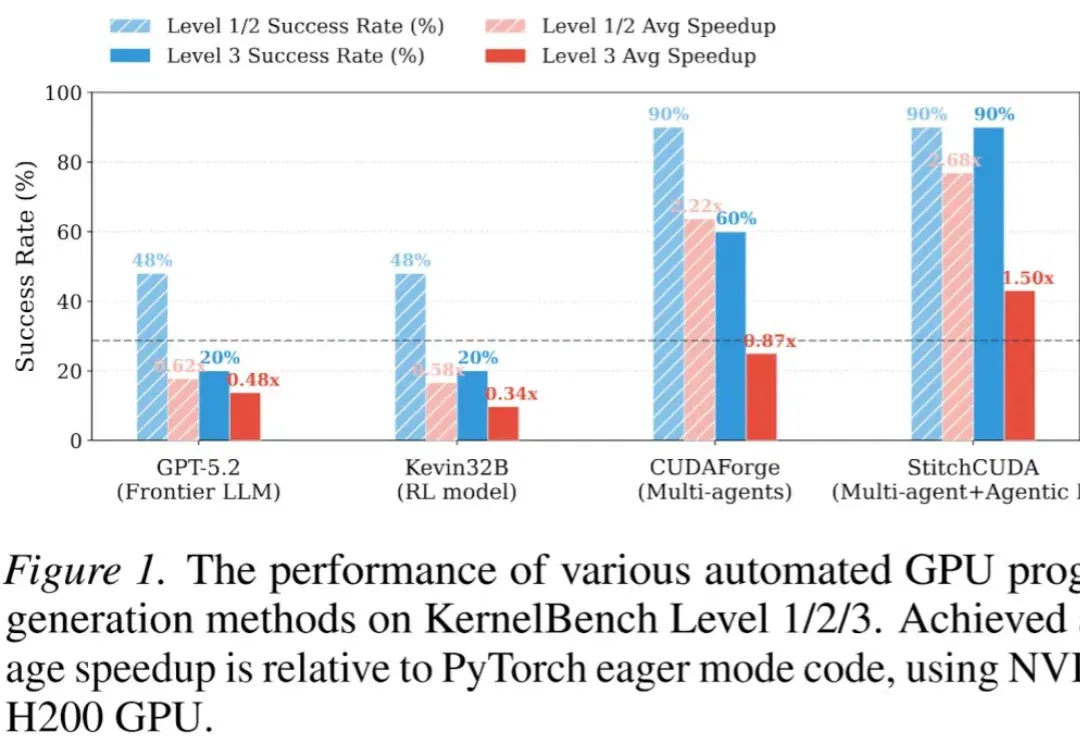
现有的 LLM 自动化 CUDA 方法大多只能优化单个 Kernel,面对完整的端到端 GPU 程序(如整个 VisionTransformer 推理)往往束手无策。
上海交大00后团队创办的芯生代完成数千万元种子轮融资,计划让Agent为不同模型、芯片和场景生成可自我迭代的定制推理引擎,其EvoKernel框架已将昇腾算子生成正确率从4%提升至83%。