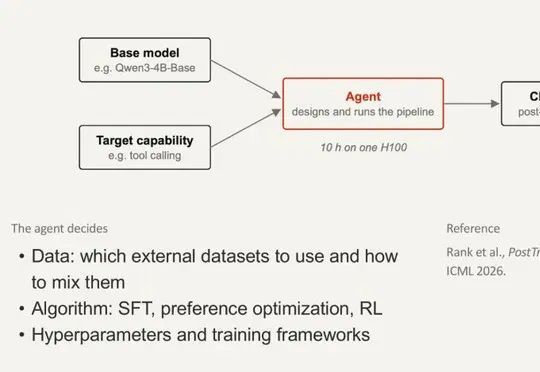
让AI自己给大模型做后训练:AIBuildAI开源递归自进化PostTrain Agent,登顶PostTrainBench (opens in a new tab)
给定一个基座模型、一个目标能力和算力预算,RSI Agent 自己设计后训练算法、收集和整理数据、写代码、跑实验、迭代改进,最终交出一个训练好的模型,全程无人介入。在自主后训练基准 PostTrain
Total 126 articles
给定一个基座模型、一个目标能力和算力预算,RSI Agent 自己设计后训练算法、收集和整理数据、写代码、跑实验、迭代改进,最终交出一个训练好的模型,全程无人介入。在自主后训练基准 PostTrain
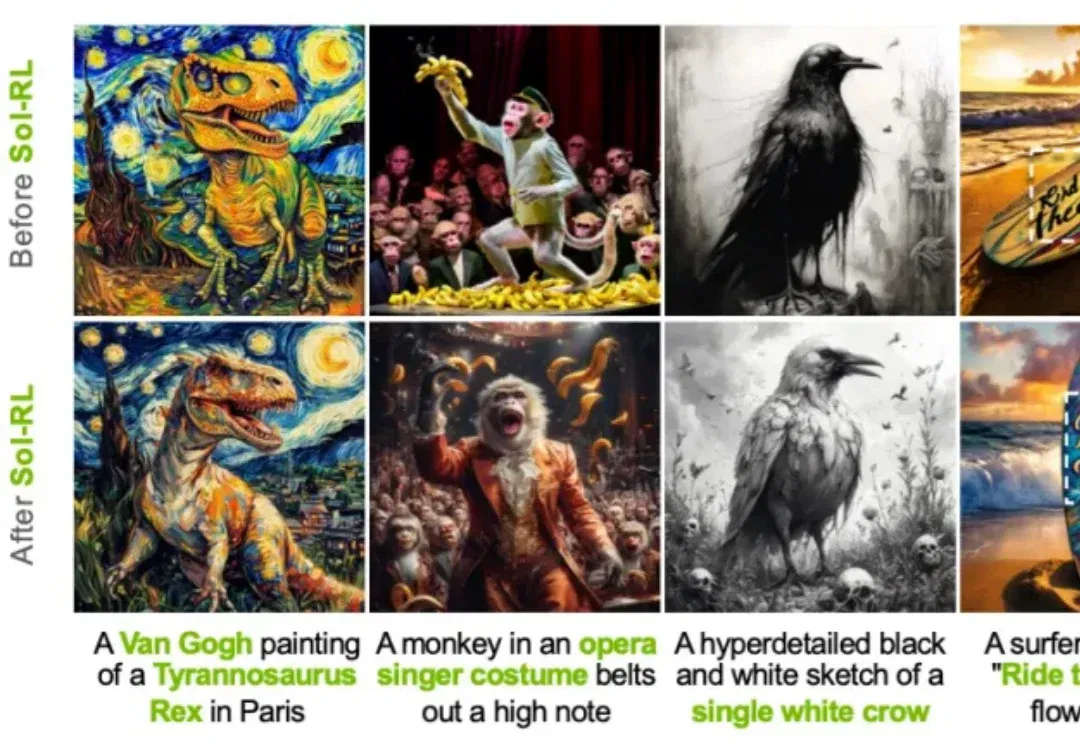
当强化学习后训练的大规模 rollout 已经被证明能够提升图像生成模型的偏好对齐能力,推理负担就成了制约训练速度的核心瓶颈。来自 NVIDIA、港大和 MIT 的团队提出的 Sol-RL,通过「FP4 先探索、BF16 再训练」的后训练框架,将达到等效 reward 水平的收敛速度最高提升到 4.64x,在训练速度与对齐效果之间给出了一条更具工程可行性的解法。
AI模型后训练公司Trajectory宣布完成4500万美元A轮融资,由红杉资本领投,英伟达、Bessemer Venture Partners和Bain Capital Ventures参投,估值达3亿美元,其基于持续学习的后训练平台已正式向公众开放。
在当前的 LLM 开发中,后训练阶段通常被视为赋予模型特定能力的关键环节。传统的观点认为,模型必须通过强化学习(如 PPO、GRPO 或 RLHF)和进化策略(ES)等算法,在反复的迭代和梯度优化过程中调整权重,才能在特定任务上达到理想的性能。
既然后训练这么重要,那么作为初学者,应该掌握哪些知识?大家不妨看看这篇博客《Post-training 101》,可以很好的入门 LLM 后训练相关知识。从对下一个 token 预测过渡到指令跟随; 监督微调(SFT) 基本原理,包括数据集构建与损失函数设计;
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
别人做AI中训练都在堆语料、补知识。 Anthropic这边直接给大模型上价值观必修课。 最新研究提出的中训练(简称MSM)精准插在预训练之后、后训练之前,专门用来给AI立规矩、塑三观。 更准确地说,就是在模型预训练结束、还没开始对齐微调之前,先用模型规范讲解文档做一轮对齐前置特训。 在这个阶段,模型不直接学习合规行为案例,而是通过大量专门讲解模型规范的合成文档,进行专项训练。 让模型先完整理解自身需要遵守的规范、原则、价值内核,再进入后续的对齐微调环节。 实验显示,仅靠新增一轮中训练,就能让通义千问两款32B大模型智能体失准率从68%、54% 降至 5%、7%,同时还能精简40至60倍微调数
亚马逊公司与杜克大学的研究表明,在大模型后训练的在线策略蒸馏(OPD)中,仅保留万分之一的极端稀疏监督信号即可显著提升学生模型的推理能力,且性能可匹配甚至超越密集全信号训练。
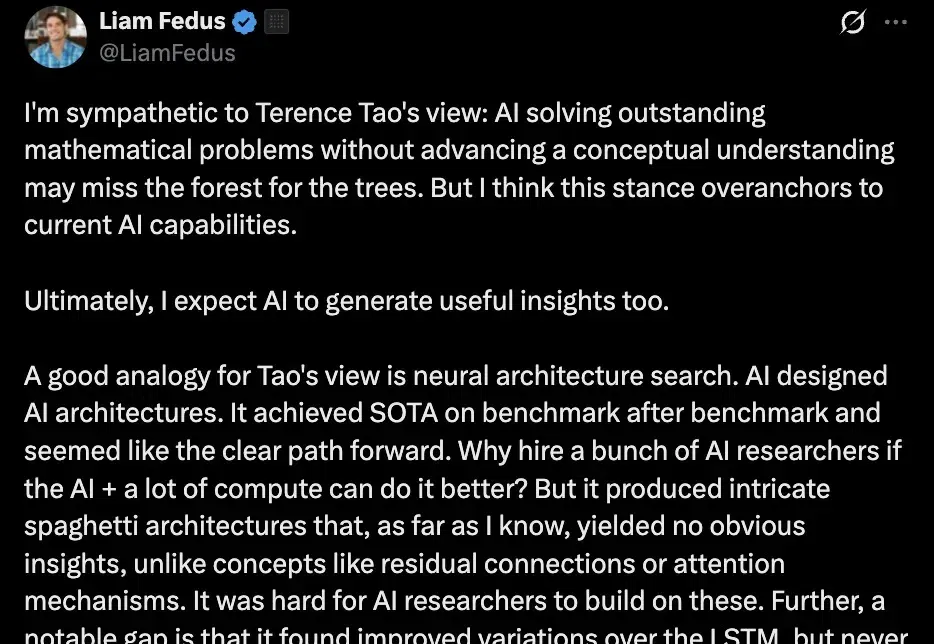
说AI毁了数学,可能还是太小瞧AI了。 刚刚,OpenAI前后训练VPLiam Fedus,回应了陶哲轩等数学家关于“AI不应只追求解题,更应推动数学理解”的观点。 他赞同陶哲轩对概念理解的重视,但也认为不能用今天AI的能力边界,框定未来的可能性。 在Liam看来,未来的AI不仅能解决问题,还能提出有价值的洞见、建立新的概念框架,让数学家在此基础上继续探索。 换句话说,如果AI的训练目标不只是“把题做对”,而是进一步扩展到解释为什么、提炼方法、帮助人类理解,那么它最终可能成为一个既能给答案,也能创造新思路的数学研究伙伴。 这份乐观,与陶哲轩等25位菲尔兹奖得主最初联署的声明,既有共识,也有分歧
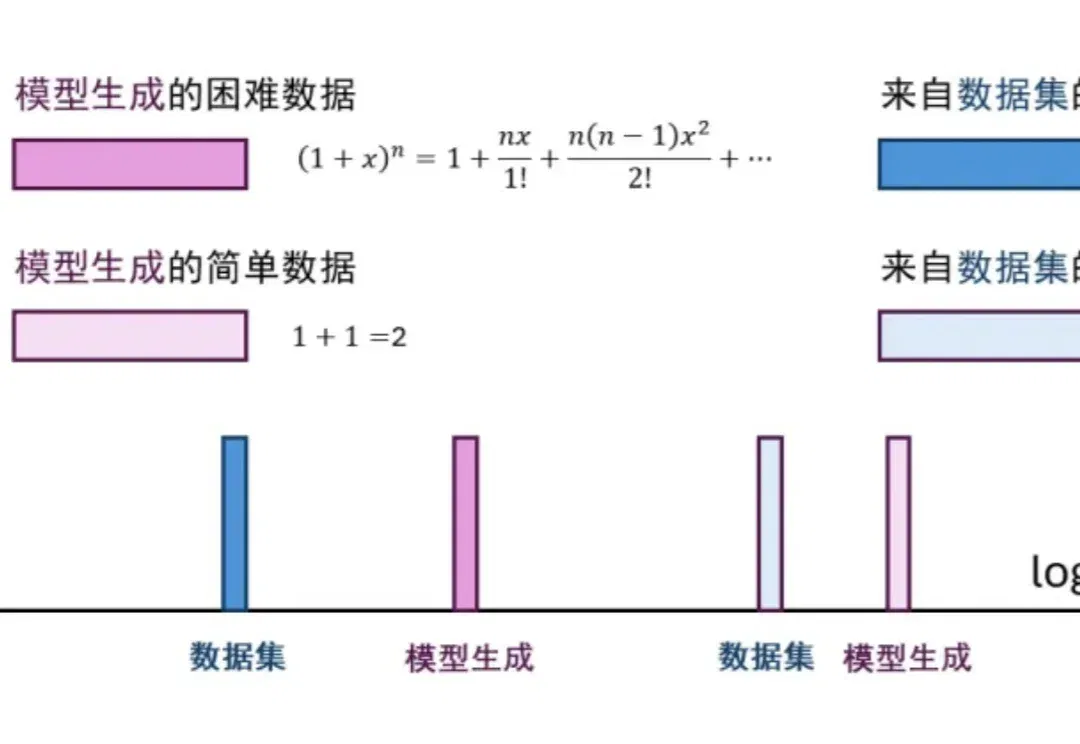
在大模型后训练阶段,监督微调(SFT)和强化学习(RL)是两根不可或缺的支柱。SFT 利用高质量的离线(Off-policy)数据快速注入知识,但受限于静态数据分布,泛化能力往往容易触及天花板并带来灾难性遗忘;RL 则允许模型在探索中不断自我迭代,产生与当前策略同分布(On-policy)的数据,上限极高,但往往伴随着训练极度不稳定、计算资源消耗巨大的痛点。