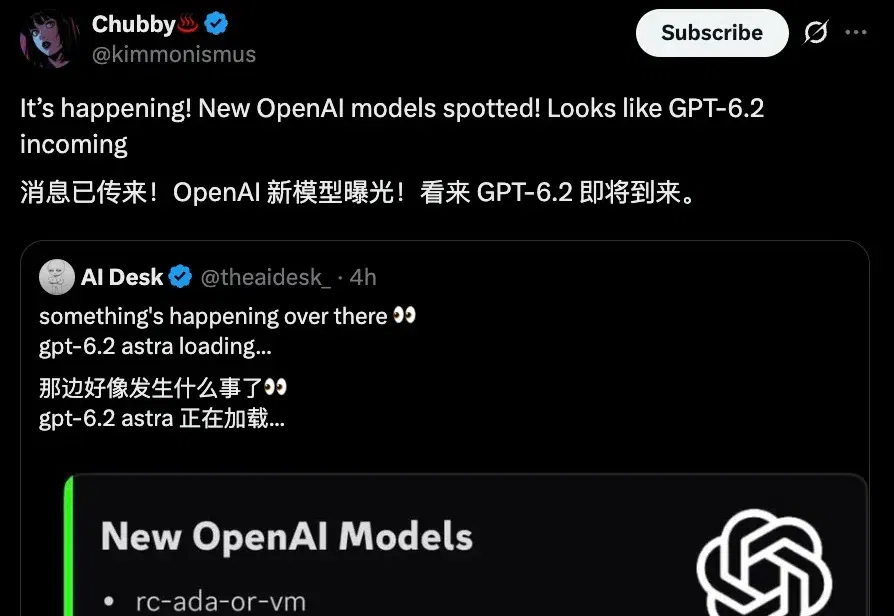
网友分享所谓 GPT-6.2 测试片段,模型身份与发布信息仍待确认 (opens in a new tab)
社交平台出现被标为GPT-6.2的动画演示及未公开API标识,尚不能独立确认模型身份、生成条件或与Sora的关联。OpenAI另披露硬件工程内部模型的BenchCAD结果,该评测并未确认其公开产品名称。
Categories
Important AI news, product launches, industry developments and business changes.
社交平台出现被标为GPT-6.2的动画演示及未公开API标识,尚不能独立确认模型身份、生成条件或与Sora的关联。OpenAI另披露硬件工程内部模型的BenchCAD结果,该评测并未确认其公开产品名称。
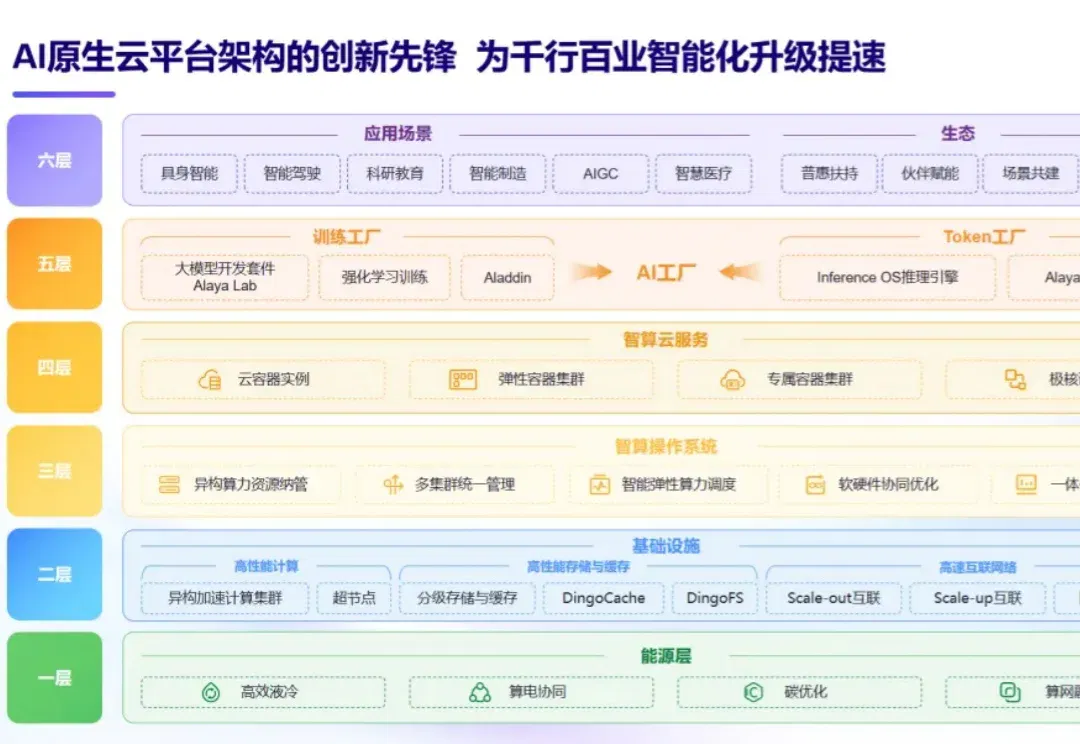
报道介绍九章云极以DCU核算资源投入、以Token记录交付,并通过异构调度及推理优化比较单位成本。公司披露的利用率、客户案例和收入变化反映其经营口径;统一内部计量不等于行业已形成通用结算标准。
报道整理奥特曼访谈中关于超级智能控制权、研发速度及权力集中的讨论,并回顾模型监测与人类复核机制。软件任务时长、IQ测验和科学验证是不同尺度,不能直接换算智力差距,也不能据此确认完全自主RSI已经实现。
由前 Manus 成员 Cecilia 与 Tianyi 创立的 Persom 推出本地优先的 Personal Agent,在用户授权下将电脑中的工作与生活上下文沉淀为可由其他 Agent 调用的 Personal Database,并持续沉淀工作流与个人判断。
腾讯发布Hy4正式版并计划开放权重。智东西通过网页改造、Blender建模、财报PPT和微信操作进行体验,记录多轮人工纠正、耗时与桌面占用;公司另报告训练系统吞吐优化,个案不能保证所有办公任务可靠完成。
v0.2.2-alpha.3预发布版本加入实验性变更请求与工作树入口,扩展宿主级任务管理、SDK和插件能力,并改善手机浏览器体验。报道时尚无对应桌面安装包;服务中断与软件更新同时发生,不证明存在因果关联或新模型将发布。
LifeVal围绕148类个人助理任务,结合用户背景与可验证环境评估智能体。报告基于消费者支付意愿推算潜在价值,不能把1.7万亿美元写成基准售价或已实现收入,也不能据此宣称AGI已达到通用标准或接管人类生活。
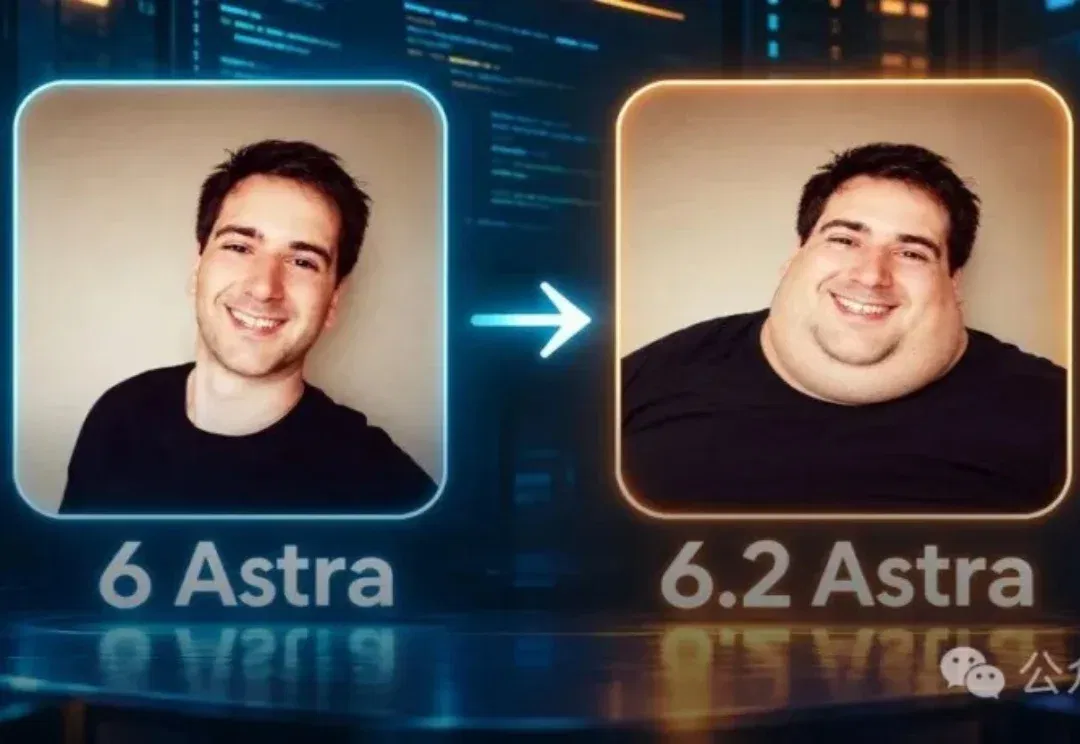
报道汇总网友观察到的API标识、第三方演示和OpenAI硬件工程评测中的未公开模型。模型标签、双虚拟机分工、参数规模及与GPT-6.2的对应关系均不能由这些线索确认;BenchCAD成绩只说明所报告的特定评测表现。
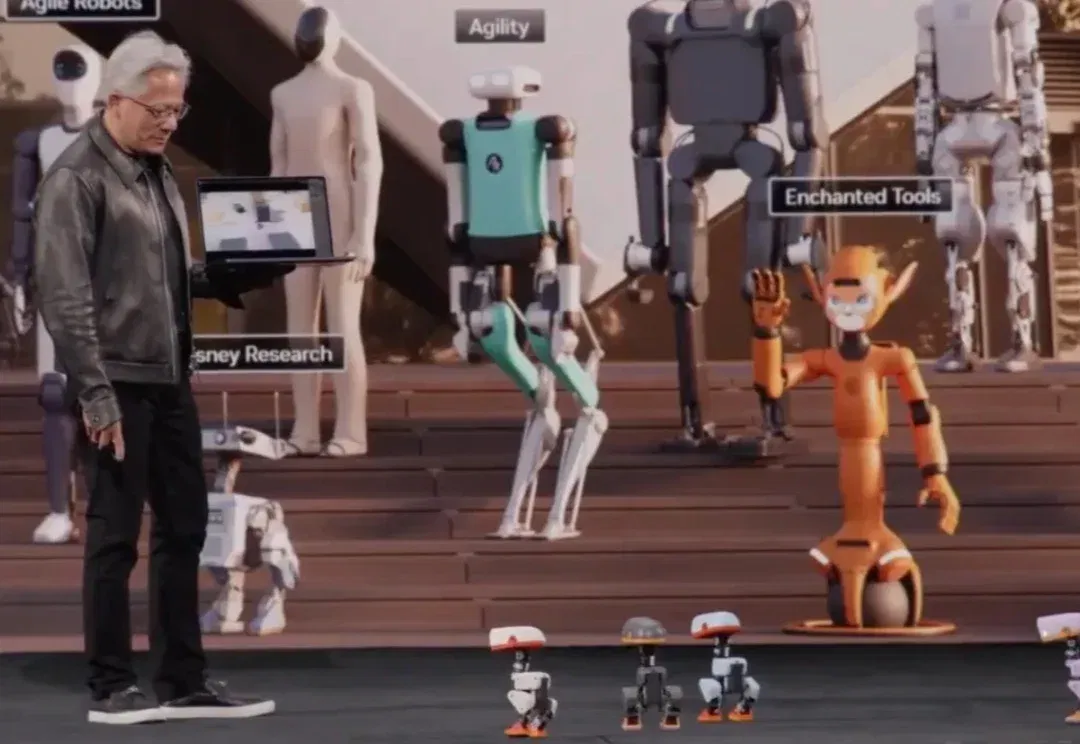
天数智芯开放日演示TY1200在本地进行机器鸭环境构建、策略训练和仿真,并公布若干量化模型的吞吐对比。当前设备标称300 TOPS,600T对应预告中的TY2000;不同精度、模型及批量条件下的算力不能直接混比。
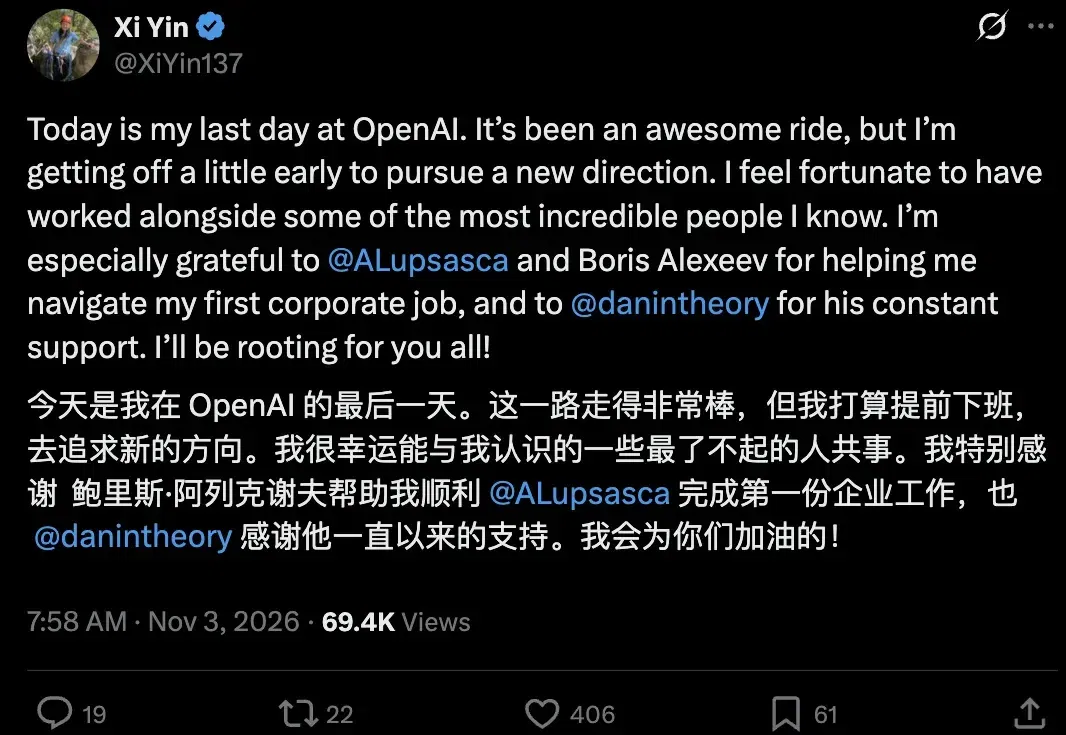
报道援引尹希告别帖,称其结束在OpenAI的首份企业工作,准备探索新方向,并回顾其物理研究及AI使用观点。离职去向未获本人披露,网友关于新公司的猜测不应作为任职消息;研究提速数字属于个人经历。
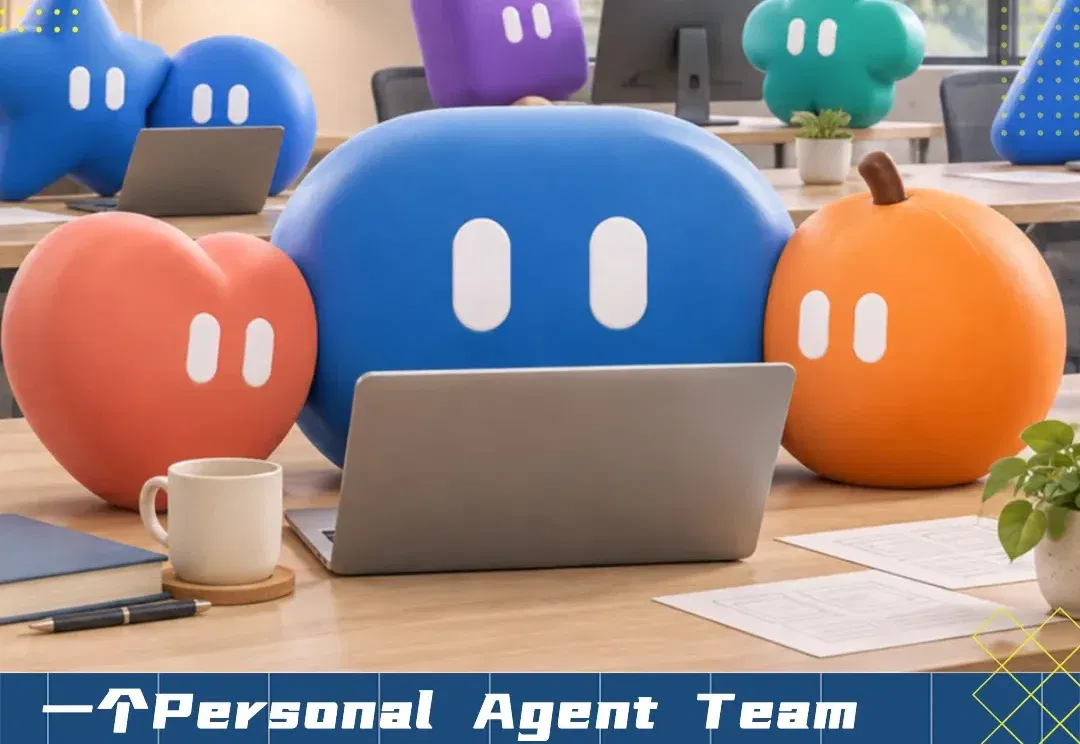
硅星人Pro体验Grok Bot的多角色协作:不同Bot维护各自的背景和记忆,通过委派与群聊推进任务,并使用独立云端电脑。文章讨论省去模型选择的便利和透明度取舍,增长及留存说法保留报道口径,不能等同全面优于同类产品。
LiberAI介绍Liber-0及人类视频、动作手套和本体表征的训练路线。公司报告60项无目标任务机器人示范的测试中整体成功率36%、长程组10.5%;奶茶制作则经过少量后训练,两类演示不能混为完全零样本能力。
报道援引安全研究员分享的账号恢复邮件,以及员工对逆向任务误拦截的回应。账号恢复属于个案,不能等同取消使用政策或允许任何逆向活动;文中关于Anthropic拦截的讨论也应区分用户反馈与正式规则。
无涯智远创始人张牧涵在访谈中介绍参数内学习:先训练超网络,再以前向传播生成基座更新,探索把新经历持久写入参数。受访者也谈到长期稳定性、遗忘及大规模写入仍待研究;秒级写入不等于超网络训练没有成本。
Anthropic介绍内部模型把已知Linux内核漏洞CVE-2026-98432串成远程利用链的受控实验。漏洞已获上游修复,Red Hat部分产品也已发布补丁;MPTCP是该演示的条件,不能据此认定关闭MPTCP即可消除底层漏洞。
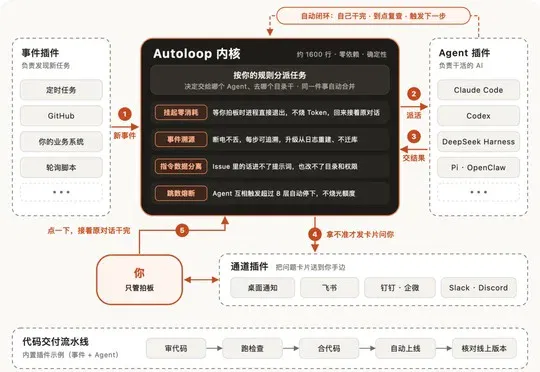
作者将使用一年的智能体自动化流程重写为 Agent-Autoloop,介绍约1600行内核,以及事件、执行器、通知和交付插件。1.0.0版本包含等待恢复、事件账本和调用层数限制;性能及实际案例为作者测试,项目仍可能存在缺陷。
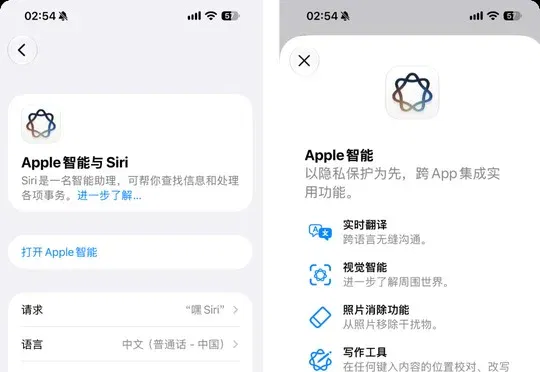
APPSO 记录开发者Beta版的写作、视觉识别、照片消除及Siri体验,并介绍与千问衔接的部分任务。测试也出现闪退、发热和功能入口缺失;更强的个人情境理解与跨应用执行仍待推出,测试体验不等于正式版承诺。
《智东西》在商汤小浣熊桌面端体验 SenseNova 6.8 Flash:两份合计582页招股书的对比与看板任务耗时8分21秒,8页PPT任务则用64分钟。个案反映长文检索和排版流程的差异,环境与执行框架也会影响耗时。
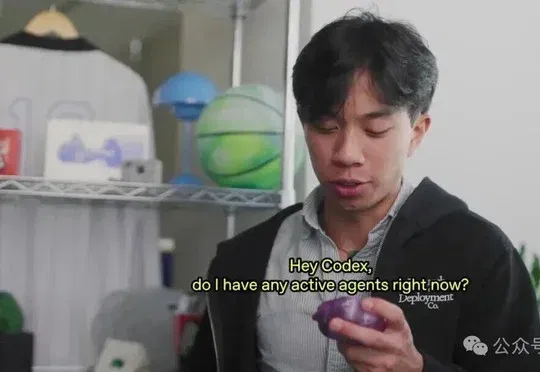
OpenAI 展示 GPT-6 Astra 辅助电子宠物设计,以及与赛车团队、马自达探索建模和仿真的项目。设计文件约一周完成,工厂制作原型另需时间与多轮人工修正;工程演示和内部评测尚不能等同自动量产能力。
FlashProve 用权重承诺与零知识证明探索模型推理验证。团队在400B参数的Llama 4 Maverick上报告约110 Token/s证明吞吐;当前实验为1024 Token窗口中的单个输出Token,仍受整数计算、贪婪解码及较高证明成本限制。
Join the conversation
Read how to join the community. No sign-in is required to read articles.