英伟达SEED减少混合模型记忆开销,Qwen测试每GPU峰值吞吐最高提升42%
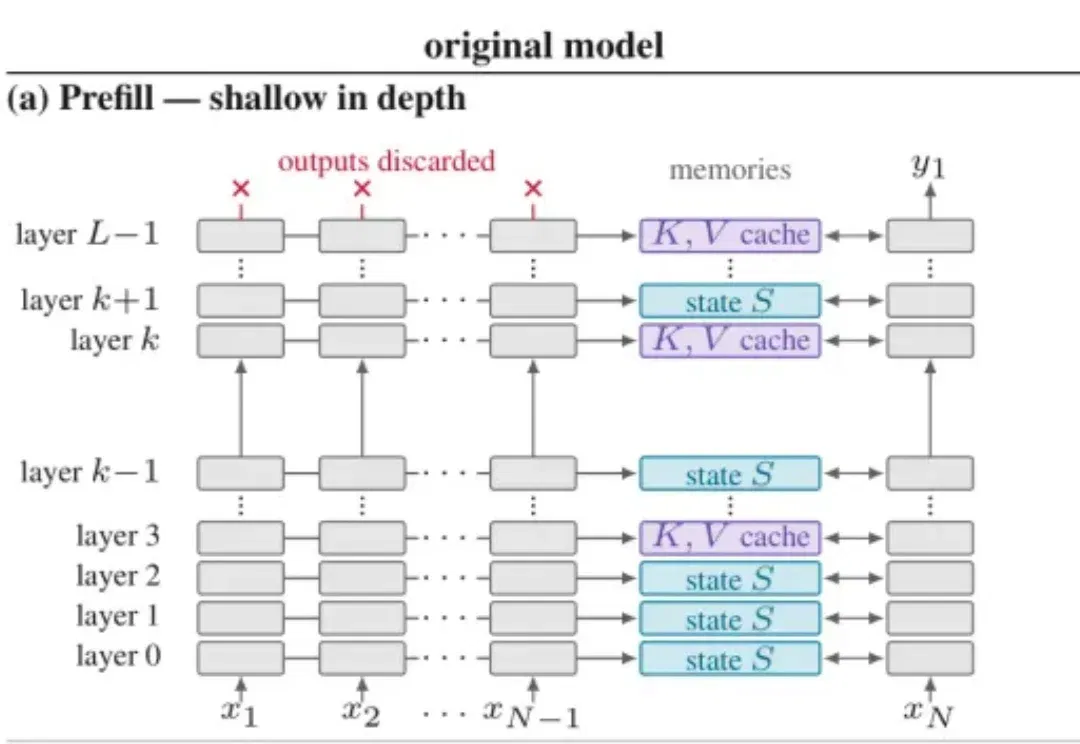
英伟达团队在冻结原模型权重的前提下,通过浅层预填充和循环状态低秩表示减少开销。在GB300、SGLang与编码Agent会话负载的Qwen3.8-Flash-Next测试中,每GPU峰值吞吐提升16%~42%;该吞吐包含输入和输出token,不是单用户生成速度。
Qwen3.8-Flash-Next 有 48 层。处理一段输入时,SEED 让除最后一个以外的 token 只运行前 31 层,再由轻量的记忆写入组件,为后续 17 层生成 KV Cache 和循环状态。到了生成阶段,每个 token 仍然运行完整的 48 层。
这个改动利用了一个区别:为后续生成写下记忆,所需的深层计算可以远少于预测下一个 token。SEED 在五种已训练的混合大模型上测量了这种差别,并把它用于减少预填充计算。
解码侧还有另一处空间。模型每步读写的循环状态,往往包含一个接近固定方向的主分量,剩余内容则具有低秩结构。SEED 将状态保存在这种分解形式下,让模型直接读取和更新它。在 Qwen3.8-Flash-Next 上,单请求循环状态从 113.2MB 降到刚压缩后的 29.2MB,整个压缩周期平均为 43.4MB。
在 GB300 GPU、SGLang 和编码 Agent 会话轨迹上,SEED 使 Qwen3.8-Flash-Next 的每 GPU 峰值吞吐提升 16%~42%;在相同 P90 用户端到端输出速率的比较点,吞吐提升 23%~42%。五种模型、六个检查点的质量评测则检验了这些改动的精度代价。原模型权重全程冻结,新增组件通过蒸馏训练。
论文《Shallow Encoding Emits Deep Memories》已发布 arXiv 预印本。Mingyuan Ma 与 Yangmin Li 共同主导、同等贡献;其余作者为 Harris Nover、Zheyu Fu、Po-Han Huang、Alex Settle 和 Ashwin Nanjappa,作者均来自 NVIDIA。
- 论文链接:https://arxiv.org/abs/2611.06084v1
- 项目链接:https://latent-voyager-seed.static.hf.space/index.html
固定大小的状态仍然可能很贵
混合架构用少量 softmax 注意力层保存 KV Cache,再用大量线性注意力或状态空间层维护循环状态。KV Cache 随上下文增长,循环状态大小固定,但后者并不小:Qwen3.8-Flash-Next 每个请求的状态,占用空间相当于约 4500 个 token 的注意力缓存。
这些状态每生成一个 token 就要更新一次,还会与活跃请求、缓存前缀争用显存。SEED 分别处理两个阶段的成本:预填充少做深层计算,解码少存循环状态。两项优化都来自现有模型已经表现出的记忆结构。
前 31 层为何足以写出后 17 层的记忆
预填充中,只有最后一个输入 token 的输出用于预测首个回复 token。其余 token 留给后续生成的结果,是各层写出的 KV Cache 和循环状态。研究者因此单独考察了深层网络的写入路径。
研究者将浅层隐藏状态直接送入后续各层的写入路径,省去其他深层计算,再与同深度的提前退出比较:直接将该隐藏状态送入输出头,预测下一个 token。
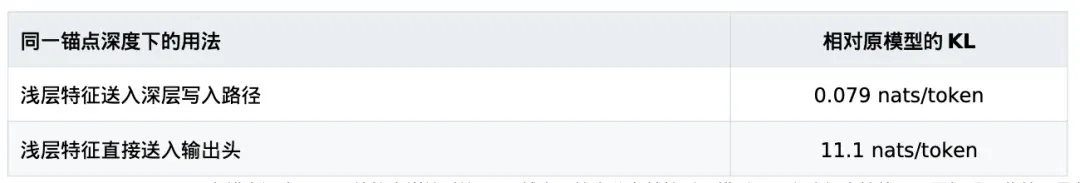
表 1 Qwen3.8-Flash-Next 在锚点深度 k=31 处的未训练对比。KL 越小,输出分布越接近原模型。写入路径直接使用原层权重;此处不是蒸馏后的最终结果。来源:论文图 2 (c)。
两个结果相差约 141 倍。浅层特征尚不足以直接预测下一个 token,却已能为深层写出可用的记忆。这就是写入与读取不对称性。
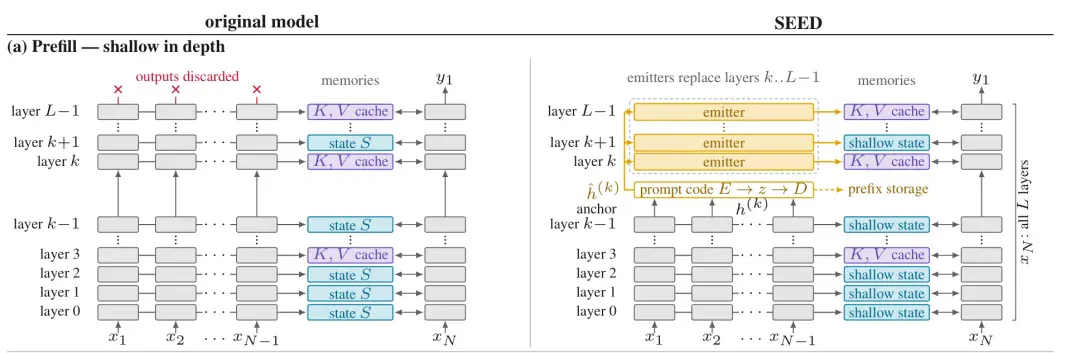
图 1 SEED 的浅层预填充。emitters 从锚点层输出写出后续层的 KV Cache 和循环状态;最后一个输入 token 仍通过完整网络。来源:论文图 1 (a)。
SEED 用 emitters 实现这条路径。注意力层保留 key、value 和必要索引的生成;循环层还保留写入强度、衰减、短卷积和扫描。这些组件从原层参数初始化,通过蒸馏适配浅层输入,省去完整的深层注意力读出和前馈计算。
计入 emitters 后,Qwen3.8-Flash-Next 除最后一个以外的输入 token,参数相关计算量从 12.1GFLOP 降到 9.1GFLOP,减少约 25%。生成时仍走完整网络,各深层记忆也保留。
锚点深度也不能只看平均 loss。GLM-5.3-Flash 在 k=27 时的分布偏差已经很小,但只能复制出原模型 595 个标识符中的 269 个;移到 k=31 后,可复制 530 个。SEED 因此同时用分布偏差和精确复制测试选深度,避免平均指标掩盖检索失败。
状态里能量最多的部分未必携带最多上下文
Qwen3.8-Flash-Next 有 1728 个 Gated DeltaNet 头,每个头维护一个 128×128 状态矩阵。对这些矩阵做 SVD 后,首个奇异分量所占能量的中位数约为 85%,而且主方向在不相关的输入之间仍然接近。
研究者进一步在通用文本上估计每个头的平均 value 方向,将状态沿该固定方向的投影称为 state sink。这个投影的能量占比中位数约为 75%,与 SVD 给出的 85% 是不同的统计量。去掉该方向后,剩余内容仍很紧凑,中位数头只需约 6 个方向就能保留其 90% 的能量。
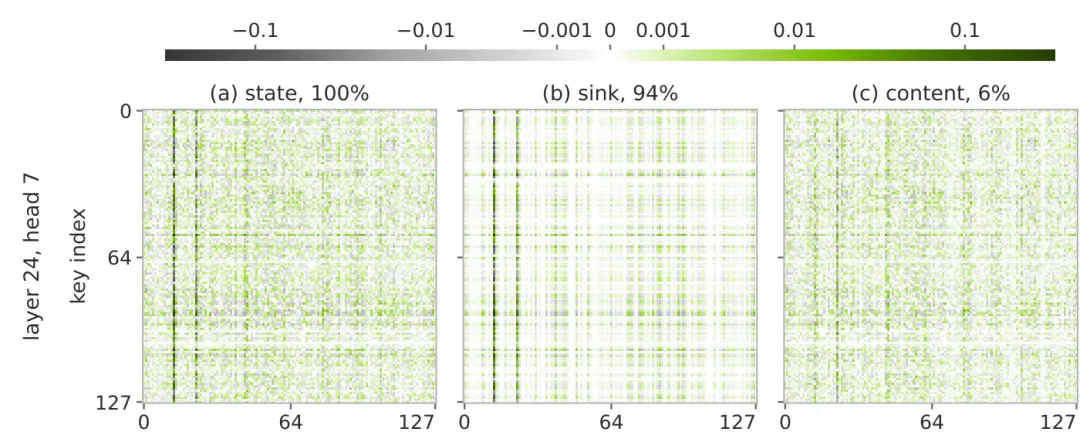
图 2 原状态、固定方向上的 sink 投影与剩余内容。图中的示例头,sink 占 94% 能量;正文的 85% 和 75% 分别是不同统计量的跨头中位数。能量指矩阵元素平方和。来源:论文图 3 (a–c) 及第 4 节。
高能量本身不足以说明哪些部分值得保留。论文做了替换实验:将每个头的 sink 换成其他输入上的平均 sink,后续预测损失只增加约 0.002 nats/token;但若在每个后续步骤都只保留 sink,损失会增加约 1.66 nats/token。前者是预填充结束时的一次干预,后者是持续干预,二者共同说明剩余工作记忆不能丢。
在归一化后,sink 主要提供偏置和增益,对当前输入有用的内容主要在其余部分。SEED 因此将两者分开保存:固定方向由所有请求共享,每个请求只存 sink 系数和工作记忆的低秩因子。
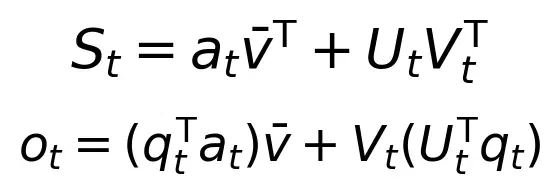
图 3 状态分解及直接读出。v̄为每个头共享的固定方向;a、U 和 V 属于当前请求。模型用这组因子计算输出,无需为读出重建完整状态矩阵。公式整理自论文第 5.1 节。
以秩 R=16 为例,单头刚压缩后的存储量从 128×128=16384 个数,变为 17×128+16×128=4224 个数。按相同精度计,约为原来的四分之一。近 4 倍的压缩来自表示结构,而非把状态换成更低精度。
能压缩还不够
这组因子必须能持续更新
循环状态每个 token 都要更新。如果每步都重建完整矩阵,再做一次 SVD,存储省下来的成本很可能被计算抵消。SEED 利用原更新规则的结构:每步更新 sink 系数,对已有因子施加衰减,再向两个因子各追加一列,便能表示新的工作记忆。
论文证明,Gated DeltaNet、Kimi Delta Attention 和 Mamba-2 的更新都能保持这种分解形式。两次压缩之间,因子上的更新在数学上精确;低秩截断才引入近似。在 Qwen3.8-Flash-Next 中,R 和压缩周期 W 均为 16,生成 16 个 token 后再将增长的因子压回目标秩。
这也解释了 29.2MB 为何不是恒定占用:追加的列会逐步增加存储量,周期平均为 43.4MB。在五种模型上,状态刚压缩后的压缩比为 2.0~3.9 倍,周期平均为 1.3~2.6 倍。这些数字计算的是循环状态表示,注意力 KV Cache 保持原格式。
误差分析针对开环:压缩递推和精确递推接收相同的 key、value 等输入,且衰减满足收缩条件。此时,误差界不随压缩次数增长。自由生成还会改变后续输入,论文另外跟踪了长解码:在跟踪到 16K 步的模型中,从首个 4K 到最后 4K,压缩次数增至 4 倍,状态引起的分布偏移只增至约 1.2~1.4 倍。
蒸馏后的模型究竟损失了多少能力
SEED 只训练 emitters 和可选的 prompt code,原模型作为冻结教师。训练先用固定文本蒸馏,再在教师与当前组件生成的回复上进行一至两轮训练;Nemotron-3.5-Super 采用第一阶段组件。锚点深度和状态秩使用统一的探测准则选定,不依赖考试分数。
质量测试覆盖 Qwen3.8-Flash-Next、Nemotron-3.5-Lightning、Kimi-Linear、GLM-5.3-Flash 和 Nemotron-3.5-Super,共六个检查点、11 项基准。每道题与原模型配对比较并使用相同采样种子,66 个 “检查点 × 基准” 组合中,63 个分数落在原模型两个标准误范围内或更高。
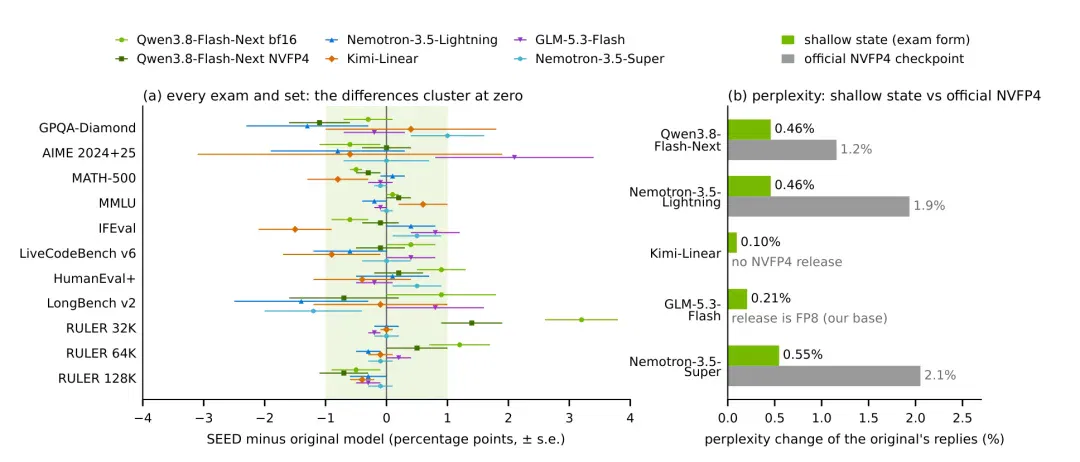
图 4 六个检查点在 11 项基准上的质量变化。右图单独考察状态压缩造成的困惑度变化,使用精确预填充。结果支持评测表现接近原模型,并不意味着所有输出完全一致。来源:论文图 6。
显存省下来了
系统为何真的能多服务用户
SEED 在 SGLang 上的端到端验证使用 GB300 GPU,回放 InferenceX 记录的编码 Agent 会话。每个并发点运行 900 秒,原模型与 SEED 使用相同硬件,循环状态均以 FP32 存储,测量包含 emitters 和周期压缩开销。下表同时启用浅层预填充与浅层状态。
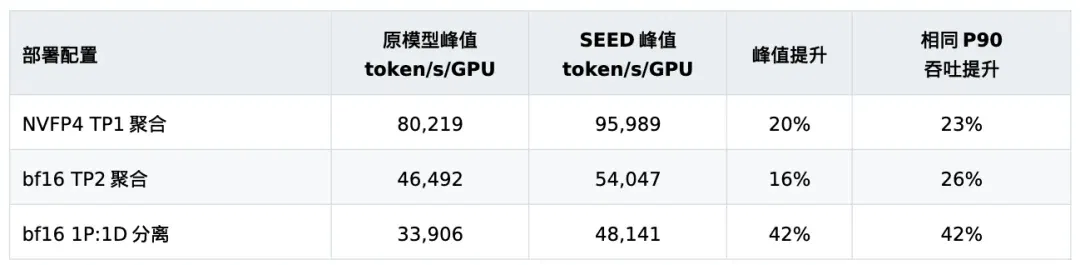
表 2 Qwen3.8-Flash-Next 的每 GPU 服务吞吐。峰值按各自最高测得吞吐比较;P90 列在论文选定的相同用户端到端输出速率点比较,具体取点见论文第 7 节。TP 为张量并行;1P:1D 由一个预填充实例和一个解码实例组成,每个实例使用两张 GPU。来源:论文表 5。
NVFP4 单 GPU 聚合部署下,原模型峰值约为 8.02 万 token/s/GPU,SEED 约为 9.60 万。bf16 预填充与解码分离部署下,峰值则从约 3.39 万提高到 4.81 万。表中吞吐统计包含输入和输出 token,缓存命中的输入同样计入,不能当作单个用户的生成速度。
在这些 MoE 模型的测试负载下,解码阶段的权重读取仍占较大比重,状态变小主要通过容量改善服务,而不只是少搬运一些状态数据。
SGLang 的混合模型前缀缓存与运行中的请求,共用一个循环状态池。状态池满后,系统逐出缓存前缀;新请求再次用到这段上下文,就得重新预填充。并发越高,状态占用与重算之间的联系越明显。
在 NVFP4 TP1、40 个并发会话的测量点,原模型前缀缓存命中率约为 55%,SEED 约为 85%。较小的状态同时给活跃请求和可复用前缀腾出空间,减少重算;浅层预填充又降低了未命中部分的计算量。
PD 分离部署中,主要瓶颈转到预填充实例。仅启用浅层预填充,峰值吞吐就提升约 35%;仅压缩状态提升约 5%;两者一起启用提升约 42%。不同部署的收益来源由此可以分辨:聚合服务更受状态池容量影响,PD 分离则更依赖预填充计算的下降。
P90 用户端到端输出速率将排队和首 token 等待时间也算在内。相同 P90 条件下比较吞吐,是为了比较相近交互体验下能承接多少负载;23%~42% 对应论文选定的比较点,并非任意速率下的固定增幅。低负载时,两种配置的吞吐差异很小,端到端服务验证目前集中在 Qwen3.8-Flash-Next。
混合模型的记忆可以怎样设计
SwiftKV 和 POP 此前已探索过从浅层特征生成 Transformer 深层 KV Cache。SEED 将问题延伸到混合模型:预填充需要写出深层循环状态,解码需要在压缩表示上继续更新,而且原模型权重保持冻结。
这两项发现分别改变了记忆的计算方式和存储方式。深层网络在生成时仍有作用,但为输入 token 写记忆未必需要同样的计算深度;完整状态矩阵仍定义着模型更新,但实现时可以存储并更新一组较小的因子。模型已具备这些结构,SEED 将它们变成了可以测量的服务收益。
收益也有明确范围。SEED 不压缩注意力 KV Cache,长上下文中若 KV Cache 占据主要显存,状态压缩对总显存的贡献会变小。论文讨论的 prompt code 前缀存储尚属后续方向,没有计入本文的服务吞吐。代码、新增组件和训练数据在论文中列为计划公开的材料。
作者简介
Mingyuan Ma
来自 NVIDIA Compute Architecture/DL Compute 团队,专注于大模型推理的性能建模、推理优化与新一代模型的性能预测。参与 Nemotron 3 Super、Nemotron 3 Ultra,以及 Nemotron 3.5 Lightning、Super 和 Bolt 等项目的推理性能建模与预测,为模型设计与系统优化提供量化依据。
Yangmin Li
来自 NVIDIA Compute Architecture/LLM Inference Performance 团队,专注于大模型推理系统的性能优化,是开源推理引擎 SGLang 的主要贡献者之一。围绕 PD 分离、投机解码、KV Cache 管理和融合 kernel 等方向,提高真实负载下的吞吐并降低交互延迟。参与 DeepSeek、Qwen、Kimi、GLM 等主流开源模型的 Day-0 支持与推理优化,推动这些模型在 NVIDIA 最新 GPU 上开箱即用、高效运行。
文章来自于"机器之心",作者 "Mingyuan Ma、Yangmin Li"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Weitu AI presents a streaming-video brain combining sparse perception and long-term memory (opens in a new tab)
Weitu AI selects temporal segments and spatial features to control compute costs, reporting OVBench and S-EMBER results and exploring continuous video understanding for glasses, offices and industry. Outcomes depend on devices, deployment and task conditions.
上海AI Lab发布Sage S2.1 Flash技术报告,披露科学多模态与智能体训练方法 (opens in a new tab)
上海人工智能实验室等机构发布320B MoE模型Sage S2.1 Flash技术报告。团队在33项基准中评估其工具调用、科研与软件操作能力,其中四项得分在论文主要对比模型中居首。
Singularity-Bench:Opus自建引擎在编程回放测试中将P90首Token等待降至0.48秒 (opens in a new tab)
研究团队用4张GB300、同一模型和16路编程会话比较推理引擎,报告Opus 5.5方案的P90首Token延迟约0.48秒,SGLang约12秒,生成速度则接近。六项任务的人类设定边界不等于完整递归自我改进。
魔搭开源EntroPack:按存储预算调节模型权重压缩码率 (opens in a new tab)
EntroPack结合E8格量化与熵编码,支持无需激活校准或微调的可调码率权重压缩。团队展示了图像模型推理和LLM LoRA训练案例;文中9.4%降至4.26%指特定配置下的权重重建误差。
费豪观点论文提出“认知共生体”:如何评估AI对人的认知帮助 (opens in a new tab)
牛津研究者费豪在59页观点论文中提出“认知共生体”,以“认知落差”和共生循环组织个人AI的研究方向,讨论记忆、适时介入、学习和照护等用途及授权、隐私和治理问题。这是一套概念框架与证据要求,并非完整系统的实测结果。