达瓦科技披露年内两轮融资累计近5亿元,聚焦可控 AI 视频
近日,达瓦科技披露,公司年内连续完成 Pre-A 轮、A 轮融资,累计融资金额近5亿元,投资机构包括启赋资本、投控东海、一村资本、宝捷会、鞍羽资本及多家产业投资机构,老股东持续加注。鞍羽资本担任公司长期独家财务顾问。
近日,达瓦科技披露,公司年内连续完成 Pre-A 轮、A 轮融资,累计融资金额近5亿元,投资机构包括启赋资本、投控东海、一村资本、宝捷会、鞍羽资本及多家产业投资机构,老股东持续加注。鞍羽资本担任公司长期独家财务顾问。
过去两年,视频生成行业最容易被看见的进步,都发生在渲染层:参数规模从几十B冲到几百B,GPU集群从千卡扩到万卡,画面越来越逼真,视频越来越长,跑分榜单一期一期刷新。竞争也随之变得直观——谁的卡更多,谁能训练更大的模型,谁能在下一次发布中拿出更惊艳的效果。
但站在生产一线的人知道,这条路正在逼近天花板。上百B参数的通用视频模型,在实验室里能生成惊艳的片段,到了商业片场就露怯:第一个镜头很好看,第二个镜头的人却变了;想让摄影机换个角度,场景也跟着换了;客户觉得其他都可以,只改一下演员的动作,结果就是无限抽卡。行业真正稀缺的能力,从来不是生成惊艳的画面,而是准确执行创作意图,并以可负担的成本持续交付。
这个判断,地球两端的两家公司,用各自的方式正在验证。
在硅谷,Higgsfield 烧掉1000万美元、试了三个方向之后,从8位资深创意总监那里听到了同一个答案:现有AI视频工具最缺的不是生成能力,而是运镜与机位控制。从这个切口进入,它18个月年化收入从100万美元冲到10亿美元,B轮估值54亿美元。
在重庆,达瓦科技从模型层直接切入。它没有在应用层加一个运镜按钮,而是直接用34B参数,把人物、动作、镜头、光照、服装、道具全部纳入分层约束。这条路不是实验室里的Demo:公司年内确认收入近5亿元,在AI视频行业普遍亏损的阶段率先实现规模化盈利。
达瓦自研控制层+实时渲染模型demo
01 Higgsfield 在应用层做运镜控制,达瓦把控制写进模型本身:从镜头到世界
如果说 Higgsfield 的突破口是「让摄影机可控」,达瓦做的事情是:让整个世界可控。
自研控制层模型 Latent Stage 仅用34B参数,将人物、动作、镜头、光照、服装、道具与物理交互全部纳入分层建模与联合约束。这不是在应用层加一个运镜控制面板,而是在模型表征与训练阶段就把「可控」内生化——修改一个变量,其余世界状态全部冻结。
工业制作中最常见的要求是「这个保留,只改那里」。达瓦的连续编辑测试中,目标编辑成功率达98.2%,人物身份保持率达93.3%。
Higgsfield 创始人 Alex Mashrabov 最近在访谈《20VC》里有一个判断:垂直公司不应该为了技术虚荣追通用基座模型,真正的护城河是控制模型路由——决定每个任务调用哪个模型。Higgsfield 目前40%的调用由系统自动分配,毛利率做到80%以上。
达瓦往前多走了一步:它不满足于在调用时选模型,而是在训练时就把「可控」写进了模型本身。路由控制的是用哪个模型生成,控制层解决的是「生成出来的东西能不能改、能不能保持一致」。前者优化成本,后者决定交付。
02 算力军备竞赛的终点,是控制权的竞争
达瓦的技术架构可以概括为一句话:控制层做重,生成层做轻。
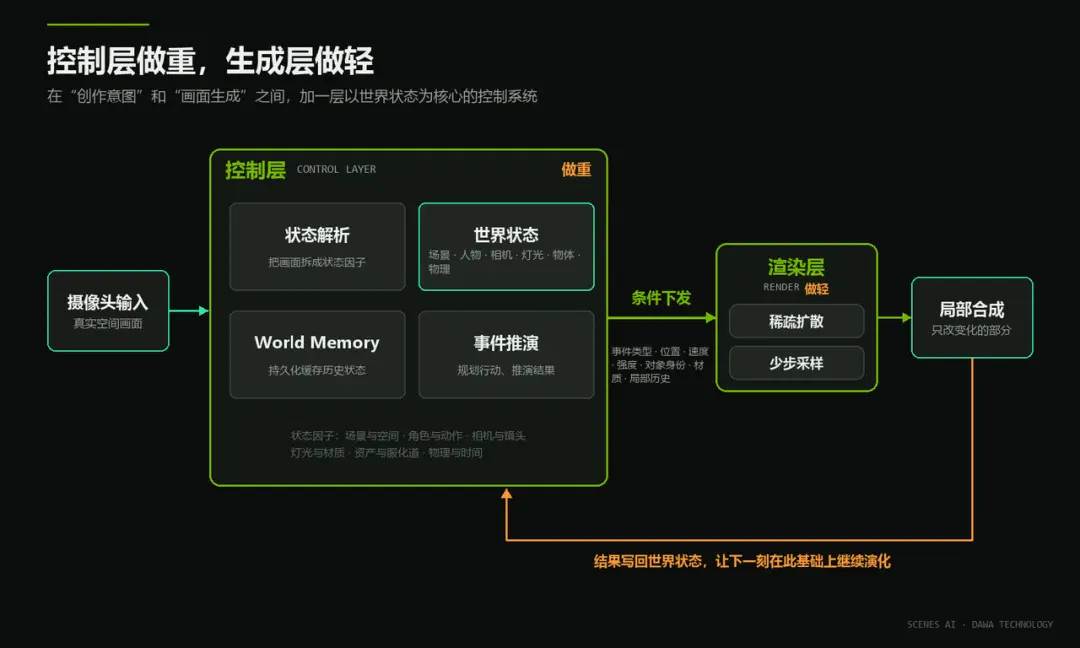
达瓦的技术架构
没有把所有问题交给一个大模型逐帧重画——那种路线意味着,哪怕只动一帧里的一根手指,整张图的像素都要重新算一遍。达瓦在「创作意图」与「画面生成」之间构建了一层以世界状态为核心的控制系统:控制层负责想清楚「哪里变了、哪里不能动」,生成层只对真正变化的那一小块做局部扩散。稳定的墙、地板、角色脸全部复用,算力只花在刀刃上。
达瓦在实时视频中,精准实时编辑
达瓦在离线视频中,精准控制单一变量
自研的局部稀疏微扩散技术,只对画面里10%–20%真正在动的区域做计算——GPU功耗直接砍掉40%–60%,推理速度翻3到5倍。同样一张显卡,离线出片量翻倍,实时交互延迟砍掉一大半。
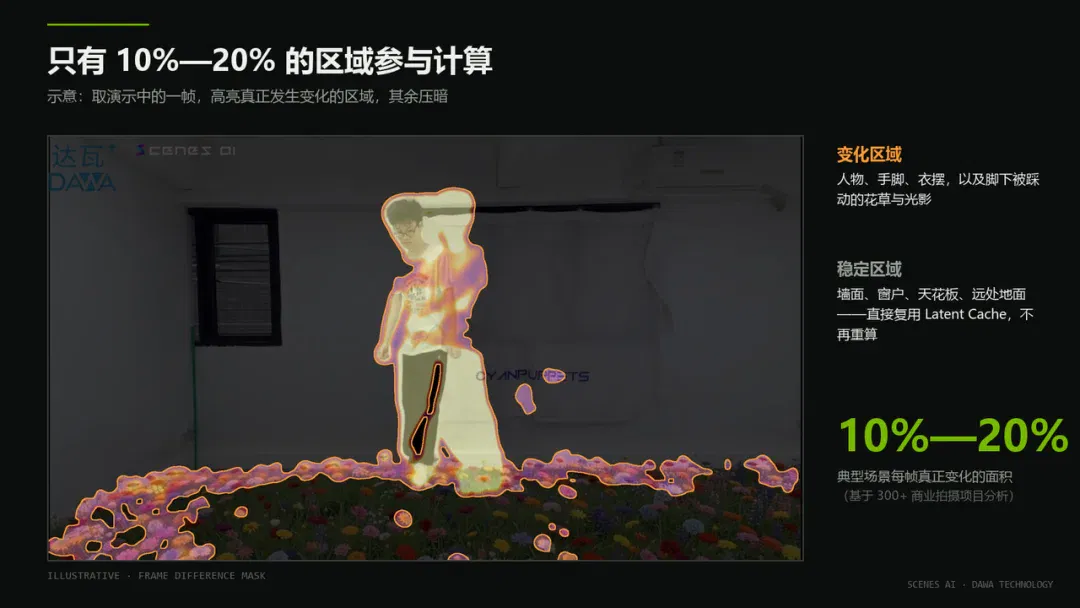
这套架构在离线和实时两条产品线上同时跑通:离线侧,CineStage 负责长镜头连续生成,角色不崩、场景不跳;实时侧,LiveStage 每步只激活约4B参数,在单张消费级 RTX 5090 上跑出720P、25帧/秒,连续120分钟不漂移。
03 从交付结果的工业级视频,到1800亿美元的实时世界
控制能力的商业价值,在离线交付和实时交互两条线上同时被验证。
离线侧:按结果收费的工业级交付。达瓦是行业内少数按交付结果收费的AI视频公司,国内红果平台已上线《从虎王开始进化》《厨神附体》《我的荒岛生活》等多部AI短剧,客户单镜头“抽卡”次数从此前的五六十次下降至5次以内,单位制作成本较使用主流模型下降一个数量级;大预算影视侧,公司在戛纳获奖影片《狂野时代》、头部院线电影《消失的人》,并在筹划业内首部纯AI大银幕电影。
实时侧:把直播间搬进一张消费级显卡。9月,达瓦发布实时世界模型 Scenes AI,首发实拍演示中:主播站在一间普通办公室里,地面塌陷、雪怪破土而出;身旁的椅子在火光中变形为狼首铁王座,主播坐了上去;花盆里长出果树,窗帘下摆燃起明火;最后整间办公室化为动画草原。真人与生成的怪物、道具、场景同框、接触、互动——不是预渲染,不是绿幕合成,而是一张本地 RTX 5090 消费级显卡实时跑出来的。
这是国内首次将真实摄像头输入、真人实时驱动、连续世界生成跑在单张消费级显卡上:模型总参数34B,每步仅激活约4B,720P、25帧/秒输出,连续运行超过120分钟不漂移。传统直播间动辄数十万的布景、灯光、LED大屏,被压缩到一张显卡上;未来,数千万的主播可以在雪地里卖雪地靴、在雨林里卖防蚊液,场景随商品一键切换。这切入的是全球1800亿美元规模的直播与游戏互动市场——从交付一段成片,到实时改写一个世界,达瓦正在把AI视频从「抽卡出片」变成「现场生产力」。
04 数据即壁垒:成片只是冰山一角,达瓦拥有180TB拍摄过程高质量数据集
控制模型最需要知道一件事:画面里的这个变化,到底是被什么条件逼出来的。
互联网上海量视频回答不了这个问题——它只看到数十万个像素点,看不到空间的深度、遮挡、互动和关系;它只记录「最后长什么样」,不记录「导演为什么这么拍、演员为什么这么动、灯光为什么这么打」。
Higgsfield 攒的是用户在软件里的「决策序列」——创作者怎么选、怎么改、怎么调,再拿这些轨迹做后训练。它专门养了一支150人的全职创意团队,把顶级工作流开源到社区,八周滚出一万个工业级用例。
达瓦攒的是片场里真实发生的「创作过程」,是从剧本,到分镜的全要素,到每个镜头背后世界的构建和拍摄过程。在重庆永川,8.4万平米全流程数字化科技片场,11个影棚常年92%以上满产。过去五年,300多个真实商业项目在这里走完从开机到成片的全流程,沉淀下约180TB结构化过程数据——摄影机怎么运动、演员怎么站位、灯光怎么打、道具怎么动,单场戏标注维度超过300个。
这是国内唯一规模化跑通的影视制作过程数据集。互联网上的公开视频只能教模型「画面长什么样」,片场里的过程数据才能教模型「画面为什么变成这样」。从第一天起,这些数据就是为「控制」而生的,不是为「生成」而生的。
片场数据训练控制模型,控制模型交付商业项目,项目回流新的过程数据——这条飞轮一旦转动,控制能力将持续自我强化。
当AI视频从「抽卡赌一把」变成「按订单交付」,这个赛道的下一程就不再比谁的模型大、谁的卡多——而是比谁能把创作意图变成可交付的生产力。达瓦要做的,是工业级影视和实时交互世界共同依赖的那层控制底座。一次世界构建,可以拍、可以渲、可以播、可以玩。
05 关于达瓦科技
达瓦科技是一家生成式世界基础模型公司,总部位于重庆永川,专注打造可控、可交付、轻量易部署的AI视频生成基础设施。公司依托真实影视生产沉淀的高质量独家过程数据集,构建 Latent Stage 控制基模、CineStage 离线生成与 LiveStage 实时交互三大模型体系,通过 FilmOS 与 Scenes AI 连接专业影视、短剧、直播、营销等创作与商业场景,推动模型、产品、交付与数据回流持续迭代。
文章来自于"Z Potentials",作者 "Z Potentials"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Seedance 2.5 flash launches; Zhidx tests a 15-second cat parkour video (opens in a new tab)
ByteDance reports faster generation and lower prices. Zhidx tests shot transitions and text stability in a 480P clip, finding that some background signs still lose parts of their characters.
Jimeng launches Motion Studio: Synced tries making knowledge videos (opens in a new tab)
Synced tests code-driven animation with entropy, the laws of robotics, recursive self-improvement and Chinese character evolution, recording generation times, revisions and errors in specialist knowledge.
九个开源动画项目,从代码绘画到视频编排 (opens in a new tab)
文章整理九个制作动画、讲解短片和产品视频的项目,介绍风格模板、分镜、可修改工程及本地渲染环境。项目热度采用报道时点的数据。
Sand.ai 完成 2 亿美元 A+ 轮融资,10 个月累计融资 3 亿美元 (opens in a new tab)
智东西报道,视频模型公司 Sand.ai 宣布完成 A+ 轮融资,并计划继续投入模型、推理基础设施和海外业务。报道还梳理了 MAGI 系列路线及 VidMuse 的公司披露数据。
Viggle 推出 Remake:用文字修改视频角色、场景与风格 (opens in a new tab)
Viggle推出AI视频二创新界面Remake,用户上传视频并用一句话即可替换人物、服装、道具和背景,调整特效与风格,同时尽量保留原有动作和镜头节奏,支持最长2分钟视频及对话式修改。