17岁天才少年陈广宇,宣布离开Kimi
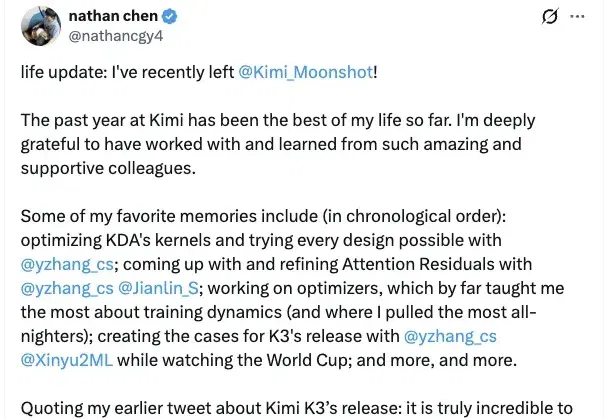
今天,曾因 Attention Residuals 论文走红的 AI 少年陈广宇(Nathan Chen),宣布离开 Kimi。
今天,曾因 Attention Residuals 论文走红的AI 少年陈广宇(Nathan Chen),宣布离开 Kimi。
16岁入职月之暗面,17岁挂出顶会级架构论文一作,深度参与Kimi K3与底层内核研发。
他在 X 上发了一篇告别帖,回顾了自己在 Kimi 参与的几项重要工作,也感谢了曾经一起做研究的同事。
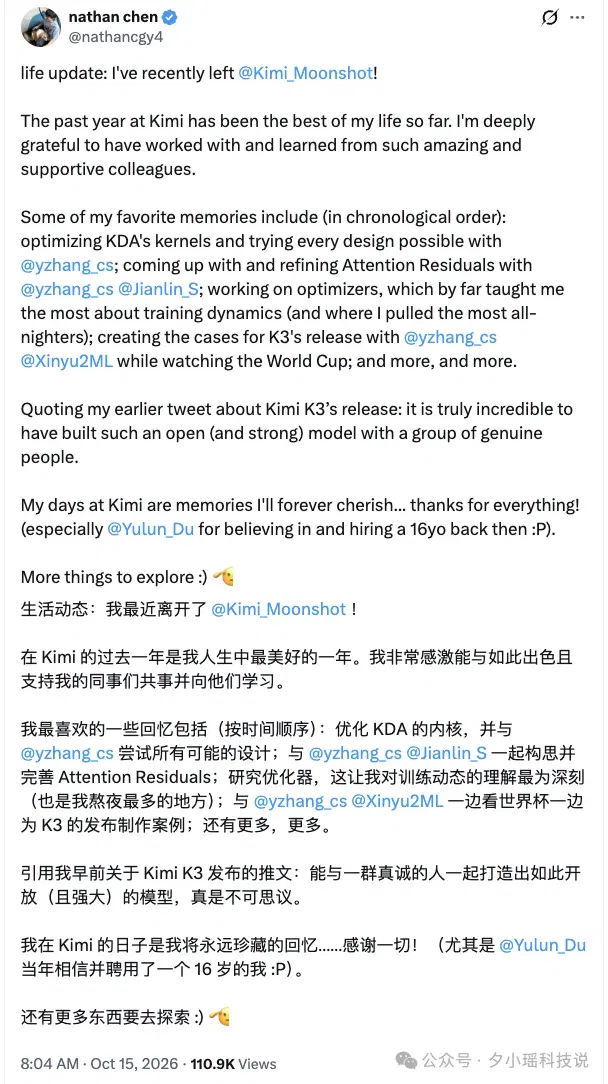
从去年11月加入月之暗面,到如今离开,前后还不到一年。
◈16 岁被杜雨伦发掘,加入 Kimi
事情要从一年前说起。
当时把陈广宇招进月之暗面的伯乐,是月暗的核心技术大牛杜雨伦(@Yulun_Du)。杜雨伦此前在 MIT 攻读博士,也是生成模型领域公认的顶级学者。
陈广宇在告别推文里特别提到了这一笔:
在 Kimi 的过去一年是我人生中最美好的一年。 感谢一切,尤其是杜雨伦当年相信并聘用了一个 16 岁的我。
16 岁很多同龄人还在刷高考五三模拟题,而他已经被扔进了国内最顶级的 LLM 炼丹炉深水区,直接怼上了最硬核的硬仗。
按照陈广宇梳理的时间线,他在 Kimi 这一年干的核心大事有这些:
- 优化 KDA 内核和团队里的张宇(@yzhang_cs)一起,死磕 KDA(Kimi Delta Attention)的高性能 Kernel,把所有可能的设计都拉通试了一遍;
- 重构注意力残差拉着大名鼎鼎的「苏神」苏剑林(@Jianlin_S)和张宇,共同构思并完善了 Attention Residuals 架构;
- 猛攻优化器与训练动力学在最底层的训练动态里摸爬滚打;
- K3 震撼发布背后的操盘手之一一边和队友看世界杯,一边给 Kimi K3 赶制发布案例。
这个战绩哪是少年班实习生,这分明是顶在大模型前沿阵地扛大梁的重装战士。
◈和苏神一起搞发明,改写 Transformer 沿用了十年的残差连接
在陈广宇交出的成绩单里,最炸裂的一张名片,叫Attention Residuals(AttnRes)。
在今年 3 月,月之暗面公开的论文(arXiv:2603.15031)里,陈广宇的名字赫然排在第一作者。和他并列署名的,正是苏剑林、张宇、杜雨伦、吴育昕以及杨植麟本人。
这项工作究竟有多硬核?
读者朋友们都知道,目前的 Transformer 模型之所以能叠到几十层甚至上百层,全靠残差连接(Residual Connection)。
但沿用了十年的经典残差,有一个让整个学术界头疼的缺陷:等权累加。
每一层网络的输出,都以 1:1 的权重强行加进主干通道。层数一旦叠深,主干数据流就会迅速膨胀。
到了最顶层,新加入的深层特征在浩如烟海的历史累加里占的比例微乎其微——这就是大模型越深越难驯服、容易出现表征退化的“PreNorm 稀释病”。
陈广宇、苏剑林与月暗团队终结了残差连接十年来的规则。
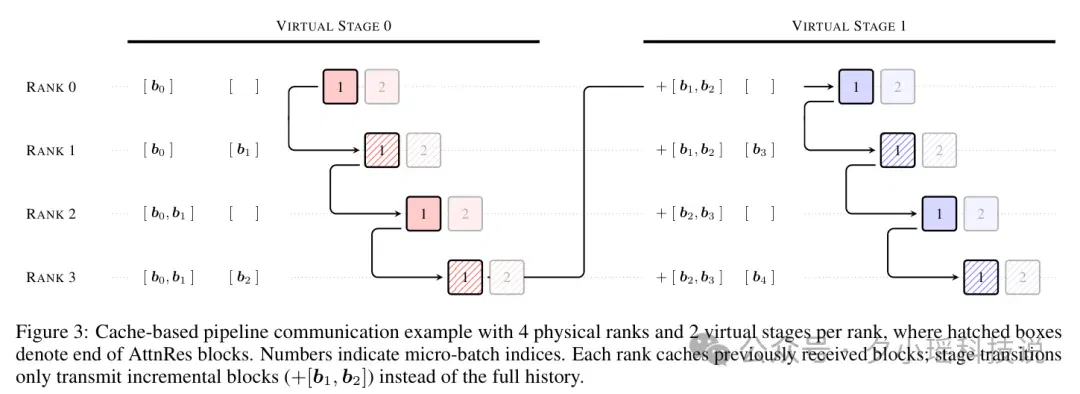
他们提出的 Attention Residuals(AttnRes),让每一层在回看前面所有层时,引入了一套轻量级的注意力打分:每一层可以根据当前上下文,自己决定给前面哪一层分配更多权重,按需汲取历史表征。
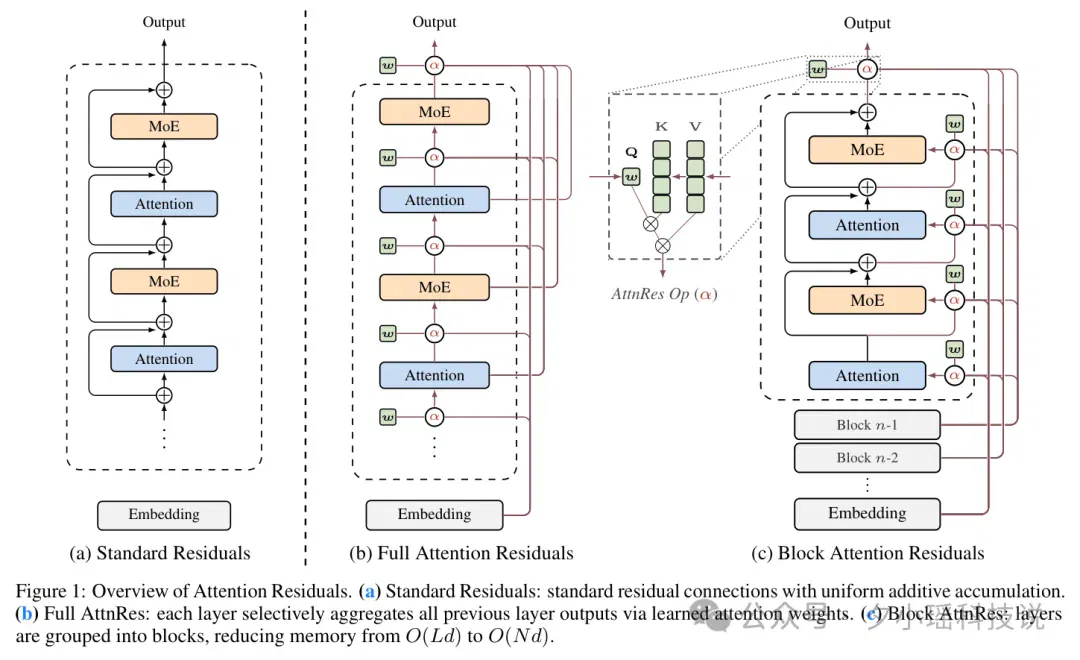
但如果每一层都对前面所有层做全量注意力,计算复杂度会随着网络深度呈平方级暴增。
为了砍掉这笔开销,他们又推导出了分块注意力残差(Block AttnRes):把上百层网络拆成若干区间块,块内精细打分,跨块用锚点通信。
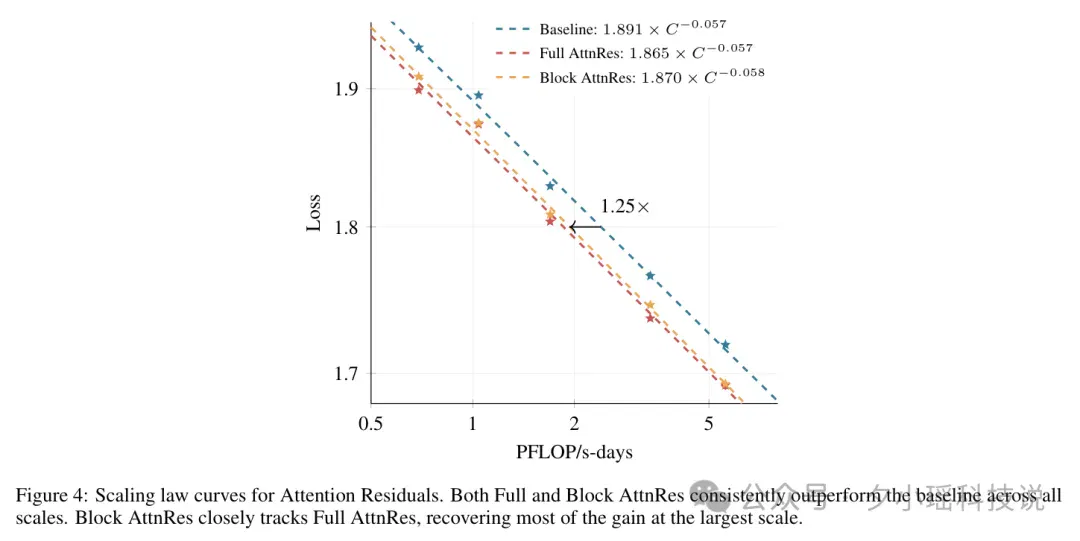
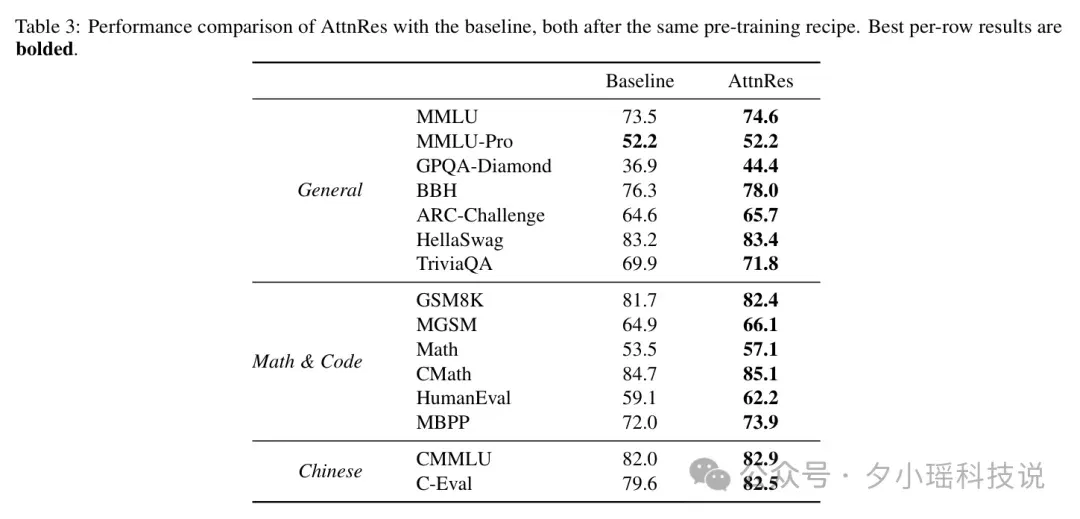
在 Kimi 48B 模型的实测里:
- 逻辑推理基准GPQA-Diamond直接爆拉了7.5分(从36.9冲到44.4);
- 代码生成HumanEval提升了3.1分。
一个16岁的少年和行业顶尖的架构师们一起,把 Transformer 的基础构件给翻新了一遍。
◈英雄出少年背后,大模型研发正把资历彻底清零
陈广宇的下一站去哪里?
他在推特里只留下了一个俏皮的敬礼表情:「More things to explore(还有更多东西要去探索)」。
有人猜测他可能要重返校园完成学业,也有人推测他会被北美顶级实验室或更具野心的初创团队挖走。
但他的离职推文在今天引发震动的深层原因,其实击中了每一个 AI 从业者的内心。
在过去的传统软件工程里,一个架构师往往需要十年、十五年的工程积累,靠堆砌项目经历和代码量爬上去。
但在今天的大模型时代,传统的经验壁垒正在以肉眼可见的速度崩塌。
底层算子的极致优化、注意力机制的数学推导、上千卡分布式集群的动态追踪,这些前沿领域里很多甚至没有现成教科书可抄,全世界的顶尖头脑都在同一条起跑线上摸索。
在这里,16 岁少年的纯粹直觉和学习曲线,真的可以正面迎战行业老兵。
陈广宇的经历就是个例子。
2025年初,他还在通过阅读论文、借助 AI 工具理解机器学习中的基础概念。
到了几个月后,他已经开始编写底层计算内核,在开源社区分享自己的研究。
不到两年时间,他已经参与到大模型核心架构的研究之中。
感谢这位 16 岁的少年给国产开源模型留下的那些优雅内核与残差公式。
正如他自己写下的那句话,模型世界浩瀚无垠,属于这一代极客少年的探索,才刚刚拉开序幕。
毕竟,他才17岁。
未来还有很多问题等着他去探索。
文章来自于"夕小瑶科技说",作者 "丸美小沐"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
刚离开Kimi,17岁的陈广宇去了Jeff Dean新公司 (opens in a new tab)
据机器之心了解,17 岁 AI 研究者陈广宇,已经加入 Jeff Dean 等人创立的 Discovery Loop 团队。
Kimi Hosted Agents 正式发布:Harness as a Service (opens in a new tab)
Kimi Hosted Agents 正式发布,以 Harness as a Service 提供7×24小时托管环境,支持长程任务、多智能体协作、安全控制、审计及140+ Skills、30+插件和8个金融Agent模板。
物理学家尹希宣布离开 OpenAI,下一步方向尚未披露 (opens in a new tab)
报道援引尹希告别帖,称其结束在OpenAI的首份企业工作,准备探索新方向,并回顾其物理研究及AI使用观点。离职去向未获本人披露,网友关于新公司的猜测不应作为任职消息;研究提速数字属于个人经历。
Kimi 发布游戏开发方案,连接专业引擎、建模与运营工具 (opens in a new tab)
Kimi 介绍基于K3.1 Pro、Kimi Code和Kimi Work的游戏开发方案,连接Unity、Unreal、Blender等工具,展示原型、工程修改与试玩验证。官方演示的耗时与完成度依赖任务及环境,不代表任意用户都能在一两天完成商业游戏。
Kimi商业和模型都想要,但卡是有限的 (opens in a new tab)
月之暗面发布2.8万亿参数后训练模型Kimi K3.1 Pro,其综合智能指数领先DeepSeek V4.1 Flash-1017和MiniMax M3.1 Flash,但API费用最高,并正研发Flash版本以平衡能力、成本与商业化。