刚刚,全网霸屏的神秘太空兔揭晓,来自 MiniMax 新模型
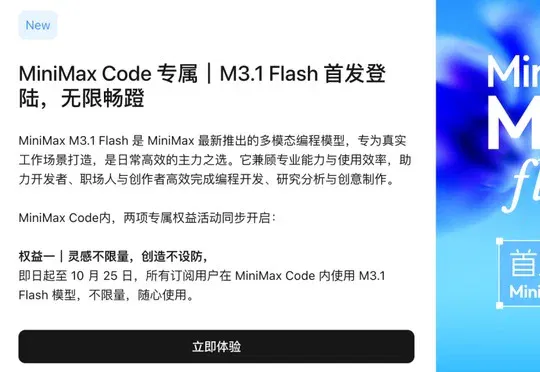
MiniMax 更新 MiniMax M3.1 Flash,并确认此前处理超200万亿 Token 的匿名模型 Space Bunny 为其早期版本;官方称新模型线上推理速度提升近3倍,Agent 类任务综合使用成本较前代降低70%。
神秘太空兔,终于被认领了。
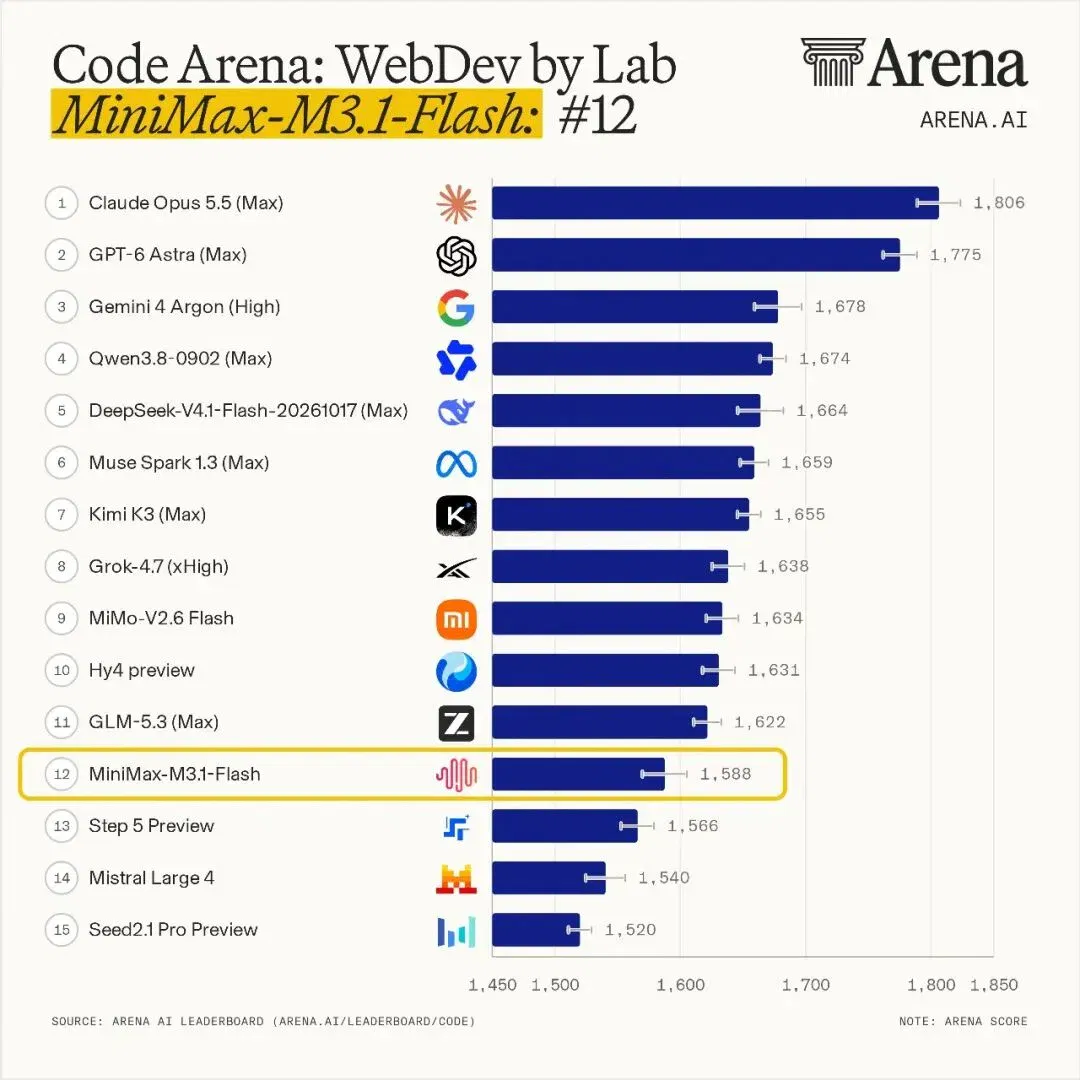
就在刚刚,MiniMax 宣布更新 MiniMax M3.1 Flash,并透露此前以匿名身份处理超过 200 万亿 Token 的 Space Bunny 正是该模型的早期版本。
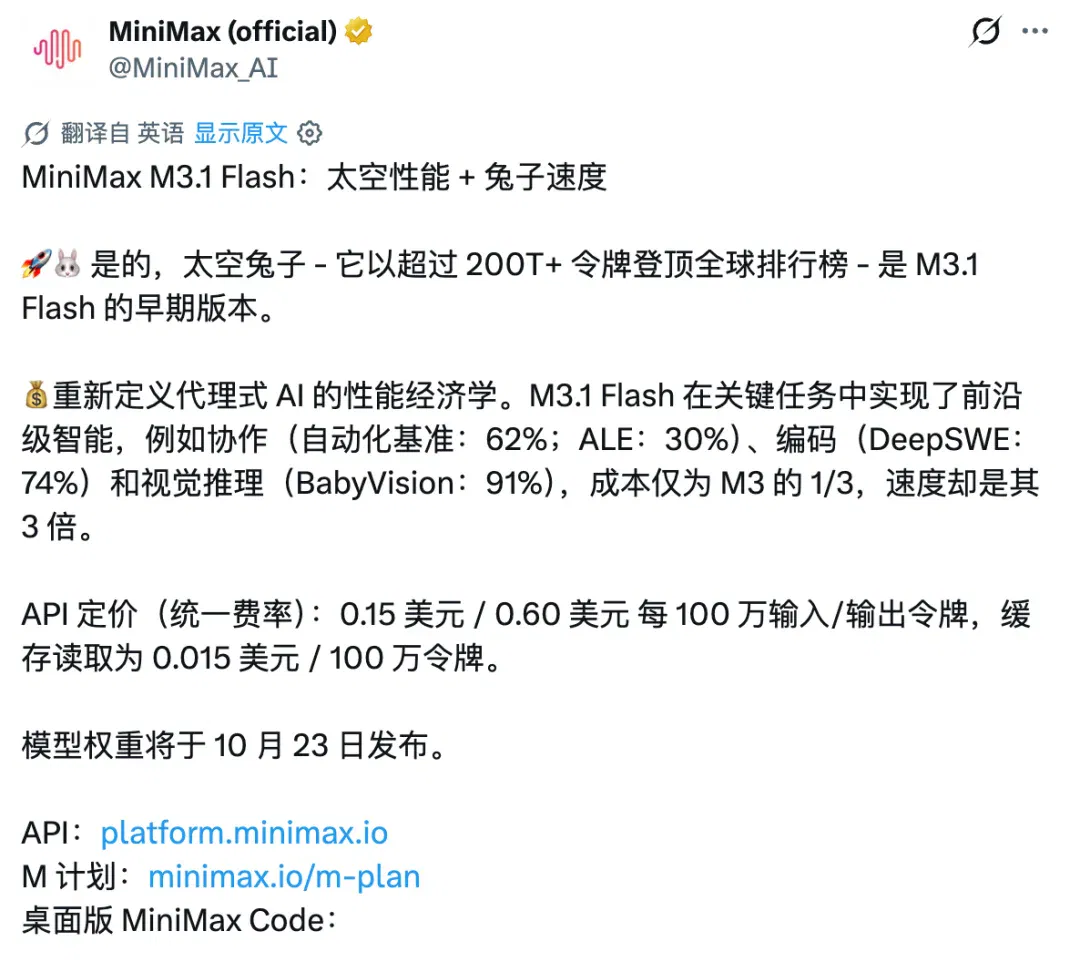
据官方介绍,M3.1 Flash 在复杂 Agent 任务、编程、电脑操作及网络安全等方面实现了代际提升,线上推理速度提升近 3 倍,Agent 类任务的综合使用成本较前代降低 70%。
随着 AI 开始操作软件、编写代码和执行企业工作流,完成一次任务所需的多步推理与工具调用,也让速度和费用变得更加重要。
此次发布中,MiniMax 除了公布能力评测,还展示了不同任务下的成本对比,试图回答模型能完成多少工作,以及完成这些工作需要花多少钱。
根据官方公布的评测表,M3.1 Flash 在 Automation-Bench v1.0.6 中取得 62.2 分,高于 DeepSeek V4.1 Flash-1017 的 60.5 分,在表内参与对比的模型中排名第一。
该测试采用 600 个任务,考察模型在跨 SaaS 系统的企业业务流程中,处理销售、营销、运营、客服、财务和人力资源等工作的能力。
在涉及多步骤规划、跨文档一致性、金融业务合规和连续工具调用的 BankerToolBench 中,M3.1 Flash 取得 76.2 分,与 Opus 5 并列。长上下文任务评测 LOCA-Bench 256K 中,其成绩为 60.3 分,略高于 GPT-5.6 Sol 的 60.0 分。
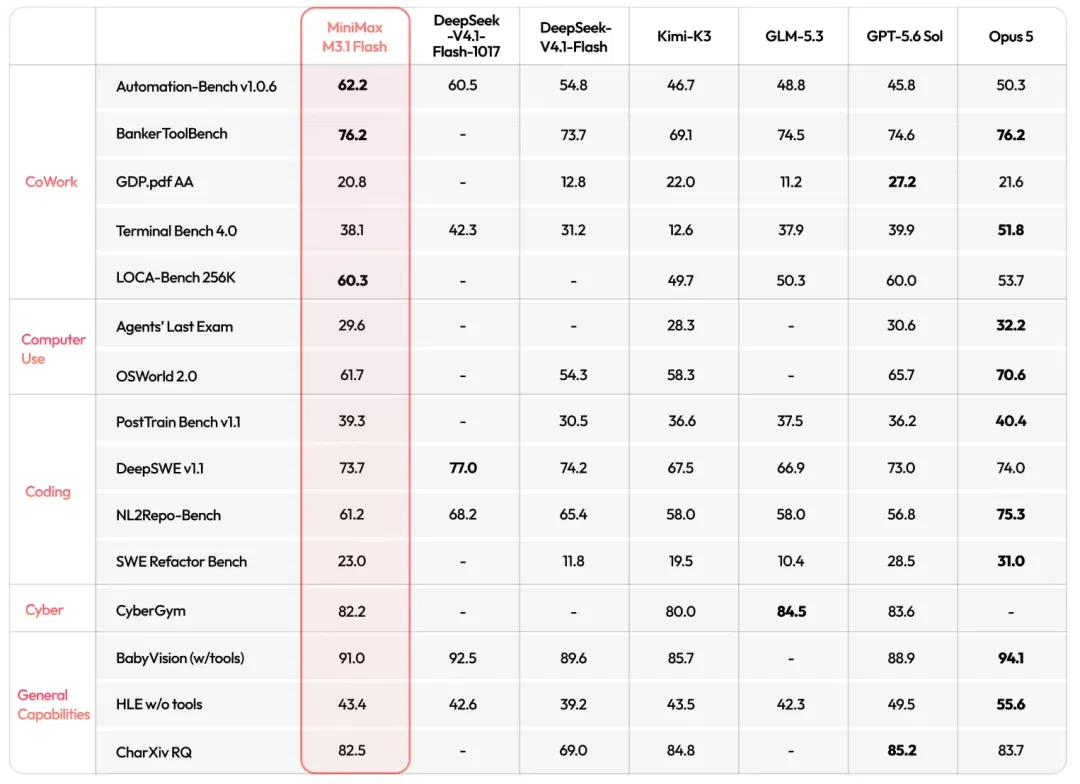
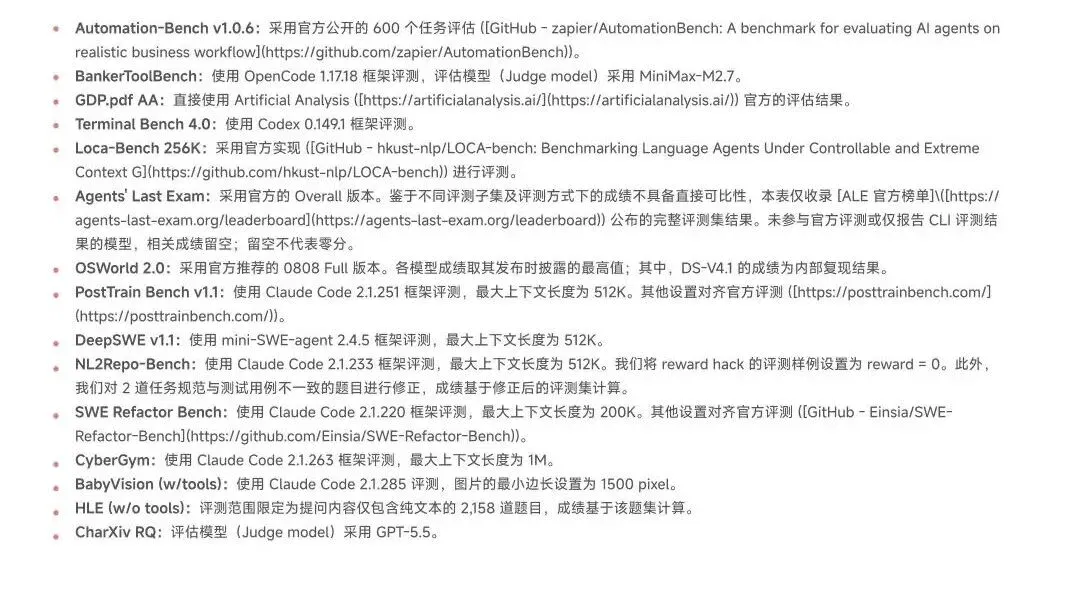
软件开发方面,M3.1 Flash 在 DeepSWE v1.1 中取得 73.7% 的成绩,接近 Opus 5 的 74.0%,高于 GPT-5.6 Sol 的 73.0%,低于 DeepSeek V4.1 Flash-1017 的 77.0%。该评测要求模型独立完成代码理解、功能开发、问题修复与测试验证,考察的是完整的软件开发流程。
电脑操作同样是此次更新的重点。
M3.1 Flash 在 OSWorld 2.0 中取得 61.7 分,在 Agents' Last Exam(ALE)中取得 29.6 分。前者考察电脑操作与跨应用任务执行能力,后者聚焦具有实际经济价值的电脑操作场景。按照官方公布的对比结果,两项成绩均位列国产模型第一,其中 OSWorld 2.0 成绩高于 Kimi K3 的 58.3 分和 DeepSeek V4.1 Flash 的 54.3 分。
网络安全方面,评测表显示,M3.1 Flash 在 CyberGym 中取得 82.2 分,高于 Kimi K3 的 80.0 分,低于 GPT-5.6 Sol 的 83.6 分和 GLM-5.3 的 84.5 分。MiniMax 表示,内部安全专家还对代码审计、漏洞修补、渗透测试、恶意代码分析和逆向工程等场景进行了深度评测,模型在这些任务中均有出色表现。
为了提高推理效率,MiniMax 采用了更激进的稀疏注意力架构。据官方数据,M3.1 Flash 在日常使用场景下的输出速度可超过每秒 200 Token,中位数速度达到每秒 170 Token 以上。
价格方面,M3.1 Flash 的输入价格为每百万 Token 1 元,输出价格为每百万 Token 4 元,缓存读取价格为每百万 Token 0.1 元。官方称,在 Agent 类任务中,模型的综合使用成本较前代降低了 70%。
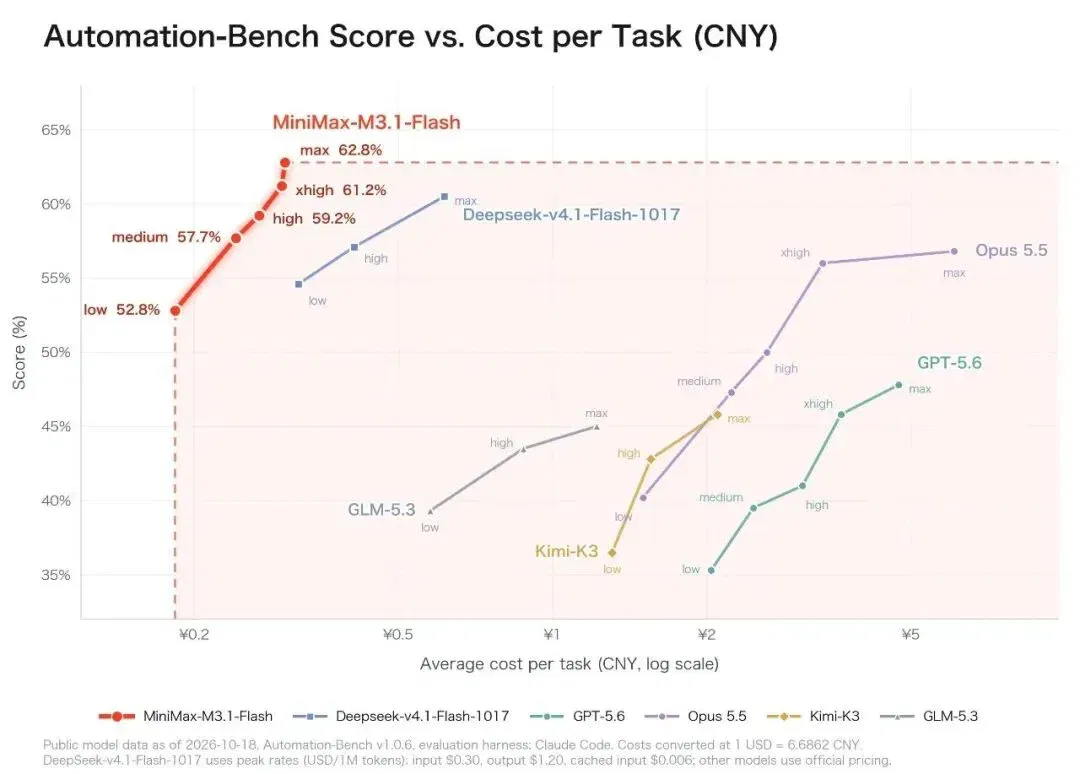
具体到实际任务,MiniMax 给出的一个例子是,花不到三毛钱,让模型尝试完成一项企业工作流任务。
在 Automation-Bench 中,随着推理档位从 low 提升至 max,M3.1 Flash 的成绩从 52.8% 提高至 62.8%。
按图中位置估算,平均每项任务成本约为 0.18 元至 0.30 元,在图示各档位下均低于 DeepSeek V4.1 Flash-1017。不过,该图采用的 DeepSeek 价格为高峰时段价格,其余模型采用官方定价。
在 DeepSWE 中,M3.1 Flash 的 high、xhigh 和 max 档位成绩分别为 68.1%、72.1% 和 73.7%,对应的平均任务成本均在 2 元以内。
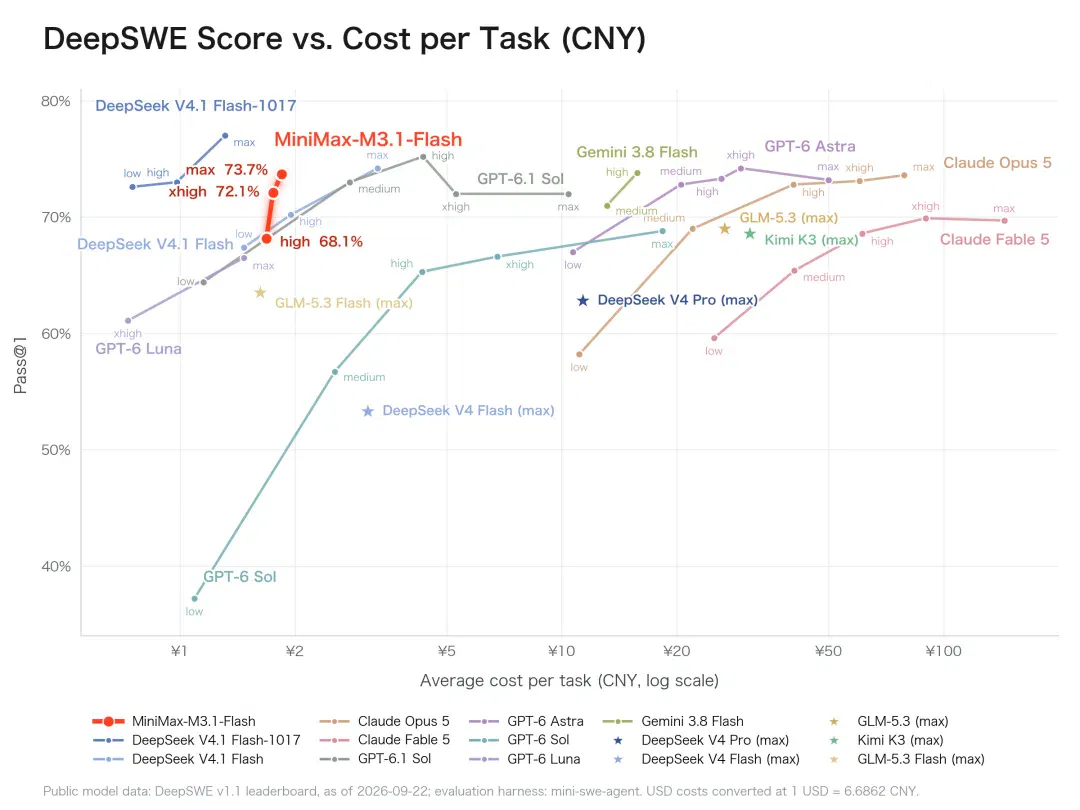
相比之下,图中 Claude Opus 5 达到约 74% 成绩时,平均每项任务成本已达数十元。不过,DeepSeek V4.1 Flash-1017 在这项测试中同时呈现出更高成绩和更低费用,说明不同模型的性价比优势仍与具体任务有关。
ALE 对比图则展示了完成整套评测的预计总费用。在包含 152 个任务的 Overall 评测中,M3.1 Flash 以约 739 元的预计总成本取得 29.6% 的通过率,是图中费用最低的模型。
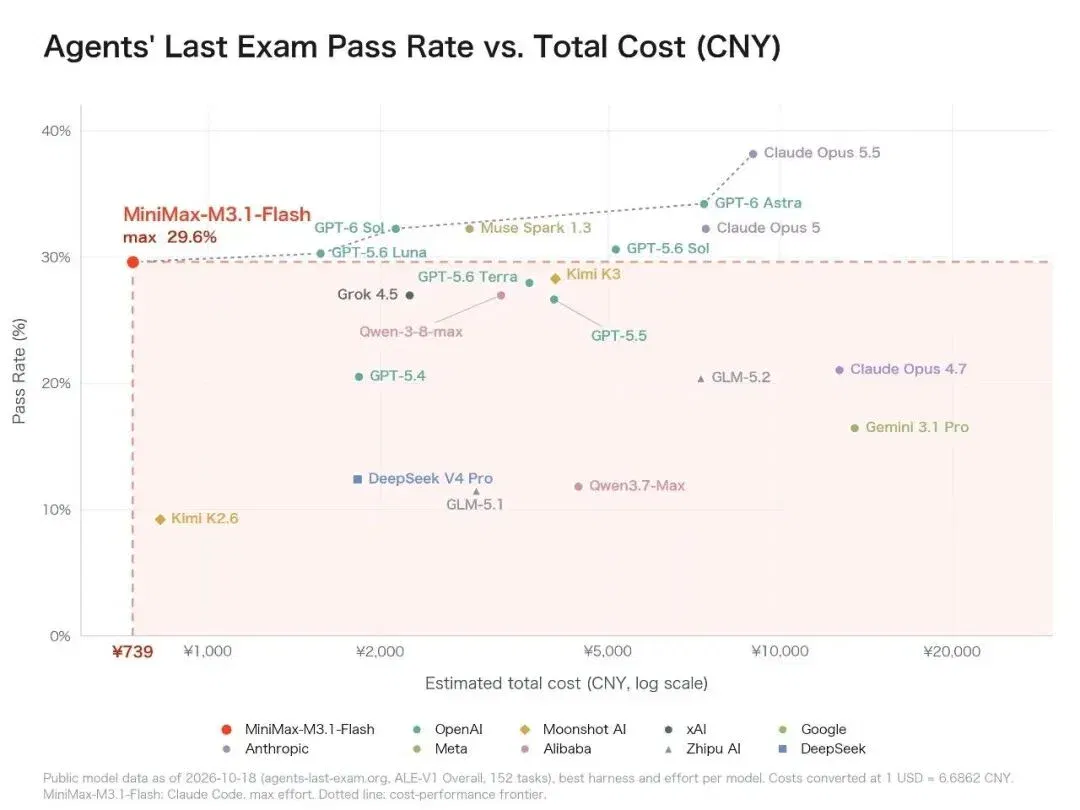
作为对照,GPT-5.6 Sol 的通过率约为 30.6%,预计总成本约为 5000 元;Claude Opus 5.5 的通过率约为 38%,预计总成本接近 9000 元。各模型采用各自表现最佳的运行框架与推理配置。
综合这些结果,M3.1 Flash 的卡位非常清晰:用极致的成本控制,撑起高频、高强度的 Agent 规模化调用。毕竟在海量调用的真实业务里,单次省下的几块钱,乘以规模就是真金白银的护城河。
目前,M3.1 Flash 已上线 MiniMax API、M Plan 和 MiniMax Code,模型权重也将于近期开源。
值得一提的是,APPSO 登录 Minimax Code 官网时发现,配合此次更新,MiniMax Code 同步推出两项限时权益。
即日起至 10 月 25 日,所有订阅用户均可在 MiniMax Code 内不限量使用 M3.1 Flash;
即日起至 10 月 31 日,新订阅或升级 M Plan 的用户可享首月五折优惠,次月起按原价续订。
此外 MiniMax 还埋了个彩蛋:主攻更高智能上限的 Pro 版本已经在路上了,后续将与主打高效率、低成本的 Flash 系列高低搭配。
文章来自于微信公众号 “APPSO”,作者 “APPSO”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
MiniMax M3.1 Flash 正式发布:成本降 70%,速度提 3 倍 (opens in a new tab)
刚刚,MiniMax 正式发布了 M3.1 Flash
MiniMax M3.1 Flash来了:Opus 5.5刷屏的绝活,它也能做 (opens in a new tab)
六天后的 9 月 28 日,MiniMax 上线了 M3.1-Flash-Preview。这是 M 系列的最新模型,百万 token 上下文、原生多模态,在 MiniMax Code 里首发上线,目前也可以通过 API 订阅套餐调用。
MiniMax Code lead on why review and task management matter as AI writes code (opens in a new tab)
MiniMax Code lead Ronny discusses internal adoption, context management and tool orchestration, then outlines personal-agent collaboration and task management. Figures such as 95% of code and 15% token-efficiency gains are team reports; future product forms are his views.
MiniMax 发布 H3-Image 并开放权重,支持 16 张参考图 (opens in a new tab)
H3-Image 支持文生图、参考图生成及编辑。MiniMax 公布了 4K 输出与最多 16 张参考图的能力,权重使用受其社区许可证约束。
MiniMax 闫俊杰谈推理成本、开放权重与多模态模型 (opens in a new tab)
闫俊杰在 Scottish Mortgage 播客解释低推理成本如何支持后训练,并讨论 H3 开放权重和 M3 Pro 的开发进度。访谈亦区分年化收入运行率与财报收入。