GPT-6 Astra也会「看错」流程图? Einsia AI发布PPTBench,视觉编程还有多远?
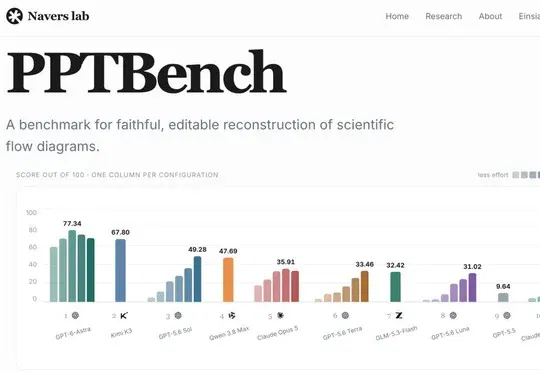
Einsia AI旗下Navers Lab发布视觉编程基准PPTBench,包含500个科学流程图任务并测试10个模型36种配置,GPT-6 Astra High以77.34分居首,但64.03%的结果因流程语义错误被拒,表明视觉理解仍是当前主要瓶颈。
Coding Agent 正在从屏幕里的终端世界走向屏幕外的物理世界。
过去,Agent 面对的主要是文本:给它一个任务,它通过调用工具、修改代码、运行测试,最终交付软件。整个过程,本质上都发生在字符串之间。
但如今,越来越多的任务开始将「视觉世界本身作为输入」。
一幅流程图、一张网页设计稿、一个 3D 场景草图,甚至一整页 PPT,都可以成为 Agent 需要理解并用代码重建的目标。于是,Coding Agent 正在面临一项新的考验:
「Visual Coding」—— 看懂一个视觉目标,并把它转化为可执行、可编辑的代码。
这看起来只是多了一层视觉输入,实际上却引入了一个全新的挑战:在保证代码能运行的基础上,Agent 必须还要从视觉输入中理解对象、结构、空间关系和语义,再把这些信息准确地编码进程序。
那么,如何才能既看清 Agent 在 Visual Coding 上走到了哪一步,又推动它继续向前?
一个好的测试载体,既要有足够丰富的视觉结构,又要能够被程序化地表达和编辑。
PPT 恰好满足了这两个条件。一页 PPT 不是一张简单的图片,而是由文本、形状、连接线、分组和空间布局共同组成的可编辑对象集合。它既保留了视觉世界中的结构,又给出了一个天然的程序化表达空间。视觉上的相似,并不意味着语义上的正确。 一条箭头接错节点,流程关系就变了;一个小节点被漏掉,整个过程的含义也可能随之改变。
这也正是 Einsia AI 旗下 Navers Lab 最新发布的PPTBench想回答的问题:
「今天的 AI Agent,能不能真正看懂视觉目标,并把它准确转化成代码?」
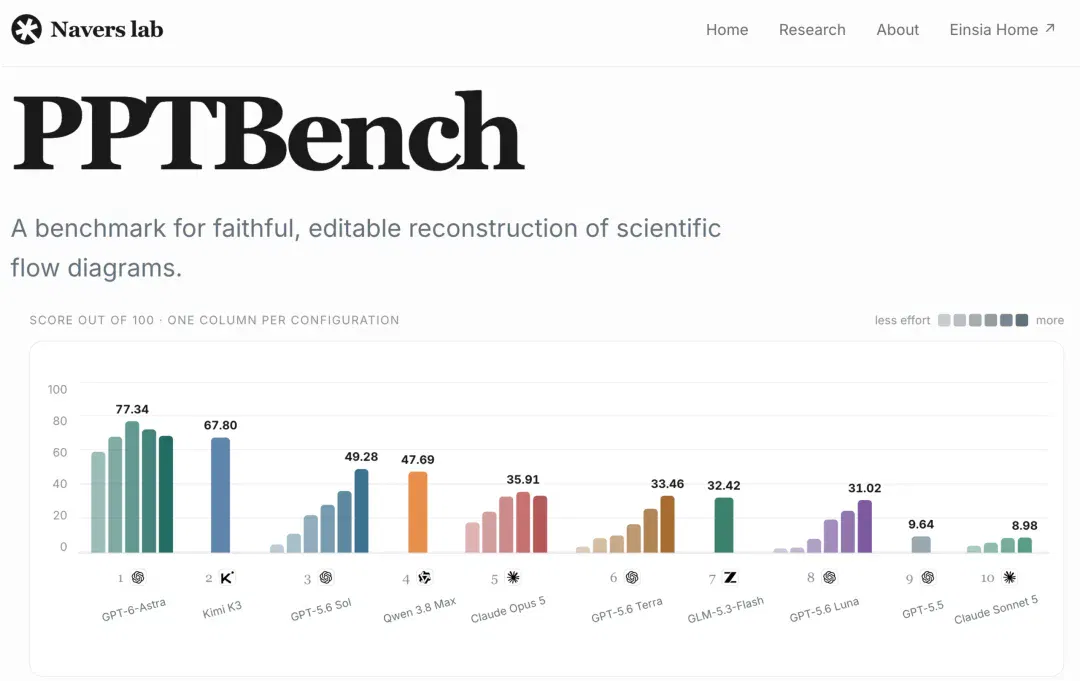
- 论文题目:PPTBench: Can Coding Agents Reconstruct the Visual World through Structured, Editable Slides
- 项目主页:https://lab.einsia.ai/pptbench
- GitHub:https://github.com/Einsia/PPTBench
- arXiv: https://arxiv.org/abs/2609.29718
- AgentGit(查看部分评测Session): https://agent-git.com/@einsia/ppt-bench
当 Agent 不再只是写代码,而是要理解 “图在说什么”
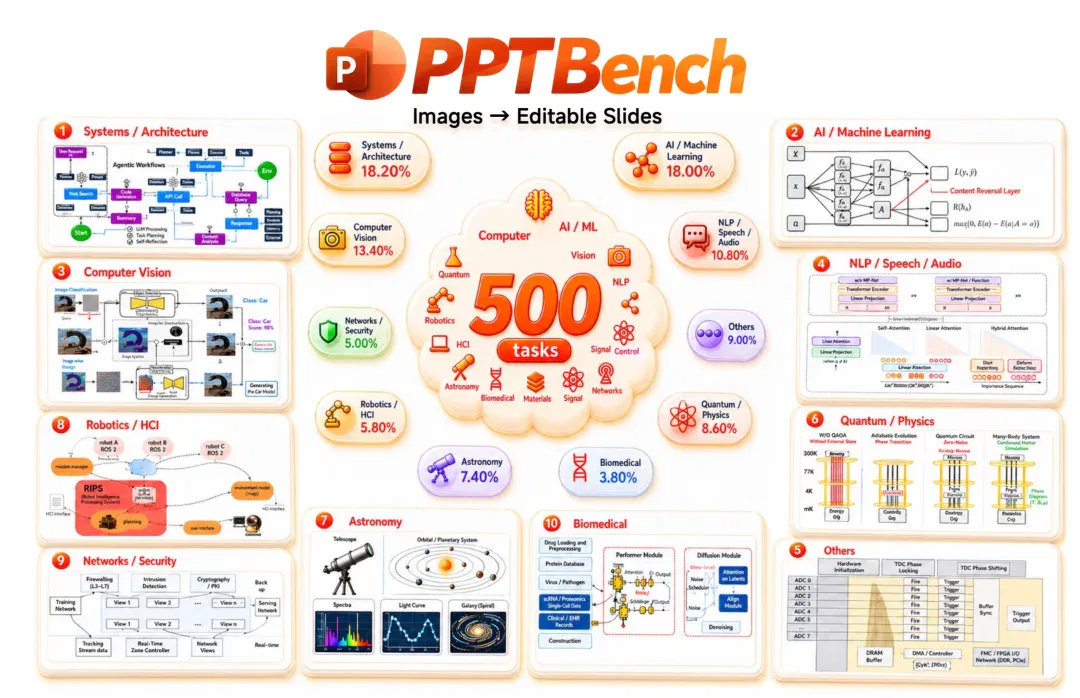
PPTBench 的任务来自真实科学论文中的流程图和架构图。研究团队从中构建了500 个任务,覆盖系统与软件、人工智能、计算机视觉、语言与语音、量子与基础物理、天文、机器人、生物医学等13 个领域,同时包含多面板图、层级结构、重复网格、复杂连线和文字密集等不同类型的布局。
对 Agent 来说,任务非常直接:
给定一张流程图,用代码把它重建成一页 PowerPoint。
输入是一张确定的视觉目标,输出则是一份真正由代码生成的、可编辑的 PPTX。Agent 不能简单地把原图贴进幻灯片,而需要用文本、形状、连接线等原生 PowerPoint 对象,把看到的内容重新表达出来。
真正困难的地方,也恰恰藏在这里。
Agent 首先要看懂这张图:识别其中有哪些节点、文字和关系,理解连接线从哪里出发、指向哪里;然后要把看懂的内容写出来:将这些结构准确地映射到二维画布,处理节点大小、间距、文字和连线的位置;最后还要交付一个正确的程序化产物:生成的 PPTX 能够正常打开,里面的内容也必须是真正可编辑的对象。
换句话说,这不是简单地 “把一张图画出来”。
它要求 Agent 同时解决三个问题:看懂、写对、交付。
流程语义错了,图表达的就是另一个算法;几何位置错了,虽然还能看懂,却失去了原图的精确结构;产物本身出了问题,则连后续查看和编辑都无法进行。
也正因为如此,一个看似简单的 “照着图做 PPT”,实际上成为了检验 Visual Coding 能力的一道综合测试。
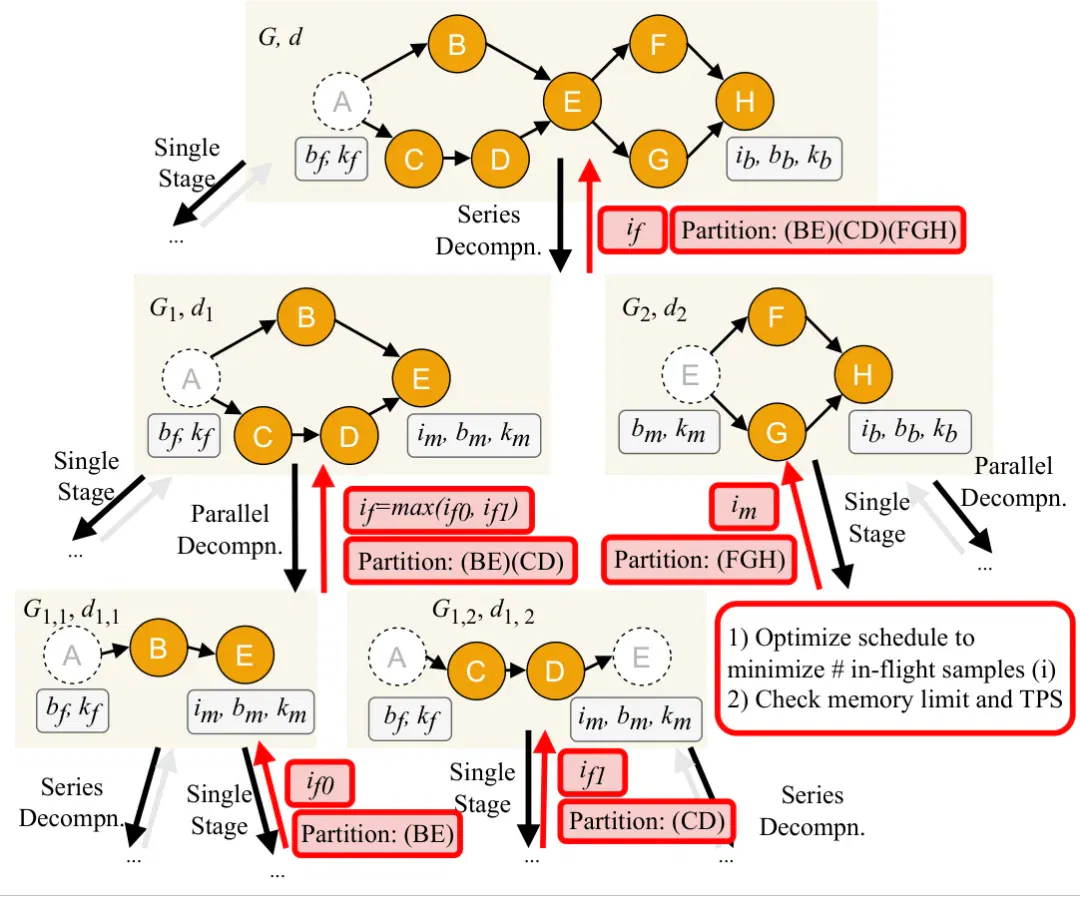
输入:一张流程图
输出:Agent重建成为可编辑的PPT
Agentic Judge:让 “看懂” 和 “做对” 都能被评测
一张还原出来的 PPT,可能和原图看上去几乎一模一样。但如果它本质上只是一张截图,就无法真正编辑;如果箭头方向反了,流程表达的语义也随之改变;如果出现大面积渲染错误、文字溢出或严重遮挡,整张幻灯片甚至失去了基本的可读性。
更复杂的是,PPT 中的同一个视觉元素,往往可以有完全不同的对象表达方式。
一个田字格可以由四个方块组成,也可以由一个方块和两条直线组成;一个对勾可以由两条直线拼成,也可以由一个多边形直接绘制。对于传统的规则系统来说,很难穷举这些 “一对多” 的表达方式。
PPTBench 因此设计了一套Agentic Judge。它不要求 Agent 按照某一种固定的对象树来重建,而是从最终交付的 PPT 出发,逐层判断它是否真正完成了任务。
首先是一个Artifact Gate,判断产物是否具备进入正式评测的资格。Judge 会检查 PPTX 能否正常解析和渲染,是否生成了单页幻灯片,是否包含足够的原生可编辑对象,以及是否存在直接贴图等不符合要求的情况。如果产物本身无效,就直接判为 0 分。
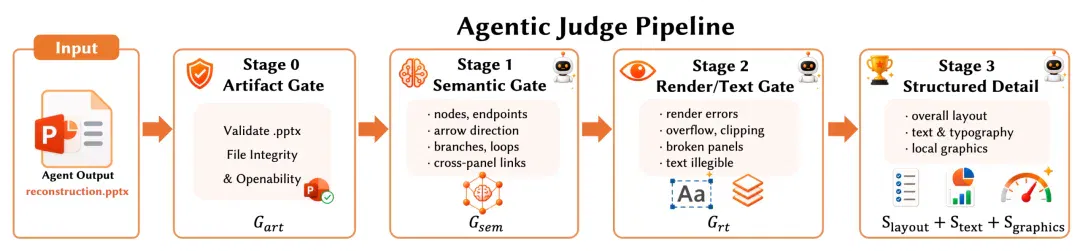
通过 Gate 后,Agentic Judge 再依次完成三个阶段的评测。
Stage 1:先判断 “做没做对”
这一阶段关注的是最核心的问题:Agent 重建出来的图,是否还在表达原来的过程。Judge 会从整体上理解参考图和生成结果,判断关键关系有没有被正确还原。只要流程本身发生了改变,即使视觉上再接近,也不能算正确。
Stage 2:再判断 “能不能看”
语义正确之后,Judge 进一步检查生成结果是否具备基本的可读性。严重的渲染问题或排版错误,可能让一张语义正确的 PPT 依然无法使用。这一阶段主要排除这类影响整体阅读的错误。
Stage 3:最后判断 “有多像”
通过前两关之后,Judge 才进入细节层面的比较。它会进一步分析整体布局和局部视觉差异,并把发现的问题结构化记录下来。这里不再要求两份 PPT 使用完全相同的对象表达方式,而是关注最终呈现出来的视觉结果是否足够接近。
总结来说,Agentic Judge 并不是简单地问 “这张 PPT 像不像原图”,而是依次回答三个问题:它做对了吗?它能看吗?它还差多少?
Agent 距离稳定复现 PPT 还有多远?
研究团队测试了 10 个模型、36 种配置,每种配置完成同一组 500 个任务。每份结果经过三轮评审,累计得到 54,000 份评审记录。
GPT-6 Astra High以77.34 分位居榜首。在 500 个任务中,它全部生成了有效产物,80.8%同时通过语义和渲染检查。
其他参评模型中,Kimi K3 High表现最好,得分为67.80;GPT-5.6 Sol Max和Qwen 3.8 Max XHigh分别得到49.28和47.69分。
Astra 的领先比较明显,但即便是这一最优配置,也仍有近两成任务没能同时通过两道检查。
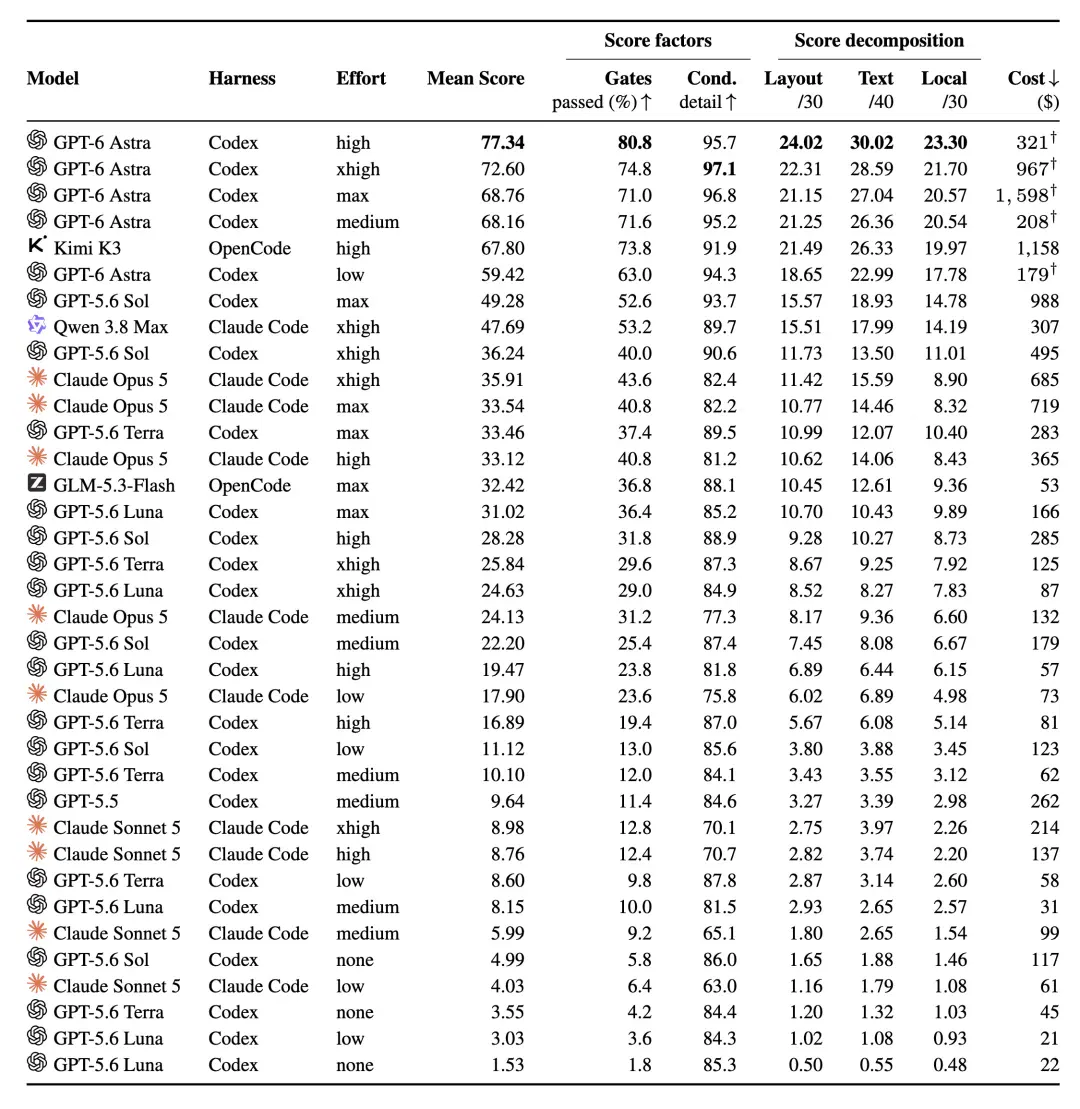
这些分数背后,模型究竟在哪些环节出了问题?
视觉理解,远难于代码本身
模型还原一张 PPT 的难点,并不在于写出能被正确解析的文件;而是在于,这张文件里,到底是否表达了正确的含义。
在所有的18000份结果中,394 份(2.19%)未通过产物检查;随后,11526 份(占全部结果的 64.03%)因流程语义错误被拒绝。剩余 6080 份中,又有 365 份未通过渲染/文字门控,最终 5715 份(31.75%)进入细节评分。
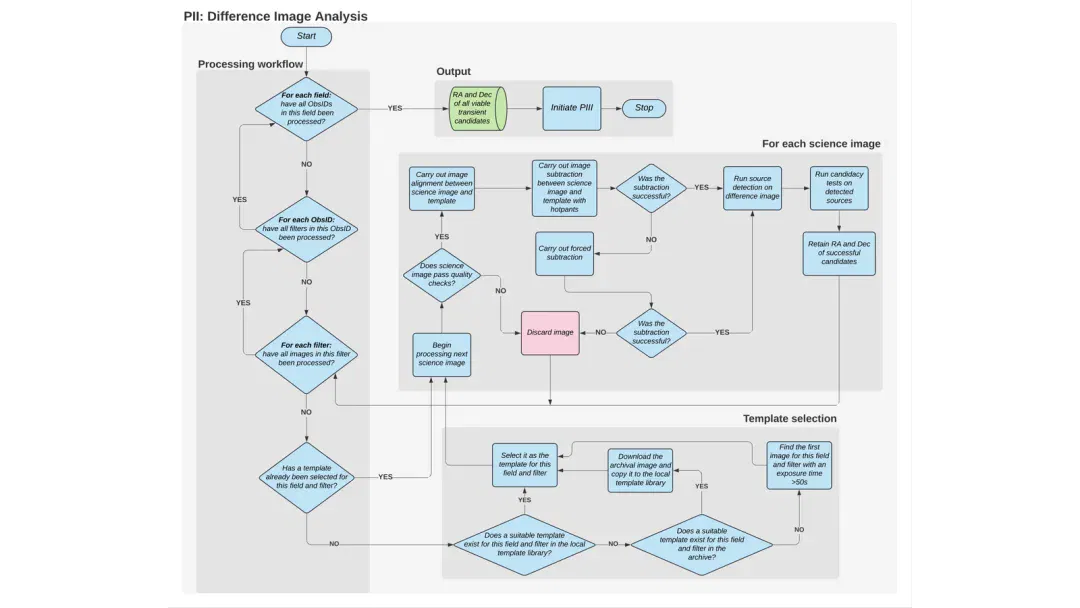
流程图输入
Astra 6生成的结果,未通过语义门控
而在进入细节评分产物当中,文本与排版问题贡献了53.0%的细节扣分,局部图形占 34.3%,布局占 12.8%。失分最多的单项是文本意外换行。
这些问题又恰恰是文件代码本身无法直观体现的。一份生成 PPT 的脚本本身并不会告诉模型渲染出来的文字是否会在不应该出现的地方换行、是否会挤爆整个文本框;但在真正渲染出来的产物当中,这恰恰又是最明显的问题。
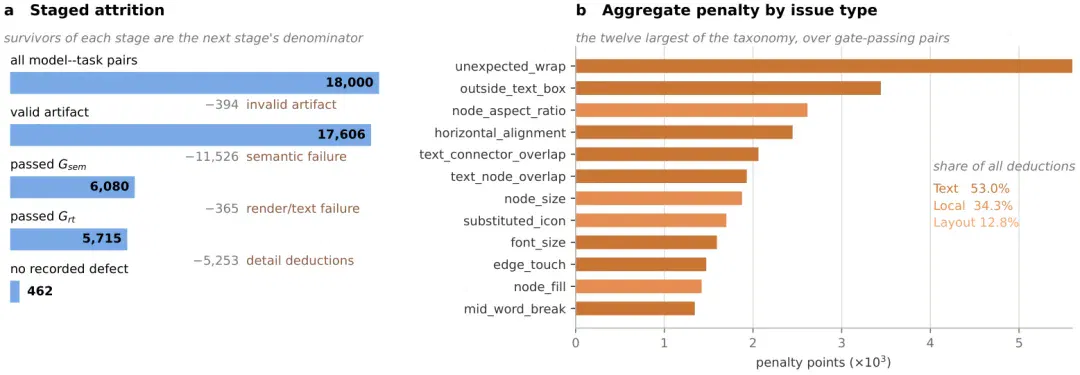
只有真正能够进行视觉审查与迭代的模型,才能够真正发现并且解决这些问题。
更多思考换来的是流程理解,而非细节重建
提高 reasoning effort,收益主要体现在更高的门控通过率。
GPT-6 Astra 从 Low 到 High,平均分由59.42 升至 77.34,通过全部门控的比例由63.0% 升至 80.8%,提高 17.8 个百分点;通过门控后的条件细节分仅由 94.32 升至 95.72。
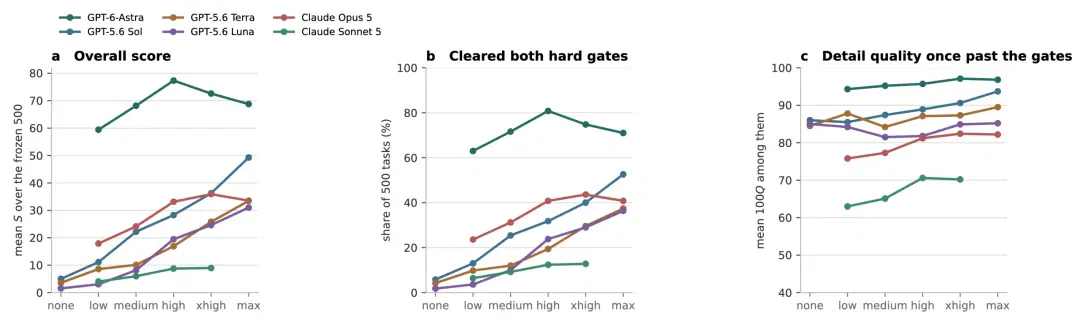
但更多思考并不保证更高得分。Astra 五档的平均分依次为 Low59.42、Medium68.16、High77.34、XHigh72.60、Max68.76。从 High 到 Max,门控通过率从 80.8% 降至 71.0%,尽管通过门控后的条件细节分升至 96.85,总分仍然下降。
这说明,思考深度带来的主要收益是让更多产物保留正确的流程,而细节精度的改善相对有限。Astra 在 High 达到最佳表现,也提醒我们:把 effort 调到最高档,或许并不是可靠的默认选择。
「回头去看」,让模型的复现变得更好
模型构建 PPT 的过程和人类并不相同。
人类会把组件一个一个拼上去;而模型则会一次写出完整的 PPTX 生成脚本,再根据视觉反馈来调整。
分析模型的调用轨迹,论文发现:对自己的产物进行视觉检查次数更多的模型,往往得分更高。
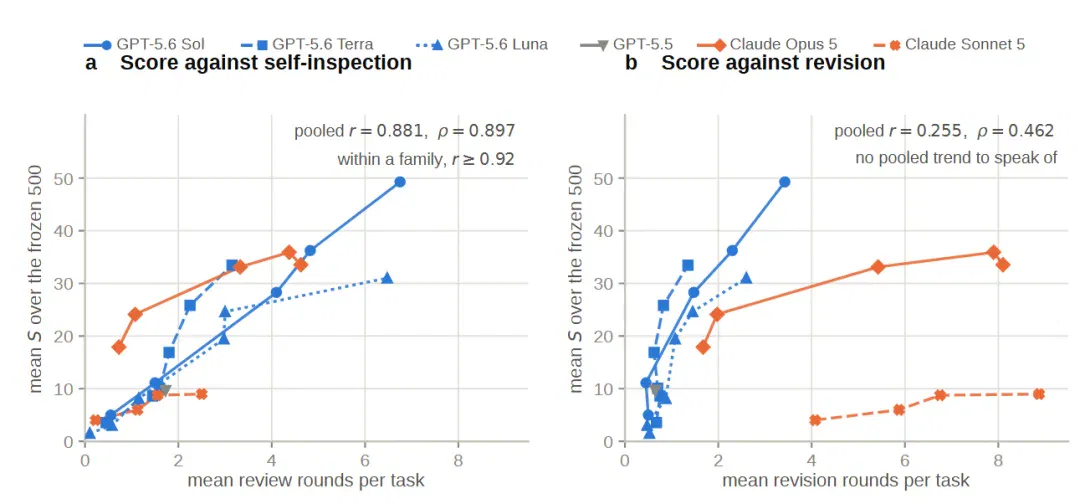
在解析了调用轨迹的 27 个配置中,模型审查轮数与得分的 Pearson 相关系数为0.881;作为对比,修改轮数与得分的相关系数仅为0.255。
视觉审查让模型得到最直接的反馈,让模型对下一步要做什么有直接的判断:是调整节点间距,改变箭头流向,还是修复渲染问题。
而这,正是 Visual Coding 的核心:
「当模型能够自主决定何时需要观察,能够理解自己看到了什么,并且能够做出适合的修改,视觉任务就迈向了下一个里程碑。」
PPTBench 想回答的,不只是 “谁最强”
一张科学流程图不是装饰性的海报。它同时承载了过程语义、空间关系和大量局部细节:任何一个箭头的错位或反向、节点的缺失或交换,表达的流程就完全不同。
PPTBench 的实验表明,前沿 Agent 已经能够完成相当复杂的视觉重建。但从 “能够还原” 到 “稳定地还原正确”,中间仍然存在明显的距离。 语义理解是最主要的瓶颈,而当语义基本正确之后,文字、布局和局部细节又成为新的挑战。
因此,PPTBench 想测量的并不只是模型能不能做出一张 PPT,而是一个更基础的问题:
「当 Agent 看到一个视觉目标时,它能不能真正理解其中的结构,并把这种理解可靠地写进代码?」
这也是 Visual Coding 下一阶段真正需要解决的问题。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Frontier3DBench 测量智能体制作 3D 物体、场景与开放世界的能力 (opens in a new tab)
Einsia AI 用 Blender 和 Unreal Engine 中的 145 项任务比较 11 种模型与工具组合。评测发现连续移动、避障和状态管理比局部交互更容易失分。
深度|Einsia AI发布 LaPlace's Eye:在未来尚未命名时,看见新的可能 (opens in a new tab)
从软件迁移、浏览器操作,到仿真中的机器人任务,再到市场数据...翻看Einsia AI已经公开的研究项目,会发现他们的研究从不只围绕一个模型或一个行业展开,他们似乎热衷于不断把模型放进新的环境里,观察它能不能完成任务、能不能从结果中积累经验。
刚刚,全球首个开源Agent会话平台发布!老板、同事和我共享一个AI (opens in a new tab)
当 AI Agent 开始连续数小时替人工作,真正有价值的就不只是最终成果,还有藏在会话(Session)里的整个过程:它做过什么、哪里失败、为何改变方向。
BrowserBC:克隆人类点击,让一次网页操作转化为所有Agent的能力 (opens in a new tab)
Agent从来不是不会用浏览器,只是浪费太多时间在探索——BrowserBC把人类轨迹蒸馏成可复用Skill来完成Behavior Cloning,用户点一遍,Agent照着就能跑通。Einsia AI旗下Navers Lab发布的开源项目BrowserBC给出的答案,是一条三步范式:录制→转写成Skill→交付执行。
WorkflowArena 评测多智能体编排,覆盖 145 项长程任务 (opens in a new tab)
Einsia AI 团队在八个领域比较九个模型的 25 种推理配置。按其完全解决标准,最高配置得分为 36.95%,工作流迁移实验另采用连续得分。