WorkflowArena 评测多智能体编排,覆盖 145 项长程任务
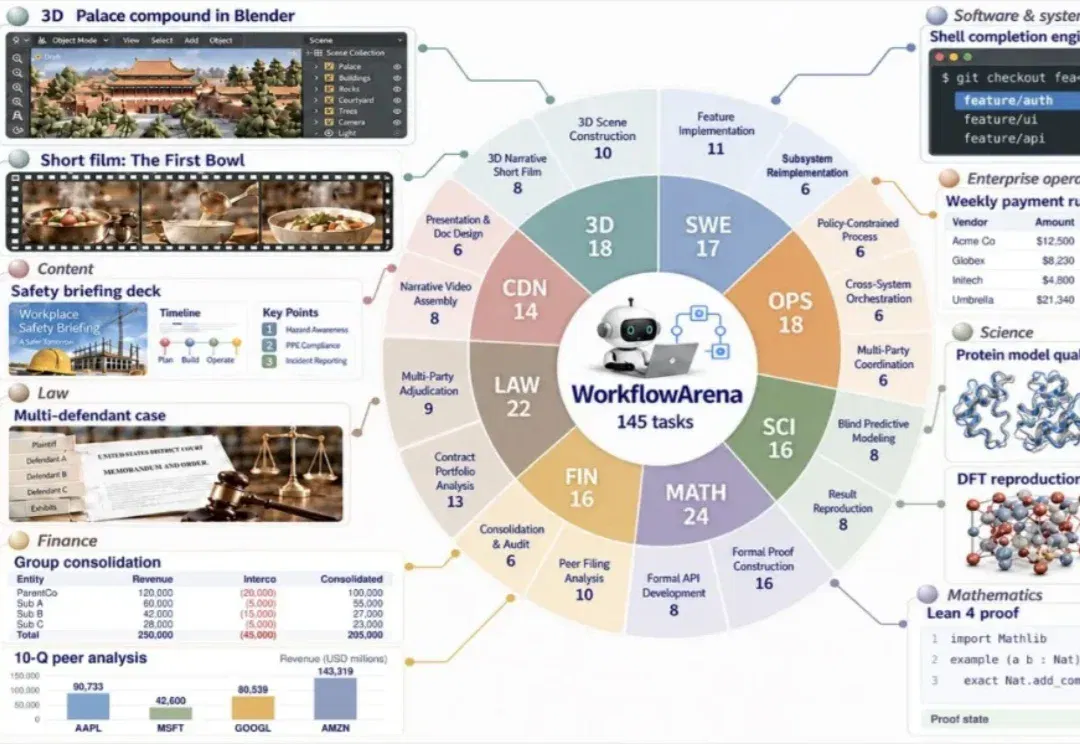
Einsia AI 团队在八个领域比较九个模型的 25 种推理配置。按其完全解决标准,最高配置得分为 36.95%,工作流迁移实验另采用连续得分。
智能体正从单打独斗走向多智能体协同。
如今的 Claude Code、Codex 等框架,已经允许模型在运行时自己拉起子智能体,甚至直接写出调度它们的可执行工作流:任务怎么拆、每个子智能体拿到什么上下文、中间结果在哪里校验、最后如何整合。过去由工程师预先设计好的多智能体结构,正在交给模型自己临场决定。
这意味着,多智能体编排本身成了一项关键能力。同样一批智能体,组织得好可以事半功倍,组织得不好则会互相拖累。但现有评测要么只看任务最终有没有完成,要么在设计者预先规定好的协作结构里测试,始终没有回答一个问题:
「面对真实的长程任务,大模型能不能自己把多智能体系统组织好?」
为此,Einsia AI 旗下 Navers Lab 发布WorkflowArena,专门评测大模型的多智能体编排能力。基准包含145 项长程任务,覆盖软件工程、企业运营、科学研究、数学推导、金融、法律、内容设计与 3D 制作8 大专业领域,对9 个主流前沿模型的 25 种推理配置进行了全面评测。
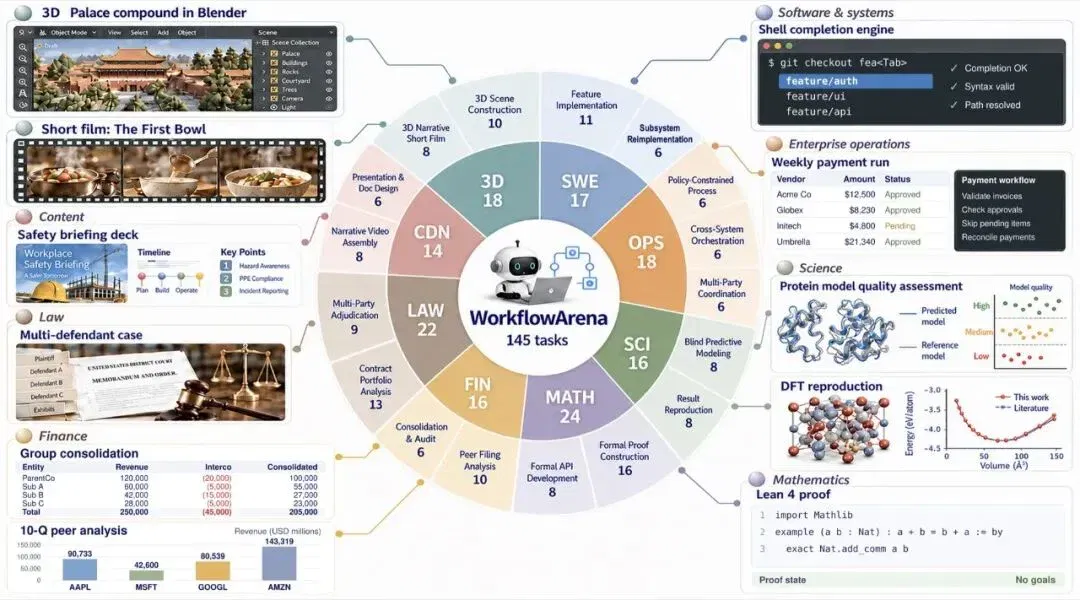
WorkflowArena 的 145 项任务分布在 8 大领域、17 种任务形态
- 论文题目:WorkflowArena: Benchmarking Executable Workflow Orchestration in LLM-Based Multi-Agent Systems
- 项目主页:https://lab.einsia.ai/workflowarena
- GitHub:https://github.com/Einsia/WorkflowArena
- Arxiv:https://arxiv.org/pdf/2611.12856
不规定怎么分工,只看最终交付
WorkflowArena 的每道题,都是一份真实的专业交付:修改一个开源代码库、复现一项科学结果、完成一套 Lean 形式化证明、编制一份多主体合并报表、分析一起多被告案件,或在 Blender 里搭出一座完整的建筑群。
这些交付物的共同点是,各部分环环相扣:代码改动要通过原有的回归测试,财务数据要在不同主体之间对得上,法律结论要在多份文书间保持一致,3D 场景的各个部件要拼得严丝合缝。每一块单独做对还不够,整合在一起才算数。
能拆、但拆完必须对齐,正是编排能力的用武之地:比如合同组合分析,每份合同可以分头审,但合同之间的冲突必须合起来才看得出。
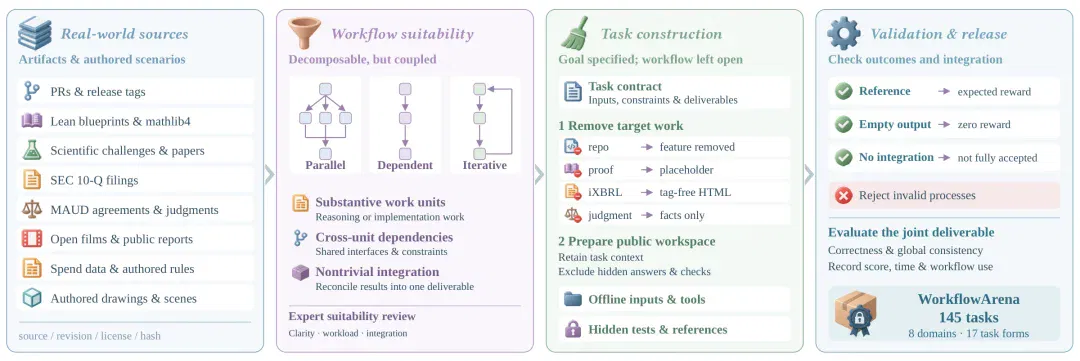
WorkflowArena 构建流程:真实素材 → 筛选「可拆分但相互耦合」的工作 → 只规定目标、不规定工作流 → 校验结果与整合。
评测中,模型拿到的是一个空白的「指挥台」:
- 怎么编排,模型自己定。它可以自己动手,也可以通过 Workflow 工具同时调度多个子智能体,并随时查看、终止、修改工作流。要不要分工、怎么分工,完全由模型决定。每个子智能体该知道什么,也由它来交代。
- 编排也要花时间。主智能体和所有子智能体共享推理预算,规划、调度、返工都算在里面。
- 判题隐藏,过程留痕。模型看不到判题器和标准答案,评分只看交付结果,与用了多少子智能体无关;同时,每一次调度都被完整记录下来。
这样一来,WorkflowArena 不仅能看到「做得怎么样」,还能看到「是怎么组织起来做的」。
最强系统也只解决 36.95%,没有全能选手
WorkflowArena 采用严格的完全解决率:只有交付物满足全部验收标准,才算真正解决。各部分都做对、却没整合好的提交,同样判为失败。
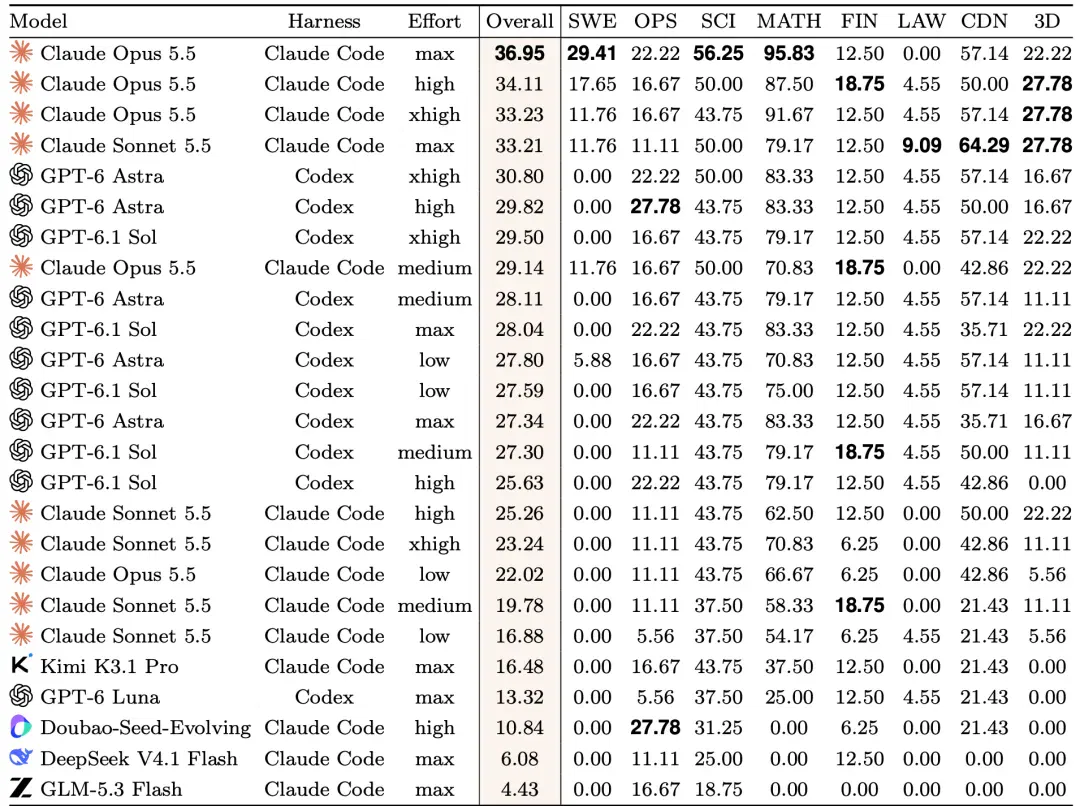
25 种配置在 8 大领域的完全解决率(%),按总体结果排序。
榜首是Claude Opus 5.5(max),平均完全解决率36.95%。换句话说,即便是当前最强的系统,也有六成以上的任务没能完整交付。
领域之间的差距更加悬殊。形式化数学已接近饱和,Claude Opus 5.5 解决了95.83%;但软件工程最高只有 29.41%,金融最高 18.75%,法律最高仅9.09%。
而且,没有一个系统能通吃全部领域:Claude Opus 5.5 领跑软件工程、科学与数学,Claude Sonnet 5.5 拿下法律和内容设计,GPT-6 Astra 与 Doubao-Seed-Evolving 则拿下企业运营的并列第一。
Claude 与 GPT:两种截然不同的编排风格
由于每一次调度都被记录在案,WorkflowArena 把不同模型「怎么组织多智能体」摆在了同一张图上。
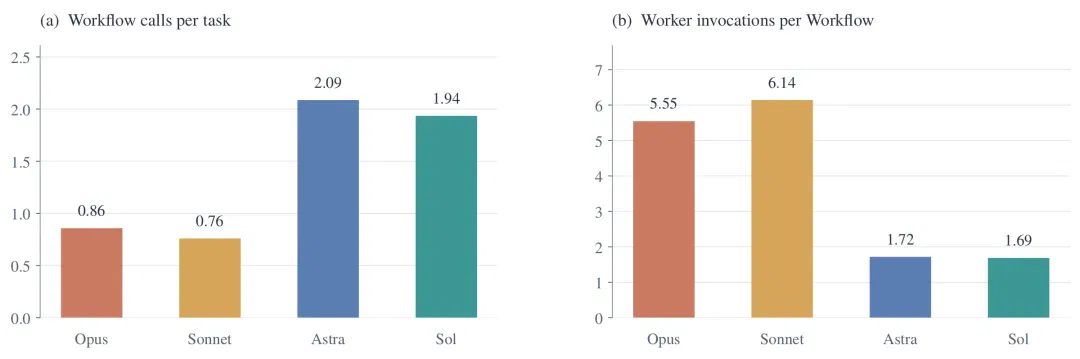
每道题平均调用 Workflow 的次数(左)与每个 Workflow 平均调度的子智能体数(右)。
结果显示出两种鲜明的风格:
- Claude 系「谋定后动」:调用少,规模大。Claude Opus 5.5 和 Claude Sonnet 5.5 平均每题只调用 0.86 和 0.76 次 Workflow,但每次平均调度 5.55 和 6.14 个子智能体;9 个以上子智能体的大型编排,在 Sonnet 中占到 30%。
- GPT 系「小步快跑」:调用勤,规模小。GPT-6 Astra 和 GPT-6.1 Sol 平均每题调用 2.09 和 1.94 次,但每次只调度 1.72 和 1.69 个子智能体,约 99% 的工作流不超过 4 个。
这种风格差异还会随任务领域变化。
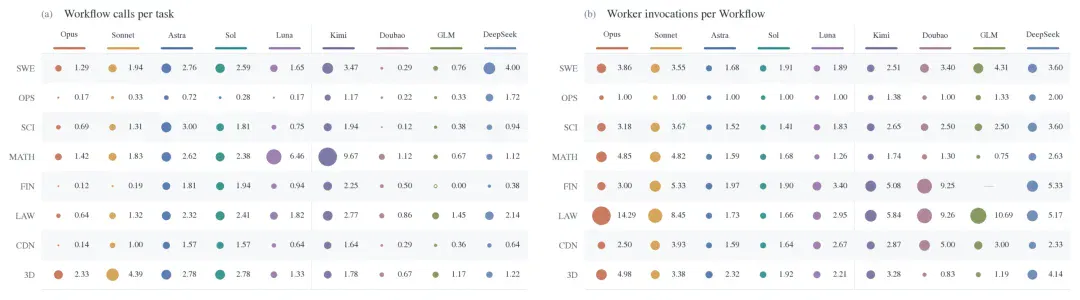
9 个模型在 8 大领域的委派频率(左)与委派规模(右),圆圈越大数值越高。
法律任务中,Claude Opus 5.5 每个工作流平均调度 14.29 个子智能体,GPT-6 Astra 只有 1.73 个;数学任务中,Kimi K3.1 Pro 每题调用 9.67 次 Workflow,每次却只调度 1.74 个子智能体。调用得勤,不等于协作的规模大。
换一个编排者,弱模型也能明显变强
系统得分高低主要由两部分决定:工作流设计和模型执行能力。那么,编排本身到底值多少分?
研究团队设计了一个巧妙的实验:执行模型固定不变,只更换编写工作流的模型。Claude Opus 5.5 和 GPT-6 Astra 担任编排者,Kimi K3.1 Pro、GPT-6 Luna、DeepSeek V4.1 Flash、Doubao-Seed-Evolving 担任执行者;编排者不能亲自修改任何文件,所有实际工作都由执行模型完成。实验分两种模式:编排者写完工作流就离场(静态),或者全程在线、根据反馈不断调整(动态)。
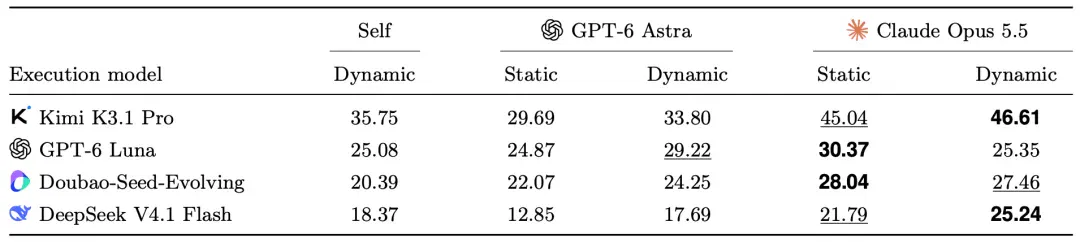
核心子集上的工作流迁移结果。Self 为执行模型自己编排;加粗与下划线分别为每行最高与次高分。
注:这里比较的是连续得分(部分完成也计分)。子集难度明显更高,Kimi K3.1 Pro 在全部任务上平均 62.73 分,在这里只有 35.75 分。
Opus 编排的工作流,让所有执行模型都变强了。
- Kimi K3.1 Pro 从 35.75 分提升到46.61分,涨了近 11 分;
- DeepSeek V4.1 Flash 从 18.37 分提升到25.24分;
- 四个执行模型平均提升6.41分(静态)和6.27分(动态)。
由于 Claude Opus 5.5 全程没有碰过任何文件,这些提升来自它设计的工作流,以及它交给每个子智能体的指令。
更有意思的是:自己会做,不代表会编排。
GPT-6 Astra 本身是一个强得多的系统:在全部 145 道题上平均得分 77.29,明显高于四个执行模型(最高为 Kimi K3.1 Pro 的 62.73)。可它编排的工作流交给别人执行,效果却差强人意:静态模式平均降低 2.53 分,动态模式平均提升只有 1.34 ,还拉低了 Kimi K3.1 Pro 和 DeepSeek V4.1 Flash 的成绩。
上述结果说明,多智能体编排能力并不是任务完成能力的副产品,而是一项需要单独衡量、也值得单独优化的能力。
算笔经济账:编排一道题要花多少钱?
把完全解决率和每道题的平均推理成本放在一起,就得到了这张性价比地图。
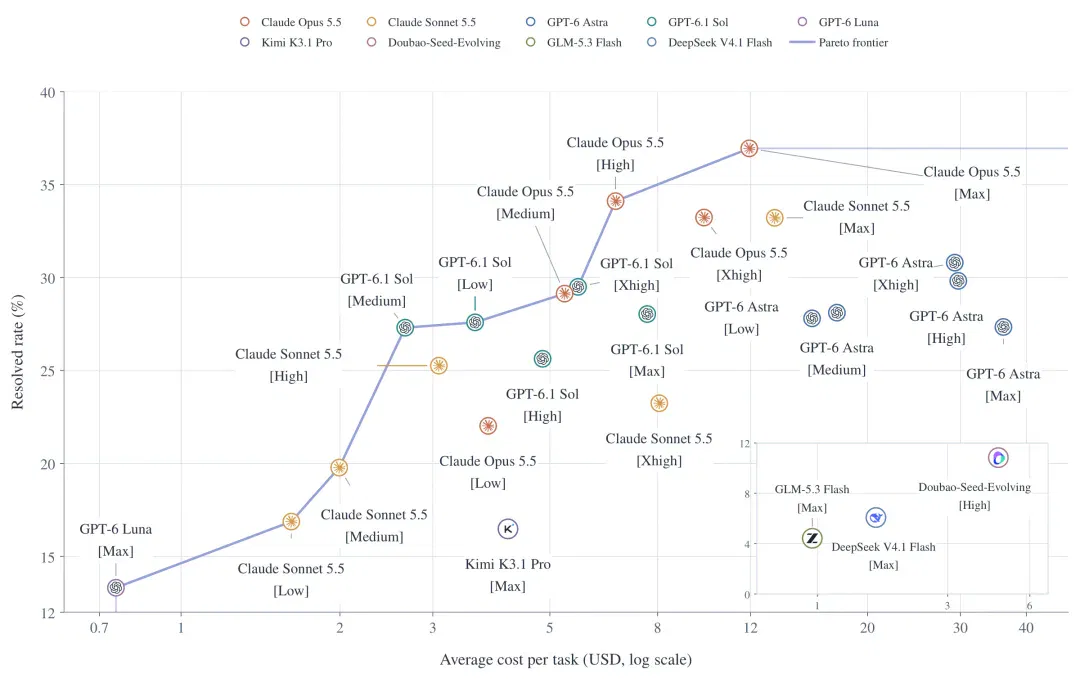
总体完全解决率与单题平均推理成本(对数坐标),折线为帕累托前沿。
不同系统的编排成本相差数十倍。同样是组织子智能体完成一份长程交付,最省的配置每题不到一美元,最贵的要几十美元。
但钱多不等于编排好。GPT-6 Astra 每道题的花费是 Claude Opus 5.5 的好几倍,解决率却始终没能追上 Claude Opus 5.5。同一个模型把推理强度往上调,成本大幅增加,收益却很有限。
决定上限的,是编排得好不好,而不是烧了多少 token。
同一座建筑,两种编排思路
3D 建造任务让编排的差异变得一目了然。模型需要根据施工图纸和设计变更单,在 Blender 中搭出完整的建筑场景。
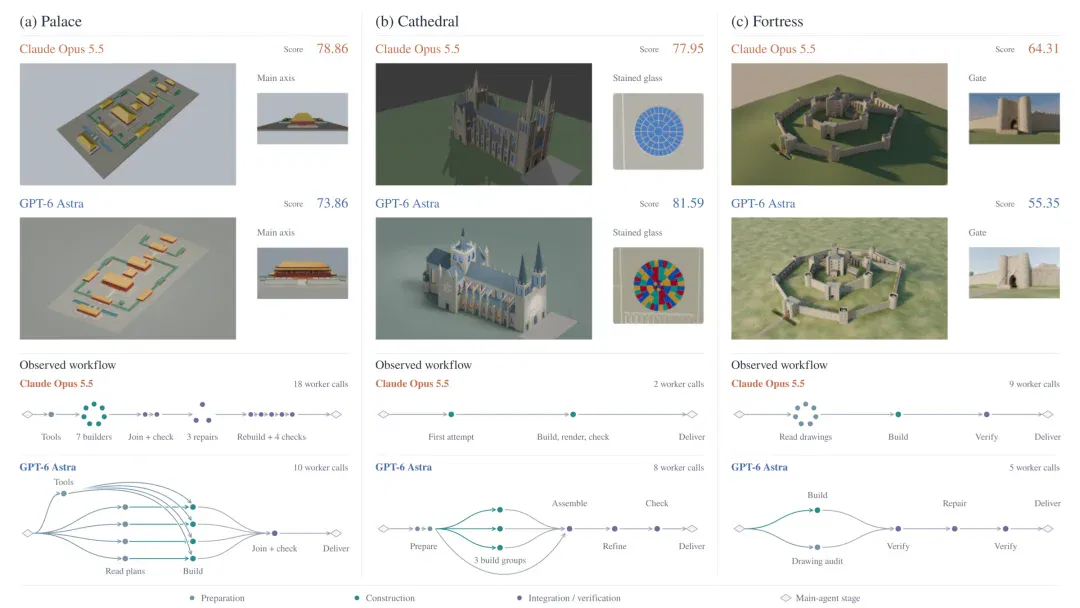
宫殿、大教堂、要塞三项任务中,Claude Opus 5.5 与 GPT-6 Astra 的交付成果与工作流对比。
- 宫殿:Claude Opus 5.5 同时派出 7 个子智能体分头建造各个殿宇,再组装、检查、多轮修复(78.86 分);GPT-6 Astra 先打好共享基础,再交给单个子智能体统一组装(73.86 分)。
- 大教堂:Claude Opus 5.5 选择两次整体建造(77.95 分);GPT-6 Astra 则把教堂按区域分给三个子智能体,再单独整合(81.59 分)。
- 要塞:两者都只用一个主建造者,但 Claude Opus 5.5 在动工前先派出 7 个子智能体研读图纸(64.31 分),GPT-6 Astra 则边建边审图(55.35 分)。
同样是 3D 建造,有的编排用来并行造部件,有的用来为主建造者备好图纸。没有放之四海而皆准的编排方式,好的编排取决于任务本身的结构。
从「能执行」到「组织协同」
当任务越来越长、越来越复杂,决定上限的不再只是单个模型有多强,而是整个系统如何被组织起来。
WorkflowArena 的结果说明,今天的大模型在多智能体编排上仍有很大提升空间;而一份好的工作流,本身就能让同一批模型交出明显更好的成果。
WorkflowArena 完整记录了每份交付物和产出它的工作流,也为后续研究留下了空间:让强模型负责编排、弱模型负责执行的异构多智能体系统,或许正是下一步的方向。
从「一个 Agent 完成一件事」到「一个 Agent 组织一群 Agent 完成一件事」,系统智能的竞赛,才刚刚开始。
文章来自于"机器之心",作者 "机器之心"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
最强AI改进自己仅得0.16分? Einsia AI发布AI4AI-Bench: AI能否设计出更好的AI? (opens in a new tab)
导读 AI 能否改进 AI 自己? AI 已经会写 AI、训练 AI、优化 AI 系统;下一个里程碑,是 AI 能不能开始「设计 AI」。 对于今天的 Coding Agent 来说,它能介入的改进大致有三层: 系统工程解决算子、并行和通信,最终受硬件上限约束;数据工程改进配比、合成和清洗,受高质量信息供给限制;而算法设计改变的是目标函数、更新规则和训练流程本身。 这一层最特殊,一个更好的算法改变的是:在同样的数据和算力下,究竟能换来多少能力。 Adam、DPO、GRPO 这样的进步一旦出现,就能持续影响之后的一代代模型。 所以,如果 Recursive Self-Improvement 真要
Auto Research时代,47个没有标准答案的任务成了Agent能力必测榜 (opens in a new tab)
如果把AI丢进一个没有标准答案的工程现场,它还能活下来吗?
Auto Research最后一块拼图,Frontier-Eng Bench登场,在工程闭环里死磕最优 (opens in a new tab)
科研,能被 AI 全程加速吗? 过去两年,Auto Research 被寄予厚望:读论文、找方向、写代码、跑实验,甚至生成新假设 ——AI 仿佛要成为科研全能助手。 但做过科研的人都知道,真正烧脑、耗时间的不是「能跑」,而是「够好」:调参数、改代码、看输出,再跑,再调…… 每一次优化都琐碎又重复,却几乎无法跳过。 于是问题来了:能不能把这些繁琐的迭代交给 AI?Researcher 只提供方向,后续的「看反馈 → 调代码 → 逼近最优」,全交给 Agent 自动完成? Einsia AI 旗下 Navers Lab 的最新论文 Frontier-Eng 盯上的就是这件事。 论文题目:Front
Frontier3DBench 测量智能体制作 3D 物体、场景与开放世界的能力 (opens in a new tab)
Einsia AI 用 Blender 和 Unreal Engine 中的 145 项任务比较 11 种模型与工具组合。评测发现连续移动、避障和状态管理比局部交互更容易失分。
深度|Einsia AI发布 LaPlace's Eye:在未来尚未命名时,看见新的可能 (opens in a new tab)
从软件迁移、浏览器操作,到仿真中的机器人任务,再到市场数据...翻看Einsia AI已经公开的研究项目,会发现他们的研究从不只围绕一个模型或一个行业展开,他们似乎热衷于不断把模型放进新的环境里,观察它能不能完成任务、能不能从结果中积累经验。