独家|LiberAI跨越GPT-6斩杀线空降Robodojo榜一,再获数亿元Pre-A++轮融资
Z Potentials独家获悉,LiberAI完成新一轮数亿元Pre-A++轮融资,投资方包括中关村科学城、达晨财智、高信资本、华映资本等。5个月内,LiberAI已获得红杉中国、真格基金、美团龙珠、顺为资本等顶级机构的连续押注,累计融资超十亿。
Z Potentials独家获悉,LiberAI完成新一轮数亿元Pre-A++轮融资,投资方包括中关村科学城、达晨财智、高信资本、华映资本等。5个月内,LiberAI已获得红杉中国、真格基金、美团龙珠、顺为资本等顶级机构的连续押注,累计融资超十亿。
这笔融资发生在Physical AI热度高涨的节点上。就在昨天,GPT-6 Astra屠榜Robodojo,其在机器人上的亮眼表现火遍硅谷、国内。整个行业重新开始思考一个问题:通用大模型,是否正在重新定义物理智能?
今天,LiberAI公布Liber-0 Preview模型,完整版Liber-0将于后续正式发布。
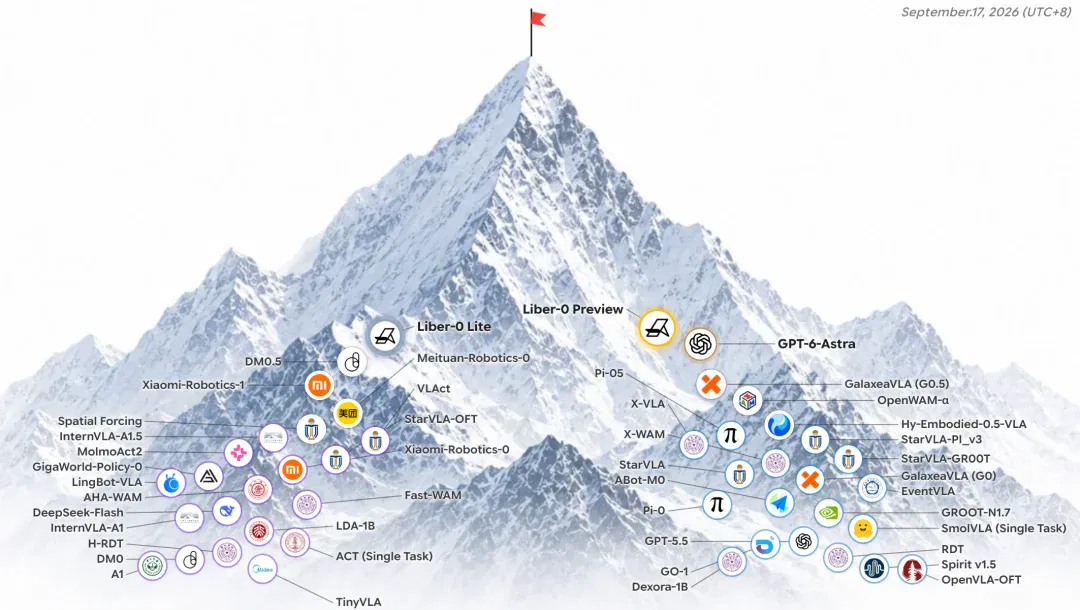
在RoboDojo最新官方评测中,Liber-0 Preview位列第一,GPT-6 Astra位列第三。Liber-0 Preview是首个登顶“具身珠峰”的世界模型。截至发布时,也是榜单中唯一打败GPT-6 Astra的模型。
与此同时,Liber-0 Preview在真实机器人上完成了一组长时序、高自由度灵巧手操作任务,展示出全球第一梯队的灵巧操作能力。
LiberAI跨越性的全面领先,背后蕴藏着怎样的技术路线?在LiberAI看来,Human Experience是物理智能最庞大的数据源。关键在于:如何定义横跨数采方法、模型架构、训练策略和机器人本体的Scaling Engine,以最大化人类智能到机器智能的转化效率。
01 空降“具身珠峰”榜一,唯一超越GPT-6 Astra
RoboDojo,被誉为“具身珠峰”,是行业最具公信力的综合评测榜单之一。由港大多媒体实验室联合伯克利、清华等全球近20所顶尖学术机构共建,由第三方非营利组织独立维护。42项任务,从泛化、记忆、精细操作、长程执行到开放语义理解五大维度构建起一套全科大考,无差别考验所有参赛模型。
这座珠峰从不偏袒任何选手,榜单数据可复现、基准全开源,客观丈量基础模型真实能力上限。
此次Liber-0 Preview空降RoboDojo榜首,一举成为首个拿下榜一的世界模型。在42项全科任务测评中,模型拿到30.74的平均分、平均成功率25.52%;要知道π0.5仅拿到11.41平均分、6.91%平均成功率。
其中五大维度多点开花:长时序任务执行45.98、精细操作38.28、记忆维度 37.77、泛化能力24.99、开放语义6.68,在几乎所有维度均取得了具身模型的榜首成绩。就算比单科,科科几乎都是状元,真正的全面领先。
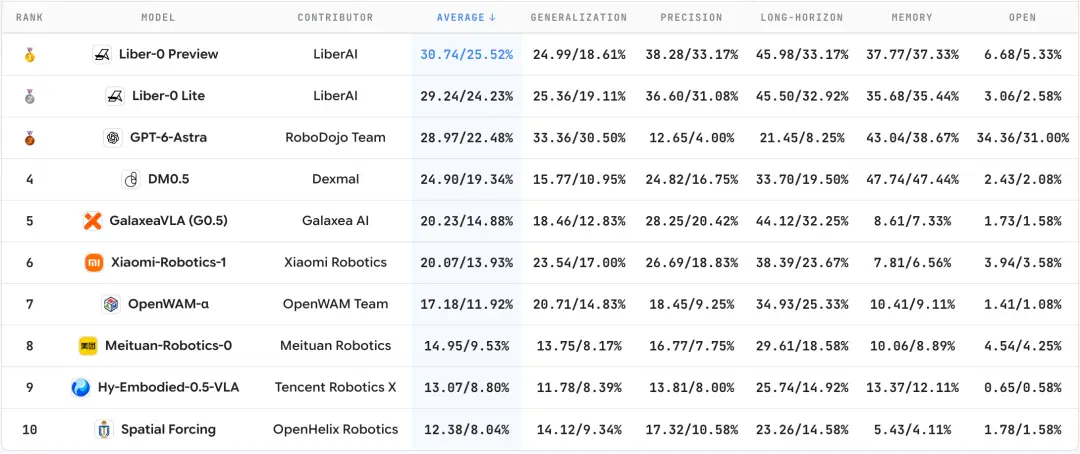
不靠单点技能突围,而是全维度实力齐头并进,充分印证世界模型基模对物理世界的理解与实操能力实现跨越式突破。这似乎预示着LiberAI这一支真正具有大模型思路的团队,正尝试让Physical AI跳出单一场景单一任务的overfit局限,围绕世界模型,定义最陡峭的Scaling Law,依托更大规模预训练,让基模对物理世界的理解、操控、泛化能力自主涌现。
值得注意的是,近日Robodojo官方同步上线了GPT-6基准“斩杀线”,是一把极具参考价值的能力标尺。绝大多数模型都没能跨过这条基准线,而Liber-0 Preview模型,是全场唯一综合性能突破GPT-6基准线的基模。
GPT-6带来了强大的高阶System2规划能力,但在负责实时物理交互的System1层面,能力边界还停留在简单的pick and place,且难以完成高精度操作。如何突破这层限制,在物理交互层面实现类人灵巧,解锁Physical AI智能上限?LiberAI给出了自己的答案。
02 第一性原理:Human-level智能=人类数据+预训练
从第一性原理出发,LiberAI对Physical AI有一个底层判断:人类水平的物理智能,根植于海量人类数据与大规模预训练。
当业内绝大多数玩家选择1个自由度的夹爪作为末端执行器,LiberAI从day0即押注算法难度高一到两个数量级的高自由度灵巧手路线,走“难而第一性正确”的路径。
人类灵巧操作数据天然产生于日常生活之中,夹爪数据再多,也无法和人类视频完成对齐;且从夹爪泛化到灵巧手很难,难以实现终局的human-level智能。而LiberAI在Robodojo榜一的成绩也侧面验证了,可部署于灵巧手的模型迁移到夹爪很容易,甚至可能是“降维打击”。
模型驱动高自由度灵巧手丝滑流畅完成一整套拟人长程任务,至今仍是行业里一道极难突破的难题。海外玩家中Genesis在该方向持续深耕,国内赛道中,LiberAI属于少有实现突破的玩家。
以一套brunch任务为例,任务包含30多项灵巧子任务,鸡蛋、面包、火腿、蔬菜都属于形态不规则物体或易形变的柔性物体,同步还需要操控刷子、搅拌棒、胡椒研磨器等多款小巧精密、难以稳定抓握的厨具,实现抓、拿、搅、捏、倒等拟人操作,唯有灵巧手才能完成这类拟人化的工具操控与任务闭环,任务本身挑战难度极高。
而一项有意思的发现是:随着人类数据预训练规模不断放大,模型自主涌现出纠错、重试的能力。一旦工具抓握位置不准确、操作略微失误,模型不会直接卡死终止,而是自主重试、动态修正,持续推进直至完成完整任务闭环。
随着人类数据预训练的泛化Scaling,LiberAI模型在仅用少量数据后训练的情况下,可以学习掌握插吸管、打扫垃圾、拧瓶盖、整理眼镜等高度拟人的精细化灵巧操作。
这也给我们带来新的思考:在开放物理世界的大多复杂任务中,我们或许不必一定执着于把每一个独立子任务打磨到99.99%的单点成功率。真正支撑长链条复杂任务落地的,是模型随预训练Scaling自主涌现出的纠错retry能力和泛化能力,从而保障长程复杂任务最终闭环。
03 Scaling Engine是一套全栈、全链路的系统工程
LiberAI认为,Scaling是一门科学,不是盲目烧钱和堆数据量,而要讲方法、讲效率、讲最优。数采方法、模型架构、训练策略的整个链路构成了Scaling Engine。而这个Engine最终决定了整体Scaling的ROI。
虽然Human Experience是最大的数据源,但对机器人来说并不是开箱即用。
因为人类和机器人之间天然存在Embodiment Gap:
- Vision Gap:人类与机器人的外观不同。人类与机器人观测世界方式也不同。
- Action Grounding:大量人类数据仅有纯视频,缺少人类和世界交互的物理数据。
- Morphology Gap:人类与机器人的自由度、尺寸、运动学特性存在巨大差异。甚至不同人之间也存在不可忽视的差异。
这些Gap能被解决得多好,直接影响了人类智能到机器智能的转化效率(Human-to-Robot Transfer Efficiency),进而影响到Scaling的效率。
LiberAI提出要把Embodiment当成一个scaling axis去scale up,见过的本体越多,Liber-0的跨本体泛化性越好。在模型架构上,LiberAI将Embodiment信息作为context输入模型,让模型进行Embodiment In-Context Learning。模型学习的不是绑定某个本体的策略,而是根据不同本体的context采取对应动作的“元策略”。
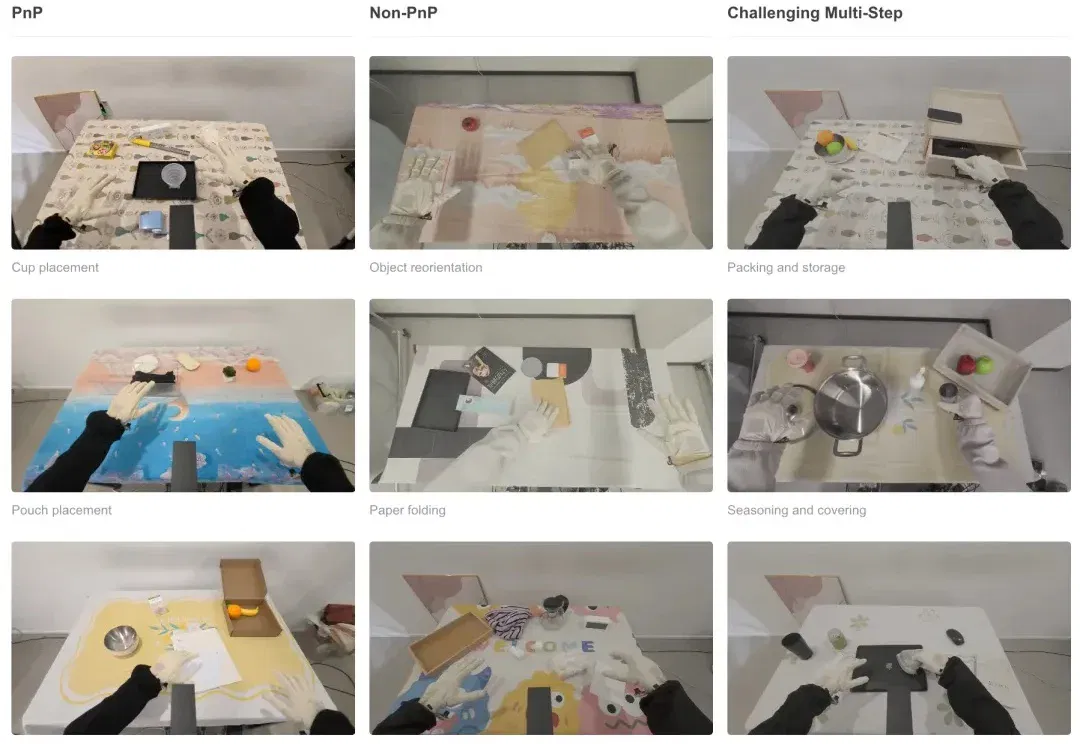
数采方法上,LiberAI自研数采手套,轻薄、无感,能以mm级精度捕捉人类手部动作,补全人类action的“最后一毫米”,已经启动in-the-wild规模化采集;在训练策略上,LiberAI持续押注多模态对齐。
此番LiberAI世界模型登顶RoboDojo,也进一步验证了其在长时序、高自由度灵巧操作任务上的技术能力。随着Physical AI从单点任务逐步走向规模化预训练与通用泛化,世界模型正在成为机器人基础模型竞争中的关键变量。对于LiberAI 而言,或者接下来需要验证的是,这套能力能否进一步走向真实场景,形成可持续的产品与商业化闭环。
文章来自于"Z Potentials",作者 "Z Potentials"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
LiberAI's Liu Songming on connecting models, hardware and data for physical AI (opens in a new tab)
LatePost interviews LiberAI founder Liu Songming about Liber-0, glove-based data collection, robot hardware, full-stack integration and commercial use cases. The 2.2 million data hours and test results are team claims; a flagship application remains a goal.
Liber-0 发布:团队报告220万小时预训练数据与零样本机器人测试 (opens in a new tab)
LiberAI介绍Liber-0及人类视频、动作手套和本体表征的训练路线。公司报告60项无目标任务机器人示范的测试中整体成功率36%、长程组10.5%;奶茶制作则经过少量后训练,两类演示不能混为完全零样本能力。
LiberAI完成亿元融资,清华00后特奖入局世界模型 (opens in a new tab)
LiberAI已于近期连续完成种子轮、天使轮及天使+轮融资,累计金额数亿元人民币,投资方包括真格基金、红杉中国、美团龙珠、顺为资本等一线机构。公司成立于2025年12月,CEO刘松铭是清华特等奖学金获得者,师从清华大学朱军教授,在ICML、NeurIPS等顶会发表多篇一作论文。
从RDT-1B到Liber-0,两年间,基模走了多远? (opens in a new tab)
从 RDT-1B 到 Liber-0,文章比较了具身基座的数据来源、操作本体与训练路线。Liber-0 的 60 项真机测试、手套数据对照和示范者多样性实验展示了部分迁移能力,也显示长程任务仍较难。

姜宇辉的AI分身:知识助手与“另一个自己”之间 (opens in a new tab)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。