人人都能整个“自己的DeepSeek Harness”,那我们为啥还在给Claude Code们充会员?
“你如果不能在几个小时内重建 Cursor,下次面试会非常艰难——那不过是 300 行代码的一个 while 循环。”
“你如果不能在几个小时内重建 Cursor,下次面试会非常艰难——那不过是 300 行代码的一个 while 循环。”
Ralph Loop 创造者 Geoffrey Huntley 把软件工程师的底线划在 300 行。看似离谱,但大家发现,他可能是对的。
过去一年,Claude Code、Codex、Antigravity 等大厂产品底层路径越来越相似:Agent Loop 读写上下文、调用工具、反复执行,用测试和权限兜底。上下文、工具、Loop、记忆和多 Agent,逐渐成为一套公开的标准牌面。
大厂之外,个人 Harness 项目也在疯狂涌现。
如今已经拥有庞大社区的 Pi 和 Aider,也都是从个人项目起步:Pi 由 41 岁的奥地利软件工程师 Mario Zechner 独立开发,Aider 由约 54 岁的加拿大软件工程师 Paul Gauthier 一人发起。面向 DeepSeek 优化的 Reasonix,则由游戏引擎开发者 YHH 个人发起,随后迅速发展成拥有数万 Star 的社区项目。
DeepSeek 宣布招募 Harness 内测后,评论区很快变成了一场“个人 Harness 展销会”。社区整理了帖子下的上千条回复,其中有数百个开源仓库,覆盖 Coding Agent、记忆、Skills、评测和安全等方向。几乎每个人都带着自己搭建的 Harness 前来自荐。
世界就是这么奇妙:几个月前大家的差异还在“AI 辅助开发者生产力提升 2 倍还是 100 倍”,现在的差异已经变成“能不能写一套自己的 Harness”。
但当模型可以替换、Harness 可以复刻、常见组件已经趋同,连个人开发者都能拼出一套可用系统时,Coding Agent 还能靠什么打出差距?为此,我们采访了 TiDB 唐刘、腾讯研究院茹炳晟、Floatboat Harness 架构师 Remy,以及字节 Trae 天猪。
追模型不如搭 Harness?
今年,多位知名 Coding 工具创始人都开始谈论一个话题:日常编程任务上,模型已经拉不开差距了。
Amp 联合创始人 Thorsten Ball 说:“模型已经死了。”近距离管理单个模型的行为,回报已经越来越低。我们不需要再不断调整、试验不同模型——它们最终都会发展到“按下按钮,就能得到一个 John Carmack”的水平。
OpenCode 联合创始人 Dax Raad 的感受类似:模型公司在可用性方面找到了某种完美区域,用过更新的模型,再回头看这一代,会觉得它们彼此都差不多,“用哪个都一样”。
Pi 创始人 Mario Zechner 认为如今模型不仅到顶峰了,新版本能力甚至还会倒退。能力越强,厂商越难保证旧能力不退化——真实世界的用例太多,评测根本覆盖不完。所以模型厂商会选择推自家 Harness,因为 Harness 是唯一能控制的部分,至少能把变化锁住。
几个月前,有国内 Coding 工具专家对 InfoQ 说过一句话:“(国产)模型不行,就只能靠工具补。模型负责决策,真正的编码、调试和重构,交给 Harness 里的工具完成。”
但现在情况变了。模型已经能应付大多数日常工作的复杂度。当日常任务根本触及不到模型的能力上限时,谁的上限更高,也就没有之前那么重要了。
既然模型拉不开差距,竞争就进入 Harness 层。
Harness 也在趋同,但趋同不是终点
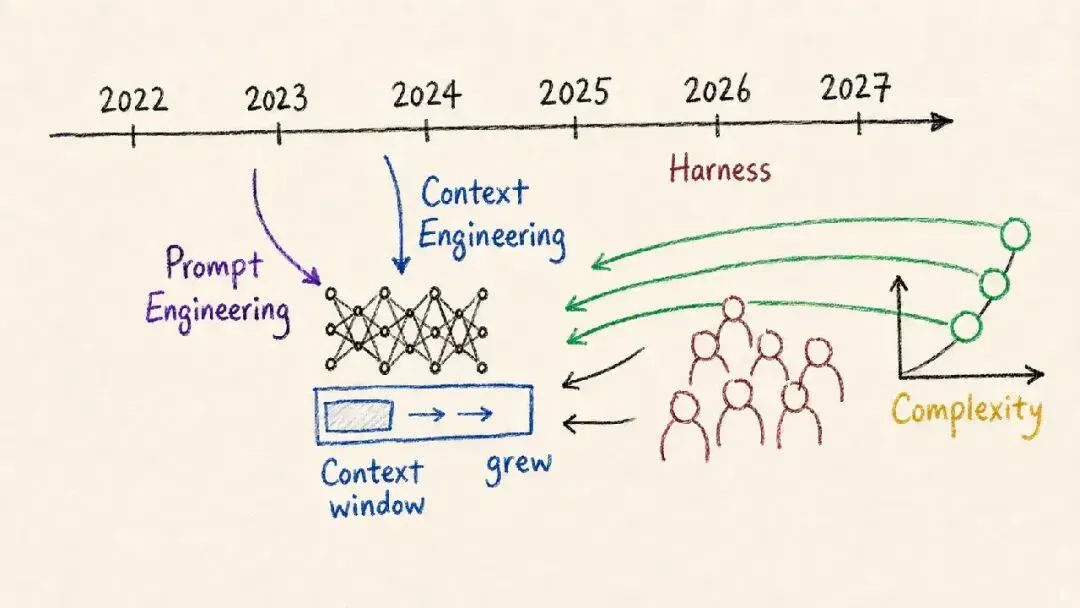
Harness 不是新东西。早在 2022 年 ChatGPT 刚问世时,4000 Token 的上下文窗口逼着开发者用工具调用、MCP、RAG 来管理上下文——Cursor、Windsurf、Cline、Aider 都是那个时期的产物。后来上下文窗口大了,任务也长了,Agent 跑几个小时就开始压缩总结、遗漏关键信息。有人引入 Sub-agent,有人搞 Agent Swarm,本质上都在做同一件事:为底层模型搭一个更好的运行环境。
“Harness”这个说法在 2026 年初广泛流行起来,但不过半年,大家的发展方向已经趋于一致。
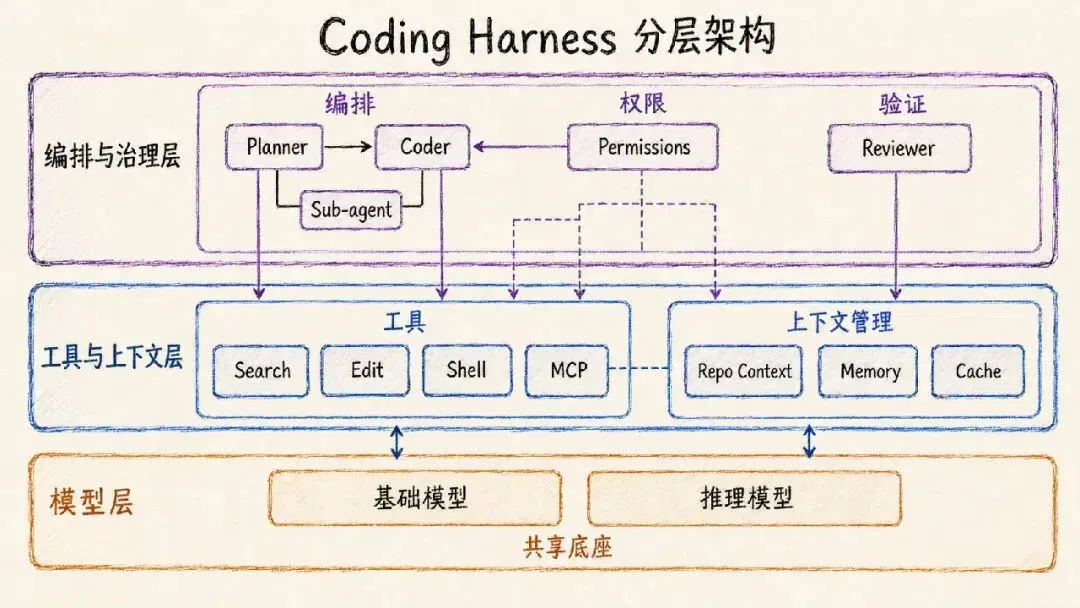
最内层的 Agent Loop ,负责模型循环、文件读写、上下文管理和安全控制,可以只有约 200 行代码。Amp 联合创始人 Thorsten Ball 则用 315 行 Go 代码 从零写出了一个能够在终端读取、搜索和编辑文件的 Coding Agent。
虽然核心只有几百行代码,但一套完整的 Harness 仍要向外叠加大量组件。Planner、Coder、Reviewer、Search、Edit、Shell、Sub-agent、MCP——TiDB 团队唐刘列了一串名字,然后说:“这些东西慢慢都会变成标准部件。”
他拿数据库打了个比方:MySQL、TiDB、PostgreSQL、Snowflake 都有 SQL,都有 Optimizer,都有 Storage Engine,但没有人会觉得它们一样。真正的差距从来不在“有没有这个组件”,而在于这些组件怎么组成一个真正能解决问题的系统。
具体怎么做,TiDB 团队有自己的答案。他们的新产品 TiDB Cloud Filesystem。项目本身是一次探索——团队边推进边迭代,在与 AI 的协作过程中,同步打磨出了一套 Harness。它不是提前设计好的,而是在项目不断遇到瓶颈、定位问题、调整执行方式的过程中,被一步步“逼”出来的。这套 Harness 的成形甚至早于 Claude Code 动态 Workflow 的发布。
他们没有从零写最内层的 Agent Loop,主要基于开源项目 Pi。但任务编排、权限、持久状态、Sandbox、失败恢复,是自己动手做的。设计哲学是一句话:薄 Agent Loop,厚 Control Plane。
为什么不自己写 Loop?因为 Agent Loop 是变化最快、也最容易同质化的一层。模型协议、Tool Calling、Streaming、Reasoning 一直在变,LLM 公司和云厂商迟早会把它做得越来越好。“我们没有必要在这里内卷。站在巨人的肩膀上就可以了。”
真正需要自己动手的,是数据库团队过去二十年一直在解决的问题:状态怎么持久化,权限怎么收口,副作用怎么控制,失败以后怎么恢复,一个结果到底怎么证明是真的,出问题以后怎么审计和复盘。
这样设计的主要好处是一旦换模型、换 Agent Core 不用推倒重来。他们最开始用 OpenCode,后来换成 Pi,但不管上面的 Agent 怎么换,下面的 Sandbox、权限、状态和控制面都不需要跟着重写。模型能力越强,越可以放宽 Sandbox 里的探索空间,但完全没有必要同时放宽对真实生产系统的副作用边界。
这很像数据库。SQL、Optimizer 这些组件可以越来越聪明,但 Transaction、Privilege、Durability 这些边界不能因为“上层更聪明”就消失。Agent Framework 可以不断变化,但状态、权限和副作用的边界必须稳定。
这套 Harness 最终支撑 TiDB Cloud Filesystem 在三个月内完成开发并上线。跨 Session、Sandbox 和 Executor 的持久 Workspace,版本、分支、Checkpoint、Rollback、权限、配额与多租户隔离——全部由 Agent 完成,人类没有写一行代码,也没有审一行 PR。上线后,已经承载超过数百万个 Agent Workspace。
差距藏在这些看不见的地方
LangChain 联合创始人 Harrison Chase 也看到了同样的趋势,只是多了一层判断:收敛是收敛了,但它会收成一个连续的光谱。
他的观察是,通用 Harness 已经足够胜任很多基础任务——让 Agent 访问文件系统、调用子 Agent,对多数场景够用了。但任务越不常规,越需要定制 Harness,所以光谱的一端是现成的通用产品,另一端是完整的定制认知架构,中间还有无数通过 Hook 或中间件实现定制的状态。促使人们走向定制端的,往往不是性能,而是可预测性和控制力,比如金融行业——客户宁愿牺牲一点智能,也要换回可控性。
而另一端的定制认知架构,说白了就是把领域知识、专业工具和专家流程一起塞进 Harness——这在垂直领域尤其关键。
具体到 Coding Agent,腾讯研究院茹炳晟认为,知识工程决定了它的能力高低。
绝大多数 AI 编程工作不是从 0 到 1 开发新项目,而是在现有代码上增加功能或修复 Bug。所以 Coding Harness 的核心能力,是先理解现有系统,再按照软件工程的方法判断应该在哪里做什么修改,并通过快速试错和验证形成闭环。
他把一套好的 Harness 需要做到的事情拆成三层。
第一层:理解存量系统。很多项目的代码本身比较杂乱,光读代码不够,最好能把原始需求、系统设计和代码结合起来,理解原有功能、业务逻辑以及具体实现,Agent 才能理解“这个东西为什么长这样”,才有针对性地做出推断。
这牵涉到大量 Harness 的工作:知识怎么接进来,代码和设计怎么映射,大型项目不可能把全部代码一次性塞进上下文,怎么做顶层建模、做 Code Graph 机制,在需要时定位相关模块,再在模块内部通过 grep 等方式找到更细的代码片段。这些都需要由 Harness 处理。
第二层是项目约束与推理。模型本身需要具备软件工程能力,同时还必须了解具体项目和代码仓的约束。Harness 要让这些规则对模型可见,确保它在执行过程中遵守规则,并在完成后检查规则是否真正得到落实。
但光在 Prompt 里写“遵守规则”不够——生成规则有了,还得有检查规则和反思机制。对生成结果做反思,而且反思可能不止一轮。多轮反思的结果合并,再去做迭代,直到满足项目约束。
第三层:确定性验证。代码生成只是起点,Agent 说“我修好了”没有意义,你得用外部不变量证明它是正确的。因此 Coding Harness 要与持续集成体系打通,覆盖测试生成、测试执行、结果分析和错误反馈,再根据运行结果修正代码。要做到这一点,Harness 还需要具备单元测试环境、容器化测试环境、编译运行、结果分析和结果展示等能力。
代码生成之后,如何编译、运行、拉起环境并判断结果,都可以通过确定性的工程手段完成。而这些工程能力,应该成为 Coding Harness 不可缺少的部分。
多 Agent 编排:听着高大上,实际是“分布式内耗”
Boris Cherny 最常挂在嘴边的事,就是吹他那套多 Agent 能力——几千个 Agent 同时跑,忙的时候直接上万。Claude Code 顺势把这种玩法产品化了:Dynamic Workflows,用户给个目标,Claude 自己拆任务、调度几百个子 Agent 去搜索、编码、验证、汇总。
2026 年被称为“Agent 编排之年”。Boris 大概是最卖力证明这个说法的人。
这套剧本十年前演过一次。2016 年也叫“编排之年”,主角是容器。Docker 把应用标准化了,大家发现跑一个容器不难,难的是管几千个。于是 Kubernetes、Swarm、Mesos 打成一团,最后赢的是控制平面。十年后,Agent 在走同样的路。
这个位置上现在已经挤满了人。大模型厂商、云厂商、企业软件巨头、开源框架、治理层平台——全都扎进来了。每家都有自己的编排方案,每套方案都想成为那个“管理 Agent 的 控制层”。
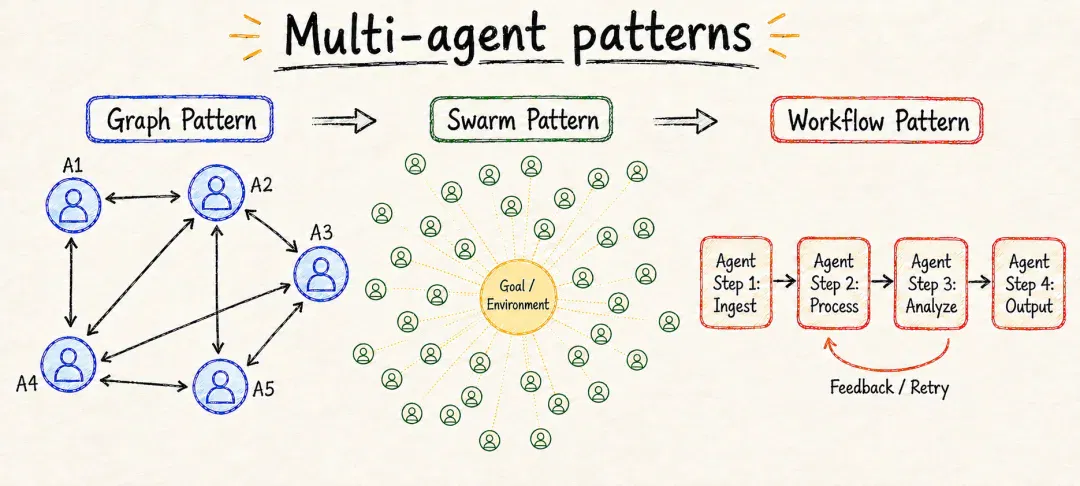
其实这个判断并不新鲜。早在 2025 年,《Vibe Coding》作者、前 Google 和 Amazon 工程师 Steve Yegge 就去找过 Anthropic 的高层,告诉他们应该做一个“Agent 的 Kubernetes”——Claude Code 只是一个构件,真正的战场在上面的编排层。没人理他。于是他 8 月自己动手了,后来做出了 Gas Town。按照 Yegge 的说法,Gas Town 可以让一个人持续管理 20 到 30 个 并发 Coding Agent(本地单机)。
现在,所有玩家都在抢同一个入口。但这个位置真的会像 Kubernetes 一样,成为一个独立而统一的平台吗?还是说,整个行业正在一窝蜂地冲进一条被过度炒作的死胡同?
TiDB 团队唐刘有一个判断,听起来像个暴论,但越琢磨越有道理:Agent 编排的未来,可能是越来越少的编排。
一两年前,让 Agent 做一个复杂任务,得手把手教它:第一步干什么、第二步干什么、Planner 怎么工作、Coder 怎么工作、Reviewer 怎么工作,写一大堆 Prompt 把协作流程塞进去。现在呢?很多时候只需要告诉 Agent“我要这个结果”,它自己就能完成大量内部规划,把活干了。
所以模型越强,一部分显式编排就一定会消失。这很像数据库的演进——早期得告诉数据库“怎么 Join、从哪张表开始”,后来 Optimizer 越来越强,人只管说“我要什么”,怎么执行数据库自己定。Agent 也会走这条路:从命令式的编排,走向声明式的目标。
做分布式系统这么多年,唐刘对一件事越来越敬畏:Communication is complexity(通信即复杂度)。
十个组件频繁通信的系统,大概率难 Debug、性能也不会特别好。Agent 也一样。如果要完成一个任务,Agent A 问 B,B 问 C,C 改完通知 A 和 D,大家不停同步状态——这个系统在设计上可能已经出问题了。
所以 TiDB 在多 Agent 上反而很克制,甚至有点反潮流。他们更信 Unix Philosophy:一个 Agent 做好一件事,Agent 之间靠清晰的 Input/Output 解耦,尽量减少高频聊天。上层可以有一个 Agent 或 Workflow 分配任务、汇总结果,但整体拓扑要尽量简单。
“复杂性永远有成本。不要因为我们‘可以’做一个复杂系统,就一定要做复杂系统。我不觉得未来一定是一百个 Agent 在 Slack 群里开会的软件公司。” 唐刘说。 “真正好的多 Agent 系统,反而可能看起来非常安静。每个 Agent 都在自己的边界里面完成工作,最后通过明确的状态和结果来协作。”
茹炳晟对此也十分赞同。他认为多 Agent 不是默认选项,是单 Agent 搞不定了才用的补充方案。
行业里常见的一种说法,是把多 Agent 编排归纳为顺序、并行、路由等十来种固定模式。但在茹炳晟看来,这些分类大多只描述了 Agent 如何连接和执行,还算不上真正的智能体设计模式。
茹炳晟是 Agent Design Patterns Society(ADPS)的创始人之一,在 ADPS 的体系下,智能体设计模式被拆成两个维度:一个是认知能力,包括感知、记忆、推理、行动、反思、协作和治理;另一个是执行拓扑,包括链式、路由、并行、循环、层级和编排。两者拼成一个二维矩阵,每个交点都可能形成一种具体的设计模式。比如,并行拓扑与推理、行动等能力结合,可以衍生出并行推理、并行执行、扇出聚合等不同模式。
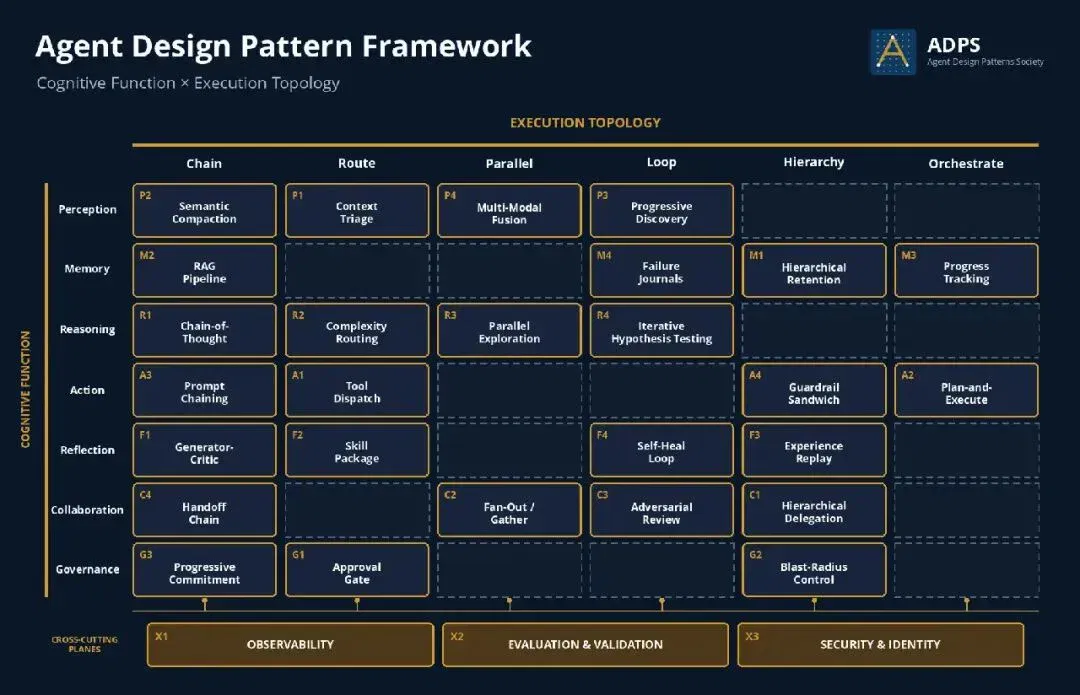
因此,基础拓扑的数量确实有限,具体的设计模式却远不止十来种。更关键的是,这些模式并不天然属于多 Agent:有些必须依靠多个 Agent 协作,有些在单 Agent 内部就能完成。
但无论选哪种模式,都有一个原则:只要单 Agent 能搞定,就不要引入多 Agent。因为复杂度不会消失,只会转移。从单体架构拆成微服务,服务之间的通信和状态管理成了新难题;从单 Agent 拆成多 Agent,协作、状态同步、结果汇总、系统治理全是新坑。很多人觉得多 Agent 能降低系统复杂度,其实是把问题从一个地方挪到了另一个地方。
那么,什么时候值得付出这笔复杂度成本?目前最明确的场景主要有两个。
一个是缓解上下文压力。单 Agent 扛全链路任务,上下文窗口很快会被耗尽。把子任务拆给子 Agent,主 Agent 只接收子 Agent 完成后的结果,这是最典型也最务实的用法。
另一个是交叉验证和发散探索。一个模型完成任务后,另一个模型负责检查,两个智能体相互对话,从中产生新的想法和碰撞。
回到 Boris 的几千个 Agent 和各大厂争抢的控制平台——大家都在抢同一个入口。但这个入口真的存在吗?还是说,一场由模型厂和云厂商联手催熟的“编排热”,正在让行业集体走入一个“为了复杂而复杂”的陷阱?
长程是分水岭
如果通用 Coding Agent 的差距不在“多 Agent 编排”,那么就需要多问一个问题:一个 Agent 连续跑 50 个小时,它还知道自己到底干过什么吗?
这是通用型 Agent 框架的“终极考场”。如今,Harness 的核心模块已经高度标准化:上下文管理、任务拆解、工具调用、记忆整合——各家方案大同小异。正如茹炳晟所说:“大的方向上,基本就这些东西了。”
架构趋同之后,拼的就是模块之间怎么配合。某个模块可以暂时领先,但长期优势一定来自整体协作。单点上的实现细节,经过几十轮执行后会累积成完全不同的结果。
所以多位从业者均认为:长程稳定性,会是下一代 Agent 产品的核心分水岭。
很多 Agent 前十几步表现不错,四五十步就开始跑偏。但“长程”不只看步数——调用 50 次同一个稳定 API,未必比修改 7 个相互依赖的文件更长程。Floatboat 团队指出,真正决定难度的是依赖链深度、状态跨越的时间和工具数量、目标开放程度、操作可逆性,以及错误被发现之前需要经过多少轮反馈。
所以这不是“模型能不能咬牙坚持跑完”的问题。真正的问题是,一个小错误出现以后,系统能不能在它变成故障之前把它拦住。错误很少突然爆发。模型本身就有概率性,用户需求也常常是模糊的,再加上 Harness 在长链条里会把目标稀释、上下文压变形、工具调出问题,反馈又不及时。这些东西缠在一起,早期一个不起眼的偏差被写进环境,等到验证环节才发现,已经晚了。
既然问题是“错误发现得太晚”,解法就是让错误尽早暴露。
这和分布式系统的逻辑一模一样。网络会断、磁盘会坏、机器会挂,所有分布式系统都会失败。真正危险的不是失败本身,而是系统不断 Retry,把一个小故障放大成雪崩。正因如此,唐刘越来越相信一句话:重试很危险,快速失败的价值却常被低估(Retry is dangerous. Fail fast is underrated)。
但 Fail Fast 不等于放弃任务。它只是把问题的暴露时间点从“五十步之后”提前到了“十步”。Agent 在第十步犯了一个错,不等于任务失败。真正可怕的是,第十一到五十步还在错误前提上继续跑,上下文里的错误信息越攒越多,后面的 Agent 把旧错误当成事实,到最后你根本不知道从哪一步开始错的。所以 Fail Fast 必须搭配另外两个能力:限制错误传播、从最近一个可信状态恢复。
唐刘的解法是从数据库研发经验中找答案。要有 Checkpoint,要有持久状态,要能换一个 Agent、换一条路径继续干。这跟数据库设计的哲学完全一致——Transaction Log、Checkpoint、Rollback、Failover。我们不会设计一个假设“这台机器永远不会坏”的数据库,同样也不该设计一个假设“这个 Agent 永远不会犯错”的系统。
这个方向已经成为行业共识。Pi 的 Harness v2 正在做的,就是把执行状态也拉入持久化范围——操作意图、执行步骤、Tool 状态、消息队列全部落盘,进程崩溃后能根据 Operation Log 判断安全恢复点。这和数据库 WAL 的思路如出一辙:状态可以丢,但日志不能丢,丢了日志就丢了真相。
这正是数据库可靠性哲学的延伸:可靠性从来不是不失败,而是失败以后仍然能够保持系统正确。
再往前走一步:能恢复,能不能自改?可以,但必须是受控闭环——发现问题、生成改动、隔离评测、灰度发布、保留回滚。没有版本管理和可观测性,自进化只是在积累技术债。关键不在“能不能改自己”,而在如何证明改得更好、代价可控,而且随时能退回去。只有可观测、可溯源、可回滚,自进化才不是伪命题。
要做到这些,对底层技术栈的控制力是一个绕不开的前提。Floatboat 是一家面向通用工作场景的 Agent 公司,这是他们选择全栈自研的原因——这个“全栈”不止是 Harness,也包括模型层的理解和训练能力。
他们自研了 Runtime、Agent Loop、Tools、Infra 和自进化系统 FloatSail,还构建了原生文件协议、GUI-Agent 双向协议等能力。对一家创业公司来说这条路很重,但他们认为这是必要的:如果连系统内部发生了什么都不知道,长程的收敛就无从谈起。
Remy 指出,模型决定“每一步判断的上限”,Harness 决定“这些判断能否在长路径上积累成结果”。他们的逻辑也验证过了。同一个模型,任务越长、状态越复杂、验证越稀疏,Harness 拉开的差距就越大。他们测下来,长程任务上 Harness 能多贡献 23%——模型不变,差别在模型之外的那一半系统。
这种控制力也体现在他们怎么让系统自进化上。产品级的 Harness 不能让模型随便改自己,得有个受控的闭环:先发现问题,生成改动,在隔离环境里跑一遍,过了质量、成本、时延和安全这几道门槛再灰度上线,同时保留回滚的能力。并且始终保持 Human-Centric:起初是人在环中,逐渐增多人在环上的模式——大量局部优化自动完成,人主要负责目标、边界、例外和系统级治理。
编程之战结束了吗
编程只是 Harness 最早跑通的场景,但不是终点。
从 2026 年初开始,国内大厂的 AI 资源就在从编程向办公场景倾斜。据《晚点》等媒体持续追踪报道,春节后,字节高层便调整了 AI 资源分配策略,重心从消费产品转向企业服务;阿里在年初成立 ATH 事业群统一调度算力,7 月完成多条智能体产品线整合;腾讯则从 3 月开始全力押注 WorkBuddy,资源被形容为“一路绿灯”。半年左右,三家大厂相继完成了同一件事:把算力、人才和预算集中到 AI 办公这条主线上。
但这场转向不是从零开始的。腾讯的路径最有代表性:CodeBuddy 和 WorkBuddy 原本就出自同一团队,据《晚点》报道,Claude Cowork 发布后,四人团队只用一个周末便做出了 WorkBuddy。原 CodeBuddy 负责人带队转入 WorkBuddy,团队扩编,Coding Harness 的能力被完整带入办公场景。Trae Work 和 Trae IDE,阿里的 Qoder 和 Qoder Work 也是类似的一面两体,都是从 Coding Harness 泛化到 Work 场景;OpenAI 也明确表示,ChatGPT Work 与 Codex 的底层 Harness 完全共享:“用的是同一套 Harness,这套 Harness 是两款产品共享的。”
可见这已经是整个行业的共识。道理其实不复杂。Trae 团队的天猪之前聊过一个趋势:IDE 正在经历“能力原子化”,那些为人类操作设计的界面和功能,正在被拆解成一个个细粒度的 Tool,交给 Agent 按需调用。办公场景也一样——邮件、文档、日历、审批,这些人类熟悉的操作界面,一样会被拆成 Agent 可调用的接口。今年飞书开源的那套 CLI,本质就是一套 Skill + CLI,把飞书的消息、文档、日历、审批、聊天记录全部封装成 Agent 可调用的工具,所以上线后很快爆火。
因此,这两类产品现在都是共享同一套 Harness 核心,区分的是调用工具:IDE 产品操作代码仓库和终端,Work 产品进入文档、网盘和邮箱。但底层逻辑还是一样——理解目标、选择工具、执行多步任务、维护状态、验证结果。
但“相同”不意味着“完全等价”。Coding 场景的交付标准相对明确:代码能否编译、测试是否通过、类型是否正确,对错分明。通用任务则更多发生在开放世界:一封邮件是否得体、一次跨应用操作是否符合权限规范、一份研究是否抓住了重点,这些涉及情境、审美和判断。Coding Harness 主要管理技术复杂性,通用 Harness 还要管理社会复杂性(延伸阅读:自研 Runtime、Agent Loop、Infra:一家通用 Agent 公司的全栈赌注(在新窗口打开))。
两者的关键分界线,是交付标准能否在任务开始时被充分形式化。能写成测试的任务,核心是可靠执行;不能的,系统还要在执行中帮用户发现自己真正要什么。
这意味着编程 Agent 过去几年积累的能力——上下文管理、任务规划、工具调用、状态持久化、错误恢复——正在从一个垂直场景,变成一套通用的工作基础设施。
编程为这套 Harness 提供了最早的训练场和商业化验证,Work 则把它推向更大的市场。
文章来自于"InfoQ",作者 "Tina"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Claude Code desktop opens theme mods for colors and animated customization (opens in a new tab)
The article describes natural-language creation of visual mods and official theme examples, alongside comparisons with other coding tools. Support varies by version and plugin; appearance and comfort differ across people and devices.
Claude Code 用户报告账号邮箱被写入外部请求 (opens in a new tab)
用户在公开工单中提供了请求头和上下文案例。Anthropic 的发布记录提到为含账号邮箱的网络调用加入检查,报道也梳理了脚本调用的边界。
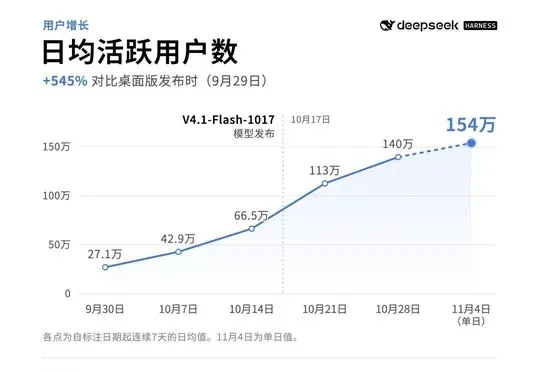
DeepSeek Harness 筹备插件市场和作者支持计划 (opens in a new tab)
DeepSeek Harness 正筹备官方插件市场,以及面向作者的 Token 支持和作品推荐。公开第三方插件约 3.5 万个,活跃用户的统计范围为使用官方 API 的用户。
阶跃星辰测试 Step Studio,用自然语言构建可真机运行的应用 (opens in a new tab)
Step Studio 的 Beta 版本面向应用、网页游戏和智能体创作,报道展示了模板、连接器与 STEPX 设备能力。真机运行、分享和上架使用各自的产品流程。
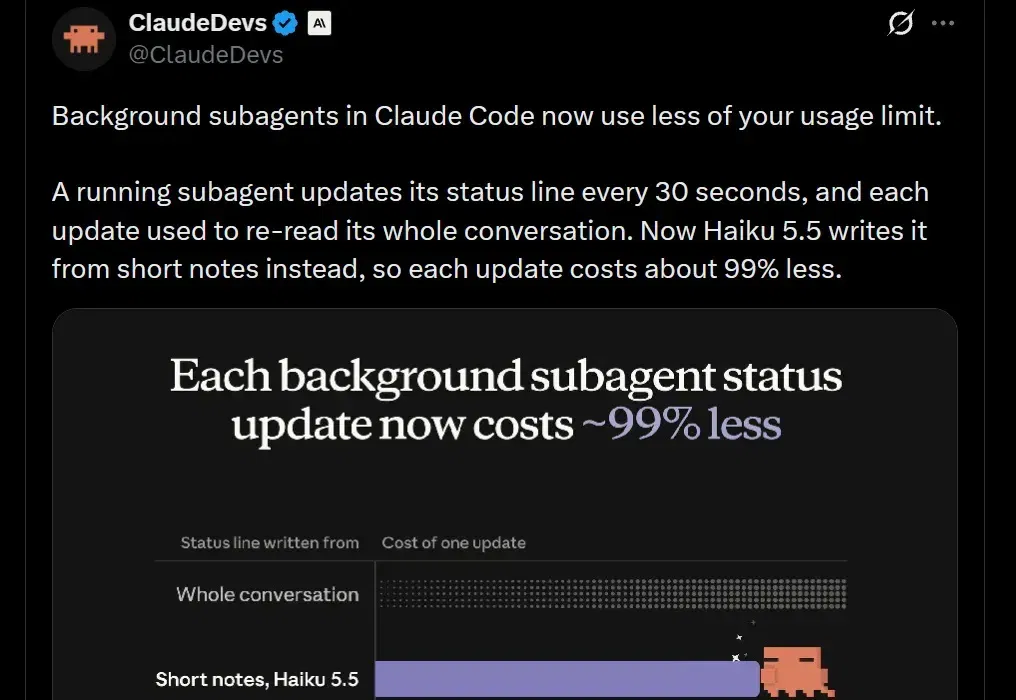
Claude Code 调整子代理状态行,单次更新成本约降 99% (opens in a new tab)
据 Claude Code 团队介绍,CLI 后台子代理的状态更新改由 Haiku 读取短笔记。单次状态行成本约降 99%,带后台子代理的整段会话额度消耗约降 5%。