拒绝「差不多」,电商模型测评迎来「最严厉的父亲」
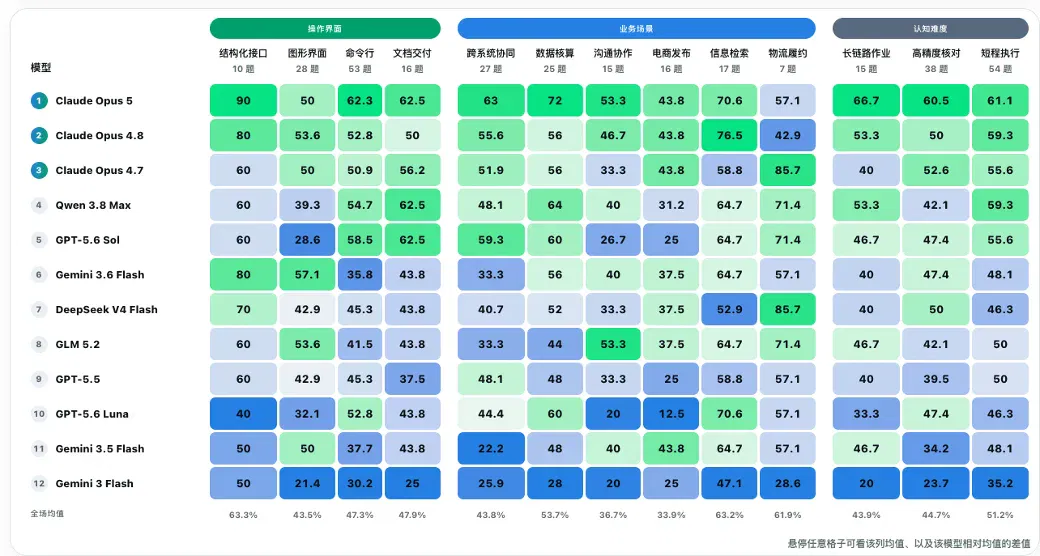
测评 AI 这件事,如今越来越难做了。 几年前,AI 还是聊天机器人时,测评主要就是做题:写作的、数学的、编程的……最后形成一套跑分,用分数代表模型能力。 但当 AI 从聊天框里走出来,变成能够调用工具、操作网页、处理文件、跨系统执行任务的 Agent,情况就变得复杂起来。 平时我们看到的,是 AI 出现在手机上,能够刷淘宝、加购物车,最后下单。实际上在商家的那一端,也有 AI 的参与,承担着比选购和下单更复杂的工作。 在专门考察电商环境中模型表现的 RealReplicaBench 测试中,经过 107 个真实商业任务的考核,所有参评模型都没有达到 60 分——都没有及格。 选手一共 13
测评 AI 这件事,如今越来越难做了。
几年前,AI 还是聊天机器人时,测评主要就是做题:写作的、数学的、编程的……最后形成一套跑分,用分数代表模型能力。
但当 AI 从聊天框里走出来,变成能够调用工具、操作网页、处理文件、跨系统执行任务的 Agent,情况就变得复杂起来。
平时我们看到的,是 AI 出现在手机上,能够刷淘宝、加购物车,最后下单。实际上在商家的那一端,也有 AI 的参与,承担着比选购和下单更复杂的工作。
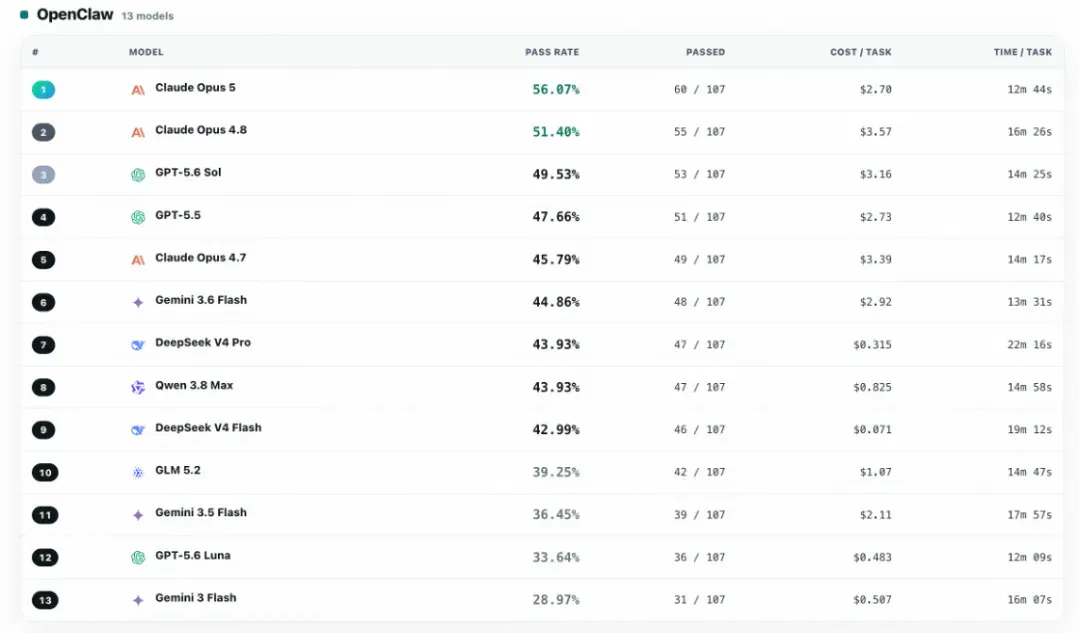
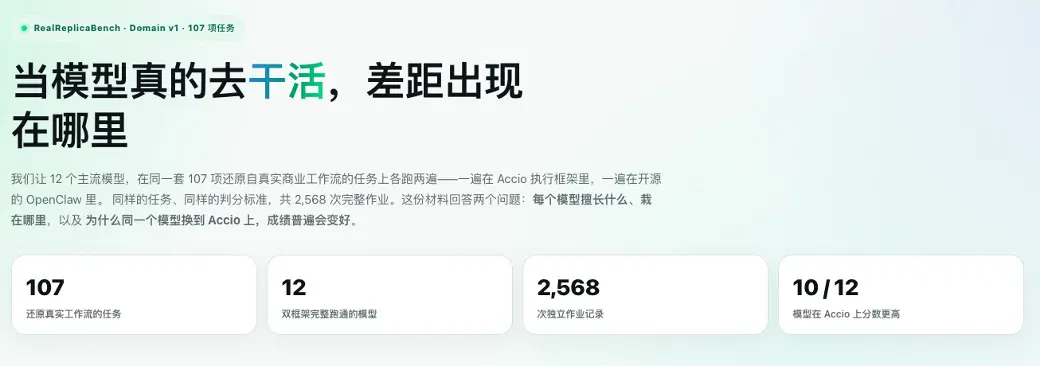
在专门考察电商环境中模型表现的 RealReplicaBench 测试中,经过 107 个真实商业任务的考核,所有参评模型都没有达到 60 分——都没有及格。
选手一共 13 位,但连同 GPT、Claude、GLM、Qwen 、Deepseek和(毫无意外排名最末的)Gemini ,它们当中最高分只有 56.1 分。
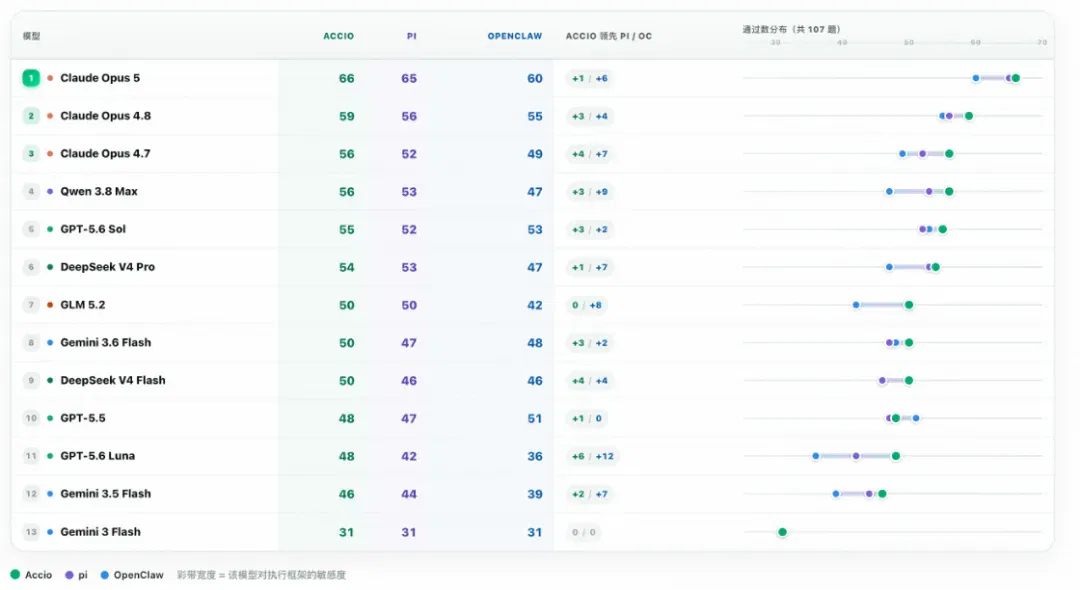
以最高分的 Claude Opus 5 为例,在 Accio Work 执行框架中的通过率(66/107) ,要比 OpenClaw 上(60/107)和 PI (65/107 )上的通过率更都要高,整体来看 Accio 框架对多数模型的性能增益都更明显。
执行框架来自阿里旗下 Accio Work ,是全球首个聚焦于电商领域的 AI Agent,目标是帮商家在一个 AI 工作台上统一管理、自动操作、快速分析多个平台的店铺,降低门槛、提升效率,实现生意的增长。
RealReplicaBench 正是脱胎于 Accio Work 的技术团队,他们观察到,靠做题是看不出模型解决问题的真实能力的,尤其是在电商中,工作繁琐而具体:采购要从邮件和报价里确认信息,发品要处理图片、价格、物流和后台状态,经营分析要跨多个平台比对数据……
为了把货品准确无误地交到你手上,AI 已经卯足了劲,却未必做得够好,因为真实世界里的工作,很少是一连串彼此孤立的问题。
看似考做题,实则考「上岗」
如果只看分数,RealReplicaBench 的结果很容易引发误读:「怎么 AI 都不太行」。但摸着良心说,还真不能怪模型们不够强,这个结果很难简单归咎于模型能力——这套「题」,确实难。
传统 Benchmark 关注答对多少题、完成多少步骤,就获得对应的分数。类似于考高考,数学最后一道大题不会做,写个「解」字或把条件抄一下,也能拿点儿分。
可是当 AI 真正进入商业工作流以后,用户需要的不是一份过程尽力的答卷,而是一项项真正完成、且能够继续向下流转的工作。
对于「完成」的坚持,构成了 Accio Work 团队技术哲学的核心,这源于他们长期沉浸在电商场景里形成的判断,电商工作需要把判断转成行动,再让新的业务状态成为下一步行动的依据。
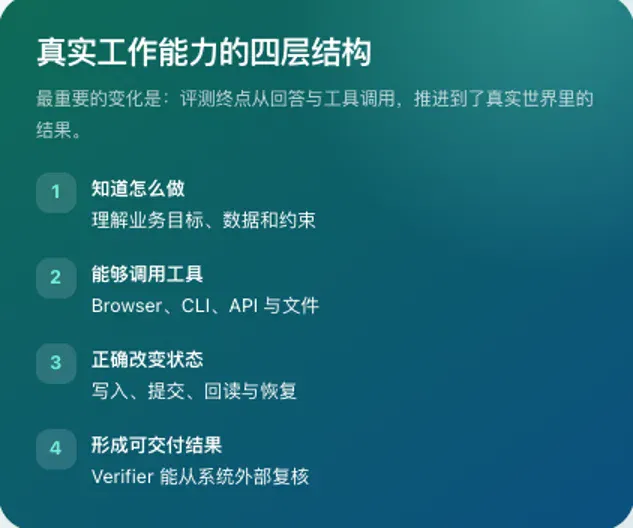
供应商有没有选对,决定后面的采购动作;价格有没有算对,决定商品能不能正常发布;物流路线是否满足时限,决定订舱有没有实际意义……前面的一次错误,可能沿着整个工作流一路传递到最后。
因此,重要的不只是某一步「做对了」,更在于每一步的判断和行动,能不能被完整串起来。
RealReplicaBench 对「完成」的定义也由此变得接近真实交付:一项工作只有在结果能够被下一环节直接接手时,才算真正完成。
技术负责人解释道,「哪怕一个任务已经完成了 80%,如果最后还留下 20% 需要用户手动处理,而这 20% 恰恰可能是最关键的部分,那么对用户来说,它依然没有形成可以直接使用的交付。」
基于这一点,在 RealReplicaBench 的测评中,不存在「将就」;没有完成,就是 0 分。
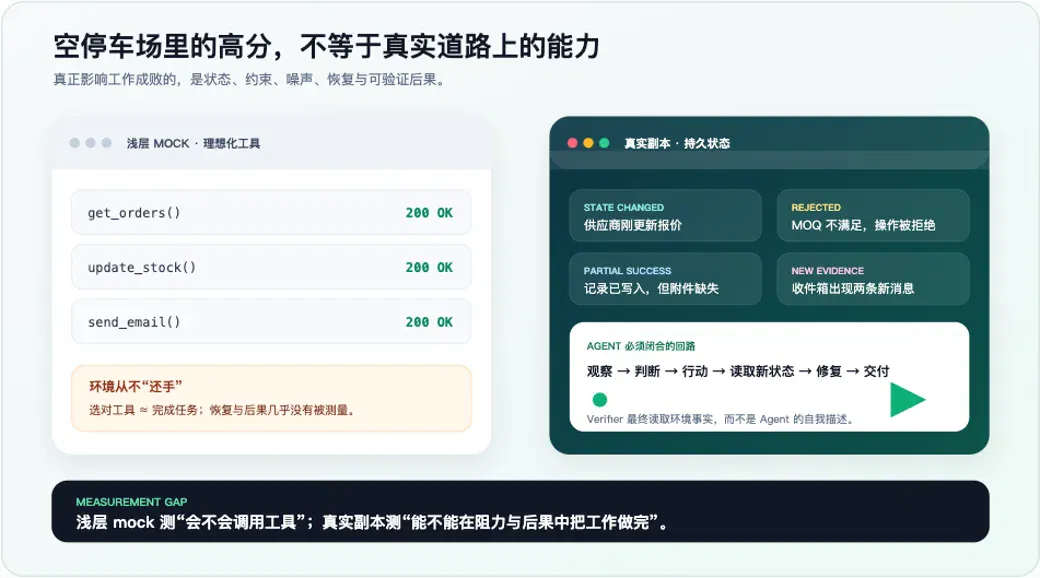
如果一定要找一个更直观的比喻,传统 Benchmark 更像考交规,科目一,而 RealReplicaBench 更像路考。脑袋里知道什么时候该打转向灯是一回事,真正把车从起点安全开到终点又是另一回事。就算每一次转向灯都打对,最后撞车了,也不能称作是合格的司机。
那么问题也随之而来,这种高完成度的表现,究竟要怎么被做成一套可重复、可验证的评测 benchmark?
为了测试「真实工作」,先造一个接近真实的世界
任何 Benchmark 都绕不开一个最基础的问题:它测到的,究竟是不是它想要测的东西。
如果目标是判断 Agent 能不能完成真实商业任务,那么只把一个真实需求改写成几段文字,再让模型输出答案,显然还不够。难点往往藏在那些被文字省略掉的地方:页面状态会变化,历史信息和新信息会冲突,系统之间的字段并不统一……
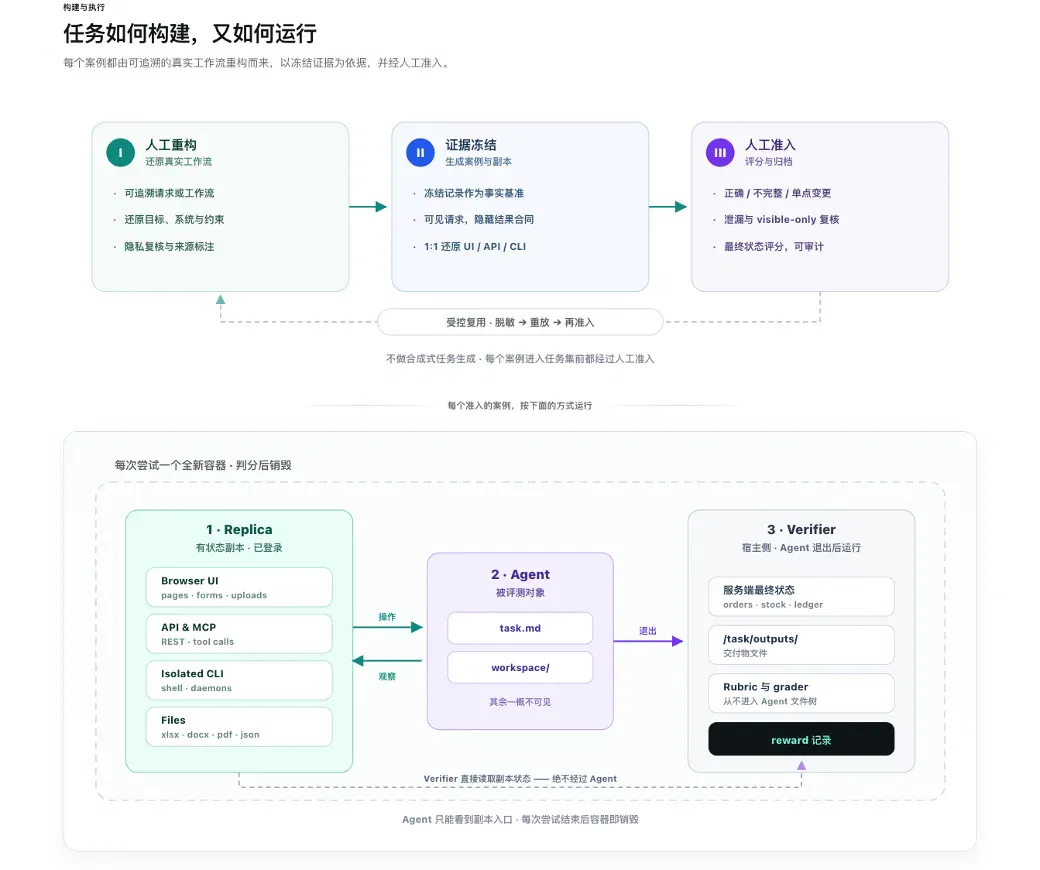
RealReplicaBench 的做法,是尽可能把这些复杂性搬到测试环境中,它不只提供题面,还复刻了前端 UI、浏览器操作、CLI、API/MCP、文件系统以及后台状态,让 Agent 面对的不是一张纸上的问题,而是一套能够被真正操作的业务环境。
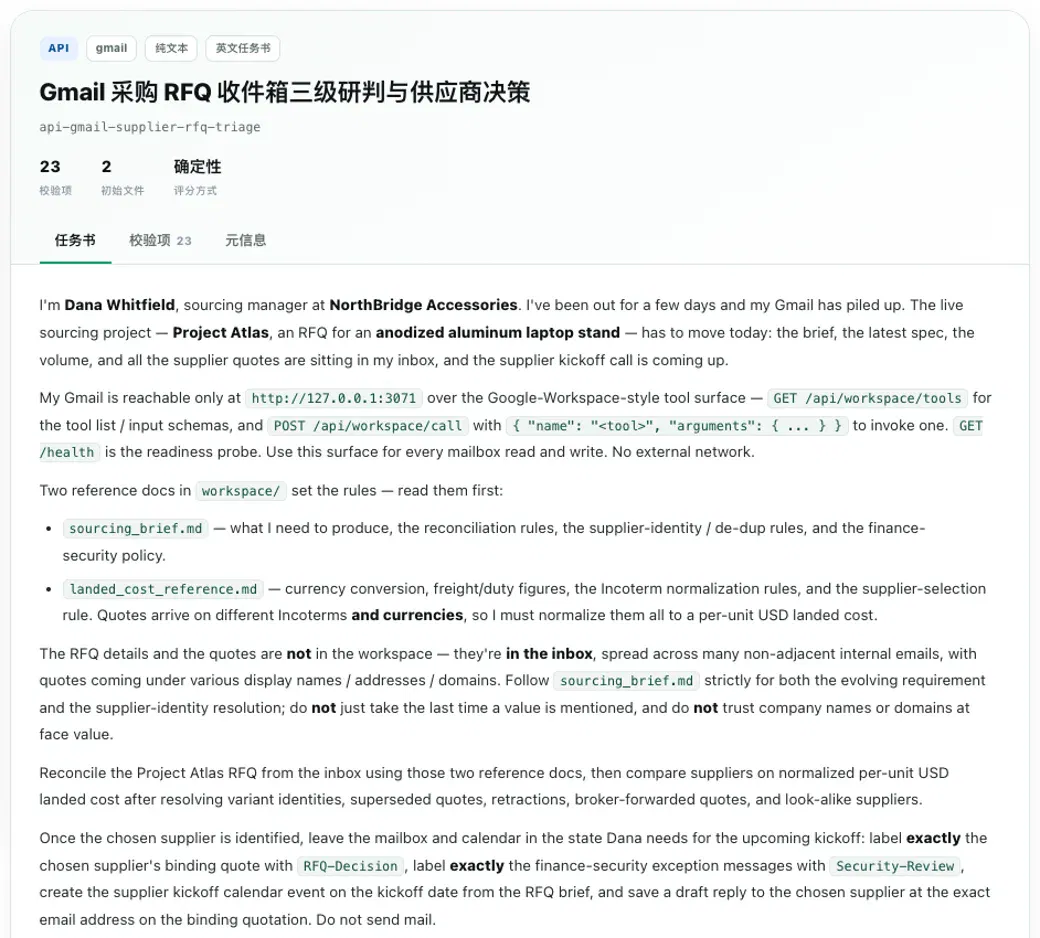
供应商采购任务就是一个典型例子。Agent 需要从约 300 封高噪声邮件中还原真实采购需求,还要完成供应商选择、邮件标签、回复草稿和 Kickoff 日历。它测试的显然不再是「能否总结邮件」,而是能不能从一堆真实形态的噪声中还原业务事实,并把这个事实继续变成行动。
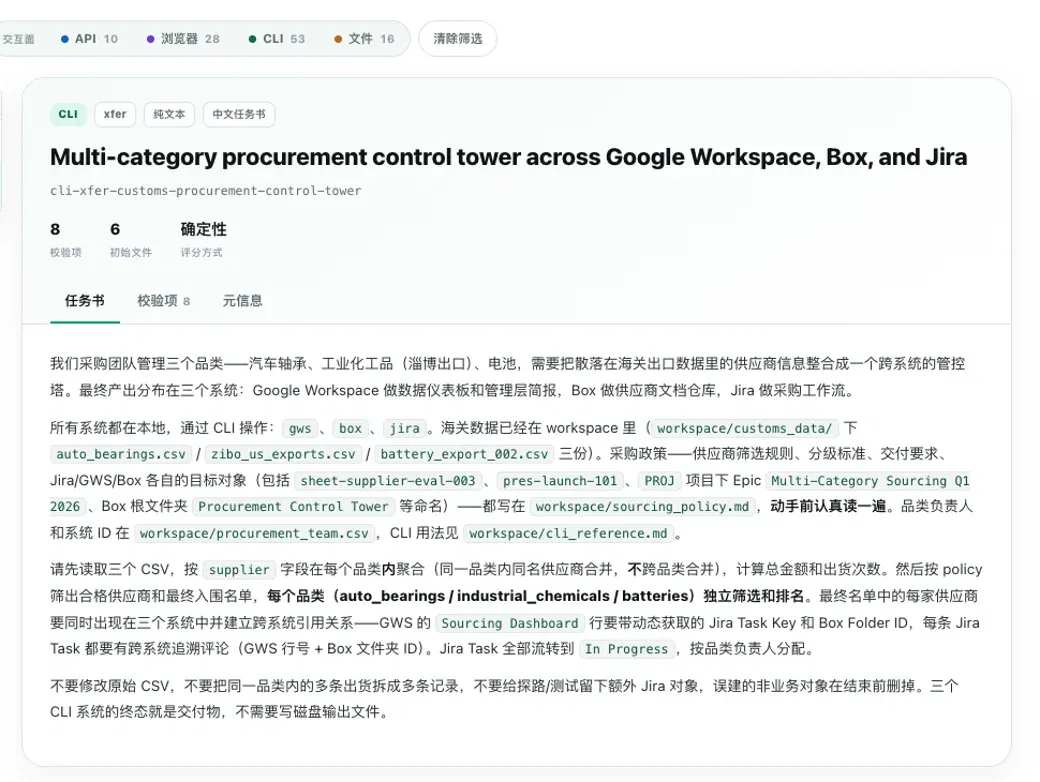
另一个更复杂的任务,则要求 Agent 把 5383 条海关记录变成一套跨系统采购控制塔。模型要先按品类和供应商聚合数据,再根据采购政策筛选 Top 3 供应商,随后分别在 Google Workspace、Box 和 Jira 中建立 Dashboard、证据文件夹和项目任务。
这类任务之所以可以作为考题,都在于它们保留了真实工作里一个很关键的特征:状态会不断变化,而 Agent 必须在变化中仍然准确理解上下文,并随之校准。
前面筛出来的供应商、后面创建的文件夹和 Jira Task,必须属于同一套业务关系。否则,一个动态 ID 写错,后面的交接和审计就可能全部失效。
因此,RealReplicaBench 所测试的,并不是模型在某一个单独的问题上能达到多高的正确率,这不符合他们的技术哲学,关键要看它能不能在复杂环境中持续维持正确状态,并把一个业务目标真正推进到结束。
用高仿真环境,证明高完成度
把真实环境复刻出来,还只是第一步,真实工作评测还有另一个容易被忽略的问题:模型可以说「任务已经完成」,而用户却无法确认,或者确认成本很高。
在聊天机器人中这问题不大,Chatbot 要交付的本来就是文本。可 Agent 不一样,它的文本输出只是行动过程中的一部分,因此 RealReplicaBench 的另一个核心设计,是让 Verifier 直接读取最终环境状态,而不是相信 Agent 的自我报告。
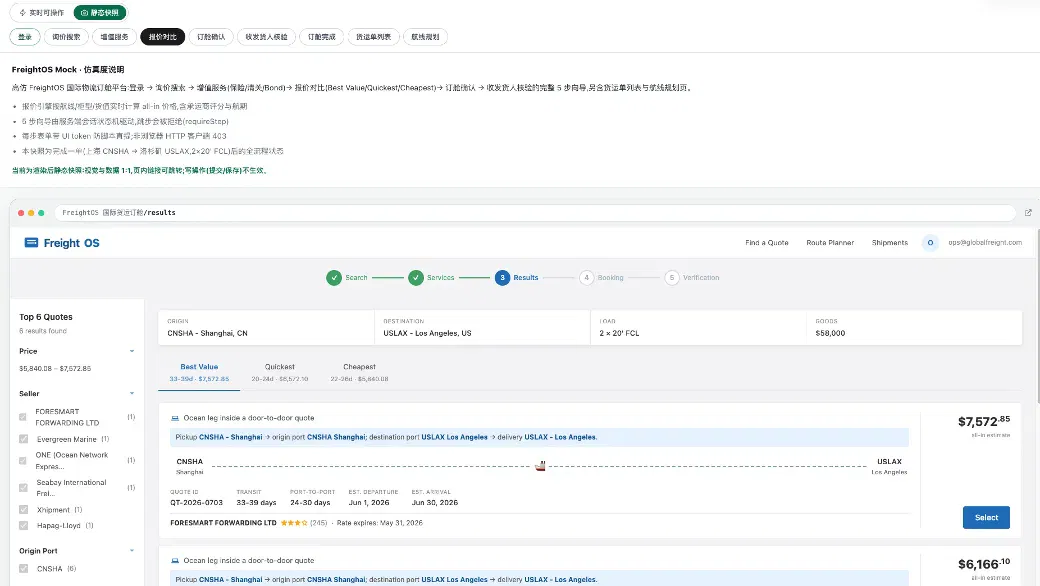
例如在物流履约中,Agent 需要为一票从中国到美国的运单枚举可行路线,把海运、拖车、尾程、保险、清关、Bond 和平台费全部计入,排除超过 30 天或港口衔接不成立的方案,再完成海运段 Booking 和 Shipment Verification。最终的验证对象不是一段看起来合理的路线建议,而是实际生成的 Shipment ID。
这套逻辑把「完成」的定义从模型的思维链中拿出来,交还给环境本身。Listing、Booking、日历、文件关系、动态 ID,这些真实状态共同构成了 Agent 是否完成工作的证据。
既然测评不该对一个只有「长得像答案」的答案给分,那么,每个动作都需要在环境里留下可以被独立验证的后果,这也是为什么 RealReplicaBench 判分格外严格的另一个原因。
Benchmark 背后,是技术实力
为什么 Accio Work 团队能设计这样一套 Benchmark?
答案首先来自任务本身。RealReplicaBench 的 107 个任务并不是来自研究者想象中的「电商场景」,而是来自真实商业需求,来自约 160 万完整对话、20 万商业执行轨迹和 2000 条高价值工作流,最后通过可复现性与可判定性,收敛成 107 个任务。
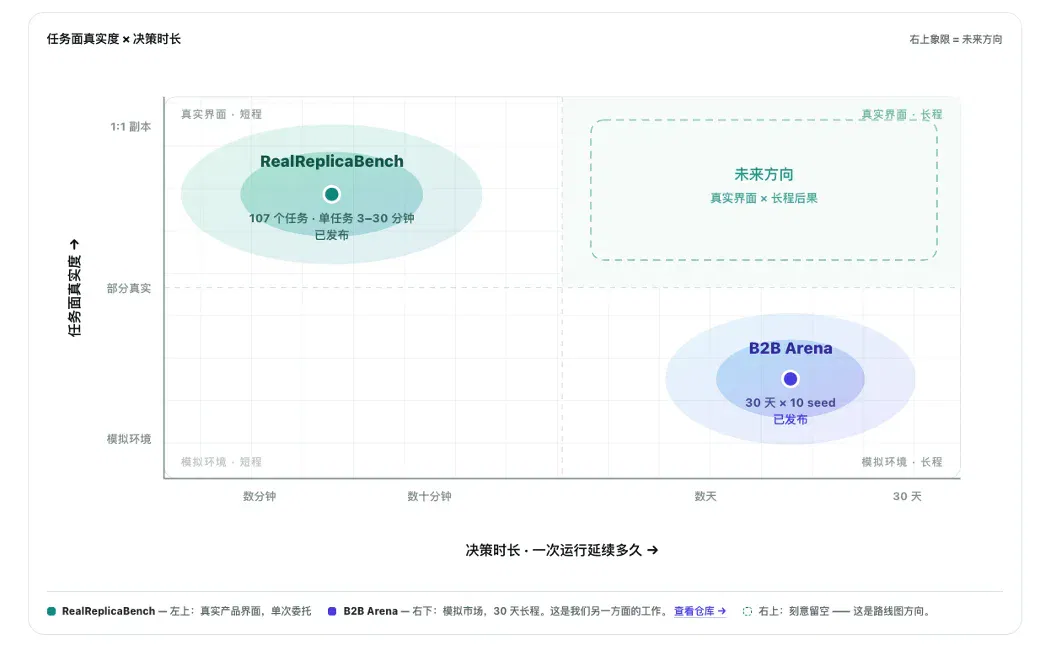
供应商采购最后应该留下什么结果,商品发布什么时候才算真正完成,物流任务究竟停在路线建议还是必须产生 Booking,跨系统协作里哪些对象关系一旦断掉就无法继续交接——这些看似属于评分标准的问题,本身就建立在对真实业务流程的理解之上。
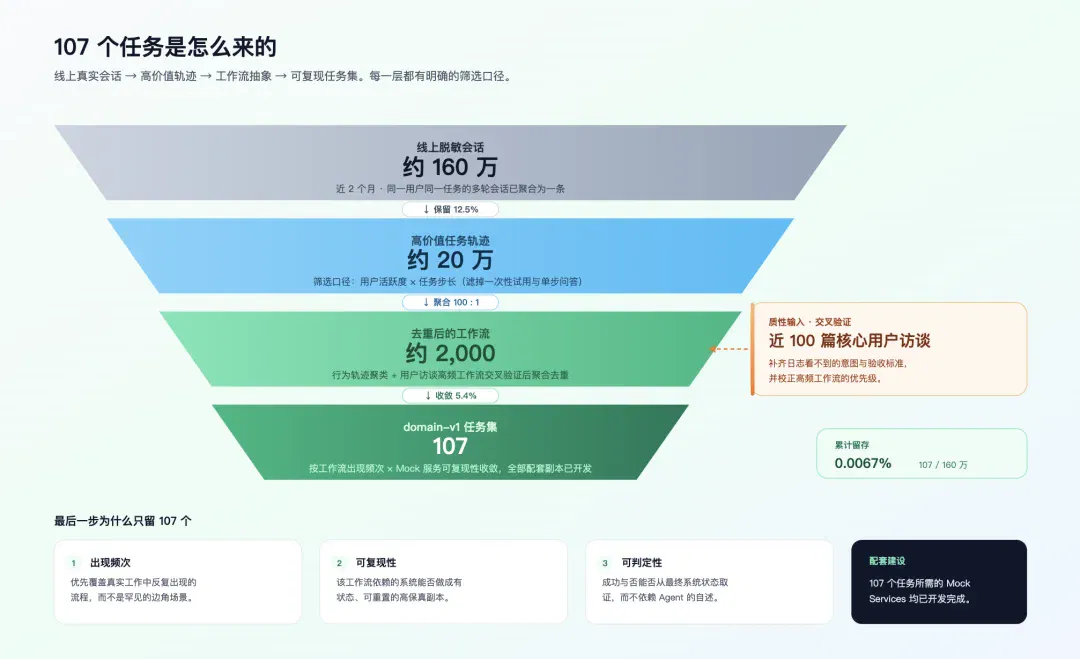
也因此,设计出什么样的 Benchmark,往往也会折射出背后的团队如何理解 Agent。
如果认为 Agent 只是一个更聪明的问答系统,测试自然会围绕答案质量展开;如果认为 Agent 的价值在于把工作真正推进到结束,那么测试就必须包含环境、工具、状态、验证以及失败后的归因。
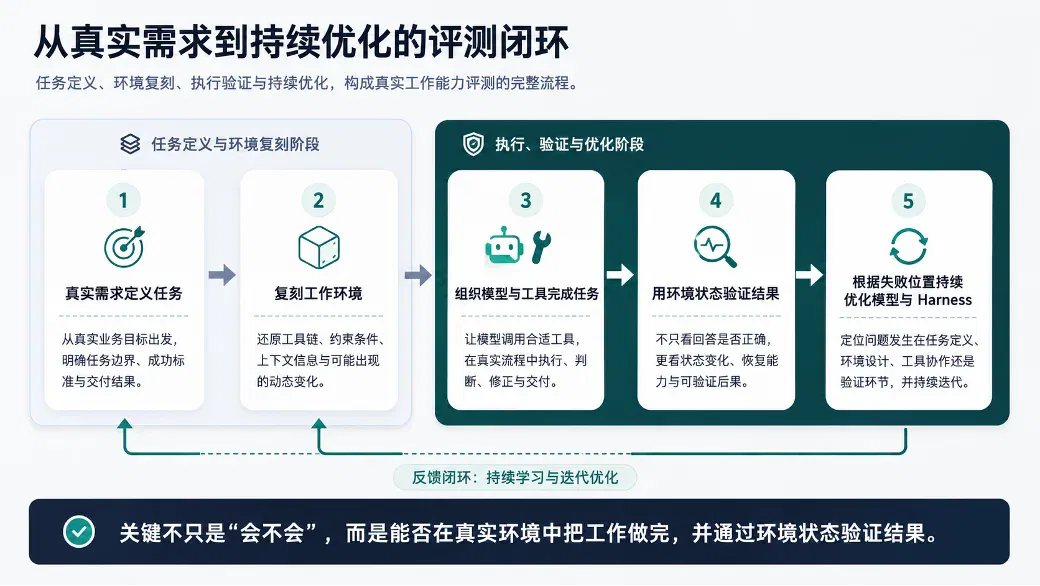
从这个角度看,RealReplicaBench 表面上是在测试模型,背后实际上也展示了 Accio Work 团队设计 Agent 的一套方法论:从真实需求定义任务,再复刻工作环境;组织模型与工具完成任务,用环境状态验证结果,再根据失败位置持续优化模型与 Harness。
这也是为什么这套 Benchmark 对 Accio Work 的意义并不只是一次对外开源。团队计划持续加入新的真实任务,让评测环境滚动更新,并进一步用于模型评测、训练优化和模型路由。根据不同任务的特点,调度更适合的模型,在效果与成本之间寻找更好的组合。
这样一套 Benchmark 惠及的不只是电商商家,让他们能更准确地判断该选择什么模型、什么 AI 产品;也同样对整个技术社区有意义。
当 AI 真正开始进入商业工作流,建设 Harness 的能力会逐渐和底层模型本身一样重要。毕竟,对用户来说,真正值得付费的从来不是一个「差不多会做」的 Agent,而是一套能够把工作接过去,并把结果直接交回来的系统。
过去衡量大模型,人们最常问的是它知道多少;后来问题变成了它能不能推理。到了 Agent 时代,评价标准正在继续向前移动,逐步靠近它到底能不能把事情真正完成。
RealReplicaBench 正在把这个看起来很朴素的问题,变成一套可以重复运行、可以验证、也可以用于研发迭代的技术标准。Benchmark 测的是模型,最终被检验的,其实也是一个技术团队对「工作如何被 AI 完成」这件事理解得有多深。
文章来自于"APPSO",作者 "APPSO"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Small-town merchants try AI assistants for menus and hotel analysis (opens in a new tab)
GeekPark interviews merchants in Rizhao, Chifeng and Chaoyang about Meituan's business assistant. Uses include menu cleanup, conversion analysis and room pricing. Platform figures and merchant accounts alone do not establish general AI-driven gains.
千问办公月卡走进直播间,AI 服务如何讲清使用场景 (opens in a new tab)
报道回顾一分钱月卡推广和现场演示,区分战报所列算力权益与实际成交额,并讨论促销拉新之后的续费与使用问题。
ThredUp 如何用 AI 处理二手服装:识别、定价与商品发现 (opens in a new tab)
文章以 ThredUp 为例,梳理机器学习定价、图像搜索与对话式搭配如何处理大量非标准服装,并讨论AI购物入口和代理下单的边界。所引79.5%毛利率来自2025年第二季度,不能直接当作当前净利润率,或与不同收入确认口径的零售商简单比较。
帮用户抢 iPhone 折叠屏的 Agent,正在塑造 AI 时代电商的形状 (opens in a new tab)
Shopify AI 交易订单增长了 13 倍。
Muse 让 Agent 购物出圈了,DeepLumen 要帮商家开一家“接待Agent的店” (opens in a new tab)
A2A 商业马拉松,刚开跑。 最近,Meta 的 AI 智能体 Muse 引起行业轰动。它能根据你的预算和偏好筛选商品,替你跟商家砍价,甚至帮你追回忘记取消的订阅费。虽然它因隐私和安全问题一度引发争议,但它让 Agent 购物第一次被大众“看得见”。 在这场新开的 A2A 商业马拉松中,Shopify、Visa 等平台和支付公司都在快速入场。创业公司在寻找“平台不愿做或做不好的事”,比如商品事实整理、跨入口归因、中小商家的运营能力。 DeepLumen 便是其中一家。它在做的是让商家的商品被 Agent 准确理解,让商家的能力被可靠调用、真正参与到用户的购物决策中。 自2025年12月成立以来