对话科锐国际刘之:招聘赛道进入 Agent 时代,关键人才反而更贵了
MiraDay 正是为了解决这个问题而诞生的,作为科锐国际孵化的一款 Talent Intelligence 产品,MiraDay 面向企业内部招聘团队和猎头公司,重点服务高管和关键技术人才招聘。它希望让 AI 承担数据搜集、信息整理和重复工作,让人类把更多精力放在人才判断、沟通和关系建立上。
因为 AI 的加入,招聘赛道开始了一场新的军备竞赛。
求职者开始用 Agent 批量投递简历,用 AI 优化简历、辅助面试,甚至通过身份伪造和 Deepfake 作弊;企业也开始用 AI 筛选候选人,投入更多技术进行识别和反作弊,一些公司还重新增加了线下面试。
AI 降低了投递和筛选的成本,却没有让招聘变得更简单。企业收到的简历越来越多,真正有用的信息反而更难辨认。
科锐国际 CTO、MiraDay Founder 刘之观察到一个看似矛盾的现象:从全球范围看,整体招聘需求正在下降,AI 招聘工具的使用却在持续增加。更深一层的变化是,AI 正在让执行变得越来越便宜,研究、规划和判断的价值则在上升。公司可能变得更小,需要招聘的人更少,但少数关键人才对公司的影响会更大。企业对这些人才的竞争会更加激烈,一次错误判断带来的代价也会更高。
找到一个人的资料正在变得越来越容易,理解一个人却越来越难。
MiraDay 正是为了解决这个问题而诞生的,作为科锐国际孵化的一款 Talent Intelligence 产品,MiraDay 面向企业内部招聘团队和猎头公司,重点服务高管和关键技术人才招聘。它希望让 AI 承担数据搜集、信息整理和重复工作,让人类把更多精力放在人才判断、沟通和关系建立上。
8 月 3 日,在 AGI Playground 2026 的主题对谈中,刘之分享了他对全球招聘市场、Talent Intelligence、Agentic Search 和垂类 AI 应用壁垒的思考。当模型厂商开始进入应用层,垂类产品是否还有壁垒?在他看来,壁垒依然存在,包括长期而细碎的 Dirty Work、行业合规、无法只靠 Scaling Law 解决的垂直算法,以及私有数据和 Context。
以下是主持人胡少阳(Stealth Startup 创始人)与刘之的对谈实录,经 Founder Park 编辑整理。
01
关键人才越来越贵,
能被自动化招聘解决的岗位会逐渐变少
Founder Park:科锐作为一家深耕人力资源行业多年的公司,今年也向海外推出了一个新的产品,你们看到了什么样的趋势和机会?
刘之:科锐国际是一家全球化人力资源服务公司。MiraDay 是科锐国际孵化的一个产品。作为一家全球化的公司,我们看到了全球人才市场正在发生两个非常大的变化。
第一个变化是,AI 让执行变得越来越便宜。以前需要几十个人完成的事情,现在可能几个人加上 AI 就能完成。公司会变得更小,但少数关键人才对公司的影响会变得更大。所以,人才市场正在向头部收缩。企业招聘的总人数可能减少,但对真正优秀人才的竞争反而会加剧。这些人会越来越稀缺,也会越来越贵。过去,优秀技术人才的总薪酬大多还在几十万美元。现在,优秀的 AI 人才已经开始出现几百万美元甚至更高的薪酬。一个关键人才可能让产品提前几个月上线,也可能帮助公司进入一个新的市场。反过来,如果关键岗位招错了人,企业付出的代价也会非常大。所以,这类人才的招聘和判断会变得越来越重要。
第二个变化是 AI 招聘的军备竞赛。从全球视角来看,很多市场的招聘需求在下滑,但 AI 招聘工具的使用却在不断上升。自动化投递和自动化触达越来越多,企业收到的简历更多,候选人收到的信息也更多。AI 辅助面试、身份伪造和 Deepfake 等问题也开始出现。企业又投入了很多技术进行反作弊。前段时间,美国有不少公司开始重新增加线下面试。判断一个人的技能到底是真实的,还是经过 AI 包装甚至虚造出来的,正在变得越来越难。这也暴露了原来招聘基础设施的问题。
过去的招聘系统主要是为批量招聘设计的,但关键人才招聘不是一个简单的漏斗,也不只是找到一个人的资料。真正困难的是理解这个人,判断他是否适合公司的产品、业务和发展阶段,以及他是否愿意加入。这需要大量研究,也需要人类提供信任、连接和温度。AI 可以负责数据搜集、信息整理和大量重复工作,人类负责判断、沟通和建立关系。
MiraDay 就是在这个判断下产生的。它是一款 Talent Intelligence 产品,面向企业内部招聘团队和猎头公司,重点服务高管和关键技术人才招聘。它不是 ATS,也不是聚合数据的搜索工具。MiraDay 希望解决的,是招聘团队如何更好地理解岗位、研究市场、找到真正合适的人,并获得更充分的判断依据。
Founder Park:你提到了一个很关键的信息是,人才是非常贵的,尤其是模型厂商需要招聘的人才。那我们可以预测一下,未来工作会整体变得越来越少吗?会不会出现一个两极分化?我们需要做模型或跟模型相关的人,依然是 margin 非常高的人才,但除此之外,原来很多中层岗位可能就消失了?会有这样的可能性吗?
刘之:我觉得会。招聘场景可以根据薪资、职级和岗位标准化程度分成很多不同的细分。但职级越高,或者专业能力越稀缺,往往越接近我们所说的关键人才。
这类人才的招聘需要人类提供 Trust、Connection 和 Warmth。现在已经有一些产品在做自动化招聘。我的判断是,越是能够通过自动化招聘解决的岗位,未来越可能被 AI 替代,或者需求逐渐减少。
02
Coding Agent 解决不了垂直场景的 harness 问题
Founder Park:其实AI 招聘赛道的发展已经有几年时间了。海外我们也看到了 Juicebox、Jack&Jill 这些产品。但对大多数在场的朋友们来说,其实不太清楚这个赛道到底是怎么划分的。给大家介绍下,以及你们今天这个产品切入的是哪个点?
刘之:招聘赛道大致可以分成四块:
第一块是 Talent Intelligence。它和 GTM Intelligence 的逻辑比较像,都是把企业内部数据和外部数据连接起来,GTM Intelligence 提供获客,而 Talent Intelligence 提供人才搜索、市场研究、人才 mapping 和信息监测等能力。
第二块是 Assessment,也就是人才测评。它解决的是怎么评价一个人,包括能力测试、技术测评、面试和其他评估工具。这本身也是一个很大的市场。
第三块是 ATS,也就是 Applicant Tracking System。当企业同时招聘很多人时,需要一个系统来管理候选人进入公司以后的流程,包括简历记录、面试安排、内部反馈和录用进度。很多大型跨国公司在不同国家有招聘团队,ATS 是它们的基础系统。
第四类是 Job Board,比如 Indeed、Dice 和 JobStreet。它们主要连接职位和求职者。LinkedIn 也有 Job Board 的功能,但它首先是一个职业社交网络,招聘只是建立在这个网络上的一个业务。
整体来看,AI 招聘的发展比客服、法律服务等垂直赛道慢一些。但我的判断是,到明年会有更多 AI 招聘公司的 ARR 超过 1 亿美元。目前增长比较快的公司,大致在走三条路径:第一类以 BPO 的方式按业务结果付费;第二类是 Talent Intelligence;第三类是减少甚至替代传统人类中介,直接连接企业和候选人。
招聘本身是一个场景高度细分的领域。企业内部招聘和猎头业务有各自的工作方式,高管招聘和技术人才招聘也需要不同的专业方法。不同行业、岗位和地区所需要的数据、搜索方法和工作流程都不一样。我们之所以切入 Talent Intelligence,是因为团队过去四五年一直在做人才数据、搜索和相关产品,科锐国际也提供了大量真实的招聘场景。这些经验让我们能够针对不同场景分层下采用不同的产品和技术策略。
市场上的通用 People Search 工具通常只是抓取公开数据,再按照条件返回一批人。这种方式可以找到名单,但很难支撑完整的高管和关键技术人才招聘。MiraDay 将专业的招聘方法、流程和团队分工融入 Agent Team,用来处理这些更复杂的招聘任务。
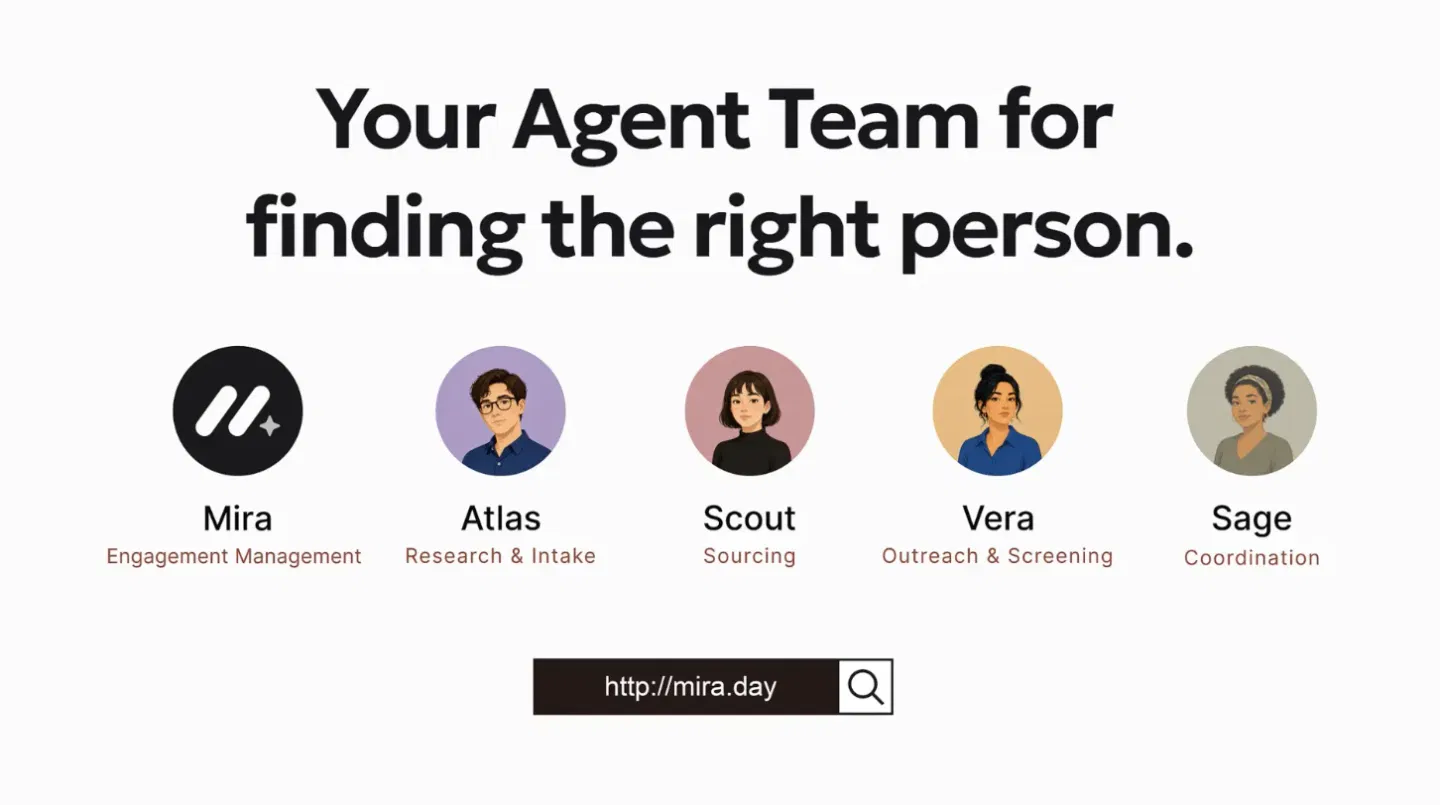
AI MiraDay 是面向海外市场的,这里有一个很本源的区别是:在中国没有用 LinkedIn 的习惯,但为什么 LinkedIn 对于海外招聘市场是一个长期性的存在?
刘之:我觉得核心还是网络效应。LinkedIn 在海外同时承担了两个角色。
第一个是职业社交网络。用户会持续维护工作经历和职业关系,企业、候选人和招聘人员都在同一张网络里。普通用户可以免费使用,招聘人员则为更专业的搜索和触达能力付费。
第二个是职业身份。一个人的公司、学校、职位和职业关系,通常都能在 LinkedIn 上找到比较标准化的记录。在研究 GitHub、Hugging Face 或学术网站上的信息时,LinkedIn 经常可以作为身份确认和跨平台 mapping 的起点。
Founder Park:MiraDay 是一个 Agent Team 的产品形态。为什么要自己做这层 harness,直接使用基模厂商的产品不行吗?怎么理解 harness 这一层的价值?
刘之:最近我看了不少 Agent Team 形态的产品,很多都是参考软件研发团队来设计的,比如产品经理、工程师和测试各自负责一部分工作。我觉得,人类团队的分工,其实是长期实践中逐渐形成的一种知识和上下文的划分方式。产品经理和工程师关注的问题不同,掌握的信息不同,需要承担的责任也不同。把不同角色拆开以后,每个角色可以长期保留自己的上下文,再通过协作完成一个更复杂的项目。
MiraDay 参考的是高管猎头(Executive Search)团队的分工。虽然 Agent 产品设计未必需要遵循人类的组织分工,但我们觉得这样的划分更符合用户心智。一个大的项目里通常有人负责理解客户和岗位,有人做行业研究、mapping 和人才搜索,也有人负责候选人研究和项目推进。360 度猎头并不是没有这些分工,只是由一个顾问同时扮演多个角色。我们认为,除 BD 职能外,高管猎头团队的这套专业分工同样高度适用于企业内部招聘团队,尤其适用于高管和关键技术人才招聘。
为什么不能直接使用 Claude Code 或 Codex?这些产品很强,但主要还是围绕 Coding 任务设计的。Coding 通常会解决一个相对明确的需求,不同任务可以通过分支、工作区或者会话进行上下文隔离。
招聘不是这样的。一个关键岗位的招聘经常会持续三到六个月,整个项目具有很强的连续性。新的市场信息、候选人反馈和面试结果会不断进入,前面的判断也可能随之改变,所以不能把它当成一个执行完就结束的单次任务。
招聘需求本身也需要反复校准。企业一开始未必能够把要求完全讲清楚。搜索开始以后,团队可能会发现薪资范围不合适,目标公司选错了,或者原来的岗位定义与公司的产品、业务和发展阶段并不匹配。这些信息都会让团队重新调整搜索方向。招聘过程中还有大量并行和异步的工作。不同候选人的进度不同,今天发出的邮件,对方可能第二天回复,也可能一周以后才回复。
招聘 AI 还涉及风险和合规。欧盟已经把部分用于招聘筛选和候选人评估的 AI 系统纳入高风险框架,美国不同地区也有反歧视、告知和审计方面的规定。所以权限、日志、判断依据和人工复核都需要进入产品设计,关键决定必须由人类负责。它不是简单给模型套一个界面,而是负责保存长期项目的上下文,协调不同 Agent,管理浏览器、邮件和数据工具,处理异步事件,并在关键节点把决定交给人类。
Founder Park:所以最终除了表面上看到怎么招聘、怎么分类之外,核心是谁要为此负担责任。
刘之:对。尤其在招聘这种高风险场景中,最终判断和责任必须留在人类这边。
03
几乎所有的 AI 应用,
都逃不掉对数据的搜索
Founder Park:对于 AI 招聘场景来说,Agentic Search 是很重要的一块技术。这块你们是怎么做的?Agentic Search 跟过去的 RAG、传统检索的区别是什么?
刘之:是的。大部分垂直类产品或应用都绕不开搜索。做法律产品,需要搜索法规、判例和企业内部文件;做财务产品,也需要搜索公开数据和企业数据。招聘也是一样,既要搜索公开数据,也要处理企业自己的数据。
从 AI 应用的角度来看,我觉得搜索技术大概经历了三代。
第一代更多是通过关键词、标签、分类和图谱进行搜索。2014 年前后,深度学习开始更多地进入搜索和推荐,但当时主要还是用于分类和排序。人需要先把搜索条件定义清楚,系统再根据这些条件返回结果。
第二代是语义搜索。BERT 在 2018 年发布,Dense Retrieval 和 RAG 大约在 2020 年出现。到了 2023 年前后,随着更大规模的 Embedding 模型、数据和算力进入,模型的语义匹配能力有了明显提高,向量检索和 RAG 也开始大规模进入 AI 应用。
RAG 的典型方式,还是人输入一个问题,系统检索一批相关内容,再交给模型生成答案。如果结果不理想,通常需要人修改问题,再重新搜索。
第三代是 Agentic Search,并且会结合上下文检索。它和 RAG 最大的区别是,人不一定要先写出一条准确的查询,而是可以先给 Agent 一个目标。Agent 会自己搜索、阅读结果,再根据当前发现决定下一步搜索什么。这是一个不断观察、判断和采取行动的过程,和 ReAct 的思路比较接近。
这背后有两个比较重要的变化。第一个变化是 Agent。它可以在长程任务中不断与外部环境互动,根据每一步得到的结果形成下一步 Action。第二个变化是模型对长上下文的能力提升。很多人只关心模型最多能处理多少 Token,但更重要的是,当信息分散在长上下文的不同位置时,模型能不能进行多跳推理,把来自不同位置、不同来源的证据连接起来。在 12.8 万 Token 以内,头部模型的表现还不错,但再长一些就很差了。最近 Anthropic 发布的 Fable 5,在 100 万 Token 下的 GraphWalks 得分也已经接近 0.8。
第三代搜索的出现主要来自两个变化。一方面,Agent 可以持续搜索,并根据结果调整下一步行动;另一方面,模型开始能够在更长的上下文中找到分散的信息,并完成多跳推理。这就是我们所说的 Agentic Search。
Founder Park:你们产品里有一个很有意思的能力叫 Agentic Search with Signal。这个 Signal 具体是什么?在 Agentic Search 里,你们觉得有什么实时的反馈是最有价值的?相比以前上一代的系统。
刘之:讲 Signal 之前,我想先讲一下人类是怎么获取信息的。从信息科学的角度看,人获取信息大致包含四种行为。第一种是 Lookup,也就是目标明确地查找某个具体信息;第二种是 Exploratory Seeking,也就是探索式搜寻,目标还不清晰,需要边搜索、边理解;第三种是 Research,也就是穷尽式研究,为了形成相对完整的判断,系统地收集和分析信息;第四种是 Re-finding,也就是重新找到过去看过或者使用过的信息。
招聘中的很多搜索,其实属于 Exploratory Seeking 和 Research。比如我拿到一个以前没有接触过的职位,会先在人才库里搜索,从结果中找到几个相关的概念和关键词,再沿着这些线索去搜索引擎或者其他渠道继续寻找。看到新的信息以后,我可能会修正对岗位的理解,调整关键词和搜索方向,逐渐明确真正要找什么。
所以,搜索不只是找到信息,也是一个不断学习和进行意义构建的过程。
过去的搜索系统同样可以支持探索式搜寻,但整个过程主要由人来推动。系统根据当前的查询返回结果,人需要自己阅读结果、发现线索、调用过去的经验,再决定下一步搜索什么。人的注意力和工作记忆都很有限,在大量结果中,一些真正可能改变搜索方向的信息很容易被忽略。
Agentic Search with Signals 想解决的就是这个问题。Agent 不只是执行查询和返回结果,还会持续阅读、比较和分析搜索结果。如果发现了可能影响当前判断的信息,它会提出一个 Signal,告诉人类自己发现了什么,以及判断的依据是什么。
在招聘场景中,最有价值的 Signal,通常是那些可能改变原有搜索假设的信息。比如合适的人才主要集中在另一个行业,市场上的实际职级与企业设定不一致,薪酬范围可能不合理,或者当前使用的岗位名称无法覆盖真正合适的人才。
相比上一代系统,变化不在于 Agent 替人作决定,而在于它开始参与搜索过程中的线索发现。过去主要由人发现问题,再修改查询;现在 Agent 也可以主动提出值得关注的信息。至于是否调整目标、修改条件或者改变策略,最终仍然由人类决定。
不同产业、不同岗位中,值得关注的 Signal 并不相同。如何捕捉这些 Signal,本身就依赖大量专业经验。MiraDay 会把猎头顾问和招聘专家积累的经验整理成 Skills,让 Agent 具备捕捉相关 Signal 的能力。同时,Agent 也可以在搜索过程中捕捉那些没有被预先定义、但值得人类关注的 Signal。我们即将发布一篇综述论文,专门讨论这个问题。
04
模型解决不了最后一公里,
垂类 AI 应用还是有壁垒的
Founder Park:今天你们代表了 AI 招聘赛道,其他的创业者也在不同的垂类赛道上面。模型能力越来越强,成本也在变化。那作为应用型或场景类的创业公司,未来有没有可能有自己的模型?自己 post train 一个模型,而不是纯粹地调用 API?你怎么看?
刘之:我特别喜欢一本书,叫《技术的本质》。这本书讲到,技术总是会不断发展,也会组合原来的技术,形成组合创新。当一项技术刚出来的时候,它可能做得不太好,于是会出现非常多的补丁和变体。发展到一定阶段,遇到瓶颈,又会有新的技术出现。技术总是在解决一个问题的过程中,带来一个全新的问题。
如果从一个技术周期来看,早期出现的技术,往往会在未来几年当中快速贬值。也就是说,今天我们在做的模型训练、算法工程,在早期非常有壁垒。但随着标准化、平台化甚至普及化,这些技术会变得越来越简单。就像早年在国内管理一个大规模集群,做 Android、iOS 开发,或者把用户体验做好,都是非常有壁垒的事情,但今天已经没有那么高的壁垒了。
所以我觉得,未来训练和微调一个垂直模型的难度与成本会变得越来越低。核心的问题是,我有没有必要去干这个事?做完以后,我真的能不能形成差异化?
垂类 AI 应用的壁垒,不一定在于有没有自己的模型,而在于能不能解决模型解决不了的最后一公里。
Founder Park:怎么判断有没有必要?如果成本不是问题、难度也不是问题,大不了用第三方训练模型的方式,我怎么判断今天是不是应该有一个自己的 post-training 模型出来?
刘之:主要看通用模型能不能解决最后一公里的问题。比如现在很多人用 Vibe Coding,很快就可以做出一个特别好看的网页。但如果你要做一个真正的产品,里面的字体、组件、视觉和栅格都要遵循同一套设计系统,保持一致性,这时候你就会发现,只靠大模型解决不了。
还有很多人用大模型生成文案,写出来的内容 AI 味很重,有时也会出现幻觉。因为模型学习的是大量通用语料,并不了解你的品牌、业务和具体场景。这时候你可能就需要自己的模型。
招聘也是一样。我们需要解决合规、偏见以及招聘场景中的专业性问题。在通用模型无法稳定解决这些问题的情况下,我们就需要训练自己的模型。所以,判断标准还是能不能解决最后一公里。现在大家对于大模型厂商带来的压力,的确会有一些恐慌。今年 SaaS 公司被卷得很厉害,但大家现在又开始发现,大模型厂商其实解决不了所有的最后一公里问题。
为什么 OpenAI、Anthropic 这些公司要做 FDE?就是因为仅仅提供模型还不够,还需要有人把模型真正带进业务场景。而最后一公里,往往才是最有价值的部分。
Founder Park:以再进一步聊聊。今天,模型厂商也开始下场做应用了,尤其是 Workspace 这类的产品。前段时间典型的是 Claude Design 出来,杀死了一批 SaaS 公司,股价血流成河,但现在回来了。涨回来的本质到底是什么?是觉得解决不了,还是 SaaS 本身还代表了一些事情?
刘之:我觉得这里面有两个点。第一个是,刚才提到的最后一公里问题,大模型厂商解决不了。第二个是企业软件的深度集成和海外合规要求。比如企业今天把 CRM 系统与 ERP 打通,背后是一套完整的数据流和审计链,每一笔业务操作都有据可查、可以回溯。招聘场景也是一样,ATS 不仅管理流程,还会保留申请、面试和录用等记录,为企业满足平等就业和相关审计要求提供支持。这类深度集成和合规留证能力,是市场重新认识 SaaS 价值的重要原因之一。而且原来的 SaaS 公司也没有「睡着」,大家也在不断地把 AI 加进自己的产品。
所以,Anthropic 带来的恐慌,我觉得现在在硅谷已经慢慢淡化了。大家开始发现,模型能力很强,但它并不能直接替代一个完整的业务系统。模型可以生成内容、调用工具和执行任务,但进入真实业务以后,还要处理数据、流程、权限、合规以及人与人之间的协作。这些都是最后一公里的问题。
过去,AI 创业公司经常讲四个壁垒。第一,我有业务 Know-how,我特别懂这个行业;第二,我有数据飞轮,用户使用得越多,产品积累的数据和记忆越多;第三,我可能有垂直算法;第四,我有人机协作的界面。OpenAI 也讲过三个壁垒,分别是人与人之间的 Trust、Data 和 Distribution。
但 Cursor 被收购这件事,又让大家重新审视这些判断。比如记忆这件事,我觉得它并不会天然形成壁垒。记忆和上下文不是越多越好,加入太多不相关的信息,反而可能影响模型的执行效果。所以,原来大家讲的这些壁垒,有些仍然成立,有些需要重新理解。
今天以 MiraDay 为例,或者从我们对招聘垂直产品的理解来看,我们认为未来的壁垒主要有四个。
第一是 Dirty Work,也就是那些非常脏、非常细碎,但又必须长期去做的工作。比如做一个岗位时,需要持续整理标签、清理数据和进行人工判断。模型厂商不会针对每个行业去做这些事情,因为它没有这样的精力和耐心。
第二是合规。招聘有招聘合规,财务有财务合规,各个行业都有自己的合规要求。尤其是企业出海以后,合规是一件非常关键的事情。
第三是不能只靠 Scaling Law 解决的算法问题。比如多模态生成,扩大模型规模可以提升基础生成能力,但对齐、可控性和一致性仍然需要专门的训练与算法。Embedding 模型也是一样。以 OpenAI 早期的 Text Embedding 研究为例,模型参数量从 3 亿增加到 1750 亿,扩大了约 583 倍,但在 22 项任务上的平均分只提升了约 3.6 分。我们坚持做 Embedding 模型训练已经三年多了,目前在 BRIGHT 推理检索 Benchmark 上做到了 SOTA。这种细分方向需要长期、持续的专项投入,但对大模型厂商来说,要在每一个方向上都深入去做并不划算。
第四是私有的数据和 Context。这些信息不是公开的,也不会自然进入通用模型。
我觉得,模型厂商会继续进入应用层,垂类公司也一定会受到冲击。但模型厂商很难把每个行业的最后一公里全部做完。至少在 AI 招聘这个赛道里,Dirty Work、合规、垂直算法以及私有数据和 Context,就是我们正在尝试构建的壁垒。
文章来自于微信公众号 “Founder Park”,作者 “Founder Park”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Wei Xiaokang on AI talent: foundation model research, application teams, and changing organizations (opens in a new tab)
LatePost interviews former ByteDance and Meituan recruiting leader Wei Xiaokang about high salaries, fewer model jobs, and small development teams. Forecasts about employment and organizations are his judgments.
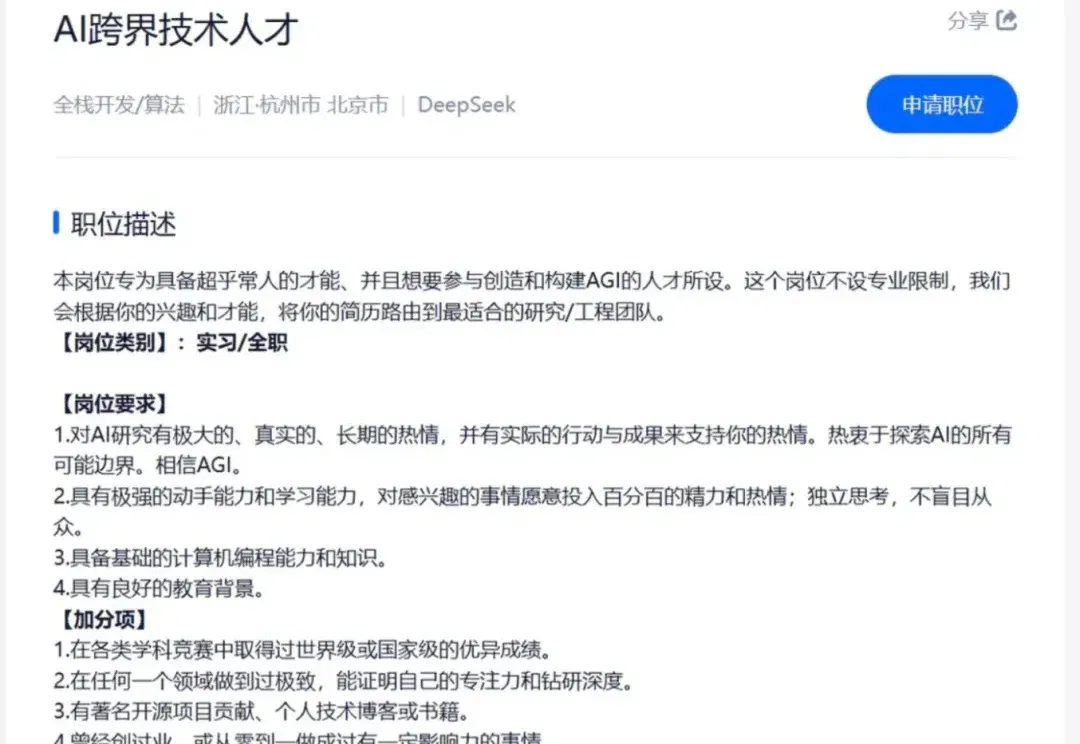
DeepSeek你这岗位到底想招啥嘞? (opens in a new tab)
DeepSeek啊……你这岗位到底想招啥嘞?
刷LeetCode的时代要过去了?大厂面试正在转向 (opens in a new tab)
程序员面试的时候,终于可以光明正大地打开 AI 了。
字节凶猛:从招聘看字节AI战略战术背后的逻辑与细节 (opens in a new tab)
字节跳动正依托Seed、火山引擎、飞书、豆包、抖音和TikTok,在芯片、算力、模型、云服务、终端及机器人等AI全产业链布局,但投入分散与关键押注不够坚定仍是风险。
前 Meta 企业 AI 负责人离职后,开始用 AI 帮年轻人找第一份工作 (opens in a new tab)
2025 年秋天,Meta 上线了一名可以替商家卖货的“AI 员工”。商家不需要重新整理一套资料,它会直接读取品牌过去发布的社交媒体内容、广告、商品目录和网站信息,自动学会这家公司卖什么、用什么语气和顾客说话。