Kimi突发K2.8:性能逼近K3,百万上下文全员开放
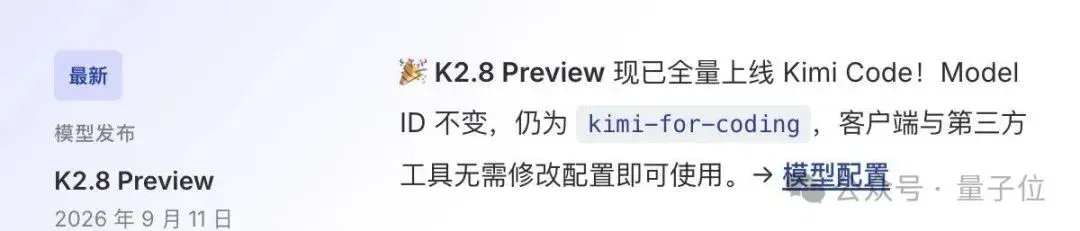
Kimi于9月11日上线K2.8 Preview模型,综合性能接近旗舰K3并将1M上下文开放至全部会员档位,作为低成本主力模型承接月之暗面快速增长的商业化需求。
Kimi又发了个新模型,把K3的能力打到全价位段了。
9月11日,Kimi K2.8 Preview在Kimi Code和Kimi Work全量上线,官方称综合性能接近旗舰 K3,且Coding和Agent能力进一步提升。
最实质的变化是在权限上,所有会员档位都能用上1M上下文了!
对比来看,K3的百万上下文目前仍需Allegretto及以上会员。
就在前一天,外界获悉,月之暗面的ARR在8月突破了10亿美元,而6月这一数字还是3亿。
这轮增长的直接催化剂是7月发布的K3,曾凭借一波SOTA级前端能力打出了全球声量。
据彭博社消息,公司内部希望,年底ARR可以冲到20亿美元。
K2.8是“小K3”吗
K2.8 Preview这个名字,很容易让人觉得月之暗面又做出了一个更小更便宜的K3。
从官方口径来看:
K2.8 Preview的综合性能接近K3,Coding和Agent能力全面提升,思考效率较K2.7 Code显著改善;
支持low/high/max三档reasoning effort,与K3的思考等级对齐;
同时支持图片和视频输入,上下文窗口为1M。
不过,本次预览更新没有公布任何benchmark数据,所以“综合性能接近K3”到底接近到什么程度呢?
尚未可知。
毕竟K3发布时也是传奇,总参数量2.8万亿、激活约1040亿参数的MoE模型,追求的是在各项基准上跑赢海外旗舰,而代价则是贵、慢、吃资源。
相较于这种跑分定位,K2.8 Preview大概是纯过日子模了,它被定位在“更适合代码补全和常规开发任务”。
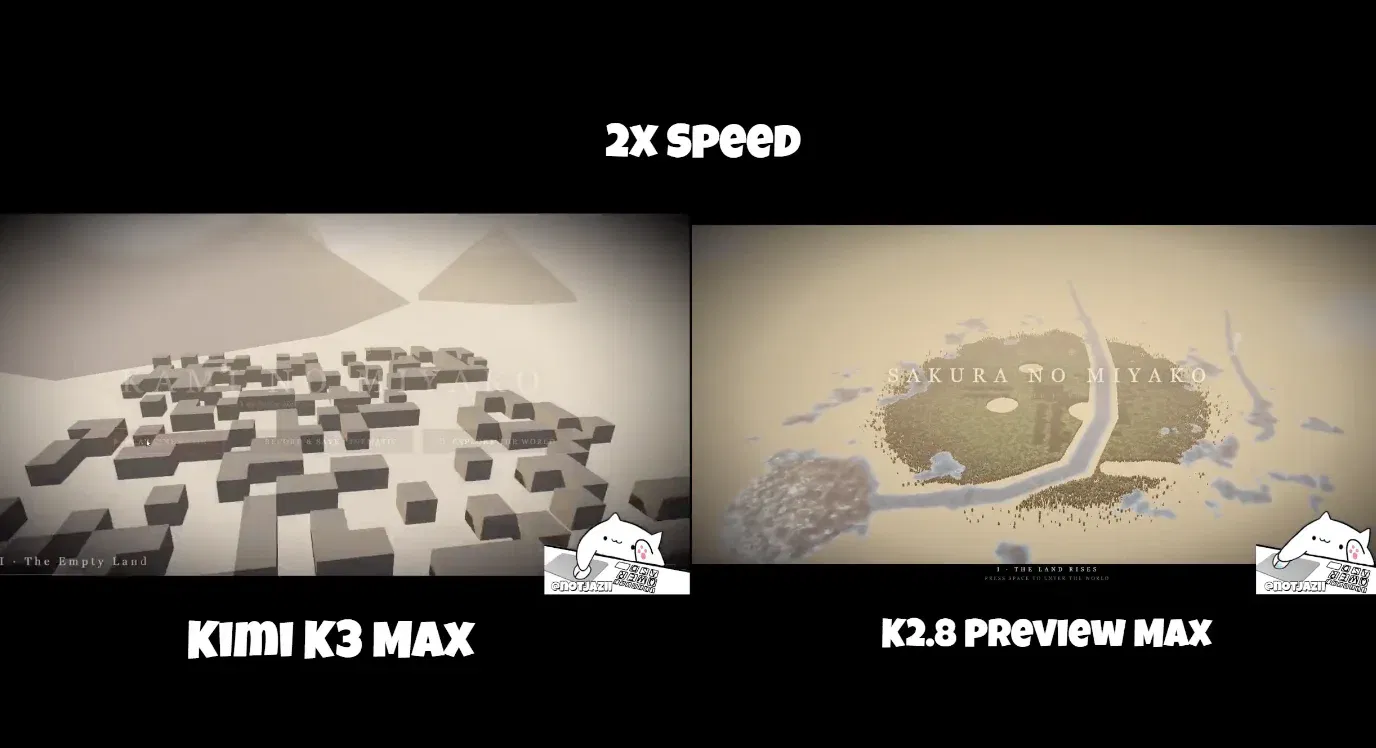
已经有人测上了,说是K2.8虽然不能一次就完成任务,但确实快了很多,大家可以看看效果:
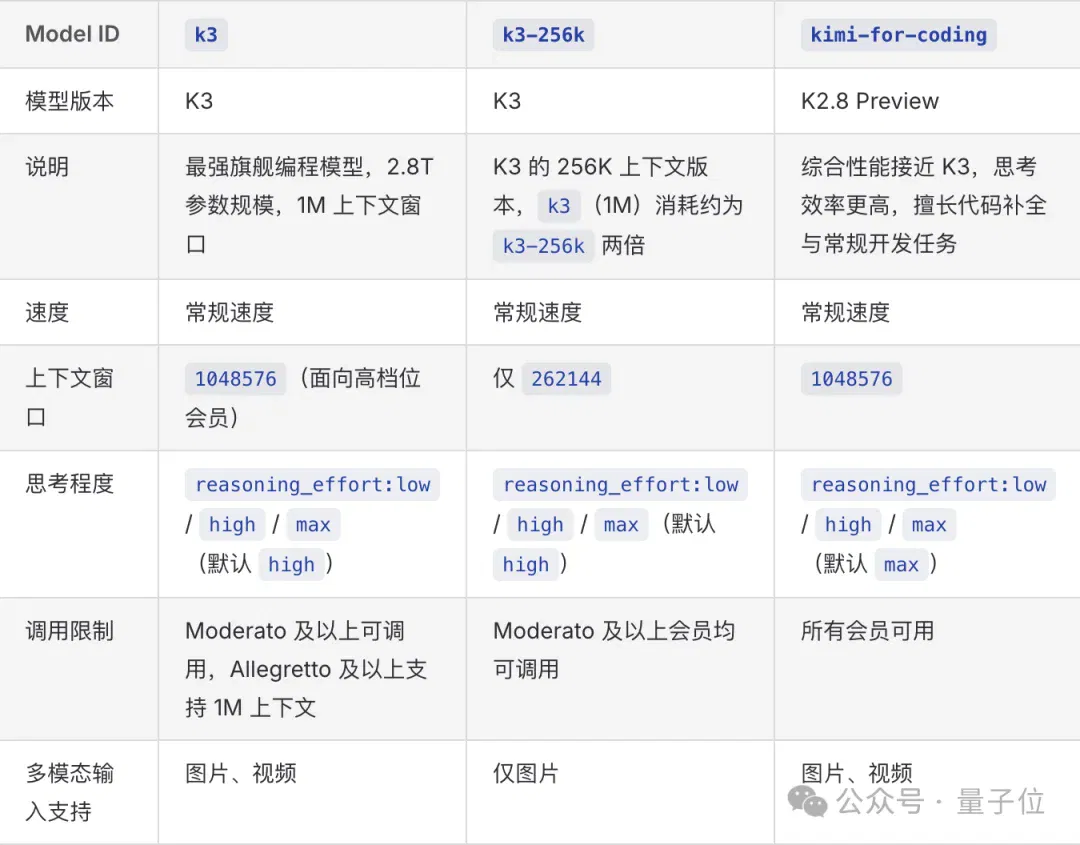
当前,Kimi Code会员有五档,Adagio免费、Andante¥49/月、Moderato¥99/月、Allegretto¥199/月、Allegro¥699/月。
K3从¥99档起才能调用,1M上下文要¥199档以上,而K2.8 Preview所有会员可用,且直接给到1M。
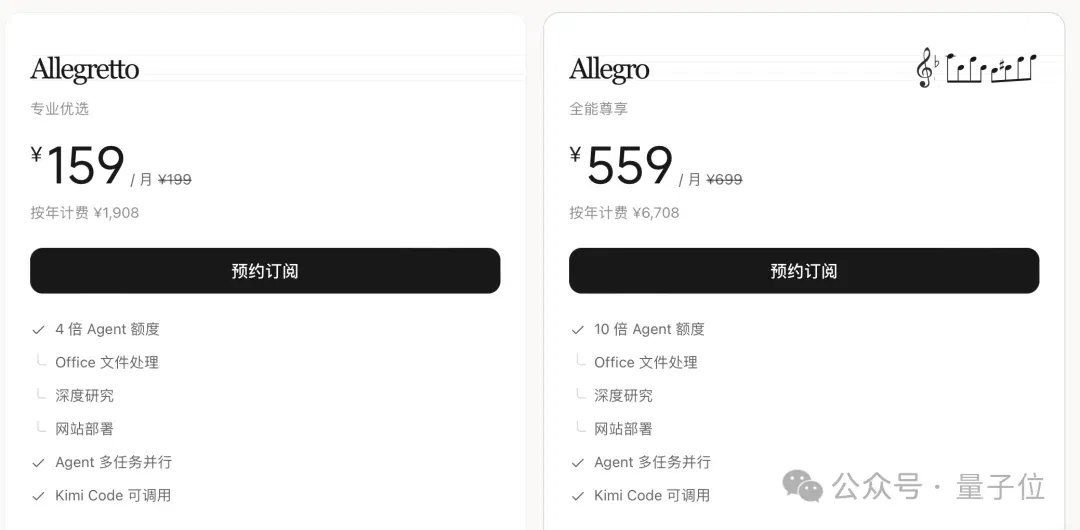
顺便插一句。
这里的会员档位名称也是在K3发布后调整的:
Adagio是柔板、Andante是行板、Moderato是中板、Allegretto是小快板、Allegro是快板,Kimi是老板……这种命名方式和他的音乐爱好也有关联吧(沉思)。
目前二者流量接管方式将如下。
无感知替换,原有的kimi-for-coding直接升级为K2.8 Preview,Model ID保持不变;
在Kimi Code里接管K3需求,K3系列关闭thinking后,请求也会被转给K2.8 Preview的无思考版本;
不止编程场景,Kimi Work也同步上线了K2.8 Preview。
月之暗面急需低成本主力模型接力
K2.8也很难与月之暗面当前紧锣密鼓的商业化节奏分开看。
据报道,月之暗面的ARR在今年3月约为1亿美元,4月升至约2亿美元,6月超过3亿美元。
而到8月这一数字已突破10亿美元,公司希望在年底前达到20亿美元。
K3是其中一个关键的陡峭点。
它在7月发布后,以开源权重、超长上下文和旗舰级编程能力迅速打开了市场。
它的定价为每百万token输入3美元、输出15美元,仅为对手的三分之一,同时在编程基准上超过Claude Opus 4.8和GPT-5.5。
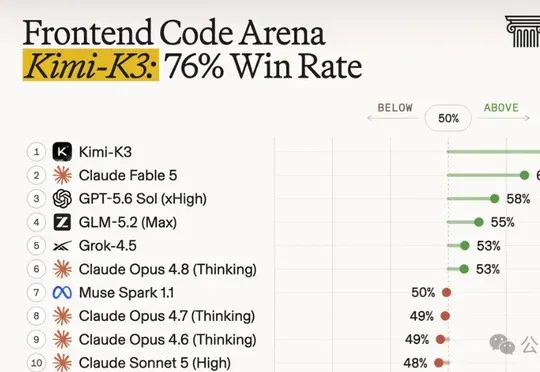
在Arena.ai前端代码竞技场上,K3以1679分登顶,超过Claude Fable 5和GPT-5.6 Sol——而前代K2.6在同一榜单上仅排第18位。
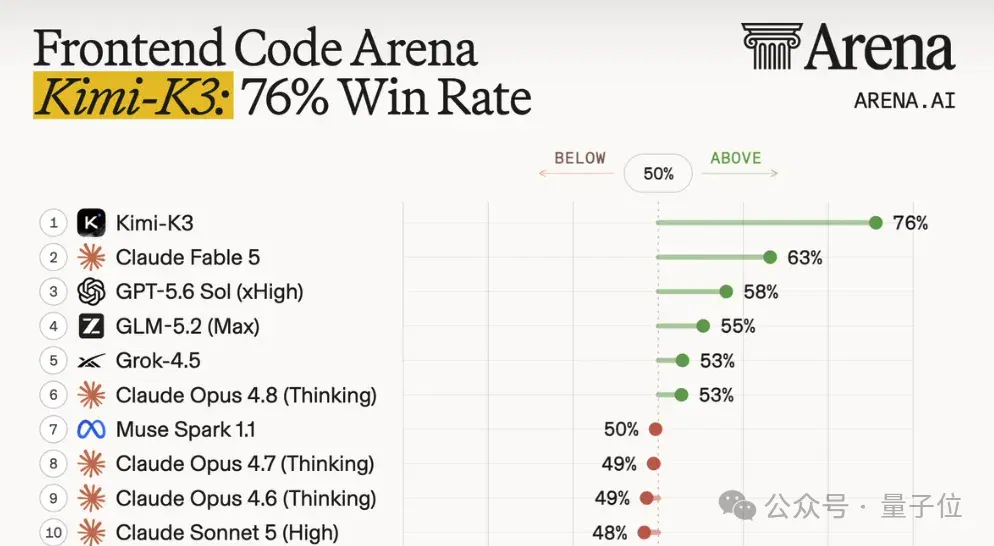
△前端代码竞技场胜率排行
目前,K3系列每天生成约3000亿token。
尽管如此,要从10亿冲到20亿,仅靠一个高成本的旗舰模型是难以支撑的。
而且K3也并非没有产品层面的边界,月之暗面在K3技术博客中提到过,K3对历史thinking内容较敏感。
也就是说,如果Agent框架没有完整传回此前的思考记录,或在会话中途从其他模型切换到K3,生成质量可能明显不稳定。
并且,K3在模糊任务中可能表现得过于主动,自行作出超出用户预期的决定。
不过这也是很多强能力模型的通病了。
故而“能力上限”有时候也不等于“所有场景下的最好体验”,对于代码补全、修改和明确边界内的日常开发,用户可能还是更喜欢行为更可控、调用门槛更低的模型。
这时候,一个单位成本更低、能够大规模铺开的主力模型就必须要推出来了。
One More Thing
据彭博社消息,本月初,月之暗面以保密形式向港交所递交了A1上市申请文件,正式启动港股IPO流程。
从估值曲线来看,2025年底月之暗面C轮投后估值43亿美元,2026年5月涨到200亿,7月F轮后达到350亿。
7 月底,月之暗面同时启动了Pre-IPO轮融资,投前估值升至500亿美元。
八个月估值涨了近八倍,但收入呢?
按500亿美元投前估值和当时公开的3亿美元ARR来算,市销率为167倍。
作为参照,Anthropic的这一倍数约为20,OpenAI约40,智谱万亿市值时约94。
因此,让更多人用起来,让单位调用的成本降下来,可能真的是Kimi的当务之急。
参考链接:
[1]https://www.kimi.com/code/docs/kimi-code/whats-new.html
[2]https://www.kimi.com/code/docs/kimi-code/models.html
[3]https://www.bloomberg.com/news/articles/2026-09-11/china-ai-star-moonshot-eyes-2-billion-annualized-sales-in-2026
[4]https://x.com/notjazii/status/2098400259223458188?s=46
文章来自于微信公众号 “量子位”,作者 “量子位”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Kimi 新模型 K2.8 Preview 全量上线!综合性能逼近 K3! (opens in a new tab)
Kimi K2.8 Preview 编程模型全量上线 Kimi Code,支持 1M 超长上下文并向所有会员档位开放,综合性能接近 K3,默认采用 Max 思考档位,编码和智能体能力较 K2.7 Code 有所提升。
TCSExam 测试研究级数学任务,Kimi 构造出 630 条边的图 (opens in a new tab)
姚期智、杨植麟等人的团队提出包含 100 项任务的 TCSExam。Kimi K3 在特定无短环图构造任务中将参考结果从 629 条边推进到 630 条边。
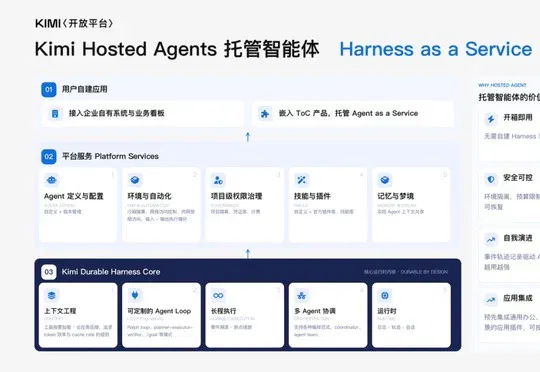
Kimi Hosted Agents 正式发布:Harness as a Service (opens in a new tab)
Kimi Hosted Agents 正式发布,以 Harness as a Service 提供7×24小时托管环境,支持长程任务、多智能体协作、安全控制、审计及140+ Skills、30+插件和8个金融Agent模板。
Kimi 发布游戏开发方案,连接专业引擎、建模与运营工具 (opens in a new tab)
Kimi 介绍基于K3.1 Pro、Kimi Code和Kimi Work的游戏开发方案,连接Unity、Unreal、Blender等工具,展示原型、工程修改与试玩验证。官方演示的耗时与完成度依赖任务及环境,不代表任意用户都能在一两天完成商业游戏。
Kimi商业和模型都想要,但卡是有限的 (opens in a new tab)
月之暗面发布2.8万亿参数后训练模型Kimi K3.1 Pro,其综合智能指数领先DeepSeek V4.1 Flash-1017和MiniMax M3.1 Flash,但API费用最高,并正研发Flash版本以平衡能力、成本与商业化。