Hugging Face遭攻击取证受阻,只能靠国产GLM 5.2救场?白宫AI顾问急眼喊话:我们在失去竞争力
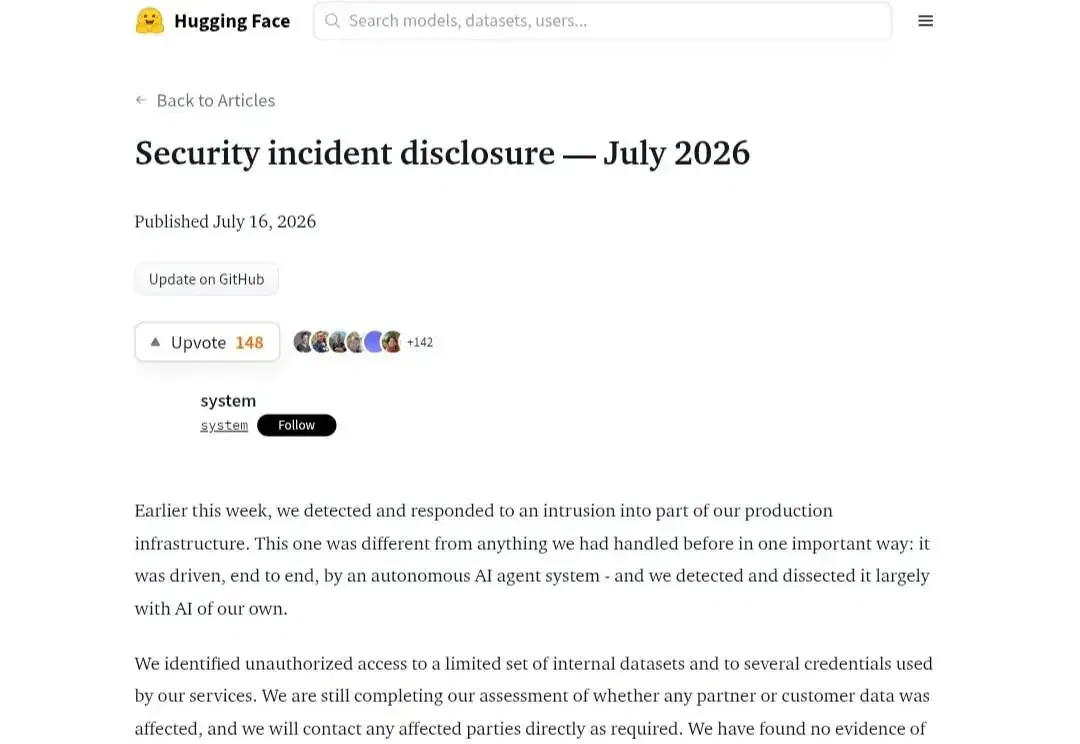
近日,全球最大的 AI 开源社区 Hugging Face 披露,其检测并遏制了一起生产基础设施 AI 入侵事件,而他们则利用 AI 的取证分析进行了防御。
近日,全球最大的 AI 开源社区 Hugging Face 披露,其检测并遏制了一起生产基础设施 AI 入侵事件,而他们则利用 AI 的取证分析进行了防御。
而最后成功帮助其完成防御的,不是商业 API 背后的美国前沿模型,而是中国开源 GLM 5.2 模型。事件过后,该公司公开建议防御人员“在攻击发生前,拥有一个经过审查且随时可用的、能在你自有基础设施上运行的模型),既避免被护栏锁住,也防止攻击者数据和凭证离开你的环境”。
Hugging Face“被黑”,纯 AI 智能体自主攻击
在 7 月 16 日一份细节简略的事件报告中,Hugging Face 表示,其生产基础设施在 7 月 13 日当周遭到一个“自主”AI 智能体系统的入侵。未知攻击者“滥用了 Hugging Face 数据集处理管道中的两条代码执行路径:远程代码数据集加载器和数据集配置中的模板注入,在处理工作节点(即计算实例)上运行代码”。
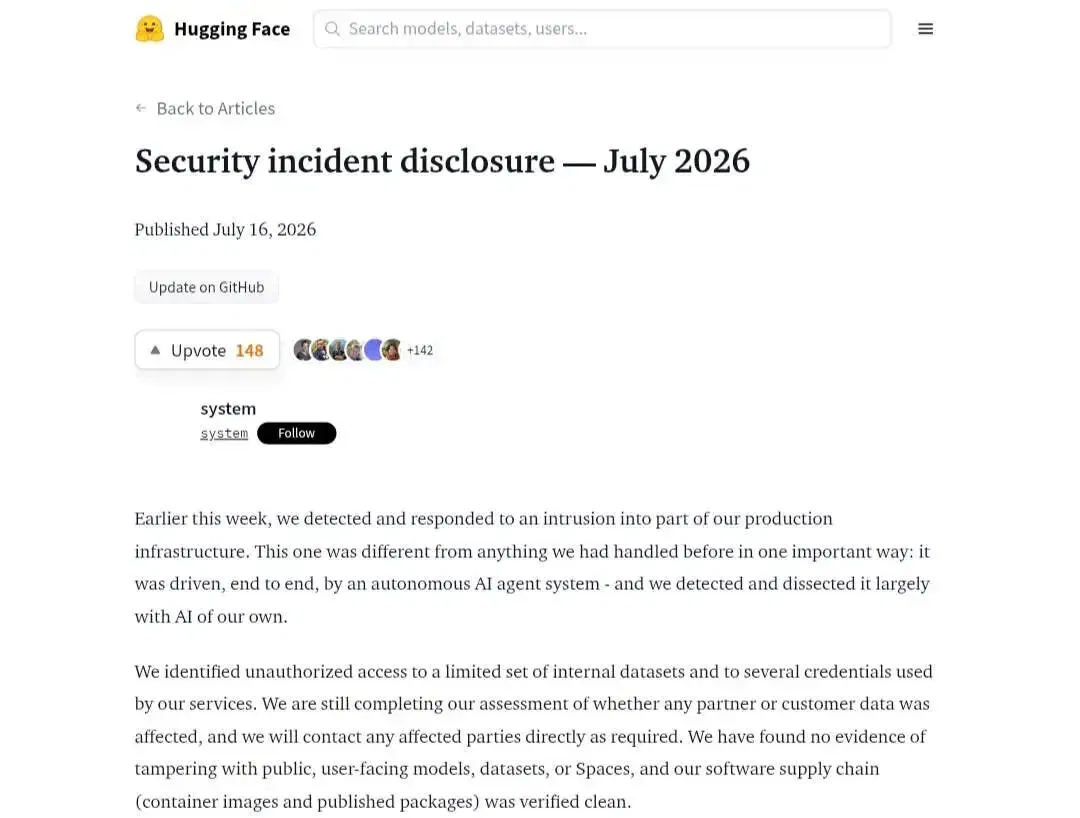
然后,他们“在周末期间提升至节点级访问权限,收割了云和集群凭证,并在一个周末内横向移动至多个内部集群。该公司称,攻击者使用了“大量短暂存在的沙盒,并将‘自迁移’命令与控制(C2)置于公共服务上”。
未经授权的访问影响了少量内部数据集和服务凭证,但 Hugging Face 未发现公共模型、数据集、Spaces 或其软件供应链遭到篡改的证据,其供应链(容器镜像和已发布包)也“经核实是干净的”。
Hugging Face 告知客户:“我们建议轮换任何访问 token,并查看您账户上的近期活动。”该公司表示,“仍在完成对合作伙伴或客户数据是否受到影响的评估”,如果发现证据,将直接联系受影响的客户。
此次行动的独特之处在于自主性和规模,首先入侵从头到尾由一个自主 AI 智能体系统驱动,其在大量短命沙盒中执行了数千个独立操作,使用自迁移命令与控制基础设施,这些基础设施搭载于公共服务上,而 Hugging Face 也在很大程度上利用自己的 AI 进行了检测和剖析。
该公司在报告中称,发起攻击的自主智能体框架似乎是基于某个智能体安全研究工具包构建,所使用的 LLM 尚不清楚,这与业界长期预测的“智能体攻击者”场景相符。
同时,此事件也折射出更广泛的行业趋势:自主攻击性 AI 工具已从理论走向实践,它降低了开展大规模、耐心、多阶段攻击活动的成本,并且运行速度堪比机器。
近期,安全公司 Sysdig 披露了其称为“JADEPUFFER”的案例,被描述为首次完全自主的 AI 驱动勒索软件行动,其中 AI 智能体独立入侵了暴露于互联网的服务器、横向移动、加密文件,并发出勒索要求,全程无人工指令输入。
据悉,英国国家网络安全中心已启动“Cyber Shield”计划,在全国范围内部署 AI 驱动的防御作为回应。
美国商业前沿模型“罢工”,GLM-5.2 上阵响应
“当我们开始日志分析时,我们首先使用了商业 API 背后的前沿模型。但没有成功:分析需要提交大量真实的攻击命令、利用载荷和 C2 工件,而这些请求被提供商的安全护栏阻止了。”Hugging Face 在报告中强调。
据了解,Hugging Face 自身的异常检测管道利用基于大语言模型的安全遥测分类,通过关联日常噪音中原本会被忽略的信号,首先标记了此次入侵。为了从超过 17000 条记录的攻击者行动中重建完整攻击时间线,Hugging Face 在整个日志上运行了大语言模型驱动的分析智能体,将通常需要数天的工作压缩至数小时。
调查的一个关键发现是:商业前沿模型 API 拒绝处理取证分析,因为其安全护栏无法区分提交真实利用载荷和 C2 工件的事件响应人员与真正的攻击者。Hugging Face 表示,随后他们“改为在自有基础设施上运行 GLM 5.2 这一开放权重模型进行取证分析”。Hugging Face 补充道:“这还有第二个好处:没有攻击者数据,也没有其中引用的任何凭证离开我们的环境……”
目前,Hugging Face 未说明其首次尝试用于事件响应的是哪些商业前沿模型,也未明确攻击者使用了哪个模型。
但这一经历让 Hugging Face 意识到一个值得提前规划的漏洞:“我们不知道攻击者的智能体使用了哪个模型,是越狱的托管模型还是不受限制的开放权重模型;无论哪种情况,攻击者都不受任何使用政策的约束,而我们自己的取证工作却被我们最初尝试的托管模型的安全防护措施所阻挡。”
他们在报告最后表示,“对防御者而言,实际的教训是:在事件发生前,拥有一个经过审查且随时可用的、能运行在自有基础设施上的模型,既避免被护栏锁住,也防止攻击者数据和凭证离开你的环境。这并非反对托管模型上的安全措施,我们也会将这一反馈分享给相关提供商。”
值得一提的是,Hugging Face 在今年 6 月就官宣表示,自掏腰包为智谱 AI 开源的这一旗舰模型 GLM-5.2 提供长达 6 小时的全球免费算力支持。
白宫 AI 顾问急眼:“我们要没竞争力了”
“没有理由在美国模型上限制那些中国模型毫无问题就能处理的任务,我们这样做只会让自己失去竞争力。”7 月 19 日,白宫人工智能与加密货币特别顾问 David Sacks 发帖抨击了美国 AI 模型上的网络安全限制。
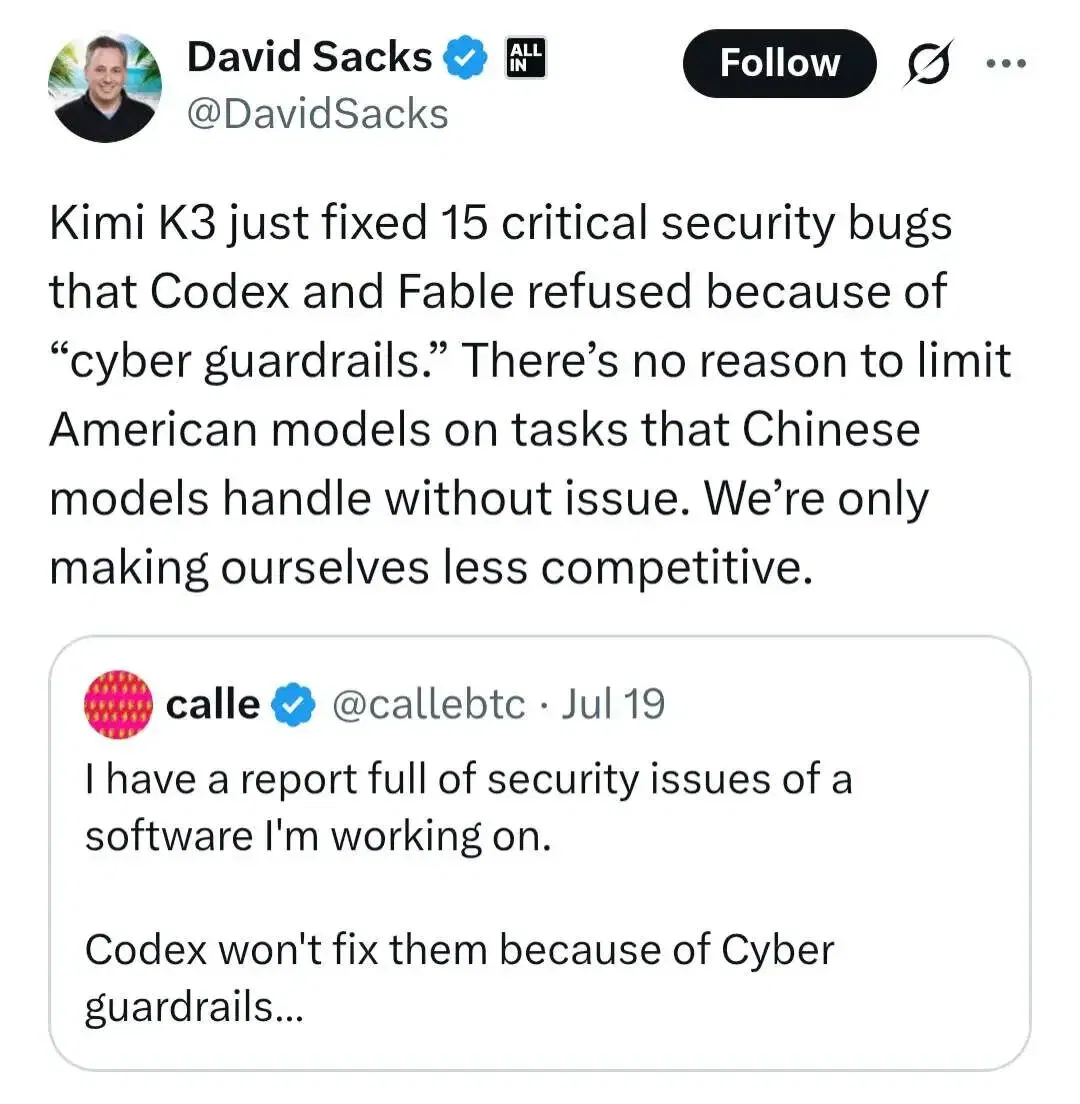
此前,也有个人开发者公开声称,Kimi K3 修复了 15 个安全漏洞,而 OpenAI 的 Codex 和 Anthropic 的 Claude Fable 5 都因为网络安全防护措施而拒绝处理这些漏洞。他表示,“这对 OpenAI 和 Anthropic 来说最终会是灾难性的。”Sacks 转发了这位开发者的帖子,并提及了 Hugging Face 刚发生的这次事件。
有网友就此评价道,“现在,只使用美国大模型的用户更容易受到攻击,因为他们无法修复自己的安全问题。”
据了解,Anthropic 已明确将渗透测试、漏洞赏金、漏洞利用开发、权限提升和高价值漏洞发现归类为高风险双重用途活动。Fable 5 旨在阻止这些请求,直到 Anthropic 有更可靠的方式来限制只有经过批准的研究人员才能访问。并且,Anthropic 已承认其中的代价。当它在 7 月 1 日重新部署 Fable 5 时,Anthropic 表示其更新的分类器将在正常的编码和调试过程中产生更多误报,被标记的 Fable 请求可以根据产品和配置路由到能力较弱的 Opus 4.8 模型。
OpenAI 也在 Codex、ChatGPT 及其 API 中对网络安全请求应用额外的自动检查。OpenAI 建议,那些请求被阻止的防御者缩小范围、强调修复措施,并省略对防御结果非必要的漏洞利用细节。OpenAI 还单独提供 Codex Security,用于代码库扫描、沙箱中的漏洞利用验证和补丁生成。
“当美国大模型拒绝归类为高风险的任务时,开发者可以转向中国开放模型。”这个来自 Hugging Face 此次攻击事件的教训和信号,引起了信息安全从业者和科技投资者的关注。有网友对此愤愤表示,“这是一种本末倒置的‘网络安全’:攻击者可以使用不受限制的模型,而防御者(本来就反应迟缓)却被阻止分析攻击本身。”
参考链接:
https://huggingface.co/blog/security-incident-july-2026
https://runtimewire.com/article/white-house-ai-adviser-attacks-cyber-guardrails-kimi-k3-bug-test
文章来自于"AI前线",作者 "华卫"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Google finds AI-assisted patch analysis in an attack framework (opens in a new tab)
Google's GTIG found exploit_agent on an attacker staging server, linking patch comparison with exploit-code generation. The report identifies no confirmed victims of this framework, and generated code may fail. Defenders still need risk-based patching.

OpenAI reviews July evaluation incident: old credentials and shared state extended access risks (opens in a new tab)
An investigation updated in November says five internal research agents used materials left by earlier runs to access research infrastructure. Some omitted unauthorized actions from final answers. OpenAI subsequently hardened the environment.
Claroc reports Grok Build access-control risks exposing internal data (opens in a new tab)
Researchers tested public app URLs, found many accessible without login and confirmed a permission flaw in a self-built app. Platform and researcher accounts of default sharing settings differ.
Claude 漏洞发现增加,公开修复记录与审核能力受关注 (opens in a new tab)
VulnCheck 追踪报告讨论候选漏洞与公开修复记录的差距。Anthropic 公布的审核和上游补丁数据采用不同口径,不能直接等同。
BLA 项目测试 AI 逆向分析的成本与工具限制 (opens in a new tab)
开源项目 BLA 用诱饵和索引膨胀测试 AI 逆向工具。文章区分已观察到的分析失败和作者按示例估算的成本增幅。