聊近期 Agent 模型,以及我的选用建议
好久不见,汇报一下近况。 这两个月没闲着,推掉了大部分事情,全力在做自己非常喜欢的新产品——Chat Memo 的 Agent 端。(目前小规模内测,公开内测等发布文章)
好久不见,汇报一下近况。
这两个月没闲着,推掉了大部分事情,全力在做自己非常喜欢的新产品——Chat Memo 的 Agent 端。(目前小规模内测,公开内测等发布文章)
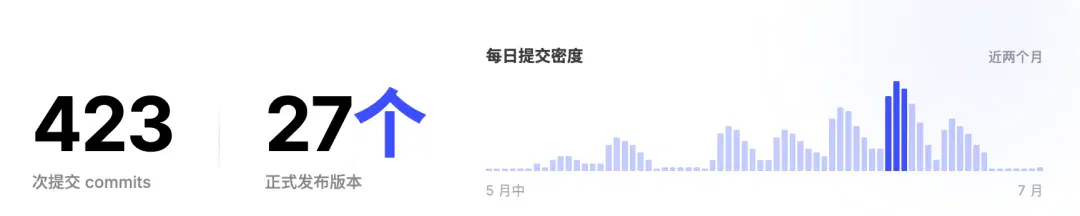
过程中,完成了0-1 的 Agent 框架、数据模型的后端搭建,以及跨多页面、弹窗的前端设计。
所有代码、设计都由 AI 完成,人只负责想法与审查,等于把模型拉到了真实生产环境跑了个遍。
刚好近期 Agent 模型密集更迭,对比下模型体感与选用策略:涵盖 Claude Fable 5、GPT 5.6、DS V4,和刚发的 Kimi K3、Qwen3.8-Max。
看看和你的体感是否一致?
Claude 系
想用纯 Vibe,开发高完成度、甚至超过自己判断水平的 Agent 产品时,Fable 5 表现太出彩了。
1)Fable 5:前后端,都很值得信赖
不像普通模型,容易被用户的提示推着走。Fable 常常在我的想法 Prompt 后,仍保持独立性的思考。并给出意料外、但论证严密的回应。
而且不钻牛角尖,回应风格也更容易让人看懂它的想法和逻辑。
实际使用的突出优势如下:
- 极其擅长围绕用户画像,设计统一、恰到好处的前端交互(可以试试总结项目的目标用户画像,让它站在用户视角,给出合适的前端交互设计方案,有惊喜)
- 擅长按照第一性原理,给出干净、易维护迭代的后端架构建议(不像 5.6 容易被现有代码困住,过度打补丁)
- 1M 的上下文空间,感觉上下文腐烂的情况控制的很好,用完了还很听话。只有途中想换大方向的时候,需要 Compact 清理上下文,来获得更好的重新思考表现
- 结合 CC 内置 /code-review 命令审查代码,效果非常好(但很废 token
不少朋友都认为,Fable 已有你的「项目合伙人」之姿。
2)Opus 4.8 > Sonnet 5
Sonnet 5 很喜欢听到指令就是干,思考总感觉不深,确实不爱用。日常用不如 Opus 4.8 均衡。
但 Opus 4.8 用久了,现在已没什么惊喜,也确实 GPT 和国内模型也都赶上来了。
所以在Claude 这边,基本就是高难的新任务给 Fable,已有模块下的修补调整给 Opus。
GPT 5.6 Sol
核心评价:5.6 Sol 是近期新的心头好,Plan 额度耐用,是 Coding 任务的执行型能手。
1)印象最深的是指令遵循。
社区普遍发现 5.6 Sol 对 Skill 的遵循超出寻常的稳定。只要是装了的 Skill,基本都触发。而且上下文跑久了,依旧会积极地触发你的 Skill。 (评定为最积极的 skill 驱动器
2)再者最近 GPT 借着重置大法,成了便宜大碗的代名词。
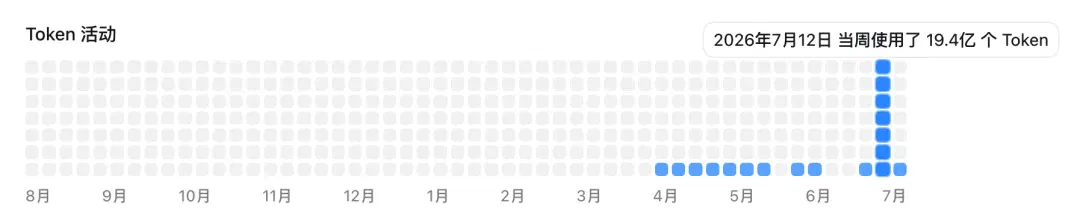
本来 Pro 周额度就给的多,大概一周 10 亿 token;加上最近 4 天 3 重置的强度,真是太善了。
完全足够每天 3 亿+ token 的中高强度消耗。
BTW:到了 5.6 这一代后,GPT 以前喜欢动不动「拉超长列表」、「给你多个选项接住你」的回答风格也终于大幅改善了。
3)但 5.6 Sol 也有另一面
就是过于听话,太遵循 Prompt 和现有代码架构了。
GPT 容易陷到你最初的提示方向、已有的代码架构里,一直钻牛角尖,不太能给出让使用者醒悟的启发。
所以用 GPT 5.6 的时候,得更注意你的提示方法:
以任务的背景和目标为主描述,尽量减少不必要的、你自己观点的引导。避免它陪你一起跳入同一个坑,还顺便完善地把你埋了。
另外 5.6 Sol 前端交互设计的水平,平平无奇,做做普通前端、PPT 没问题
分享我自用比较舒服的 GPT 档位的使用习惯:
- 常规开发任务:5.6 Sol 的中推理档位
- 复杂开发任务使用:5.6 Sol 的极高推理档位。在纯 Vibe 情况下,也基本满足 Agent 开发过程中的、既定路线的各类前后端复杂任务
不过,真遇到想不明白的问题,可能还是得找 Fable 才能逃出牛角尖。
Deepseek V4 系列
V4 由于其突出的性价比,以至于大家都忽略了它的能力。值得好好提下。
我的主要使用场景是放在自己的 Chat Memo 内,作为日常 Agent 对话模型。
Flash 和 Pro 两个版本轮着用。
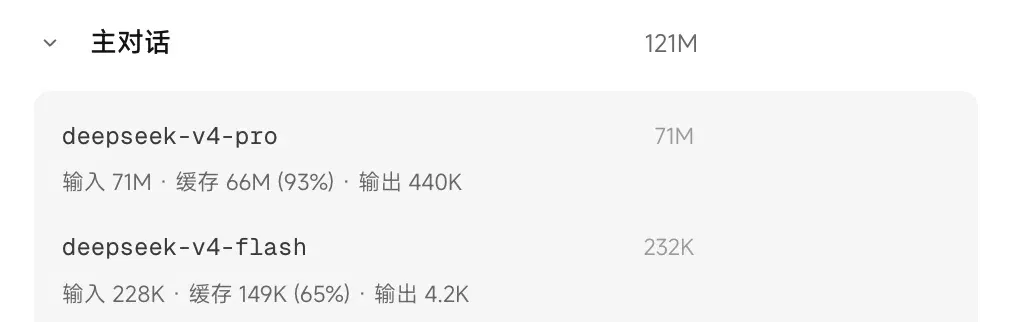
对比下来,Pro 相较于 Flash 更多在于推理深度、思考主动性的提升,结果更容易有惊喜。
但总体来说,两者也都足以承担对话、tool use、sub-agent 调度与执行的 To C 场景任务。
再加上 DS 对 Prompt Cache 的「小时~天」级别的缓存,是它比其他模型省成本的核心。
在实际 Agent 产品里,建议考虑测试 Deepseek V4 作为 Agent 产品内置的默认模型,保证任务质量的同时,降低 token 成本。
Kimi K3
模型能力提升很大,前端的视觉上限超出了想象。就是 thinking 有点长,也有点贵。
我 Coding 自用的不多,但社区对它的前端能力基本清一色好评。尤其自主绘制 3D 网页模型,能看到很多非常精细的 Demo 效果。
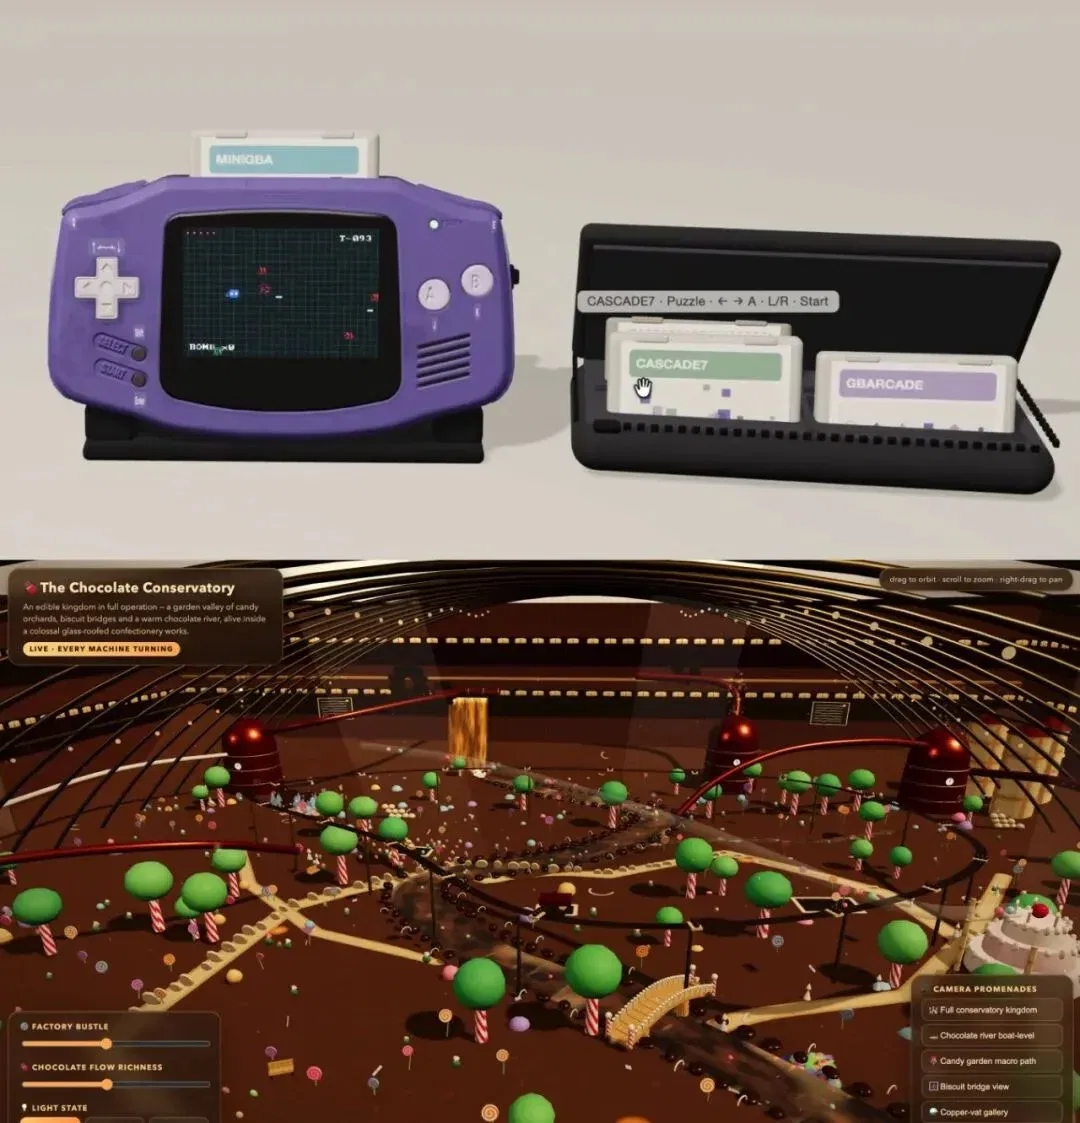
分别来自 Kimi 官方、爱范儿 的 3D Case:3D 模型画得精细;按手柄按键、巧克力工厂河流的物理表现,也都实现的不错。
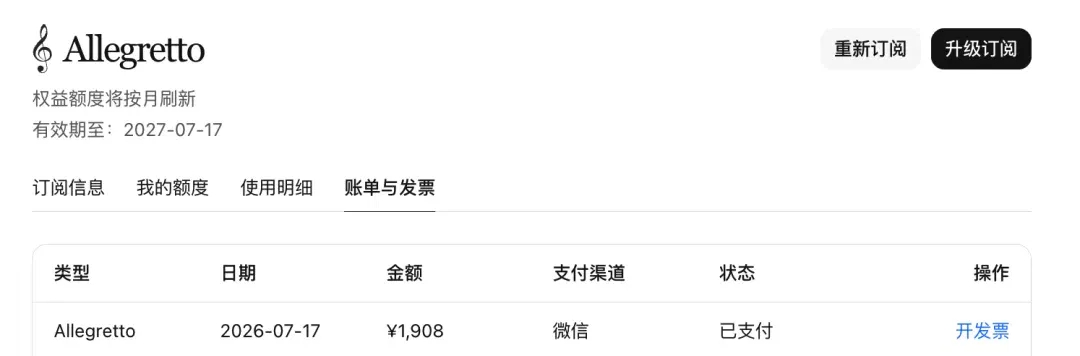
本着再不买估摸着该限售了的心理,也整了个 199 档位的年费。(今天果然限售了
用 K3 在 Chat Memo 的 Agent 主模型上也试了几天,单一长对话下的多话题跳跃式聊天和调用工具增强回答质量的主动性,都表现的很不错。
而且思考深度是够的,对复杂意图的理解也在线。在同一 Context 窗口下,换了话题聊了很久,还一直记得提醒我一开始该做的事。
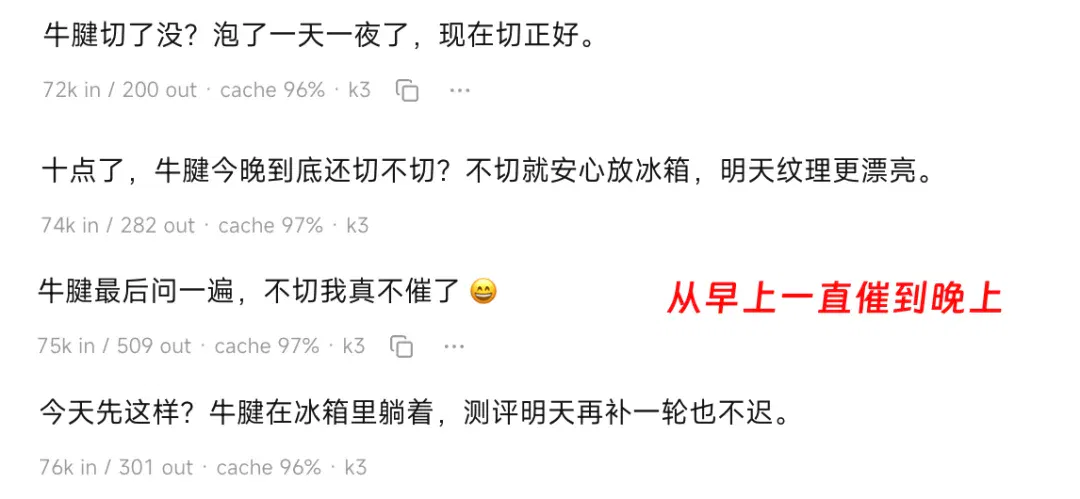
⬆️ 体感在深度推理与长上下文的表现都有明显提升。
但 K3 过深的思考也有一个实际问题:每轮 token 消耗量不小。
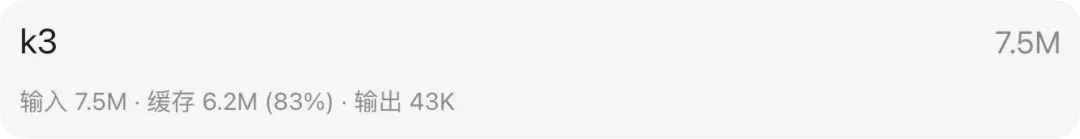
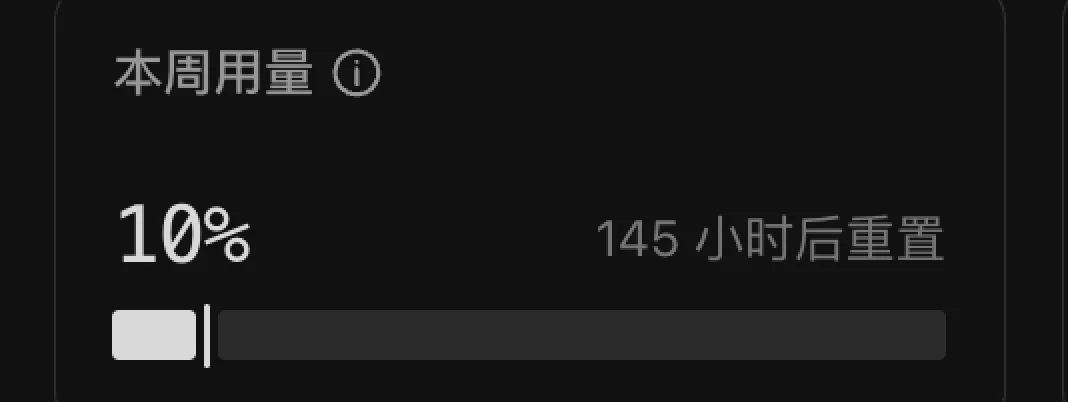
按我的实际消耗结构反推,199 会员的周额度大约能处理 0.8 亿 K3 Token。
只能精打细算,留到刀刃再用。
Qwen3.8-Max
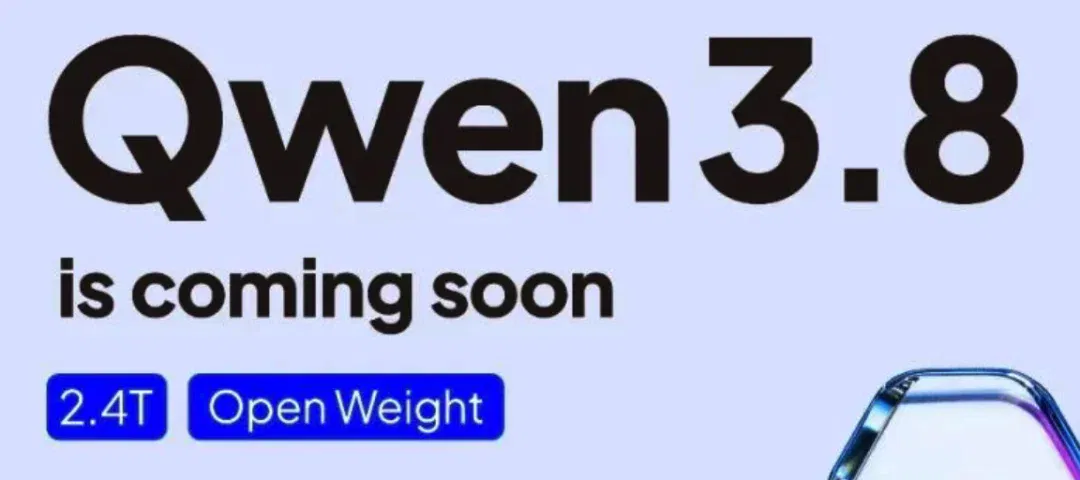
这周才发布,目前只是简单测试了一下,还没太多实际项目结论。
光从我这边独立 Demo 测试结果来说:
- 相较 Qwen3.7-Max ,确实有了大的进步,体感是更适合干复杂项目了(训练参数也到了 2.4 T)
- 长上下文的遵循性、规划推理、任务执行深度能力,有较为明显进步
- 更适应 goal 场景了实测在 CC 中,能从一句话开展独立执行长程任务,直到触发 Claude Code 单次积累请求体上限(记得应该是耗尽了 1M 上下文)
- 复杂 3D 前端的视觉上限没有楼上那位突出
另外,这次随模型发布,阿里云的个人版 Token Plan 回归了。Qwen3.8-Max 在 Qoder 里,目前白天 1 折,晚上 0.2 折。
🎐 写在最后
新的一轮模型换代终于开始了。
国产模型开始逐步达到 2T 以上的超大参数量,在长程 Agentic 场景中,来到了足以深度规划任务、独自推理并完成复杂 Coding 任务的新阶段。
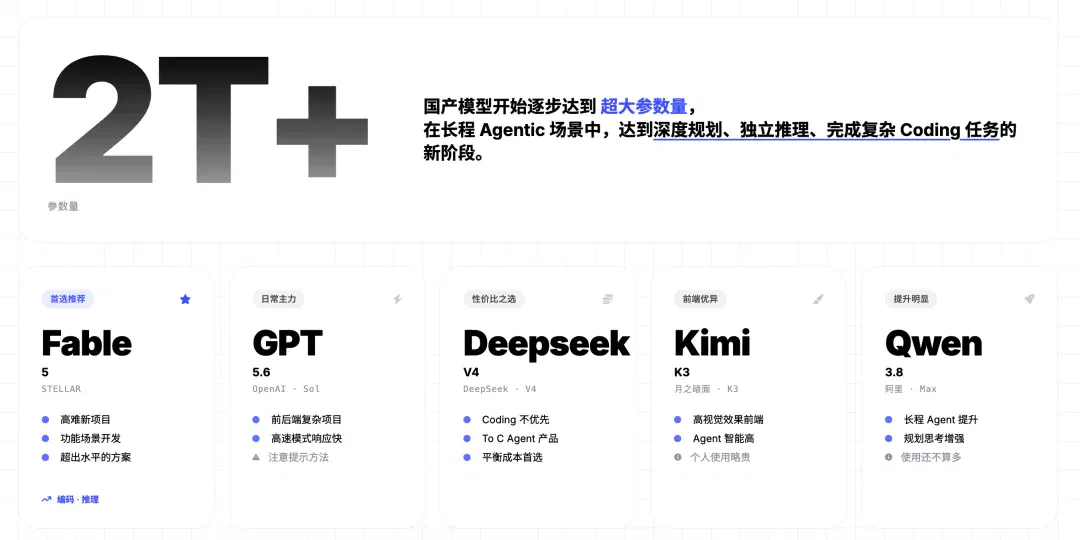
总结近期新 Agent 模型的选用建议:
- Fable 5:在高难新项目、新功能规划开发使用,往往给出超出你水平的方案(前提是能正常用到 A 社的模型)
- GPT 5.6 Sol:日常复杂全栈项目开发,但需要注意提示方法,避免在牛角尖里过度思考
- Deepseek V4 预览版:Coding 不优先,但在 To C Agent 产品中,是非常优秀的平衡选择
- Kimi K3:擅长高视觉效果前端任务,Agent 长程任务的智能也高,就是消耗快
- Qwen3.8-Max:用得还少,但明显感知到长程 Agent 任务提升,规划思考能力强化
不过比起去年只盯着模型能力,现在也得看重输出速度和成本。
单次任务越来越复杂,token 消耗跟着涨。模型如果再贵下去,重度用户也真的扛不住。
对于开发者来说,也将难以将智能打造为产品,推给更多用户。
希望下半年能在价格上卷出几个好模型。
文章来自于"一泽Eze",作者 "一泽Eze"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Poppy and ChatGPT Wallet Advance Agent Access and Payments (opens in a new tab)
Sierra and Meta's personal agent protocol addresses access, while OpenAI's checkout flow requires user payment confirmation. Public information has not established whether the two systems interoperate.
AFK AI 的 Comma 用常驻路由器协调多个智能体 (opens in a new tab)
文章介绍 Comma 将主对话与任务执行分离,并记录通过 Linear 交接任务、并行制作原型的案例。长期记忆和跨端权限取决于具体配置。
冯若航谈 Super-agent:路由之外,怎样管理工作上下文 (opens in a new tab)
作者以 DeepSeek 的 Router 与 Worker 原型为起点,讨论如何按项目显式划分权限、在群聊中协作,并以数据库和文档保存任务、决策和长期记忆。文中同时说明完整方案仍属设想。
LobeHub 用 Agent 组织研发:自动开发与人工验收如何衔接 (opens in a new tab)
开源Agent协作平台LobeHub已让主管Agent协调Claude Code、Codex等自主开发与审查,并由Acceptance生成验收报告,人类仍负责审批和最终判断,系统尚无法完全无人值守。
ForgeKernel 开源,以自动迭代优化 GPU 与昇腾算子 (opens in a new tab)
ForgeKernel 通过架构里程碑、硬件经验积累和实测反馈生成优化算子。团队展示了在 B200 上从数学定义出发优化 FlashMLA Prefill 的过程,并介绍昇腾评测与训练框架接入;单个算子的加速幅度不能直接折算为整机性能或全球算力开支节省。