突发:kimi k3悄悄上线,模型参数高达2.8T,超越Deepseek登顶开源模型全球第一
7 月 16 日,月之暗面正式发布 Kimi K3:总参数量 2.8 万亿(2.8T),原生视觉理解,100 万 token 上下文,并且——开源权重。这是历史上第一个摸到 2.8 万亿参数量级的开源模型。前任"开源最大模型"的纪录保持者?也是它自己。
过去一年,大模型圈有个心照不宣的默契:参数规模这条路上,大家突然都"佛系"了。
卷推理、卷 Agent、卷成本、卷上下文窗口……什么都在卷,就是没有一家敢再碰那个最笨、最烧钱、也最能证明硬实力的方向——把模型本身,做得更大。
直到昨天。
7 月 16 日,月之暗面正式发布 Kimi K3:总参数量 2.8 万亿(2.8T),原生视觉理解,100 万 token 上下文,并且——开源权重。
这是历史上第一个摸到 2.8 万亿参数量级的开源模型。前任"开源最大模型"的纪录保持者?也是它自己。
一、2.8T 到底是什么概念?
先给几个坐标。
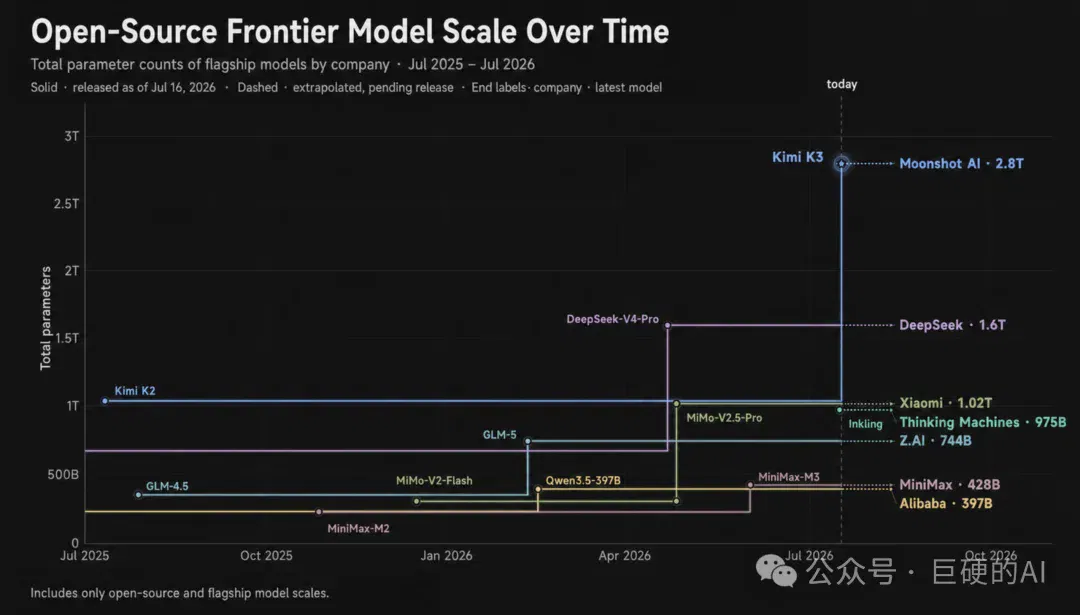
据公开报道,DeepSeek V4 Pro 的参数量约为 1.6 万亿,百度文心 5.0 约为 2.4 万亿——这已经是过去一年里最"激进"的两个数字了。而 K3 直接把开源旗舰的天花板,抬到了 2.8 万亿。
更夸张的是节奏。官方文档里有这么一句话:过去 12 个月里,有 9 个月,开源模型规模的纪录都是 Kimi 刷新的。
回想一下这条时间线:2025 年 7 月 K2 横空出世,把开源模型带进万亿参数时代;2026 年 4 月 K2.6 上线;6 月 K2.7 Code 专攻编程。一个月后,K3 直接把规模纪录翻了近三倍。
别人是一年磨一剑,Kimi 是一个月破一次纪录。
二、不是蛮力堆料,是换了发动机
参数翻倍不稀奇,稀奇的是:2.8T 的模型,居然还能谈"效率"。
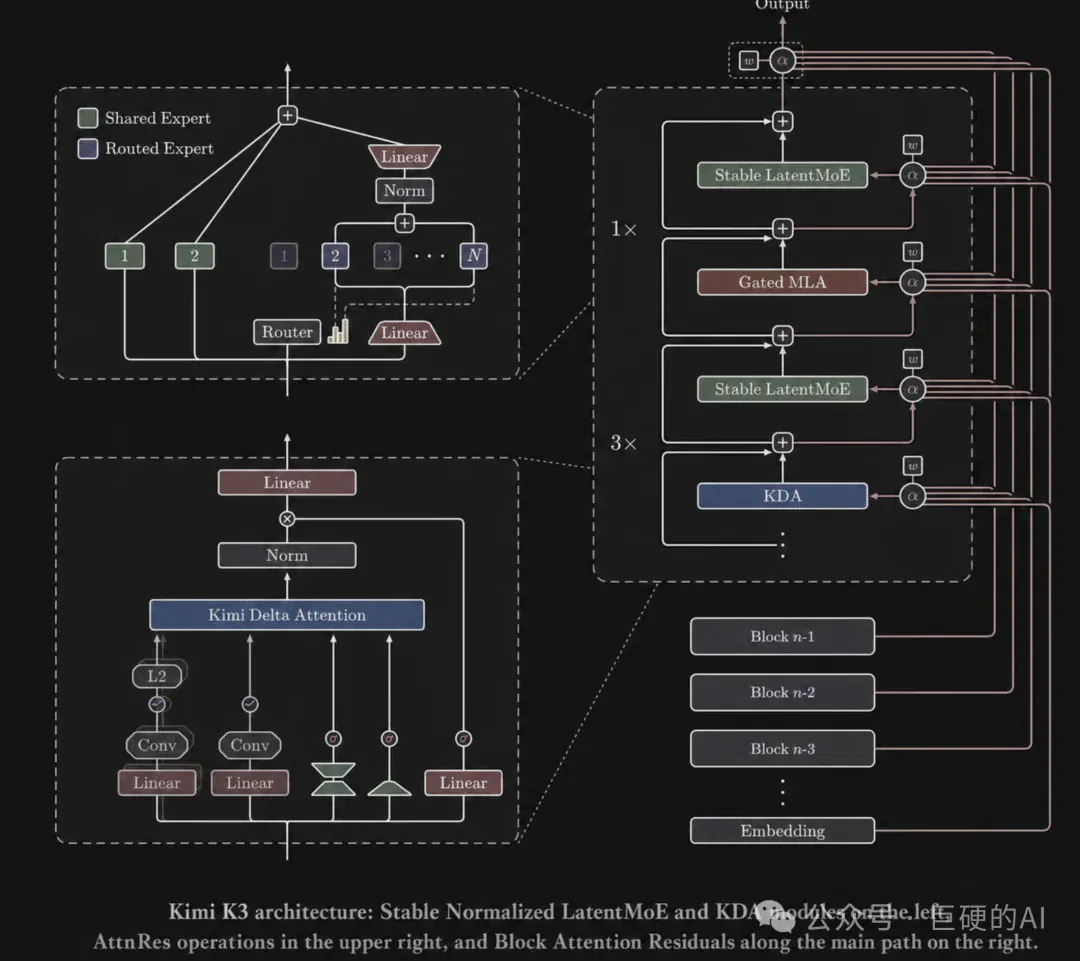
K3 的底座是两项全新的架构设计:
一是 Kimi Delta Attention(KDA),一种混合线性注意力机制,配合 Attention Residuals(注意力残差)。 用人话说,这两者的使命是让信息在更长的序列、更深的网络里流动得更顺畅——这是 100 万 token 上下文真正能"用起来"的前提。
二是 Stable LatentMoE 框架,把 MoE 的稀疏度进一步拉满:896 个专家,每次只激活 16 个。 激活比例不到 2%,但每一次都调度得又稳又准。
架构、训练方法、数据配方三管齐下,最终的结果是:K3 的整体扩展效率约为 K2 的 2.5 倍——同样的算力,挤出两倍多的智能。这才是"卷参数"的正确姿势:不是堆料,是让每一度电都不白烧。
三、成绩单:前面只剩两座大山
参数是手段,分数才是底气。官方给出的评测结论是:K3 的综合智能,仅次于 Claude Fable 5 和 GPT-5.6 Sol——OpenAI 与 Anthropic 两家旗舰中的旗舰。
拆开看几项硬指标:
知识工作(GDPval-AA v2):1687 分。 这个基准用 44 个职业、9 大行业的真实工作任务来考模型,K3 排在 Fable 5 Max 和 GPT-5.6 Sol Max 之后,领先 Claude Opus 4.8 Max(1600 分)。
AA-Briefcase(长程 Agent 知识工作基准):1527 分,全场第二,压过 GPT-5.6 Sol Max 的 1495 分。
BrowseComp:91.2 分,SOTA。 关键词是"单智能体、不做上下文压缩、不用额外的上下文管理技巧"——靠着 100 万 token 的原生长上下文,硬刚长程高难度的信息检索任务。
四、编程:长了眼睛的工程师
K3 是 Kimi 迄今为止最强的编程模型,而且强得很有特点。
它擅长的是长程软件工程任务:理解大型代码库、自己操作终端、协调工具调用、观察运行时行为,失败了还能自己爬起来重试——整个过程几乎不需要人插手。
更值得注意的是"软件工程 + 视觉理解 + 空间推理"三合一的能力:它能在源代码和渲染结果之间来回对照,看着截图、日志、测试报告决定下一步改什么。这让 K3 特别适合游戏开发、前端工程、CAD 工作流和基础设施优化这类"既要看又要写"的场景。
一句话总结:它不是"会写代码的聊天机器人",而是一个长了眼睛的工程师。
五、开发者今天就能用上什么?
和以往"先吹后放"不同,这次 API 是同步上线的,几个关键信息:
模型名 kimi-k3,OpenAI SDK 直接兼容,几行代码就能跑;
思考模式常开,reasoning_effort 当前支持 max 档(更多档位在路上);
100 万 token 上下文,上下文缓存自动开启,不用配任何参数;
计费是平价按量付费,不按上下文长度分档——用满 1M 也是一个价;
支持视觉输入(图片 base64、视频文件)、严格 JSON Schema 结构化输出、Partial Mode、动态工具加载;
max_completion_tokens 最高可设到 1048576。
六、最重要的一件事:它开源
最后说回标题里的那个"卷"字。
2.8T 参数的模型,如果只关在 API 后面,那它只是少数人的黑盒。但 Kimi 宣布,K3 的完整权重将在未来几天内发布,架构、训练与评测细节将随技术报告一同公开。
这意味着,人类历史上最大的开源模型,将从一篇新闻,变成任何人都能下载、研究、微调、部署的公共资产。
去年,开源阵营证明了自己可以追平闭源;今天,Kimi 证明了开源可以反过来定义规模的边疆。
有人把 AI 竞赛比作军备竞赛。但军备竞赛的终点是锁在仓库里的武器,而开源模型的终点,是每一个人手里的武器。
2.8T,卷得好。
文章来自于微信公众号 “巨硬的AI”,作者 “巨硬的AI”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Kimi突发K2.8:性能逼近K3,百万上下文全员开放 (opens in a new tab)
Kimi于9月11日上线K2.8 Preview模型,综合性能接近旗舰K3并将1M上下文开放至全部会员档位,作为低成本主力模型承接月之暗面快速增长的商业化需求。
秘密交表!Kimi 估值500亿美元,中国AI最大IPO来了 (opens in a new tab)
月之暗面已以保密形式向港交所递交A1文件正式启动港股IPO,估值达500亿美元,有望成为中国AI领域最大IPO。
Kimi熹妃回宫 (opens in a new tab)
在OpenAI一时半会没憋出来GPT 6的情况下,大模型排行榜被中国团队卷成麻花了。
TCSExam 测试研究级数学任务,Kimi 构造出 630 条边的图 (opens in a new tab)
姚期智、杨植麟等人的团队提出包含 100 项任务的 TCSExam。Kimi K3 在特定无短环图构造任务中将参考结果从 629 条边推进到 630 条边。
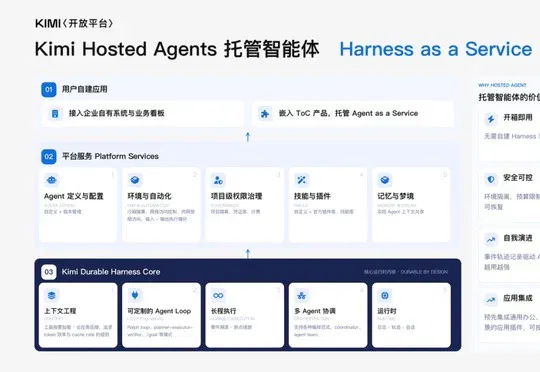
Kimi Hosted Agents 正式发布:Harness as a Service (opens in a new tab)
Kimi Hosted Agents 正式发布,以 Harness as a Service 提供7×24小时托管环境,支持长程任务、多智能体协作、安全控制、审计及140+ Skills、30+插件和8个金融Agent模板。