ClickUp 裁员 22%,同时给 AI 原生人才开出 $100 万年薪——Anita 说:每天用 ChatGPT 还不够
同一周,ClickUp 裁员 22%,同时宣布开出 100 万美元年薪的薪酬区间,专门用来吸引「AI 原生」人才。Wix、Webflow、Meta 随后也做了类似的举动。原文:How to become the AI-native hire every company wants, @anitakirkovska,May 2026
同一周,ClickUp 裁员 22%,同时宣布开出 100 万美元年薪的薪酬区间,专门用来吸引「AI 原生」人才。Wix、Webflow、Meta 随后也做了类似的举动。
原文:How to become the AI-native hire every company wants, @anitakirkovska,May 2026
Anita Kirkovska 在 Vellum AI 工作,她在这篇文章里提了一个值得认真思考的问题:在这波调整里,什么样的人会被踢出去,什么样的人会被高价留下来?
她的答案不是「会用 AI 工具的人」。这个群体比你想象中更大,但真正的「AI 原生」比你想象中更小。这篇文章梳理了这两者的区别,以及一个具体的方法论。
正在发生的组织重构
:::
Anita 引用了一篇叫《智识诅咒》(Intelligence Curse)的研究,里面总结了企业在 AI 冲击下应对劳动力的三种方式:什么都不做(靠惯性撑着)、裁掉大多数基础岗位和白领岗位来最大化 AI 收益,或者冻结所有新招聘直到搞清楚方向。
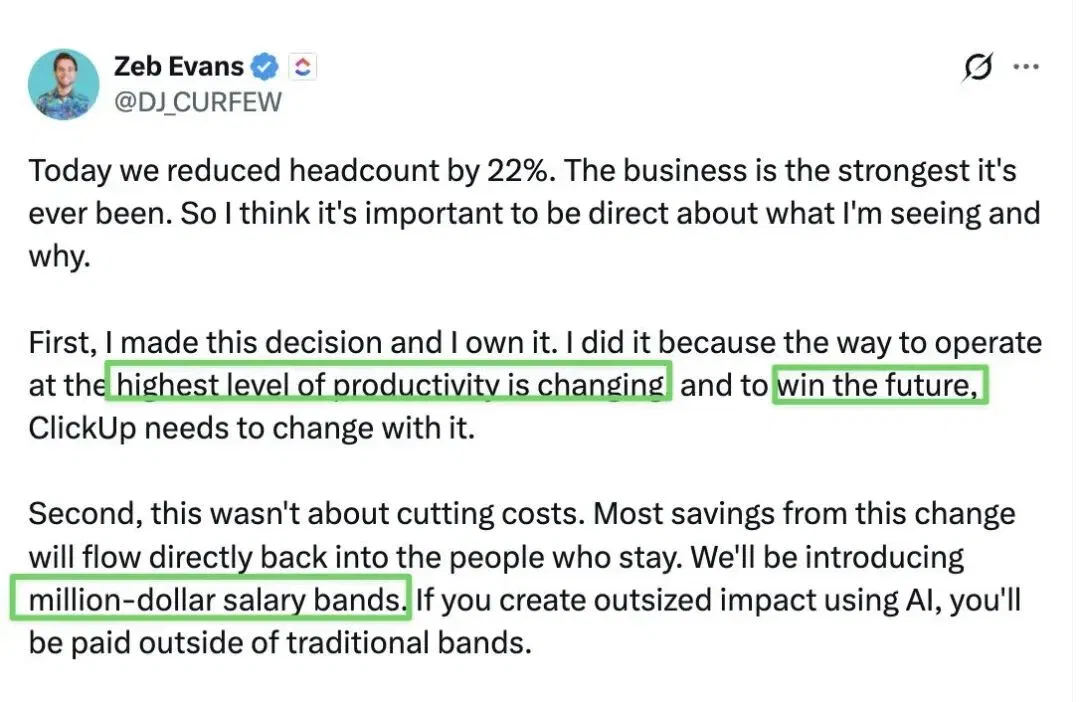
她说她现在亲眼看到的是第二种在加速发生。ClickUp CEO 公告背后有三个明确的动机:释放一笔预算用来投 AI 基础设施和高杠杆人才;以最快速度吸引市场上最好的 Agent 原生人才——100 万薪酬档位就是这个逻辑的产物;成为这个垂直领域里第一家通过 AI 重组实现爆发式增长的公司。
被解雇的不只是效率低的人,更多的是「人本身做这件事的边际成本比 AI 高太多」的岗位。基础岗位和白领岗位,恰恰是这两类里最集中的地方。
ClickUp CEO 说了一句话:「在这个现实里,要么被 AI 取代,要么成为管理 AI 的人。」这句话被重复了太多次,但配上 22% 裁员这个具体数字,它不再只是一个动员口号了。
你以为的 AI 原生,和真正的 AI 原生
:::
大多数人以为自己算 AI 原生,因为他们每天都在用 AI 工具。Anita 说,这是一个普遍的误判——而且这个误判在裁员来临的时候是危险的。
假的 AI 原生信号 vs 真实信号 / @anitakirkovska
她列出了三条「假信号」:「会提示词工程」——提示词今天已经太容易了,这根本不算壁垒;「熟悉 ChatGPT」——她原文的说法是「我妈也会用,这有什么了不起的」;「每天使用 AI 工具」——好,那你能证明你因为用 AI 变得更高效了吗?给我看数字。
这三条描述的是同一种工作状态:标签页变多了,但工作方式没有变。用 ChatGPT 起草一段文字,手动复制粘贴到文档,再让另一个工具总结,再粘贴到 Slack,再开一个工具做研究……最后,你打开了七个 AI 产品,做完了和以前一样多的事,但花了更多精力来协调这些工具之间的信息传递。
她管这种状态叫 Brain Fry:工作更多,收获更少,精神更疲惫。讽刺的是,很多团队现在的 AI 使用方式,正在让人往这个方向走。
工具多不等于系统。这是她整篇文章的核心前提。
真正的 AI 原生有什么
:::
Anita 给了四个具体的判断信号。这些信号的共同点是:都可以被验证,都不是「我感觉我挺 AI 原生的」这类主观说法。
第一,你能展示一套正在运行的 Agent 配置——Claude Code 或 Codex 的设置、Cursor 的工作环境、你的 Agent 工作流架构图。不是「我用过」,而是「这是我现在实际跑着的东西,你可以看。」
第二,你能在实时情境里展示判断力:把一个 AI 的输出直接放在你面前,你能在 30 秒内指出哪里需要调整、为什么。这考验的是你对「好的结果长什么样」有没有清晰的内化标准。
第三,你能说出三件你停止让 AI 做的事,以及原因。这说明你知道 AI 在哪里可靠、在哪里不可靠,有能力给它划边界,而不是把所有事情都扔进去再看运气。
第四,你有一个 skill.md 文件的清单,你的 Agent 正在用这些文件完成你的重复性工作。这是最硬的信号——它说明你不只是在用 AI,你在教 AI 干你的具体活儿。这也是 Anita 接下来整套方法论的核心。
skill.md 是什么
:::
一个 skill.md 文件,就是一个写给你的 AI Agent 的 Markdown 文档,告诉它「这件具体的任务应该怎么完成」。
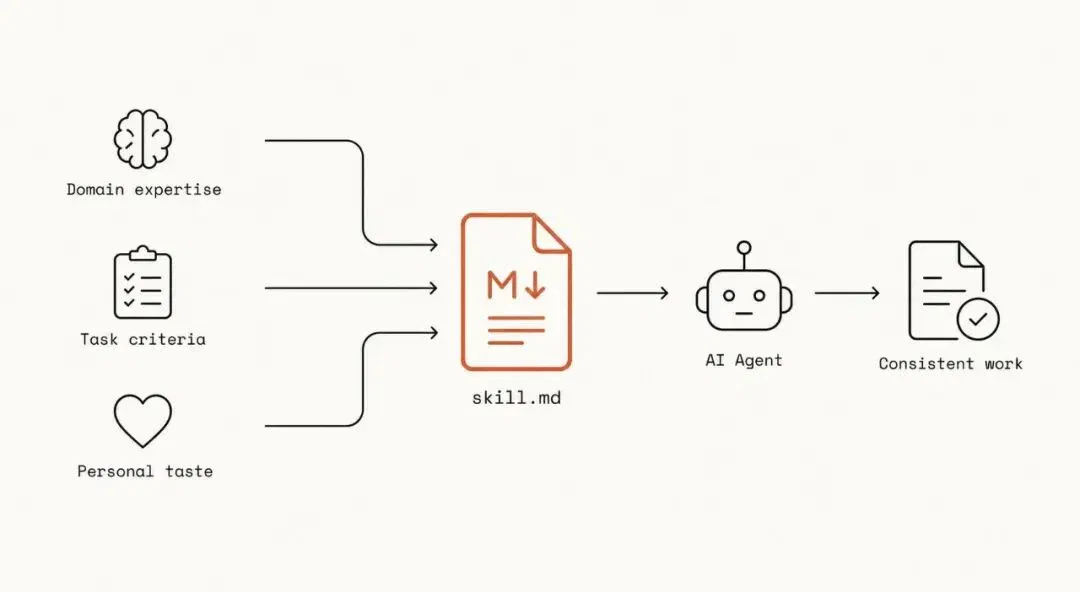
skill.md 的作用:把领域知识、任务标准和个人偏好传递给 Agent(深思圈整理)
它不是 prompt,不是系统指令,而是更像一本给 Agent 看的「工作手册」。里面有任务的定义、完成标准、你对「好的结果」的具体描述、哪些做法你明确不允许、哪些格式或语气你偏好,以及 Agent 在遇到边界情况时应该怎么决策。
举个例子:如果你的任务是每周写一份竞品分析报告,你的 skill.md 可能包含:「报告的固定结构是什么」「哪几家公司必须出现」「我最看重哪几个维度」「如果某个竞品没有最新消息应该怎么处理」「摘要部分不超过 200 字」等等。这些规则不在模型里,不在 prompt 里,而是在你的这个文件里,每次任务执行时都会被带入。
Anita 的框架建立在一个前提上:你没有办法等公司来给你建这套系统,再把杠杆递到你手上。你必须自己建,自己验证,在组织重构开始之前先把自己变成那个无可取代的人。
怎么开始建你的第一个 skill
:::
Anita 给的起点很清晰:从一件你已经经常做的事情开始。每周的竞品报告、内容 brief、客户跟进邮件、CRM 清理、提案撰写……选一件满足两个条件的任务:你已经内化了「好的结果长什么样」,而且它重复性足够高,不应该每次都完全依赖你从头思考。
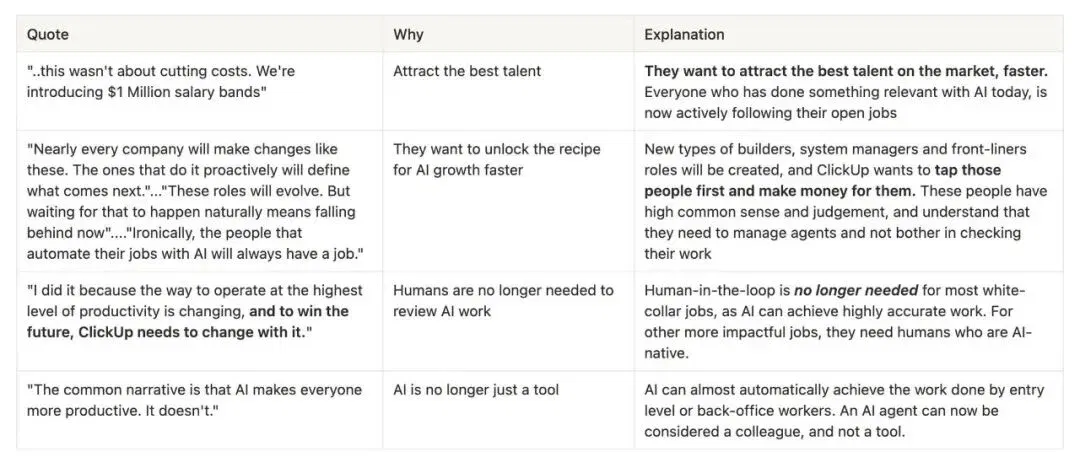
从一件具体任务开始,建立你的第一个 skill / @anitakirkovska
为什么要选你已经知道好结果是什么的任务?因为如果你自己都不清楚什么叫好,你就没有办法评价 Agent 的输出是否合格,也就没有办法给出有意义的反馈来改进。这件事是整个循环的前提。
然后选择你的 Agent。她把选项分成两类:借用现有平台上的 Agent(Claude Cowork、Codex 这类),和建立并拥有你自己的 Agent(Vellum 等需要自己配置的平台)。两类都可行,区别在于后者让你能随时间持续优化你的 skill 文件,并且那套系统是真正属于你的,不会因为换了平台就归零。
然后,写你的第一个 skill.md 文件。不需要完美,需要诚实地把「这个任务应该怎么做、什么样的结果才算对、我个人有哪些偏好」写进去。
最重要的原则:第一版必须自己写
:::
她在这里加了感叹号强调:skill 的第一版,必须是你自己写,不能交给 AI 代劳。
原因很清晰:你才是那个有领域专业知识的人。如果你把「写 skill」这件事本身也交给 AI,你会得到一个通用的、没有你真实判断的文件。AI 不知道你认为什么样的竞品分析才算有价值,不知道你对某种语气风格的具体厌恶,不知道你做这件任务十年积累下来的那些隐性标准。它只能猜。
而基于一个「AI 猜出来的 skill」产出的工作,也是通用的、没有你判断的。你花了时间和精力,但没有建立任何真正属于你的东西。这会把 Brain Fry 推到更深的层次,因为现在连你的「自动化」都是通用的。
对于技术型任务,AI 可以帮你补充 API 规范、CLI 命令这类技术细节——这部分它确实比你快。但所有的规则、偏好、判断边界,必须由你亲手定义。
第一次 Agent 的输出大概率不会好,这是预期内的。目标不是第一次就完美,而是让 Agent 犯错,然后从错误里校准。你在这个阶段的参与度是最高的——检查输出、改进 skill、给出具体反馈。这些反馈,是整套系统里价值密度最高的输入。
完整公式
:::
她把整个流程压缩成了一个九步循环:选一个好的 Agent → 找一件重复性任务(你已经内化了「好结果长什么样」)→ 写 skill.md 文件 → 把 skill 交给 Agent → 让它做工作 → 审查输出并给反馈 → 让 Agent 改进 skill → 重复到你可以真正信任它为止 → 移到下一个任务。
这个循环的核心逻辑是:你拥有领域知识,你把这个知识「教」给你的个人 AI。一个有良好记忆和学习能力的 Agent,应该能从每次互动里学到你的偏好和标准,随时间变得越来越能准确完成你的具体任务,而不是每次都从通用水平开始。
当一件任务被处理到「可信任」的程度,你可以把注意力完全从它身上移走,转到下一件任务。随着这个循环的重复,你的 Agent 系统会越来越像你的「第二个工作自我」——做你做得了的那些重复性高价值工作,解放你去做真正需要判断力和创造力的部分。
到那个时候,你拥有的是一种市场上很多人还没开始思考怎么建的东西:不是「会用 AI」,而是「有一套经过反复调教、深度反映你个人判断和偏好、持续在帮你产出的 Agent 系统」。这才是 ClickUp 那些 100 万年薪岗位在寻找的东西。
对我们意味着什么
:::
ClickUp 和 Wix 的这波裁员主要发生在美国,但「AI 重构组织」这件事不会停在美国。这是成本逻辑,成本逻辑没有地理边界,也不在乎行业。它唯一需要的条件是:AI 能把某类工作做到「够好」的水平,而这个门槛在过去 18 个月里一直在向上移动。
我自己在想这个问题的时候,觉得最难的不是「要不要建 skill.md」,而是「接受自己的工作方式需要被外化和系统化」这件事。我们习惯了知识存在脑子里,过程在经验里,「品味」在直觉里。把这些东西写出来、教给一个 Agent,是一件需要克服某种惰性的事。
但 Anita 说的那句话我觉得是对的:「大多数人太懒了,不愿意在自己的工作上认真建一套 AI 系统。」这个「懒」不是贬义,而是说这件事有真实的门槛。门槛存在,就意味着跨过去是有价值的。
如果你现在用 AI 工具的方式还是「随用随问」,没有任何系统化的记忆和流程沉淀,那这篇文章里的那三个问题是值得认真问自己的:你能展示你的 Agent 配置吗?你有 skill.md 文件吗?你能说出三件你停止让 AI 做的事吗?如果三个都答不出来,那可能不是你不努力,而是你还没有开始。
这件事的好处是:门槛是真实的,这意味着跨过去是有价值的。很多人不会去做,因为它需要时间、需要系统思考、需要把你脑子里的隐性知识外化出来。但正因为如此,做了的人和没做的人之间的差距,会随时间持续拉大。
你不需要是工程师,也不需要等公司给你这套工具。从今天手头的一件任务开始,先写第一个 skill.md,安静地建起来就好。
相关链接
• 原文:How to become the AI-native hire every company wants, Anita Kirkovska
文章来自于微信公众号 "深思SenseAI",作者 "深思SenseAI"
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Wei Xiaokang on AI talent: foundation model research, application teams, and changing organizations (opens in a new tab)
LatePost interviews former ByteDance and Meituan recruiting leader Wei Xiaokang about high salaries, fewer model jobs, and small development teams. Forecasts about employment and organizations are his judgments.
前 Claude Code 产品负责人 Cat Wu 宣布加入 OpenAI (opens in a new tab)
据报道,Cat Wu离开Anthropic后宣布加入OpenAI,参与核心产品管理。文章回顾她在Claude Code及Cowork的工作,并讨论团队人员流动;Anthropic公司收入增长不能全部归于单一产品,也不能从离职直接推断内部矛盾。
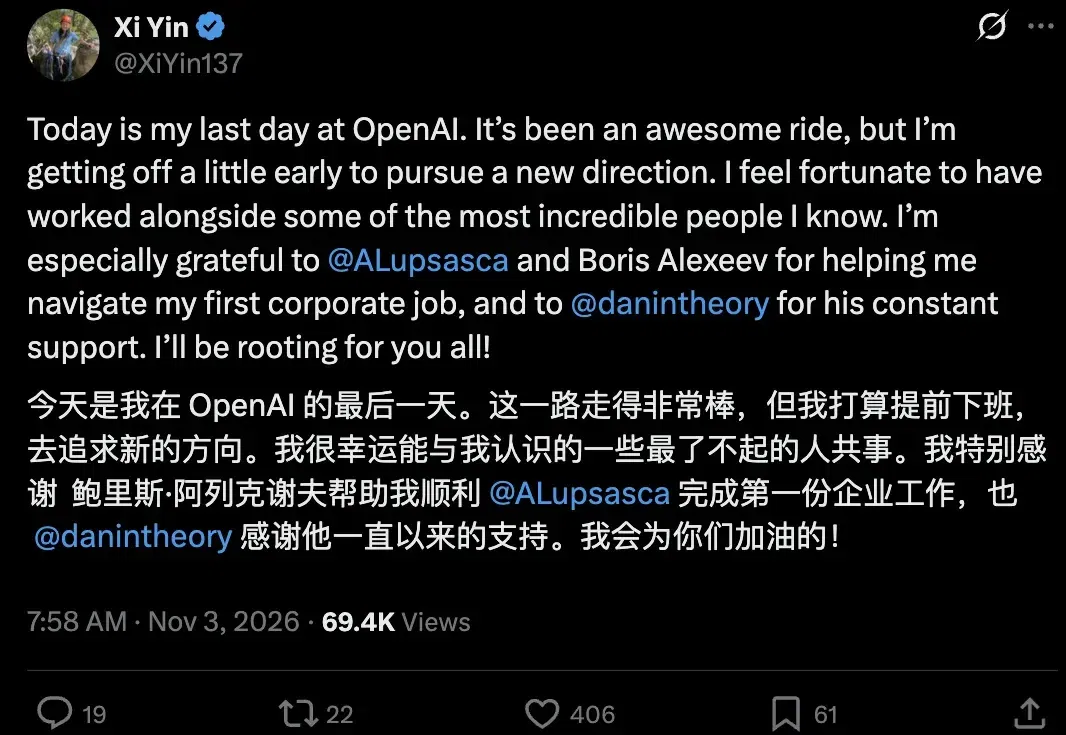
物理学家尹希宣布离开 OpenAI,下一步方向尚未披露 (opens in a new tab)
报道援引尹希告别帖,称其结束在OpenAI的首份企业工作,准备探索新方向,并回顾其物理研究及AI使用观点。离职去向未获本人披露,网友关于新公司的猜测不应作为任职消息;研究提速数字属于个人经历。
“我在Anthropic感到不安全”:一位Anthropic早期员工的回忆 (opens in a new tab)
Anthropic早期员工Ivan Vendrov在《Some Memories of Early Anthropic》中回忆,入职八个月后因AI安全使命与商业化、模型竞赛压力带来的精神重压选择离开,并质疑公司将谨慎服从的助手塑造为“受过创伤的官僚”。
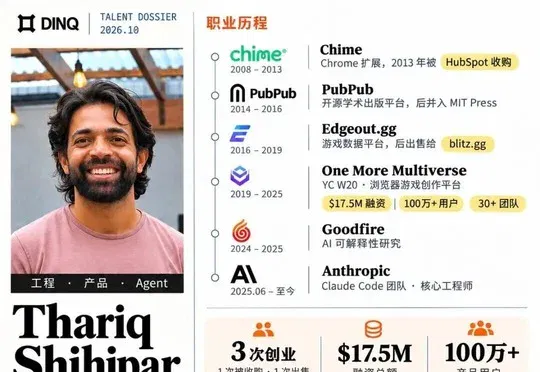
突发,Claude Code灵魂人物Thariq Shihipar宣布离职! (opens in a new tab)
Claude Code核心作者Thariq Shihipar正式离职Anthropic,并在告别信中提出“向上竞赛”,主张强模型时代应减少提示词约束、重塑人机交互并转向高密度HTML界面。