独家对话姚顺宇:请允许我小疯一下
他人生最大的一次跨步是博士毕业,毅然决然离开深造9年的物理,来到崭新的AI行业。过去两年,他先后在Anthropic和Google DeepMind出任研究科学家,参与了Claude 3.7、4.5、Gemini 3等关键模型的开发过程。
姚顺宇戴了一副茶色眼镜走过来,这副眼镜会随光线变化而改变颜色。
硅谷AI业界有两位Yao Shunyu,他们曾是清华同一届毕业生,这让姚顺雨与姚顺宇时常成为话题人物。
前一位姚顺雨2025年从OpenAI跳槽到腾讯,他去年来过我们节目;后一位姚顺宇也于同年跳槽,从Anthropic来到Google DeepMind。
这位姚顺宇毕业于清华和斯坦福大学,曾经的研究方向是理论物理——非厄米系统、量子物理与高能物理。他的人生奋斗姿态是——“总想挑战一些自己不太会的事”。
他人生最大的一次跨步是博士毕业,毅然决然离开深造9年的物理,来到崭新的AI行业。过去两年,他先后在Anthropic和Google DeepMind出任研究科学家,参与了Claude 3.7、4.5、Gemini 3等关键模型的开发过程。
姚顺宇一点也不nerd。有时,他会令你猝不及防,突然发表一点“小疯”言论。
第一次见面,他就对我说:“我在这个行业又没有什么导师,又没有什么旧友,我当然想喷谁喷谁。”
转行AI的两年,他变得越来越直接,越来越不害怕得罪人。访谈中,他也说了一些直白言论:
- “AI个人英雄主义时代已经过去了,所以也没有什么英雄,有时候甚至觉得旧时代英雄有点蠢。”
- “没有哪个老登是你的亲属,所以你觉得他傻,他就是傻,就可以直接说他傻。无所谓的啊。(笑)”
- “现在大家都是冲浪的人,本质上是那个浪,而不是你那个冲浪的人。”
- “AI这个事,本来也不太需要脑子——真的不太需要脑子——我觉得都是一些本科生就能干的活。这个行业最重要的特质,就是靠谱,就是做事细,对自己做的事情负责任。”
- “你不用太担心因为自己的观点而惹到什么人。只要你的观点是自洽的,不是说随便喷人,你是有一套自己的理解。最终你在这个领域做的怎样,是有客观评价标准的——大家是会尊重你的。”
不过,不要误会他是一个不谦虚的人。在描述自己的研究时,姚顺宇显得异常审慎。
他对于这些工作的描述是:“我自己对那个事没那么重要,更多的是,我很幸运,有机会在那个时候加入了一个重要的项目,做了一些事。”
他反复强调,AI个人英雄主义的时代已经过去了,现在都是集体主义的故事,要对神话个体的一切叙事充满警惕。
我们的节目录制于2026年3月,距离我们这次节目录制完,世界又发生了许多意想不到的变化:Meta对Manus的收购被撤销、Cursor可能被SpaceX收购、xAI将终止独立运营并入SpaceX,并更名为SpaceXAI等等。如果我们的谈话内容有一定滞后性,请大家多包涵——AI的世界实在变化太快、太出乎意料了。
可能还要特别说明的一点是,技术细节会涉及企业机密,有一些嘉宾是不方便分享的,也请大家能够包容。
在访谈中,我们尽最大可能和大家一起学习AI。你会收获姚顺宇在Anthroic和Google Gemini的技术探索历程与思考洞察。
而对于那些离经叛道的微小片刻,还请允许我们小疯一下。
友情提示:文字内容大约只占完整内容的1/3,如果要获得完整版,请观看我们的视频播客或收听播客,你一定会收获更多惊喜!
完整的播客将于小宇宙、苹果Podcast等全音频平台播出;播客视频将于Bilibili、小红书、视频号等全视频平台播出。
以下是我们的访谈节选。
“他回去之后,我们也经常打电话”
张小珺:AI业界不是有两个姚顺宇/雨吗?你要不要先给大家介绍一下你自己,并且给大家科普一下两个姚顺宇/雨的区别?
姚顺宇:我叫姚顺宇,显然也有一个跟我几乎同名的朋友(姚顺雨,腾讯首席AI科学家,前OpenAI研究员)。我们俩主要履历也有一些overlap(重叠),看起来非常难以区分。
我以前是做学物理的,本科在清华,那时做凝态理论,后来去斯坦福做理论高能物理。离开斯坦福之后去伯克利,短暂待了两个星期的postdoc博后,就离职了,去了Anthropic。在Anthropic待了一年,去年9月底、10月初加入了Gemini。
如果大家非要区分,最大区分就是,那个顺雨,一开始一直是做CS,计算机相关;我从某种意义上是半道出家,之前做理论物理为主。
张小珺:你们是不是好朋友?好像大学就认识,而且是一级的。他是一个什么样的人?你是一个什么样的人?
姚顺宇:我们本科就认识,因为我们本科在清华是一级的。他一开始就学计算机,在姚班,计算机科学实验班;我学物理,在机科班。后来他去了普林,我去了斯坦福。
这也是另一个有点令人费解的点。在普世世界,觉得斯坦福应该是学计算机的人该去的地方,普林斯顿是学物理的人该去的地方。但我俩正好反过来。哈哈。也可能产生了一些费解的事。
我俩还真的挺不一样。他是一个比我有趣的多的人,我从他身上能学习到一些和我很不一样的点。比如在AI方面,他花了很多时间思考人和AI的交互、一些产品的事。对我来说,是一个很不一样的朋友,我也从他那学到很多。
张小珺:你们之前在硅谷多久见一次面?你们现在是不是还频繁打电话?有多频繁?
姚顺宇:我们在硅谷见面确实挺频繁的,每几个星期吧。但好像见面是为了凑一块玩。哈哈哈。
真的就是纯玩。可能出去散散步,扯扯有的没的。有时候吃个饭,打个牌啊之类的。哈哈,他回去之后,我们也经常打电话。
张小珺:最近一次电话聊啥了?好像就是前一两个星期。
姚顺宇:啊,你怎么知道的?(狐疑脸)
可能会过几个月,catch up一下大家的近况吧。
张小珺:他是不是多次想把你拉过去?
姚顺宇:可能有这个意思吧(笑)。但是,我觉得不关键。哈哈哈。
多半是我自己的原因。去年八九月我离开Anthropic,决定要去哪,最大动机是我想学一些不一样的东西。对我来说,我没有更着重去考虑领导一个项目。我更多是,想优先去学习一些东西,我选择去了Gemini。
“为什么要把自己的时间浪费在伺候老登身上?”
张小珺:你本科读量子物理、博士读了高能物理,物理对你的帮助是什么?
(此处省略了姚顺宇在物理上的科研探索,完整内容请大家看视频播客或者听播客:)
姚顺宇:本科读物理最大的帮助是:第一,想问题要想清楚。读书不在于读的多,而在于读的深。读的多,不代表你能发现新东西。但如果你对一件事有和别人不一样的见解,那才是对社会来说更有价值的事。
另一件事是,别太相信纯理论。因为当时能做数值,是因为数值和理论对不上,才仔细研究那个问题。
博士去读了高能物理,这就回到了说——总爱挑战很难的事,有时候也会带来一些不好的结果。我感觉,我这个博士对自己学到很多东西、成长很大;但于这个世界,没有产生什么贡献。哈哈。
高能理论这个方向,足够难,非常非常难。但它不好的在于,不是特别可以验证,没有什么客观评价标准。因为高能理论已经发展到了实验完全追不上的阶段。
张小珺:那这个学科是怎么进步的?如果不是实验,它的进步依赖于什么?
姚顺宇:一个进步来源,来自于数学的自洽性。
比如,你提出一个框架来描述这些事,那你能和现有的已被验证的更低能标下的理论相自洽。比如说研究弦论,自然大家问题就是,弦论能不能在低能情况下回到量子场论,进而回到经典物理。
这个自洽性是一个判定方法,是很合理、科学的。当然也有一些不科学的因素,当这个领域完全没有实验、没有客观标准,肯定不会只有一个自洽框架出现。
这时候谁做的好、谁做的不好,就依赖于领域内一些老登的主观判断。
张小珺:你是被谁伤害了是吗?(笑)
姚顺宇:我也没有被谁伤害,只是在那个领域待时间越长,就越觉得这件事蠢——人这一辈子也没多长,为什么要把自己的时间浪费在伺候老登身上?
张小珺:所以是花了5年学习了很多知识,买了一个大教训。这个教训是——要做实验?
姚顺宇:要做有比较客观评价标准的事,要做对这个世界能够产生影响的事。
张小珺:你本科是比较顺利的,在量子物理这个研究领域,很快就有了非常好的学术成果,而且是范式级的变化。但你迅速觉得没有吸引力了,在博士挑战一个更难的事情。但在博士期间是比较落寞的。
姚顺宇:至少从结果来说是这样的。哈哈哈。
张小珺:外界看不出来,外界看都是非常光鲜的履历。
姚顺宇:对,从实际科研产出来说,没有人会说我博士期间的文章不好,但摸着良心说,对这个世界有多大的影响?我觉得几乎没有——没有影响,几乎为零。
对我自己来说,我自己很不满意的啊。但也没有不满意到,我会担心有人说我在混日子。确实也没在混日子,还是能达到所有外界标准。
张小珺:这是怎么做到的?——所以说,很多事情是冷暖自知对吧。
姚顺宇:达到外界的标准,或者达到一个小的圈子的评价标准,像训练模型一样。一旦有了这么一个小的圈子,你知道他们的评价标准之后,做得好是很容易的。哪怕不认可这个标准,你是可以达到的。
张小珺:有时候哪怕内心不认可,也可以蒙蔽自己继续往前走。
姚顺宇:但我后来发现我蒙蔽不了自己,骗不了自己。
博士最后两年,就会有这样的感觉。但那时确实也没想清楚,如果不做这个该去做什么?
比如说,一开始更多是去了解量子计算或者量子信息。拿了postdoc offer之后,感觉更紧急。在学校,还可以一个学生的心态。离开学校之后就是自己的career(事业),得给自己找一条路。
当时觉得,量子计算和AI是两条给小登机会比较多的路。
博士后,我到伯克利待了两三个月,官方说就只待了两个星期——我入职之前已经去那了,反正就在湾区嘛。但入职之后,只待了两个星期就辞职了。
我本来不准备入职,但伯克利人就是太好,说:没事,等事情定了再说,能来多久就得来多久。
张小珺:你告诉他们你在跟Anthropic谈?
姚顺宇:我告诉他们我可能会去做AI了,要不就别入职了。
不止伯克利,湾区这两个学校的老师都人很好,很照顾你。觉得你还没有完全谈定,还是先把工作拿着。
张小珺:物理对你后来做AI有什么帮助吗?
姚顺宇:硬实力上没什么帮助。纯工具性的技能上来说,从物理到AI的转化,是非常非常少的。但非要问的话,可能是性格吧。
做物理的人会更想刨根问底,更想理解一个事儿,更想做事很系统。因为习惯了这种很系统性的,不管是做实验的方式,还是做理论的方式。但这也不是做物理人独特的。
为什么做计算机的人没有这个特性呢?我认识很多做计算机的人,也有这个特性。很多学化学的人也有,学生物的人也有。所以不觉得它是做物理独特的。
但事实上,语言模型这种比较large scale(大规模)的AI,确实有很多物理出身的人,做的很成功。尤其Anthropic这个公司。
“智能涌现,这个话本身就不太科学”
张小珺:很多人在描述这一代AI的时候,会说是黑盒,你能用科学的角度来理解一下这个黑盒吗?
姚顺宇:这世界上所有东西都是黑盒。
哪怕像物理这种。不管是量子力学,还是量子场论,都是描述那个能标下的行为。本质上这个系统还是一个黑盒,你还是不知道它最微观的地方是什么样的动力学。
AI也是一样,黑盒不黑盒,都是相对的。我们对语言模型的理解,确实没到神经科学手术刀那个级别——不是说能理解到,这个行为是由哪一个neuron、哪一个人工神经元的哪一个激发产生的。没有到这个层面。
除非在一些很稀疏、很小的网络里,像Anthropic那个Interpretability(可解释性)团队,可能会做一些类似的工作。但在实际能用的语言模型里,都没达到这样的理解。
但也不代表完全没理解。比如Scaling Law,它就描述了那个尺度下,模型随着大小和数据量,是怎么在perplexity(困惑度)这个指标下变得越来越好的。
所以是完全没理解吗?如果Scaling Law不算是理解的一小部分,那是不是我们也说,对这个世界也完全不理解?这个世界也是一个完全黑盒。
张小珺:所以Scaling Law是一种科学规律?
姚顺宇:它是一种经验规律。但经验规律和科学规律之间的界限很模糊。
热力学那些定律——第一定律、第二定律、克拉伯龙方程——当年被发现的时候,也都是经验规律。后来随着时间发展,慢慢知道了微观机制,就变成了科学规律。
Scaling Law目前肯定还是很经验,但未来当技术变得比较固定,大家越来越多理解它微观过程的时候,会不会变成科学规律?如果这个定义存在的话,是有可能的。
张小珺:能不能用科学的表达来解释一下,“智能涌现”?
姚顺宇:这个话本身就不太科学,自然也没法用科学的话来表达一个不科学的事。
智能涌现,对我来说,它更多是一种主观的感觉,而不是客观现象。
很多人说智能涌现的时候,脑子里想的是,以前的语言模型只能做某一个方向的事,比如只能翻译、只能做分析。但现在模型好像,哎,可以做所有的事了。
但这个事,对我来说更多是一个技术上的涌现,而不是行为上的涌现。是我们通过研究,发现了该怎么去做这种大规模的训练,能够水平的提升所有能力。这才是更本质的事。
至于智能涌现,每个人心里的定义都不太一样。
张小珺:你的定义是?
姚顺宇:对我来说就是没定义。
唯一质的区别就是,有没有发生一个技术上的改变,使得我们可以做scale up,可以水平的提升所有的能力。这对我来说,是一个良好定义的事。
张小珺:你最后是在量子计算和AI之间选择了AI,这是怎么发生的?量子计算好像离你的研究主线更近一些?
姚顺宇:好处是他们都给年轻人机会。
这就是为什么要去了解细节。了解之后发现不是,是反过来的。量子计算的主要瓶颈在实验上。不是怎么设计算法或者算子,更多是怎么在实验上实现它。那个事反而是我不擅长,和我过去很多有兴趣的事比较不相关。
跟我相关的反而是AI。更多是你有一个想法,可以用一些数值去验证。这个数值在AI里面,可能就是训练一个模型。这和做物理很像。
为什么我一直爱把这个和18世纪的物理学做比较?它更像那个时代的物理。那个时代理论和实验不分家,没有什么理论物理学家、实验物理学家,你就是搞物理的。你自己可以做实验,也可以做理论推测。AI就有点像那个时代。
张小珺:你之前说现在从事AI研究像17世纪从事热力学研究,其实在表达:虽然大家没有办法很清晰从科学上去解释和理解这件事,但并不会阻止它发展。
姚顺宇:对。为什么比较那个时代的热力学?那个时代大家不理解什么是热的微观理论,不知道热是什么东西。
就像现在,大家不能理解language model(语言模型)里,哪一个矩阵元是在干什么。但是不妨碍你有好的经验定律,比如热力学的各种定律,和现在的各种Scaling Law。从这个角度来说,它是类似的。
从研究人员的角度,就是刚才说的另外一个问题:理论和实验不太分家。
“实行top down有一个很难的点,就是你做技术的决策人,必须也得是公司的决策人”
张小珺:你在Anthropic的历程是怎么展开的?
姚顺宇:主要还是有前同事在Anthropic。哈哈。
Anthropic有很多做物理出身,尤其是做理论物理出身的人。
张小珺:他们从人的选择上,为什么会倾向于选择这一波人?
姚顺宇:当然很多人可能会找一些原因说:做物理的人擅长这个或者擅长那个。但就我个人视角来看,主要原因还是connection,就是联系。
Anthropic的创始团队里,当时有三四个比较技术的人,其中有两个现在还在技术一线领导的,都是做物理出身。他们可能招的一些人也是做物理出身,就这样一直延续下来。
但到现在这个阶段,在我之后,几乎没怎么再招完全没有AI背景的人了。所以是一个时代的产物。
姚顺宇:你只找了Anthropic吗?
张小珺:没有,我还找了OpenAI和GDM,就Google DeepMind。
但Google DeepMind那时候速度太慢了。哈哈哈,最后没有出现在考虑范围内。后来Gemini获得了长足的提升,动手非常快。
Anthropic是因为当时联系了,后来我的第一任manager,第一任经理,他以前也是做理论物理的。他当时说:我们在尝试做这种大规模强化学习,有很多科学问题要去理解。那时候24年八九月的时候。强化学习还没有像现在这么成熟。
那时候大多数人都不太知道怎么做,因为o1还没发布呢。
那时候o1只是,大家都知道有,但是都还没看到结果。Anthropic当时不知道怎么做的——大体上知道,但是有很多细节需要仔细去研究。
他说:哎,有这么一个事,你要不要来面试一下?
我觉得:哎,可能是一个好的机会。
张小珺:你当时怎么认知强化学习啊?
姚顺宇:没认知,哈哈哈。
大概知道pre-train、post-train这个流程,但不太知道具体工业级别的语言模型是怎么训练的。只能知道学术界是怎么训练的。
更多还是,当时觉得这是一个不确定的事,是一个好的机会,就去干了。当然也有些面试的准备和面试过程。
面试题也不太难,反正,哈哈哈。但对我来说,当时也不知道怎么准备。就去把我能找到的那些课,自己能学的学了一遍,能做的作业做了一遍。自己手搓了一套,Andrej Karpathy有一个著名的项目,叫nanoGPT还是叫什么。手搓了一下那个,就去面了。很快拿到了offer。
姚顺宇:你在Anthropic的第一个方向是大规模的强化学习?
张小珺:有两个组的manager来跟我聊。一个是做evaluation,就是模型评测;另外一个是做强化学习。我选择了强化学习。
那时候,Anthropic也不像现在是一个大公司了,公司很小。
我去的时候,我们那个大的team才只有10个人,或者11个人。
张小珺:大team叫什么?
姚顺宇:叫Horizon。那个大team后来几乎是,强化学习的方方面面都在这个team了。
底下也有更做数据的组,更做环境、infra和基础设施的组,也有更做research和算法的组。我去的那个组,是比较偏research和算法的组。
张小珺:那时候Anthropic多少人?你一进去对这家公司印象是什么?
姚顺宇:七八百的样子吧总共。
我对Anthropic的印象还是挺consistent(一致)的。进去之后,这家公司的印象就是执行力非常强。它是一个比较top down(自上而下)的公司。很多事情决定了之后,就会全力去做。
员工之间的氛围也很好。大家都不会藏着掖着。
尤其刚去时候很小,大家都认识,氛围很好。如果是做语言模型相关的事,现在回头来看,那是一个非常非常好的学习机会。你能够接触到这个模型训练的方方面面,都能找到对应的人去问。
张小珺:那个时候的Anthropic已经有了现在我们都知道的,那个非常坚定的bet了吗?(bet coding)
姚顺宇:有的。
张小珺:这个bet来自于哪里?为什么会有这个bet?
姚顺宇:我不知道它完全的来源在哪。我自己能看到的一个显然的来源就是,前一代模型Claude 3放了之后——Twitter上那时候可能还没叫x呢——Twitter上有很多人在讨论说:Claude 3好像写code比GPT-4强啊。
那个年代,GPT-4是一个和大家gap很大的模型。能有一件重要的事比GPT-4强,就很厉害了。
张小珺:所以是试出来的?
姚顺宇:至少是其中一个原因。就是很快的对这个市场做了反馈。
这也是我觉得这公司很强的一点,它execution执行力非常非常强。一旦给它一个信号,让它觉得是很reasonable(合理的)、这公司该做的事,那就会铺上去。它没有那些大组织那种冗余。
张小珺:为什么它的coding定会比GPT-4要好?
姚顺宇:不能说,哈哈哈。
张小珺:哦,是有原因的。
姚顺宇:是有原因的。是一个纯技术原因。
但是,确实,我不能确定一开始是随机试着的,还是故意选择的。你要让我猜,我肯定会觉得是随机试着的。
张小珺:哦,纯技术的原因,是有某个人做了某个事情?
姚顺宇:是确实有某一个团队做了某个事情。
张小珺:是自上而下的,还是自下而上的?
姚顺宇:最开始可能是自下而上的,但是后来就变成了一个自上而下的事。
张小珺:就是要快速捕捉到一些内部和市场的信号,赶快要扑上去。
姚顺宇:对。这是Anthropic非常非常强的一点,它非常非常的reactive,反应非常快。
张小珺:它执行力来自于哪里?来自于Dario这个人?来自于他的某种特质?
姚顺宇:我感觉,Anthropic作为一个公司来说,它能够实行这种,就是比较top down的机制,是一个很独特的事。
实行top down有一个很难的点,就是你做技术的决策人,必须也得是公司的决策人。
首先,你技术上得能服众,才能够信服下面的研究员去做这个事;另一方面,你得是公司的决策人,你得能为这个公司负这个责任。
Anthropic有这个条件就是,它的技术上的领导人,其实是公司的cofounder。
就是像Jared Kaplan和Sam McCandlish,他们俩就是公司cofounder——他们自己做这个决定,那是人家的公司,他有权利做这个top down的事。
张小珺:Dario作为CEO,他会say yes和no吗?
姚顺宇:我不知道他们决策层的讨论里面,哈哈哈。我只能说,就技术leader是有决定权的。对我当时的工作来说,我接触的最多的就是Jared。
张小珺:这对于其他模型公司很难吗?
姚顺宇:很难。比如说OpenAI就干不了。
张小珺:Ilya在的时候难道不行吗?
姚顺宇:Ilya在的时候有可能可以。但是Ilya后来一方面,我也不知道因为什么原因,他好像就是失去了这个做决策的能力,然后他就走了。
张小珺:其他公司呢?
姚顺宇:其他公司我觉得都比较难。
Gemini也比较难。但我觉得Gemini是另外一套打法,不太一样。
就是说,大公司和startup,打法本来就不一样。因为startup重要的是make bet,就是我得赌一件事。我如果想要赌,就意味着有风险。就意味着,我能够去很快做一些决策,然后很强力推进一些决策。在这种情况下,top down是一个很有优势的事。所以Anthropic从组织上,是比OpenAI更有优势。
但是作为大公司,它可能就是另外一套想法。因为大公司的想法可能是,我不仅能尽量减少做赌的成分,而是我能在方方面面都有储备。任何一个事成了,我都能跟上。如果有事我自己做成了,我可能还能领先。这可能是大公司的心态。
所以在Gemini,Google是一个很传统的、很bottom up的组织。就是公司层面,可能有一些比较良好定义的框架,来看你的工作是好是坏,来引导你做一些公司需要的事儿。但是本质上,还是你自己来决定自己做什么。
张小珺:所以你觉得Anthropic能make bets(对coding下很重的赌注),是因为它的独特的文化、组织和文化?——这个听起来,应该是其他公司也能做的,但却非常奇怪地发现,其他公司很难做,而Anthropic可以做到。
姚顺宇:对,我觉得还是需要技术的,或者公司的leader有公信力吧。这个挺难的我觉得。
张小珺:你说的还不是CEO有公信力,是技术1号位有公信力。
姚顺宇:对我来说,我觉得技术1号位有公信力很重要。
张小珺:但与此同时,CEO可能没有成为一个阻力。这个难吗?
姚顺宇:这个就得看你这个cofounding的team,有没有足够的互相信任。这也很关键。
Anthropic这点也是在startup里,很强的。就是他cofounding team,没有一个人离开公司。如果你看他们过去,那是一群真正一起打过仗的人。
他们都是以前OpenAI的员工。他们甚至好多人都是,在一系列关键文章上的合著者。像Scaling Law这个paper,是Jared Kaplan然后Sam,当然还有Dario,还有可能Tom Brown也在吧,我不太记得Tom Brown在不在。GPT-3的paper就是Tom Brown在,Benjamin Mann在,Jared Kaplan和Sam也都在,Dario也在。
他们是一块趴过战壕的人。互相之间的信任还是很关键。
有很多公司干着干着,连小集体都团结不住了,那你怎么能指望大公司能团结住呢?
姚顺宇:你在说OpenAI是吧?
张小珺:嗯,哈哈哈。
“找到合适的环境,这个环境回馈信号足够清晰,本身也是一个很强的数据源”
张小珺:你加入Anthropic,公司正在做的最重要的项目是什么?你参与到那个大项目里了吗?
姚顺宇:当时就是为了做大尺度的强化学习,用它来提高coding的能力。这是当时最重要的事。
我们那个组的研究重心就是这个。这也是这个组后来慢慢变大、变得越来越重要的原因。最终带来的结果,就是大家一块train了Claude 3.7这个模型。
Claude 3.5有两个版本,一个可能是6月的版本,另外一个10月版本。你也可以看出,Anthropic这个公司曾经也是没啥产品能力的,居然管两个模型叫一个名字。哈哈哈哈哈。
后来外面人为了区分,管3.5后面那个版本3.5new叫3.6。Anthropic跟随着外面的习惯,就叫3.6了。再新的模型叫3.7。
实际的产品时间线,其实是——3.5、3.5new、3.7。
张小珺:怎么会有一个模型叫3.5new?这个是怎么想的?
姚顺宇:我只能说,那个时候的Anthropic,可能真的是没有什么产品上的想法。
3.5new,我几乎没参与。但是3.5new,就已经看到了coding的迹象。
张小珺:你进去的时候刚刚好就是,管理层知道了coding的迹象,要make bets的时候。你运气很好啊。
姚顺宇:我进去的时候,大家肯定已经看到了这个事儿能做成且重要,但不太清楚怎么去把它做成。我去的时候,是跟大家一起去研究怎么把它做成。
张小珺:方法是大尺度的强化学习,这里面有什么knowhow?
姚顺宇:从大的角度来说是,但有很多技术细节是需要去研究的。
哈哈哈,有好多NDA(保密协议)的内容呢。哈哈哈。
张小珺:NDA会写的这么详细的吗?
姚顺宇:原则上,员工是不能在在职期间和离职之后,透露任何跟公司内部相关的信息的。当然实际上来说就是,大家心里都有一个度。如果这个技术没有公开,肯定是不会公开去谈的。
虽然我不能公开去谈,但是,把简单的事儿做的比谁都干净,是最关键的。
张小珺:什么叫干净?
姚顺宇:就是,有很多花里胡哨的技巧。
比如说做强化学习,最简单的algorithm(算法)就是Policy Gradient(策略梯度)。但不代表这是唯一的algorithm,还有别的算法,比如各种复杂的搜索算法。
但这些复杂性是必须的吗?它们可能带来一些efficiency(效率)上的提升,但也可能带来一些基建infra上的困难。你怎么去trade off(权衡)这些事?做研究需要去理解,怎么去balance不同的因素,选择最好的、最稳定的那条路。
很多的knowhow,都在这些细节里,怎么处理这方方面面的细节。
张小珺:你们在早期怎么描述和理解coding很重要?它是大语言模型的一个分支?
姚顺宇:每个人可能想法不一样。对我来说,它重要的原因有二。
一个原因是Anthropic一直在讲的事,coding本身也是做语言模型研究的一部分。如果你能够把coding做得很好,可能会让你的研究效率翻倍提升,形成一个研究上的飞轮。这是一方面原因。
另一方面原因,是因为coding是模型使用工具和环境交互的一个很好的抽象。这个抽象的好处在哪?回归信号清晰,数据充分。很难在别的场景下,找到能同时有这两个特质的使用工具场景。
所以这是一个好抽象,在这里面做的一些研究,可能是对更通用的那些使用工具和环境交互的能力的一些有用的lesson。
张小珺:那时候Cursor是什么状态?
姚顺宇:那时候Cursor还是一个纯产品公司。
在我去Anthropic之前那段时间,Claude和Cursor都属于比较underdog的状态。在3.5new就是外界的3.6这一代的时候,首先是模型能力上去了,然后Cursor又发现,这个模型真的能够做这种Agentic coding的工具了。
张小珺:Cursor是一个壳。
姚顺宇:但是这个壳包着这个模型,一下子让公众——不是公众,是软件工程那个圈子——体会到了:哎,这事好像真的是效率工具了。后来就一下起来了。
张小珺:那时候,Anthropic意识到Cursor是未来的竞争对手?
姚顺宇:那就不知道了,该问Dario。哈哈哈哈哈。
张小珺:你参与的Claude 3.7对于Anthropic来说,是一个分水岭式的模型?
姚顺宇:对于Anthropic的后训练来说,是一个分水岭。在3.7之前,后训练都是处于一个比较小规模,可能就是修修补补模型的状态。
张小珺:大家不重视后训练吗?
姚顺宇:也不是不重视,是一开始大家很长时间都没有搞明白后训练该怎么scale up。但在那个阶段,不管是OpenAI还是Anthropic,还是中国的DeepSeek,都意识到了这个事该怎么去scale up。
就是得找到合适的环境,这个环境回馈信号足够清晰,本身也是一个很强的数据源。在这个上面能让训练非常稳定,这事就能做成。
张小珺:我记得那时,大家都不知道OpenAI的保密项目是什么,就知道它叫草莓、Strawberry。大家觉得会带来一个新的范式——后训练强化学习,但更多的就不知道了。
姚顺宇:对,我去Anthropic的时候,大家已经比较清楚,大概的方向是怎么做。
后来随着我对这个领域知道越来越多,就发现,那个时刻,OpenAI做的方式和Anthropic差别挺大的。具体这种算法,和使用数据的方式,是不太一样的。虽然都叫后训练和强化学习。但那些不是本质区别。
大的方向来说,它们是同一个——找一些回归信号非常清楚、非常客观,数据本身又比较干净,对模型来说是可学习的,在上面做稳定的强化学习训练。大的方向都是这个方向。但具体实现差别比较大。
后来事实也证明,具体实现每家方向都不一样,但是都能做成。而且当时OpenAI的目标也不是coding。
张小珺:当时我了解到的叙事是,预训练作为第一个范式,金矿快挖完了,所以开启第二个金矿,就是后训练和强化学习,让Scaling Law继续。
姚顺宇:很长时间OpenAI都是这个想法。我不知道他们现在想法有没有变。
对我来说,我的想法经历过摇摆。在3.7那个时代,我当时也抱着这个预训练已经快party is over(狂欢结束了)。就我刚入职,当时在做3.7相关的实验,我也曾经抱过这个想法。但是后来随着了解越来越深入,我就觉得,还有做的空间的。
预训练Scaling Law,它也不是告诉你要一直变大啊。它本质上是一个很系统的框架,告诉你做什么样的事是更有效的。
事实情况是,后来Anthropic和Gemini的预训练,也一直在不断进展。OpenAI自己卡了很久。哈哈哈——它应该已经重视预训练挺久了,就是最近可能刚刚有点进展。
张小珺:在你看来,预训练和后训练作为两个范式,都没有达到它的平台期?
姚顺宇:我觉得都没有。但你说要去预测到了多少,这个做不到。
到达平台期有两种可能性。一种可能性是技术本身到达了,你明明还有想让模型要干的事,但这俩技术就死活教不会了。另一种可能性是,你想干的事到平台期了。我觉得现在就是后者。
张小珺:就是说,模型是一个非常聪明的小孩,你可以教它很多东西。但我们人类作为老师,现在还不知道下一个东西该教什么。
姚顺宇:或者说该怎么去合理的教它,用现在的这些范式。
“技术的tips,是一个大家很愿意听,公司又不让你说,但实际又没啥用的事儿”
张小珺:说到Anthropic的Claude 3.7,这是几个月做出来的?
姚顺宇:林林总总,从开始训练到发布,花了四五个月的样子。
从开始大家为了这个事做研究,可能花了两三个月。后来开始训练到训练结束,中间磕磕绊绊,很多事情要处理。有很多新的基础设施,基础设施真的是很重要、很花时间。又可能花了两个月这样子。
张小珺:你在其中做的重要的工作是什么?
姚顺宇:我觉得我也没什么重要的。哈哈哈哈。
我个人对任何一个模型的贡献,我的陈述都是:我自己对那个事没那么重要,更多的是我很幸运,有机会在那个时候加入了一个重要的项目,做了一些事。
从某种意义来说,AI在最近这几年,本身是一个不可阻挡的事。它不在于你这个人去干或者不干,你不干也有别人一样能干出来。
在这个时代,所有给个人贴金的事,都有点炒作的嫌疑。但对我来说,我很幸运,能在那个阶段加入一个重要的事,学习了一些知识。
张小珺:好的,你幸运的那个阶段,在Anthropic这家公司的大尺度强化学习团队里,做了什么?
姚顺宇:3.7那个时候主要做的还是Agentic coding这件事儿怎么把它scale up,怎么去制备各种各样的环境和data,包括算法上会遇到什么样的问题。当时主要的研究都在这部分。
张小珺:这里面有什么tips吗?
姚顺宇:现在来看没啥特别有用的tips了,哈哈哈。
说到技术的tips,其实这是一个大家很愿意听,公司又不让你说,但实际又没啥用的事儿。
张小珺:哦,这是为什么?
姚顺宇:因为很多算法设计并不独立于算法,它非常强的依赖于你的基础设施。
举个简单例子,有些公司,大家经常讨论一个问题,在强化学习时候,这个sample(采样),就是给你产生这些trace(轨迹)、这些token(词元)的那个机器,和trainer(训练器),用来实际训练这个模型、改变模型权重的机器,这两个机器可能不一样。
不一样,有些原因是数值上的,有些是因为使用了异步的训练架构,所以从根本上就不一样。
不同公司这个不一样程度不一样,算法设计也会不一样。有些公司这两个difference非常大,算法最大的部分可能就是怎么控制这个,怎么让训练稳定。对于训练实际效果,权重就会稍微小一点。但有的公司基础设施建设特别好,这两个差别没那么大,就可以花更多精力在训练效果上。所以很多这种小的tips,很多knowhow,其实没什么用。
我确实也发现了,很多别的lab,不是在这三家lab里的人可能很想知道:哎,Anthropic怎么做这个?或者Gemini怎么做那个?但我有时候不愿意回答。一个主要原因是,我觉得本质上回答这个问题也是在误导他。
现代的AI训练是一个大的系统,要了解这个系统的方方面面,才能有一个全局的认识。什么事是因为什么而变得有用了,而不是说这个事本身有用。
张小珺:比如3.7上你能描述一下吗?什么样的技术性工作,在模型上变得有用了?
姚顺宇:主要还是跟Agentic coding的环境有关的工作。也有一些算法上,主要是怎么让这个训练变得更稳定。
说实话,算法上肯定是有一些提升,但没有达到特别理想的效果。比之前的算法肯定是要好的。但那个也不是我个人的贡献,是大家集体的贡献。哈哈。
张小珺:从Claude 3.7到Claude 4.5又发生什么?
姚顺宇:预训练和后训练都有。就是一个scale up上做的更多了。data,不管是data还是训练的算力,都更大的尺度了。但从范式上来说,没有特别特别大的改变。
张小珺:我每次问你,你都会说这是“集体的贡献”。
姚顺宇:嗯。这不是一个个人英雄主义的时代。
张小珺:什么时候是个人英雄的时代呢?——可能在Transformer的那个时刻?
姚顺宇:在那个技术还没到scale up那个点之前,找到了那个技术的人,可能是一个英雄。或者找到那个技术的一个小团体,可能是个英雄。
找到那个技术之后,很长一段时间,从模型侧来说都是集体主义。就是这个集体能不能一起工作,能不能为了一个目标,一起花自己的时间、自己的精力,这个是最重要的事。而不是每一个个人,提供了什么样的东西。
张小珺:说集体主义的原因,是因为能力核心是来自于AI是吗?
姚顺宇:说集体主义的原因,是因为我觉得AI这个方向本质上是简单。除了可能跳变那一下,那个idea可能得有一些很深刻的洞见。
在之后的过程中,很多想法是非常trivial(微不足道的),非常愚蠢的。谁都能想、谁都能干,只是你运气好,撞着这个机会去干了而已。
张小珺:包括你在描述Anthropic做coding,好像它也是某种随机性,但是你要抓住它。
姚顺宇:对,但是我觉得做coding,可能比做模型侧的这些技术,还更稍微有点公司英雄主义。就是,你能不能足够快的赌这件事。那确实还是Anthropic很强。
张小珺:但如果今天没有Anthropic做,可能别的公司也做了。所以都是AI在涌现能力,只是看你能不能抓住那个能力,不管是公司还是个体。
姚顺宇:我觉得是的,是一个必然的事。
在可用的语言模型、大尺度的语言模型出现之前,很多事是一个非必然。就是有没有一个人能够发明一个东西,一个语言模型能够大尺度的做训练,以及GPT这个范式能不能被发现出来,是有很多不确定性。
但是比如,如果没有Google Brain,那可能Transformer就不会被发现,可能要过很多很多年,另外一个有钱又有人的组织才会发现。那可能是一个很大的影响。
但进入那个阶段后,尤其到现在已经反过来——任何一个组织想要停止AI进展,是做不到的。
Anthropic很担心AI安全,那Anthropic有没有这个能力阻止AI发展?你停止发展,别人会发展,你的话语权还会变小。现在更多是这种状态:世界在推着我们前进,而不是我们在推着这个世界前进。
张小珺:感觉未来我们会更加难以阻止AI。
姚顺宇:哈哈,我觉得已经阻止不了。
试图去阻止AI里的一件事发生,可能本身就不是一种正确的想法。
张小珺:刚才聊到创立Anthropic一个很重要的动因是AI安全。现在这家公司跟AI安全有什么关系?
姚顺宇:现在的关系比较复杂。一个自然的问题是,大家可能会问:一个做AI安全的公司,为什么现在开始训前沿模型了?
Anthropic的解释是说,我首先得拥有一个最前沿的模型,才有话语权来推进我的AI安全。
它一直以来的想法是,我要做这个世界上最好的模型,大家不得不听我的,来推进我的安全政策。但从我个人角度,这个想法非常幼稚。这个事现在看来,是不会发生的。更有可能发生的是,大家都有很好的前沿模型,而你没有办法阻止任何事发生。
如果真的想要避免AI带来一些危机,什么才是一个更自动化的事?
举一个自动化的例子:核武器也是一个大家觉得可能有毁灭世界力量的事,但核武器最终受到控制的方法,就是Multiparty Control。
这个世界上,大家有很多个有核武器的国家,互相都有毁灭对方的能力。通过这样一种制衡才稳定住。
我觉得要阻止AI干一些不好的事,最终可能需要一种类似的机制来实现。而不是寄希望说,一家公司制定一个法律来干一件事。
张小珺:你刚刚也提到,Anthropic有个可解释性团队,它的可解释性到达哪一步了?
姚顺宇:在一些比较简单、稀疏的神经网络里面,它们能够做一些有趣的研究。
比如:哎,看看某一个输出了,或者输入的文字或者图片,它内在的表示是长成什么样的?然后把那个表示反一下之后,它会能输出一个什么样的东西。做一下这样的研究。
张小珺:到你离开Anthropic的时候,它已经多少人了?
姚顺宇:接近2000人了吧,扩了一倍多。
张小珺:你在Anthropic的时候 ,刚好是它最剧烈转变的一个时期。
姚顺宇:我可能是踩在了它还是个小公司的尾巴。进去之后过了三四个月,公司人一下就变多了。
张小珺:文化有随之改变吗?
姚顺宇:还是经历一些比较混沌的阶段吧。尤其在我快离开那段时间,文化上经历了一些混沌。因为从外面来了一些人,跟本来的文化有些冲突。
之前比较简单。更像是一个小作坊。大家都是朋友,大家都知道对方在干嘛。
也没有人特别会做过多的个人宣传,做一些没有用的事。大家都有很多事要处理。公司那时候紧迫感也更强一些。后来人多了,文化肯定会受到一些冲击。
张小珺:人多带来了什么风气?
姚顺宇:确实有一些人我个人不是很喜欢。当然不代表他们真的不好,只是我个人不是很喜欢。
我不太喜欢在这个领域里面说很多话的人。
Idea is cheap。想法是便宜的。
很多想法,显然所有人都知道。难的是怎么把它变成一个一个小的、可实现的步骤,做出来。我
不太喜欢那些一天中很多时间花在Slack——Slack是美国用的一个办公软件——在那讲一些大道理。没啥用。哈哈哈。
“AI的本质是简单的”
张小珺:你后来为什么从Anthropic突然离职了?酝酿了多久?
姚顺宇:当时酝酿了一个多月吧。
一个方面是,我不是太特别认同Dario反华这个事。他个人做什么样的观点都无所谓。但作为一个公司CEO,把这个观点推到这么极端的地步,是一个非常情绪化的体现。这是一个比较小的原因。
大的方面,像刚才说的,公司文化上有些冲击。
我自己也想去学些不一样的事情。Anthropic毕竟非常专注。如果你很想做和语言模型相关的方方面面,做这种使用工具、Agentic、coding这种事,在Anthropic很好,能学到很多东西。
但Anthropic有很多不做的事,比如完全没有人做多模态生成,你想学没地儿学。Anthropic可能也没有花太多精力在更底层的工程基础设施上。想要学习更多的东西,也是当时离开的一个动力。
张小珺:你这个选择也很神奇。大多数人在一个公司还是underdog的状态加入,会更有感情,愿意陪公司走更长时间。但你反而跳去了Google。
很多人一进Google,会觉得Google给的scope(管理范围)不够,反而想跳去像xAI,或者Anthropic这样更小一点的组织。你这个行动好像也是反的。
姚顺宇:我觉得取决于你自己想要的是什么。如果你很想要的是,我有一个很明确的scope,我一定要把我的一个想法送到这个模型里去,那Google是一个很差的地方。因为有那么多研究员,那么多已经成熟的组织,做这件事情有很复杂的过程。
但如果你想要的是有研究的自由、探索的自由,想从更广泛的人类学习,这个世界上可能找不到第二个比Gemini更强的地方。还是取决于你自己想要什么。
但我觉得很多人不管从哪离职,换到另外一家之后,会觉得不开心的主要原因,是因为没想明白自己想要什么。比如说你要是到了Google,刚开始想的是要有研究自由,更多的动机是学习。去了之后,发现还是想要有产品impact(影响力),那可能就会很难受。哈哈。
张小珺:你刚才还提到一个观点是,“AI本质是简单的”。你能不能描述一下这句话?——这是一个结论?
姚顺宇:这甚至不是一个结论,这是我的一个statement(陈述)。它可对可错。
我对这个陈述的解释是,它本质上简单的点在于,它能做实验。它和本质上难的东西,比如物理,区别在于,那个东西你没有能标下的实验数据,就是理解不了那个能标下的理论。
但AI不被这个所bound(约束),你理解不了没关系,也可以往前发展。而且事实就是,能够做任何我能想到的实验,只是可能需要一些时间,把计算量提上来,或者把基础设施准备好。但没有什么本质上的困难。
所以我一直说,觉得AI没有给人感觉碰壁的原因是,首先很多东西你都能试,其次不是大家已经想空了脑袋、没有什么想法可以试。更多的是有太多想法,得一个个试,花时间。
而且很快,可能AI就会开始自己做实验了。
张小珺:很快是多快?
姚顺宇:未来的6-12个月,AI就会自己做实验。
当然这话不太良好定义,sorry我说了一个很模糊的话。AI自己提高自己,或者自己来加快自己的发展过程,这件事其实已经在发生。就像刚才最早聊过的,它已经开始帮我们实现一些想要的东西,加快实验的速度。
张小珺:它目前还做不到的是什么?
姚顺宇:是它能不能从头到尾把一件AI研究的事做完。
比如它不仅能写这个code,还能跑这个实验。跑这个实验,还能看到这个结果。看到这个结果,还能分析这个结果,知道哪儿做的不对,提出新的假设,设计新的代码,跑新的实验。
这条链条目前还没有完整。但这条链条下一步会慢慢变得完整的。
张小珺:在你决定离开Anthropic那一刻,你对这家公司未来的预期是什么?
姚顺宇:我离开的时候,对这公司挺悲观的。但后来显然是我过度悲观了。呵呵呵。
我当时悲观的原因是,我离开的时候Anthropic主要的收入来源都是API,就是卖Token。这是个差生意。Eventually(最终)就是要打价格战。打价格战你没有完整的链条,是没有什么太多优势的。
但后来Anthropic在产品方面确实有很多巧思,做了很多好的事。不管是Claude Code变得越来越好用了,还是Claude Cowork,和各种各样跟工作效率相关的事,都慢慢汇聚起来了。
你要问我OpenAI和Anthropic哪个会先死——当然就不会真的死——哪个会先变得没那么重要。我当时会觉得:哎,可能是Anthropic会先变得没那么重要。但后来首先OpenAI被Google揍了一拳,然后Anthropic自己又上道了。现在看来好像Anthropic更占优势一些。
张小珺:你后悔过没有?
姚顺宇:不太后悔。对我个人来说,动机还是想要换一个地方,提高自己。对于想做的这件事,这个选择没有什么错误。
张小珺:你也提到Anthropic的产品有很多巧思,包括Claude Code和Cowork,这个来自于哪里?
姚顺宇:我没看到Cowork的发展过程,所以不知道。
Boris Cherny。我觉得Claude Code,至少这个事的开端吧,是他自己想要做这个事,提高自己或者同事的工作效率,最后变成了一个对所有人都会很重要的事。
这就是为什么我觉得,产品经理还是目前挺难被AI取代,会有一些个人英雄主义的机会。
“从某种意义上来说,OpenAI是救了Google一命”
张小珺:接下来说说你到了Google DeepMind以后的工作吧。重心发生变化没有?
姚顺宇:还是发生了一些变化。我自己主要在做ML coding,和一些比较long horizon的事。
ML coding,主要就是想要实现这个完整的AI自己训练自己的历程。当然过程当中有很多实际的问题、细节要去解决。
大的方向上来说,大家比较有共识该怎么去做。但还是回到细节,细节上有很多要处理。比如怎么样去选取合适的data,怎么样去选取合适的回馈信号,以及它又带来新的基础设施的挑战。现在就是要把这些事情慢慢摸清楚。
像long horizon,想要能够实现,模型能够——还是那句口号:train with finite, but use as infinite(用有限的上下文训练,但用起来像无限的上下文)。
我觉得想要把这个训练的长度一直变长,可能并不是单个训练语段的长度一直变长,那不是很现实的方案。但现实的事是,你如何在有限的context下,去做更长的工作?人就是这个样子。人的context很短很短。
你现在问我昨天晚上吃什么,我是一点也想不起来了。因为它对我现在这个场景来说不关键。我选择把它忘掉。
人本质上context很短,但他能够选择性的遗忘,选择性的去retrieve(检索),把重要的、跟当前场景相关的信息再抓回来。所以说,那个可能也是一个对我来说很有趣的方向。
其实这两件事(ML coding和long horizon)有点相关、有点互补。
都在模型使用工具和环境,以及不同模型、不同人交互的这个大的范畴内。在这个范畴内,大家过去完成的那个节点,就是Agentic coding。
又是工具又是环境,环境就是这个虚拟机,或者你自己的电脑。这个事横向就会长出不同的使用场景。做AI research,就是横向场景里的另外一个场景。这个场景,不仅横向上是一个新场景,在纵向上也让事情的尺度变得更长。完成一个代码的补全,是一个很快的事。但做一个完整的AI研究,或者做一个计算机科学的研究,那是一个很长的过程。
所以说,它像一个T字形,横向有延展,纵向也有延展。
张小珺:long horizon(长时序任务)是不是还是个科学问题?
姚顺宇:有科学问题,也有工程问题。
它科学问题更多的是,怎么把不同的方案尝试一下,以更科学的方式尝试之后,来找到最后我们要走的方案。
我不能说太细的。但粗的来说,有一些方案是从pre-train的角度来说,有一些方案就是类似于sparse attention(稀疏注意力机制)。比如DeepSeek有一些工作,学界也有很多工作。
从后训练的角度,也有后训练的方案。比如像外界,你每天用Cursor这些,他们就是很强的context management(上下文管理),管理context能力。比如它可以让模型去选择:我把中间某一段觉得不重要,就扔掉了;那一段重要就存在某个文件里,到时再取回来。
这两种大的来说,都有人研究。当然具体实施细节,不止我刚才说的这些例子。这些是比较公开的例子。具体实施细节,每个公司还有自己的小秘密。
我个人花更多时间在后训练的方案上。
首先,我自己本来就没有花正式的工作时间在预训练上。预训练对我来说更多是兴趣、想学习的事,但自己没有在那上面做太多工作。另一方面,我觉得后训练的方案,更符合我自己对这个事的理解。
我对这个事的理解,就是刚才一直在说的,能不能用短的context去训练,但能做长context的事。预训练这些方案,本质上还是需要你有长context,训练需要数据里有。所以它不太符合我对这个问题的哲学。
张小珺:Gemini的长文本做得很好,这是为什么?
姚顺宇:有些技巧。
有一些让我很惊讶的技巧。哈哈哈。
张小珺:这是取决于预训练?
姚顺宇:长文本做的很好,一定是两边都有的。我只是说,预训练那边那个技巧还是挺让我惊讶的。哈哈哈。
但也有说法不一样,有些人也说Gemini 3这一代长文本反而变差了一点。
张小珺:Again,你加入Gemini的时候,感觉大家对Gemini的预期不高?
姚顺宇:我对Gemini当时预期已经挺高的了。哈哈哈。
我是去年9月底,Gemini放Gemini 3之前。业内的人,当时对Gemini都还是印象不错的。
之前一直觉得Google很有危机,在OpenAI的冲击之下。大家的感知,可能在Gemini 2.5这一代产生了变化。
因为2.5是一个明显,你能看出来Google开始上道了。当然之前Gemini 1.5,也有一些小事,某一个具体的方面做的已经算很强了。很明显它已经不是很落后。但2.5是真的一代,开始有人用的模型。反正我自己也用过2.5,用的挺多的。
张小珺:你是看到2.5去的Gemini?
姚顺宇:我去Gemini跟这没关系。主要还是我知道,Gemini大概是一个什么样的氛围。很多Gemini工程师,技术是非常非常非常强的。我是从他们身上学到了非常非常多。
但是从大家的感知来说,可能业内的人在看到Gemini 2.5之后,就已经意识到了Gemini是要赶上来了。
张小珺:当时对你来说,从Anthropic离职,OpenAI不是一个选择吗?
姚顺宇:OpenAI也是我当时的一个选项。当然还包括xAI之类的。OpenAI最后没有去的一个主要原因,至少当时来看,对它的文化是有比较大担心的。
用粗话来说,就是感觉踏实做事的人没有Gemini多,更没有Anthropic的人多。
张小珺:然后你又赶上了Gemini 3的那个转折点?Gemini 3应该对Google来说是一个很大的转折的时期是吗?
姚顺宇:我觉得从实际的效果来说,是两件事,让Gemini产生了一个大的转折,变成了一个市场里举足轻重的player(玩家)。
Nano Banana和Gemini 3——两件事连着。
如果只有Gemini 3,可能也不会有现在这么好的效果。因为当你的市占率连10%都不到,你这个模型好一点坏一点,等它传播出去就是太慢了。
但Nano Banana做到的一件事是,首先市场上这件事很爆款,大量的人去下载了Gemini的APP,然后Gemini 3又紧接着放,把这个部分留下来了。现在它变成了一个举足轻重的玩家。
没有Gemini打这么一拳,OpenAI的位置很爽。它市占率已经高到,其实模型上干点啥,对它来说可能影响都没那么大啊。
所以说对于Gemini来说,Nano Banana把量打起来,然后Gemini 3又把人留回来,是一个很关键的事。
张小珺:它有事实上抢走多少ChatGPT的用户?
姚顺宇:我不知道现在具体的比例。但是我的感觉是,Gemini可能市占会在20%左右吧。但是我确实没有仔细去检查过现在的数据。
这是从事后归因来看,这两个因素,共同促成了Gemini今天对于OpenAI的冲击。
张小珺:你从内部视角肯定能更前置地知道,内部发生了什么,Google会有这样的变化?
姚顺宇:首先就是Google的技术储备,一直是够的。组织上,后来变得越来越清晰了,有一个更好的框架让大家一起干这个事了。所以会慢慢有些进展。
从某种意义上来说,OpenAI是救了Google一命。
大家以前一直都担心,聊天机器人会不会完全把搜索取代掉。如果这个事真的发生了,Google其实很难受。但好在,OpenAI先把这个事做了,让Google意识到了这个事很重要。
但OpenAI又没有把这个事做到底,又没有把这个事做到极致,没有把search干掉。可能就吃掉了一些份额。结果,让Google自己把聊天机器人也追上来了。那现在难受的就是OpenAI了。
你要万一,比如说在一个虚构世界,有一个公司不仅做了chatbot,还一路高歌猛进、越做越好,真的一把就把搜索吃掉了,完全没有给你反击的机会,那就很难受了。
张小珺:chatbot没有吃掉搜索,是因为OpenAI干的不好,还是因为这个干不掉搜索?
姚顺宇:我觉得两方面都有。
首先,目前的chatbot这种交互方式,不会完全吃掉搜索。它比搜索强的一点是,它有很强交互性,你可以追问,可以帮你把一些很复杂的信息去浓缩。这是它很强的地方。这部分使用场景,确实会把搜索的人抢掉。
但搜索里还有一些非常愚蠢的场景,就是你有一个特别简单的事,根本不想浪费时间在聊天机器人身上。
比如我就搜买大米,一搜买就完了。我还非得去问ChatGPT,问哪个好,它还在那转圈圈,转半天,给你个链接,你再一点,再跑到网页去买。没有那个必要。所以从事实的使用上来说,它目前的形态,并不足以把搜索完全吃掉。
当然从另一个角度来说,它在聊天机器人这个事上,也没有做到登峰造极。就还真的让Google把它给赶上了。
张小珺:现在还不算赶上吧,在产品上?
投资人投OpenAI会说,他们下注的时候,是认清楚OpenAI是个产品公司的时候,它的护城河是产品和品牌。从今天来看,似乎Google还没有在这件事情上能够赶上OpenAI吧。
姚顺宇:对。
这都是我作为一个局外人、观察者的视角来说,哈哈哈。
张小珺:对,你今天是点评家。
姚顺宇:我觉得Google传统上在产品就是有点慢,是一直都比较慢。所以你说OpenAI会不会在产品上有优势?我觉得是有可能的。
Google特别擅长的一件事是什么?是找到一个极为简单的产品形态,大家都长一个样,它就疯狂给你卷技术,你就卷不过它。那个事是Google擅长的。
搜索引擎就是这样的一个事儿。搜索是一个典型的,大家都是一个框、一个键,但它就是比你搜的快、搜的比你准,你拿它一点办法也没有。
这就是为什么,感觉一直以来,Google都处于一个做的很好但华尔街都不太认可的状态。大家总觉得这公司壁垒到底在哪?——也没有什么产品的巧思,也没有什么留存的机制,但它就活到了现在。
张小珺:所以它技术好的原因是啥?
姚顺宇:我觉得还是氛围吧。以前特别重视工程师,后来特别重视研究的氛围。
张小珺:它很适合通过技术能力溢出的产品。
姚顺宇:对。
张小珺:如果从这个角度来看,OpenAI的位置是稳固的吗?现在。
姚顺宇:我觉得现在谁的位置都不稳固。哈哈哈哈哈。
AI的形态,还有很长的路要走。没有到什么终局之战这个地方的感觉呢。
张小珺:今年初,国内已经有点儿这意思了——他们觉得在争夺一个super app,super app就是此消彼长的。
姚顺宇:对。
我不理解。我很费解。
我觉得condition on聊天机器人这个事儿(把聊天机器人作为条件来构建)就是super app,那可能可以争夺一下。但问题是。你这个形态是不是super app那个形态?会不会别人,哪天出了一个完全不一样的形态,你的功能变成了那个东西一个子集?
张小珺:人类到现在只通过chatbot去跟AI沟通,让你觉得很蠢是吧?
姚顺宇:很蠢就是。
张小珺:那应该用什么去跟AI沟通?
姚顺宇:没想明白。要想明白我就干了。哈哈哈哈哈。
张小珺:你没有告诉我,Google内部到底发生了什么变化,有了外界看到的模型能力的突飞猛进。
姚顺宇:就是组织上更清楚了。尤其像预训练,现在变得非常非常清楚。谁负责什么事情,每一个节点上谁是负责人。
张小珺:以前是混沌的吗?
姚顺宇:最早的时候很乱。我没有最早在那待过,但根据同事或者我以前认识的人的描述,以前还是更混乱一些。
现在至少预训练变得非常非常清楚。加上Google一直有的比较强的技术背景,做事也比较系统。所以,预训练在Google,是一个非常非常可控的事。
它比以前肯定要更自上而下了,但它比Anthropic来说,还是更自下而上了一些。
张小珺:好像不管是自上而下的还是自下而上的,不同的文化都能work。
姚顺宇:大公司有大公司的打法,startup有startup的打法。大公司是一个完全不一样的叙事,不一样的方法。
现在Google更多的是,像这种比较确定性的事,比如预训练,已经是一个比较确定性的范式了。Google就会更像把它做成一个工程项目。Google的工程管理能力又很强,它就能慢慢把它做好。
工程项目的意思就是,你是非常非常、非常top down(自上而下)的一个组织。很清楚,我们下一阶段要做的是什么事情,然后去做这个事情。中间需要有哪几个节点被处理掉。哪怕是做研究也是说,有一个很清晰的框架,告诉你怎么去验证你的结果是好是坏,evaluate(评估)你的结果是好是坏。
这是Google很强的。在过去任何的一个大的工程项目上。所以说预训练,就是现在进入到Google的舒适区里了。
后训练当然有更多不确定性。可能后训练现在来说,还是更bottom up(自下而上)一点。大家可以更广泛的试。
“个人英雄主义时代已经过去了,所以也没有什么英雄,有时候甚至觉得旧时代英雄有点蠢”
张小珺:最近硅谷有很多neo labs出现,你怎么看这个趋势?为什么很多人从模型大厂跳出去,成立neo lab?
姚顺宇:我看不太懂。哈哈哈。
我的感觉是,绝大多数的neo lab都会死。
可能有一些lab是真的有好的人,有些lab确实也开始在做一些事。比如像thinking machine,还是在deliver一些新东西的。
但有些neo lab就是——请帮我把名字哔掉,哈哈哈。比如说XXX那个XXX,我就完全不知道他们到底要干嘛。这俩人其实已经远离这个专业好久了。
张小珺:你在AI行业有什么偶像吗?或者欣赏的人?虽然你在AI行业很短。
姚顺宇:没啥。我感觉来这行业的时候,个人英雄主义时代已经过去了,所以也没有什么英雄。有时候甚至觉得旧时代英雄有点蠢。
张小珺:你觉得谁比较蠢?
姚顺宇:这个还是不说了吧。no comment,哈哈哈哈哈。
我觉得和做物理时候还是不一样。做物理时候,还是存在着一些真的比我聪明太多的人。比如,我读博的时候那个年轻老板,Douglas Stanford,他就比我聪明太多了。
看到他,才觉得自己在那个领域也没什么用。有他了还要我干嘛呢?
张小珺:你跑到AI来降维打击一下?
姚顺宇:也没降维打击。
但反正就感觉AI这个事,本来也不太需要脑子——不太需要脑子,真的不太需要脑子。
张小珺:那需要什么?
姚顺宇:我觉得这个行业最重要的特质就是靠谱,就是做事细,对自己做的事负责任。这是最重要的特质。
你说那些东西有多需要脑子?我觉得都是一些本科生就能干的活。
张小珺:可是你说AI没有个人英雄主义,现在一个AI研究员的价格炒的多高啊,跟球星转会一样。
姚顺宇:我不知道是好事还是坏事。对我个人来说,当然很高兴,我受益于这个。
但实际上来说,我并不知道这是不是一件好事。
张小珺:为什么价格会变得这么高?
姚顺宇:可能一方面是,大家觉得很稀缺吧。但实际上可能确实也没那么充足。因为训练一个人,虽然这事没那么难,但你训练一个人是需要一个环境的。
你得有那个机会去接触这件事,你才能学会这件事。你没有那个机会,再聪明也没用。过去能撞到这个机会的人,没有那么多。所以市场上比较稀缺。
但我觉得另一方面也是,对人的炒作有点过分了。
再说一次,这是个集体主义的事。
张小珺:很多公司也想招AI的人,你觉得最重要的特质是靠谱,这个有什么衡量指标?——怎么能够快速判断一个人靠不靠谱、做事细不细?
姚顺宇:每个人都有一些自己衡量的方法。我也有一些自己的trick(诀窍)。
我以前有出一道面试题。面试题很简单,就是需要这个人在24小时之内,完成一个强化学习的项目,从0到1。
我告诉他有的资源是什么样的,他自己选用什么样的模型、用什么数据、用什么样的算法,把这个模型训出来。24小时之内。24小时结束之后,他会跟我有一个小时的讨论。
这个事儿在AI时代没有那么难。没有AI时候,这是不可能的,没有人能在24小时之内把它做出来。但有AI之后特别简单,因为AI能帮你全套做。
但为什么还要做这个事儿呢?设计成这样的两个原因:一个原因是因为在这个时代,还去考察别人代码写得好不好,其实没用。绝大多数人都不用自己写代码。更重要的是,他能不能有效地利用AI。这是考察的一个方面。
第二方面是,这个事有一个陷阱,如果你全盘让AI做了,但你最后没有试图好好理解AI为你做了什么,那在一个小时的讨论里面会露馅儿——那是一个会挂人的地方。
所以说考验的另一件事,是你有没有真的和AI形成了协作,还是说你就全权扔给他?那个是我个人很看重的事,也是这个人是不是做事靠谱的一部分。
当然这个题目的设计本身,也有一些比较阴暗的巧思。为什么设计成24小时,就是为了看这个人有多看重这个机会。
张小珺:能熬夜?
姚顺宇:对,哈哈哈。如果他足够熬夜,他就能撑住这24个小时。如果他撑不住,那只能说,他可能对这个机会也没有那么看重。哈哈。
张小珺:对于比你更年轻的人,你觉得他们现在来AI,还是一个很蓝海的地方吗?
姚顺宇:我觉得纯做语言模型,已经不是一个蓝海了。晚了,末班车已经发车了。
我感觉我入行就是那个末班车啊。
张小珺:你自己未来会怎么发展?会在Google很久吗?
姚顺宇:我觉得应该不会。哈哈哈哈哈。
张小珺:这么公开地说吗?
姚顺宇:我觉得应该不会。我觉得我还是会尝试去挑战自己的。
张小珺:要折磨自己!
姚顺宇:对,要折磨自己!
但是,我可能需要找到一个,值得折磨我自己的事。
张小珺:如果AI不是本质的难的话,你会不会做的感觉无聊?你对你的挑战在哪?
姚顺宇:它虽然不难,但是你知道和不知道,还是有一个gap的。你从完全不知道这其中细节,到慢慢理解这其中的细节、理解它怎么运作的之类的,还是需要花时间花力气的。当你理解之后,是长期有帮助的。
张小珺:你未来想在哪里去发展?
姚顺宇:我觉得都有可能。哈哈哈。没想好该怎么折磨自己。
张小珺:你现在最高优先级是什么?
姚顺宇:我现在最高优先级是,把我刚才说的这两个事情,ML coding和long horizon,能够和同事一起,推进到一个比较稳定的状态吧。那是我的最高priority。当然可能之后也会有别的priority。
张小珺:你有特别崇拜的物理学家吗?
姚顺宇:有,但是有点多,不知从何说起。哈哈哈哈哈。
张小珺:物理学家有,人工智能科学家没有。
姚顺宇:这个跟人的成长经历有关吧——一个成年人是很难真的崇拜一个人的,一个儿童可能会。
物理学,还是有很多人真的挺强的。大家都说的那种100年前的人就不说了,什么爱因斯坦、海森伯格这些就不说了。包括大家后来都知道的,杨振宁这些也都不说了。像我之前做topology(拓扑)这个体系的时候,有一个后来也拿了诺奖,就是Haldane(2016年诺贝尔物理学奖得主之一)。
你会发现这些人,有异常的远见。他在他那个时代显得格格不入。
但你看Haldane,最开始做Haldane model和这些分数量子霍尔效应相关的事,离最后大家搞明白这些拓扑物态,过了好几十年。在那个时候他能够觉得这事重要,然后一直在自己在推进这事。
这是很不容易的。当然你要非要在人工智能找一个类似的人,可能Geoffrey Hinton是吧。就是在大家都觉得这事可有可无或者不那么确定的时候,他一直在这个方向做。那我觉得,这可能是一个英雄级别的人物。
可能也有一些英雄的集体。比如像Transformer,就Noam(Noam Shazeer)和那些,Ashish(Ashish Vaswani)、Niki(Niki Parmar)他们。那可能是一个英雄集体(Transformer论文的八位作者)。
张小珺:你讲过一个特别让我印象很深的话:“我在这个行业又没有什么导师,又没有什么旧友,我当然想喷谁喷谁。”
姚顺宇:这可能就是,不是AI出身的好处吧。真的没有什么负担。
没有哪个老登是你的亲属,所以你觉得他傻,他就是傻,就可以直接说他傻。无所谓的啊。(笑)
张小珺:你以前也这样吗?
姚顺宇:我觉得我做学生的时候还挺收敛的。但我后来发现收敛没用,对自己也没好处,对别人也没好处。
还是更直接,表达自己的想法是最关键的。
我觉得直接表达自己的想法,是一个短期一定会有人恨你,但长期大家会欣赏的事情。
张小珺:你最近听谁说话特别蠢?
姚顺宇:把这个名字哔掉,谢谢。
我觉得XXX一直挺蠢的。哈哈哈,而且蠢的始终如一。哈哈哈。
我觉得他说的话,就是not even wrong。因为不良好定义,你很难说他说的是对是错。
有一天,可能有一个不一样的范式发生了,他就可以跳出来说:哎,我当年说过这个这个这个这个。但你就发现,如果范式是另一种状态,他也能说一样的话。这就是我为什么很讨厌很vague(模糊)、很模糊的人的原因。因为一个事模糊就是没有意义的。
我觉得人年纪大了,不一定会变成老登的。
人年纪大了会变成两种状态:一种状态叫做德高望重,就是他少指手画脚,还会花自己的力气去培养年轻人。另一种人就是老登,就自己也不懂,还爱指手画脚。
张小珺:哎,你是受了谁的刺激啊?
姚顺宇:我也不知道我受了谁的刺激,但我确实见过不少老登。哈哈哈。
张小珺:你从什么时候变化的?就是说话更不收敛了?
姚顺宇:我过去可能也会比较直接,但是没有这么直接。但做了AI之后就更直接。
一是没有束缚,二是这个领域足够客观。
你其实不用太担心,因为自己的观点而惹到什么人。只要你的观点是自洽的,你有一套自己观点的理论。你不是说随便喷人。
最终你在这个领域做的怎么样,是有客观的评价标准的。
我觉得其实大家是会尊重你的。
“你还是高看了我的文化程度,哈哈哈哈哈”
姚顺宇:这是今天最难的一个问题。我感觉你还是高看了我的文化程度。哈哈哈哈哈。
我真的没有什么人生之书,说实话。
张小珺:好,最近读了一本书?
姚顺宇:最近读的书就是汤川秀树(1949年诺贝尔物理学奖得主)的自传,《旅人》。
首先我这人确实不爱读书,我感觉我这人文化水平比较低。我读的书,除了专业性的书之外,所有的书感觉都是闲书。像什么汤川的自传,本质上也是本闲书。但是写得挺有趣的,你能看到一个后来看起来如此成功的科学家,在他年轻的时候有一种挣扎感。很真实。
有本小说我很喜欢,《来自新世界》,是一个日本的小说。你要非让我推荐闲书的话,我可以推荐那个。
张小珺:一个全球范围内你喜欢的食物?
姚顺宇:寿司吧。
张小珺:一个全球范围内你喜欢的地点?
姚顺宇:现在你要非让我选,我可能会选夏威夷。因为我很喜欢海。但是也很难说,因为之后我可能去了更多海的地方,就另有新欢了。哈哈哈。
张小珺:一个少有人知道,但需要知道的知识点。
姚顺宇:别相信老登算吗?哈哈哈。
张小珺:你心目中影响AI进程的几篇论文?
姚顺宇:sequence to sequence是一篇。我觉得是language model,在feature engineering时代的高峰。
Scaling Law是一篇。就是Jared Kaplan,他们在OpenAI的那篇Scaling Law也是一篇。是一篇把这种体系化的研究方式,引进到这个领域的。
当然最后实际上Scaling Law做的方法,可能他那样并不是正确的,但是是第一篇把这个想法引进来的。我觉得这很关键。
张小珺:基于你当下的认知,一个关键的重要的bet是什么?
姚顺宇:long horizon。long horizon(长程任务)。哈哈哈。
张小珺:我们工作室叫语言即世界工作室。第一次听到这个名字的时候,你在想什么?
姚顺宇:我觉得这个名字有点,正常的太平庸了。
哈哈哈哈哈。哈哈哈哈哈。
这个名字放在十年以前,是一个很独特的视角,现在主要大家共识太多了——对不起我感觉我年纪也大了,可能不止十年了——可能在14、15那个年代,大家都会觉得视觉是最重要的事。在那个时候,意识到语言是承载智能的重要载体的人,是很不一样的。
张小珺:不过我们这个名字,不是在AI的语境里面讲的。
姚顺宇:嗯……哈哈哈……
那就值得深思了。
哈哈哈。
---
文章来自于微信公众号 "语言即世界language is world",作者 "语言即世界language is world"
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
投资人开始堵姚顺宇 (opens in a new tab)
“身边VC在打听姚顺宇创业。” 这位天才少年已为创投圈所熟知:清华物理系传奇、斯坦福物理学博士、顶尖AI研究员,并且才29岁。2025年9月,姚顺宇从Anthropic霸气离职,后加入Google D
物理学家尹希宣布离开 OpenAI,下一步方向尚未披露 (opens in a new tab)
报道援引尹希告别帖,称其结束在OpenAI的首份企业工作,准备探索新方向,并回顾其物理研究及AI使用观点。离职去向未获本人披露,网友关于新公司的猜测不应作为任职消息;研究提速数字属于个人经历。
刚离开Kimi,17岁的陈广宇去了Jeff Dean新公司 (opens in a new tab)
据机器之心了解,17 岁 AI 研究者陈广宇,已经加入 Jeff Dean 等人创立的 Discovery Loop 团队。
17岁天才少年陈广宇,宣布离开Kimi (opens in a new tab)
今天,曾因 Attention Residuals 论文走红的 AI 少年陈广宇(Nathan Chen),宣布离开 Kimi。
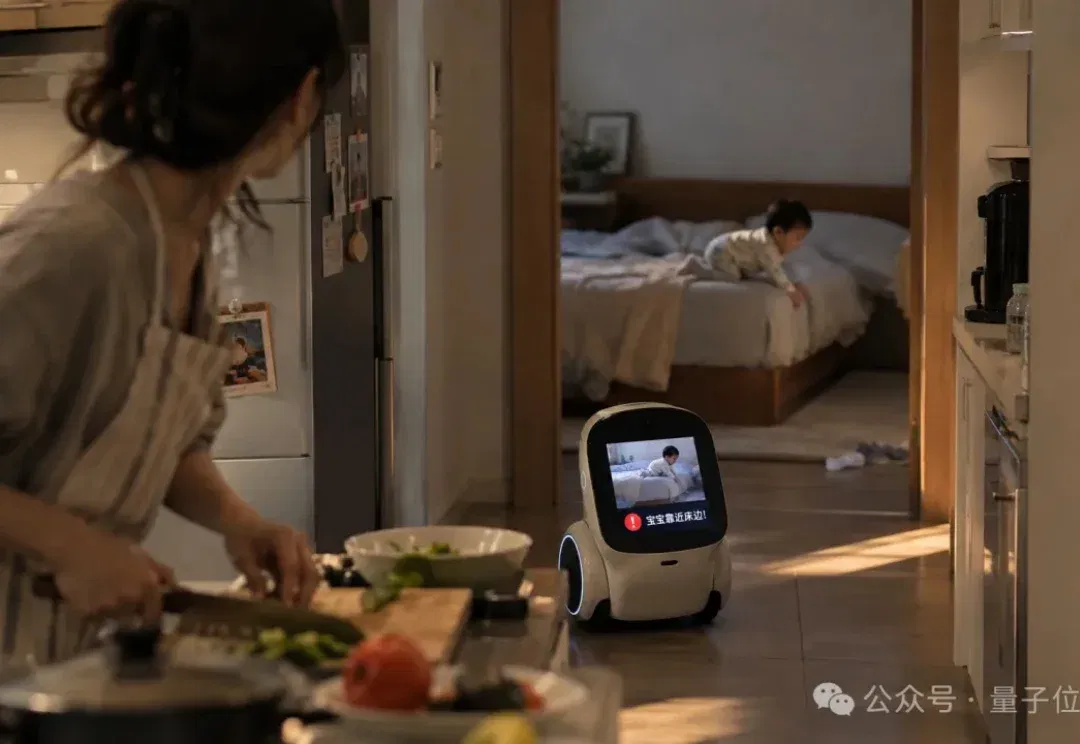
前华为小艺大模型负责人创业,押注“主动式物理AI” (opens in a new tab)
机器人开始替人操心了。 想象一下。你在饭店吃饭,结账付款正准备离开时,手表突然震动并显示信息: “你的手机忘拿了,还在刚才的桌子上!” 再想象一下,你正在厨房做饭,突然家里的小机器人发出尖锐爆鸣: “小孩快从床上摔下去了!” 你一个闪身步冲回卧室,发现家崽丝毫没意识到自己已经蠕动到了床的边缘。 △图片系AI生成 让机器有“眼力见儿”,主动发现人之所需,这是唐都钰提出“主动式物理AI”这个概念时的设想。 过去几年,物理AI主要聚焦在解决“如何更好地执行人类提出的要求”这个问题。 于是机器人走得更稳了、抓得更准了、能规划得更久了……但,这一切都发生在人类的指令之后。 能不能让AI自己去发现当下要做