即梦 Octo 来了!它想做的 Vibe Create,是什么?
一个有「审美偏好」的合作者。 2026 年以来,AI 创作工具圈出现了一个很明显的趋势:越来越多产品开始往「全链路」的方向走 ,成为 All In One 产品。 这些 All In One 产品想解决的事情,总结下来就 2 个: 第一个是降门槛,让不会用专业软件的人也能做出东西来。 第二个,也是更核心的一个,是让创作的各个节点连起来,从灵感到成品之间的路径应该是连贯的,而不是每一步都要重新开始。 即梦最近推出了 Octo,定位是一个 AI 原生的动态叙事创作工具。简单说,就是在一张画布上,从最初的灵感碰撞一直做到成片导出。 接下来,分享我们完整的实测过程。 从一个模糊的想法,到一段动漫 调研
一个有「审美偏好」的合作者。
2026 年以来,AI 创作工具圈出现了一个很明显的趋势:越来越多产品开始往「全链路」的方向走 ,成为 All In One 产品。
这些 All In One 产品想解决的事情,总结下来就 2 个:
第一个是降门槛,让不会用专业软件的人也能做出东西来。
第二个,也是更核心的一个,是让创作的各个节点连起来,从灵感到成品之间的路径应该是连贯的,而不是每一步都要重新开始。
即梦最近推出了Octo,定位是一个 AI 原生的动态叙事创作工具。简单说,就是在一张画布上,从最初的灵感碰撞一直做到成片导出。
接下来,分享我们完整的实测过程。
从一个模糊的想法,到一段动漫
调研和灵感碰撞
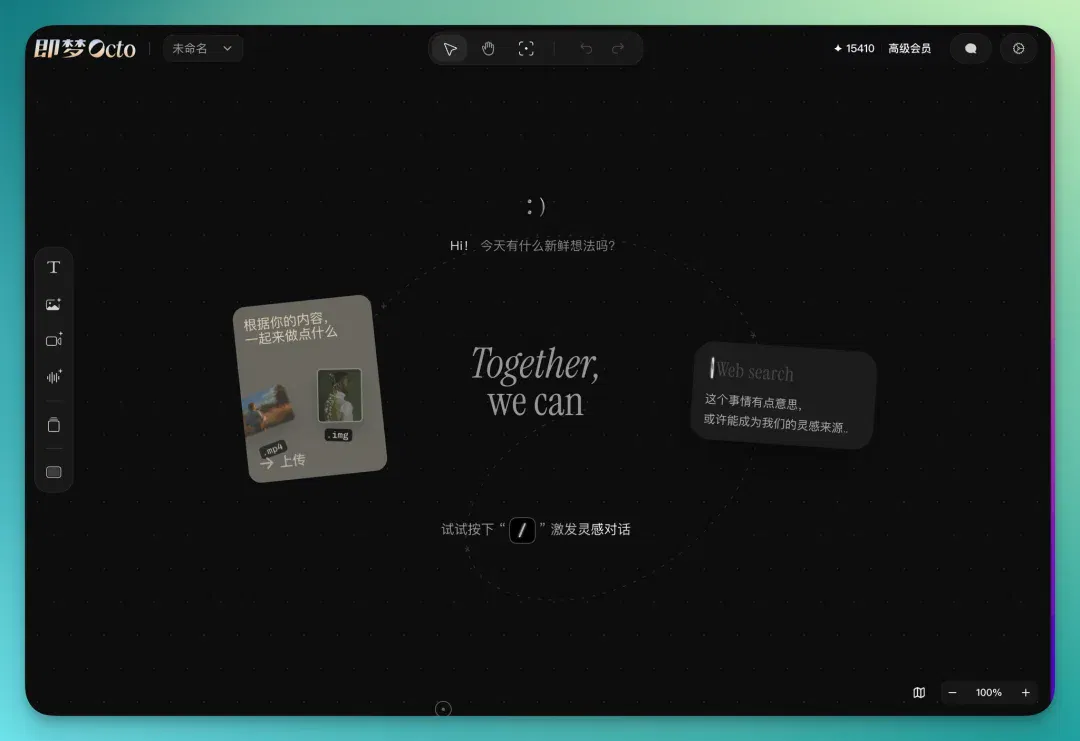
打开 Octo,进来就是一张空白画布。
我一开始只有一个很模糊的方向:想做一个昭和年代暗黑风格的短片,画面氛围要像押井守 1985 年那部《天使之卵》,并且要有 3D 人物,有矛盾感。但具体做什么故事、什么角色、什么结构,完全没想好。
在画布空白处按了一下 / 键,弹出了对话框。这是 Octo 的主要交互入口,任何时候、在画布的任何位置,按 / 就能跟它开聊。
我先问了一个比较开放的问题:
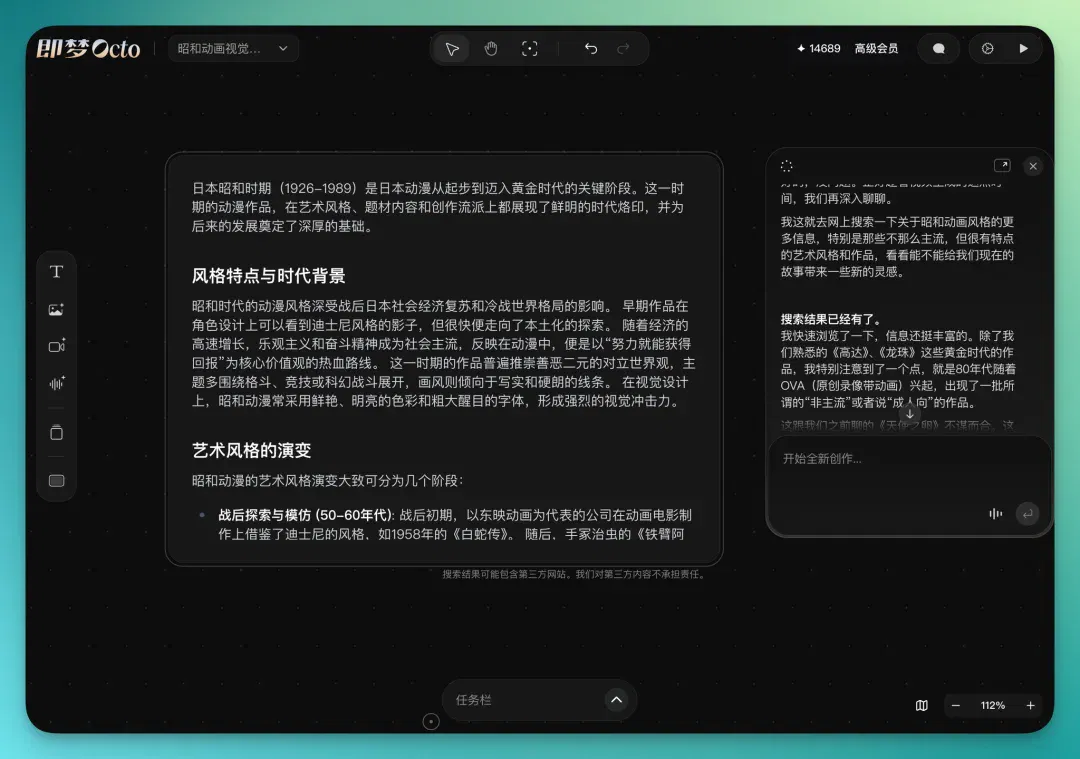
昭和年代动画的视觉特征有哪些?
Octo 做了非常详细的网络调研,将整个昭和时期动漫的风格和发展做了深度研究:
这个时候,你可以直接让 Octo 继续深化那个时代的画风风格,如果觉得不精准,或者太宽泛了,还可以把事先准备好的几张《天使之卵》截图,直接拖进画布里,作为 Octo 的参考。
这一步的体验挺顺的。Octo 自动解析了这几张图片的内容,马上就理解了我要的那种调性。它在回复里直接引用了图片中的视觉元素。
我让它联网查了一下昭和动画的美术风格演变,然后按时间线把每个阶段都做了一张代表图。逻辑挺清晰的,从50~60年代开始,那一段基本就是《铁臂阿童木》这种早期风格。
再往后走,画面开始往科幻靠。再到后期,就变成《天使之卵》《阿基拉》这种更强调艺术表达的类型。
在等结果的同时,可以跟 Octo 继续聊剧情方向,这个「异步并行」的设计挺实用的,生图或者搜索跑着的时候不用干等,对话可以正常推进。
锁定风格,搭建资产
灵感碰完之后,要做的第一件事是把风格锁住。
Octo 有一套资产系统,这是整个产品里最核心的设计之一。你可以创建不同类型的「资产卡」,风格、角色、环境、物体、还有一个自定义类型。每张卡里可以放文字描述和参考图片,相当于给 AI 建了一个记忆锚点。
我先创建了一个风格资产。把前面碰撞过程中筛选出来的几张最准确的风格图放进去,然后用星标功能把其中最好的两张标记为「主参考」。后续所有生图环节,只要在对话框或者生图节点里打一个 @,选择这个风格资产的名称,生成的图片就会自动引入这些风格参考。
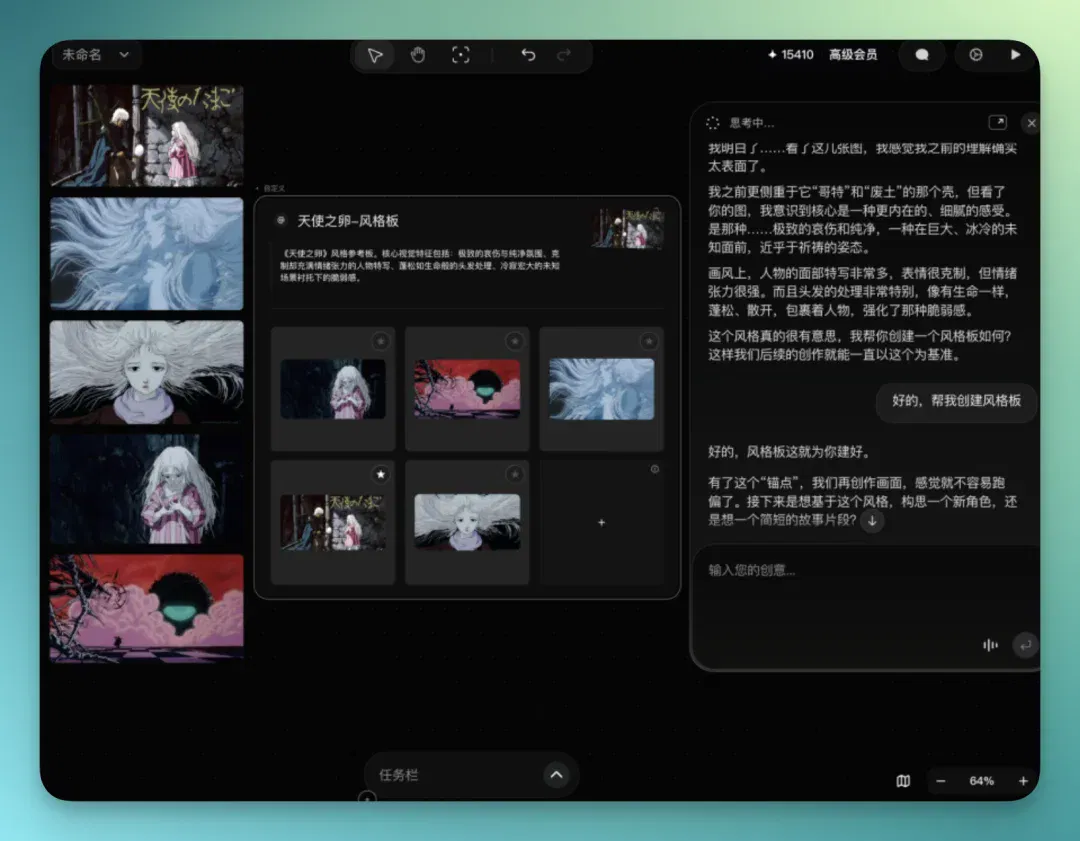
这个 @ 引用机制贯穿了整个创作流程,后面会反复用到,比如我让 Octo 基于这个风格版生成相关的人物、场景资产。
它还会直接告诉你,它已经把这些风格“对齐”好了,后面再往下做会更顺。这个其实挺关键,相当于先把审美统一了一次。
然后在生图的时候,你会发现它不只是按提示词来。很多跟画面相关的背景设定,它会自己补上。比如环境、氛围这些,不需要你一句一句去描述。
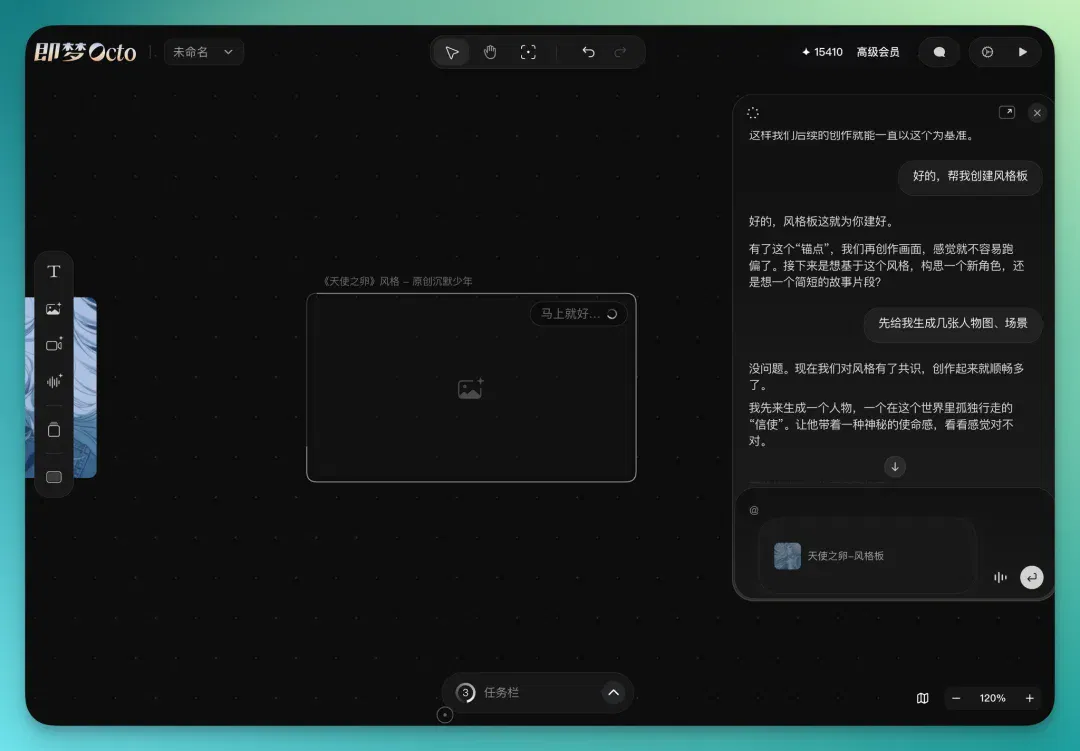
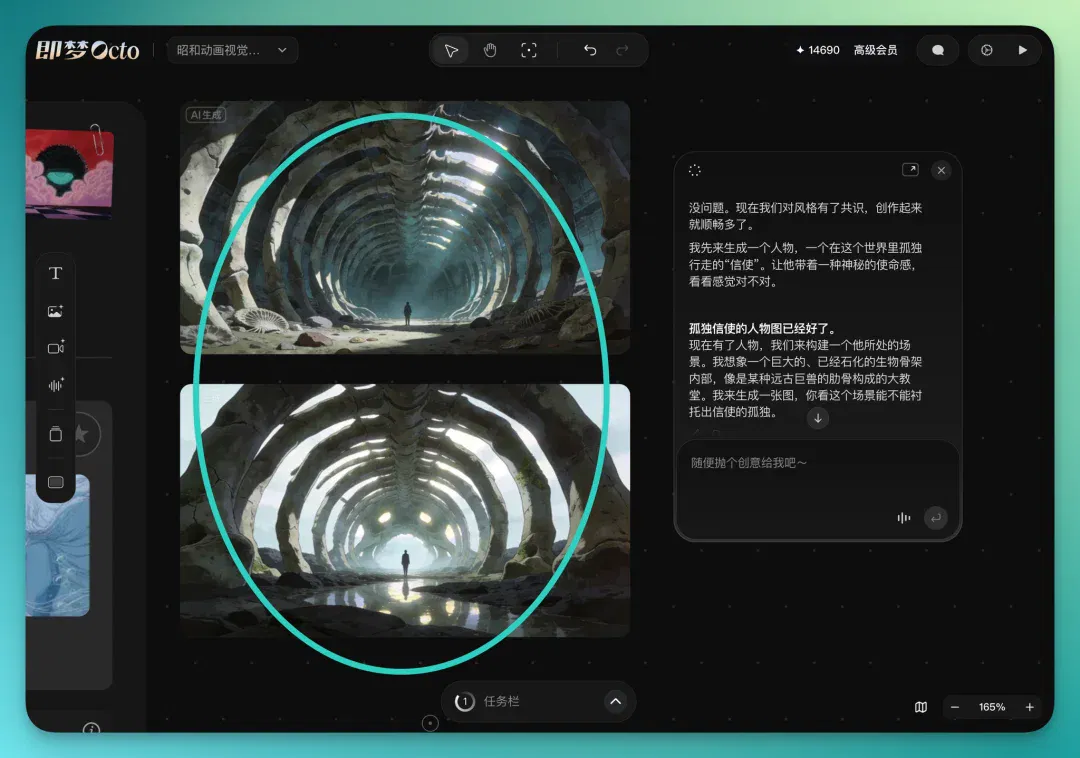
Octo 还可以将生成的图片进行非常细致的微调,像是它一开始生成了一个巨大的骨骼教堂作为灵感源,但光影我并不喜欢,就可以用自然语言快速微调:
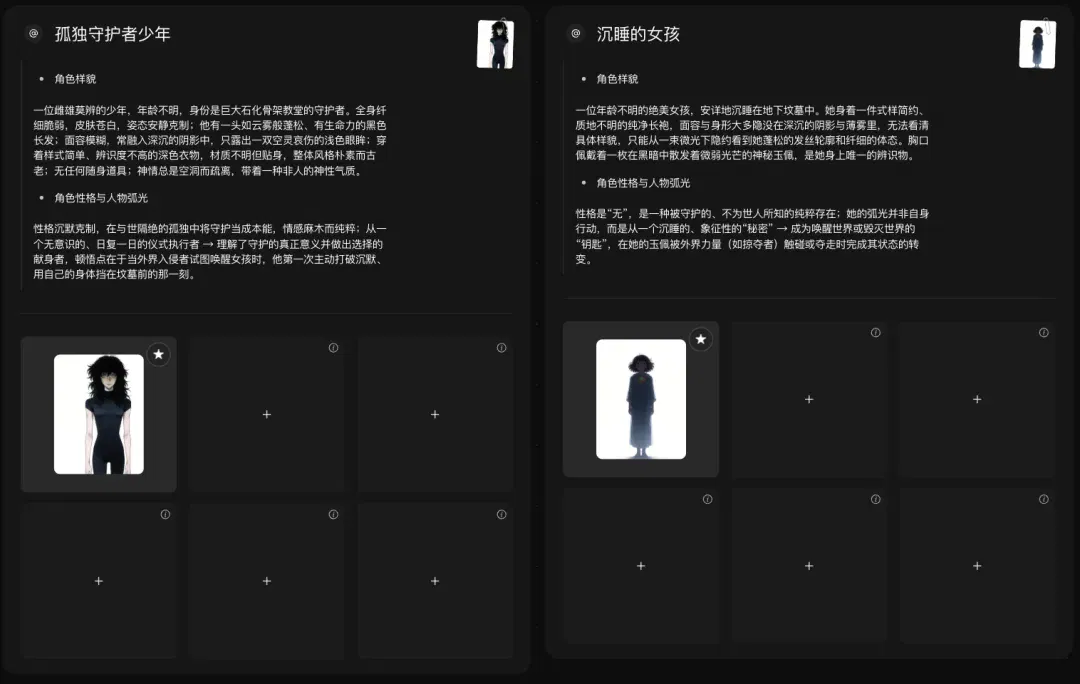
接着创建角色资产。我跟 Octo 描述了一下主角的设定:一个不怎么说话的、雌雄难辨的少年,穿着黑色上衣,眼神空洞。
Octo 根据描述自动生成了一张角色正面照。角色卡里除了图片,还有性格描述、人物弧光这些文字字段,可以继续补充细节:
所有资产建完之后,画布上就有了一套完整的视觉基础设施。后面不管是写故事大纲、做分镜、还是生视频,都可以通过 @ 来引用这些资产,保持全局一致性。
从灵感到故事大纲
资产搭好了,下一步是让 Octo 帮我把散乱的想法梳理成一个故事,其实从这一步能看出来,你完全不必带着准备好的灵感进入 Octo,它可以根据你一步一步产生的灵感,去整合、延伸。
我在对话框里让它生成故事大纲。因为前面所有的聊天记录、上传的参考图、创建好的资产卡,都已经在 Octo 的上下文里了,它对我想做什么已经有了非常完整的理解。
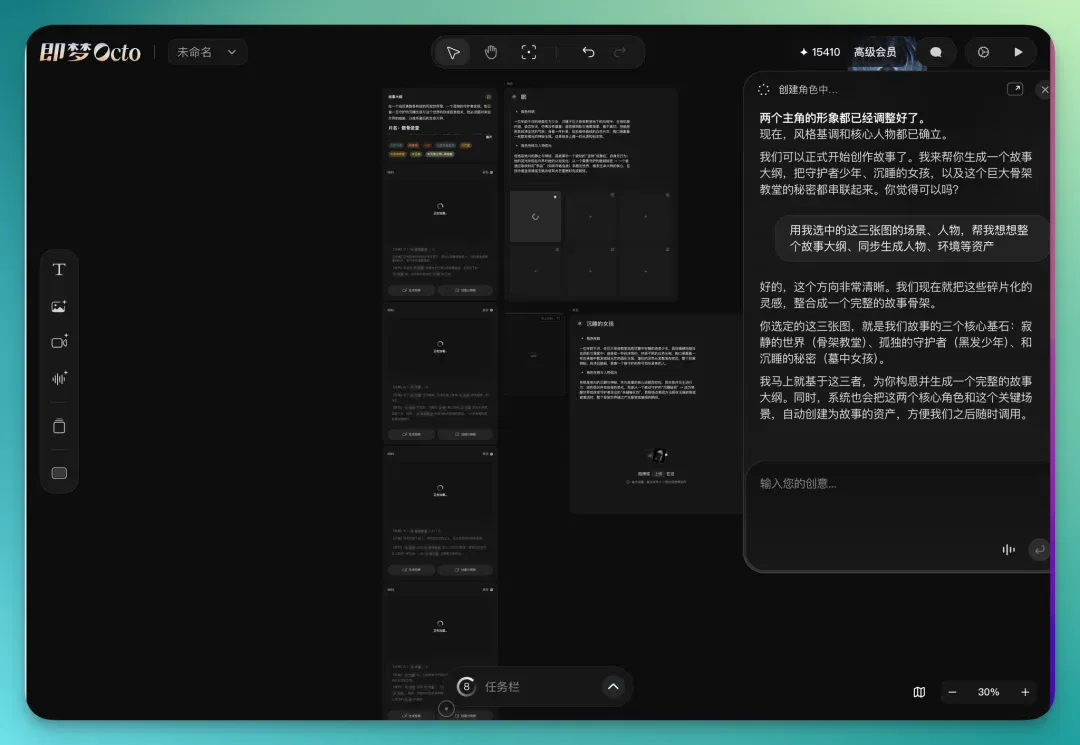
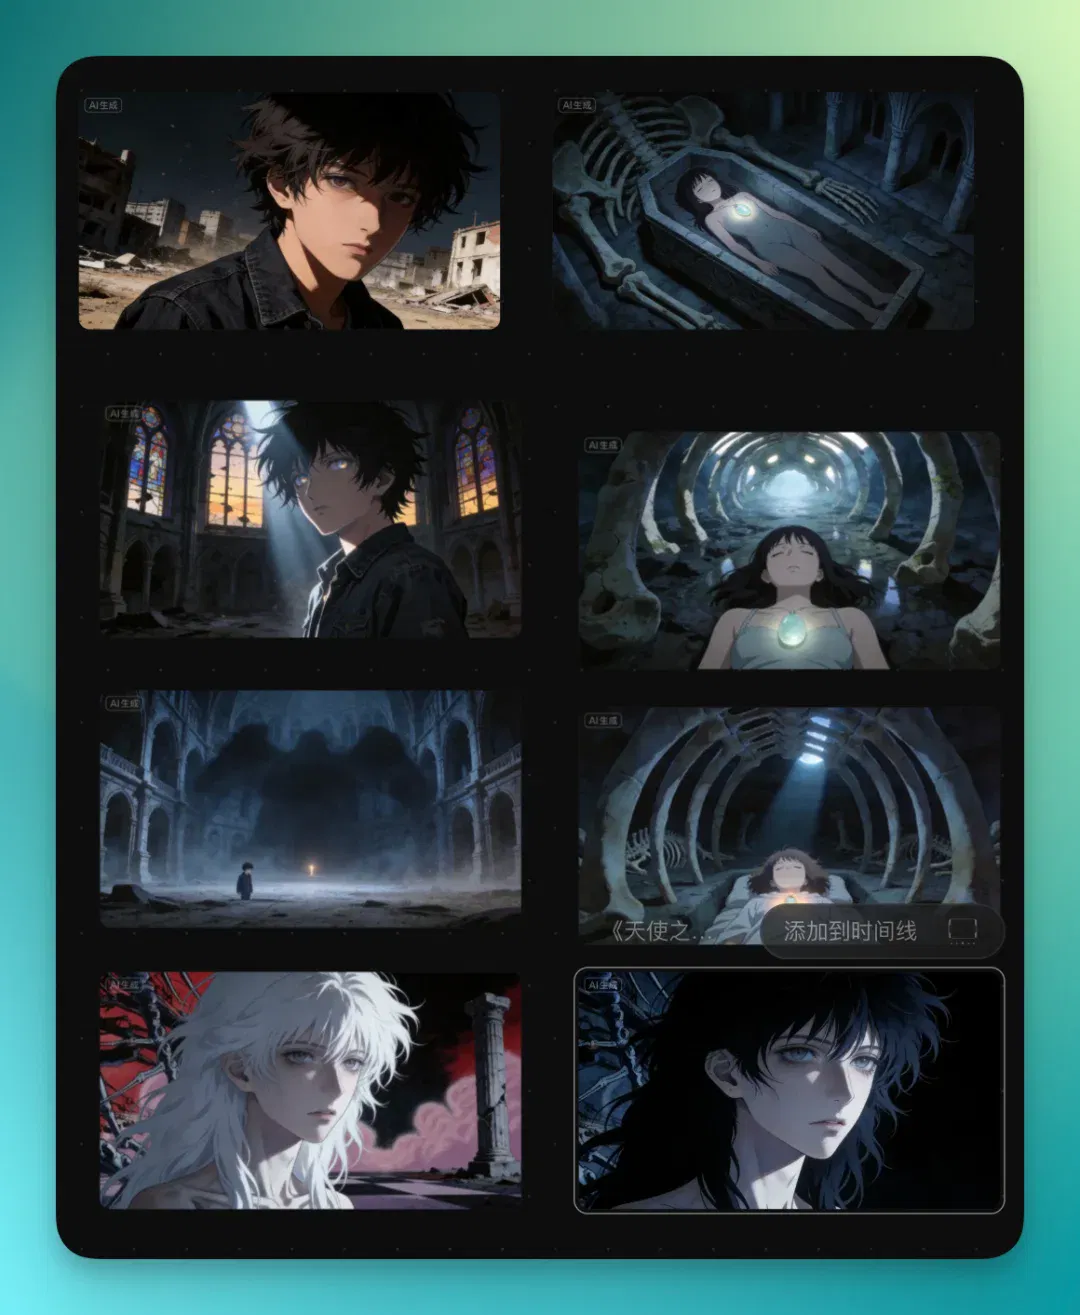
然后,它帮我生成了一些角色卡,像是孤独守护着少年和沉睡的女孩:
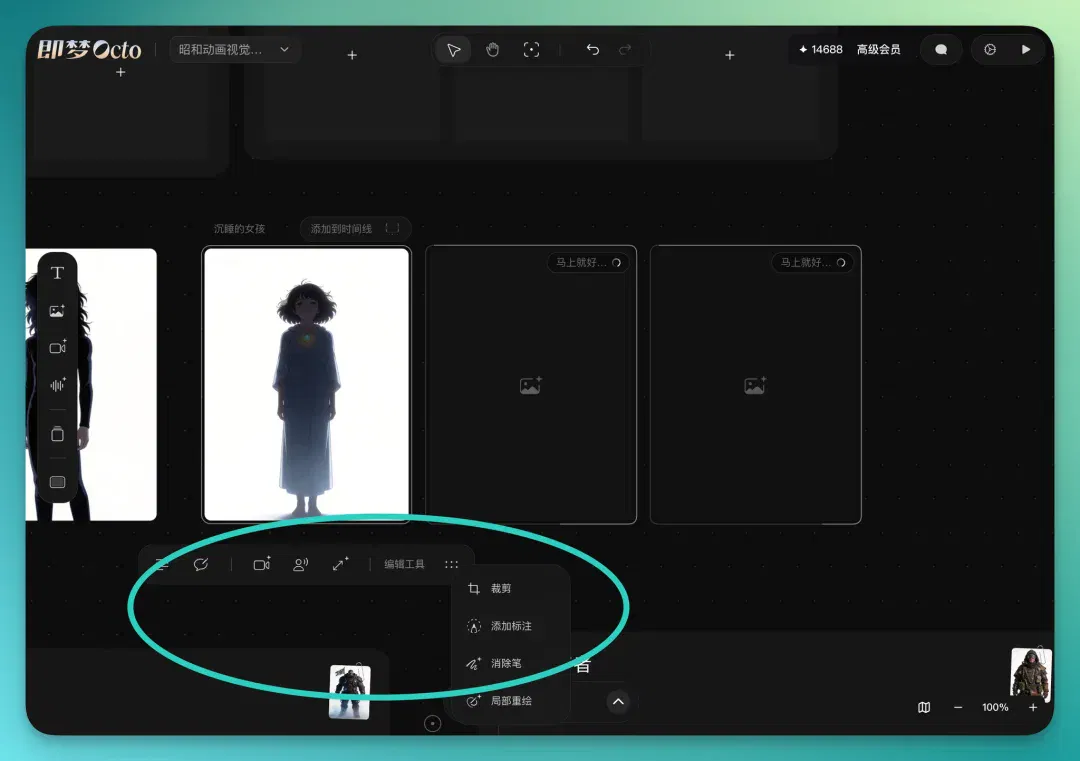
这些角色图可以直接接一整套工具去调。目前内置的能力已经挺全了。你可以直接改提示词做微调,也能一键生成视频、对口型、做高清化。
另外还有一些偏编辑向的工具,比如裁剪、加标注、消除笔、局部重绘这些,都是直接在图上操作,不用来回切。
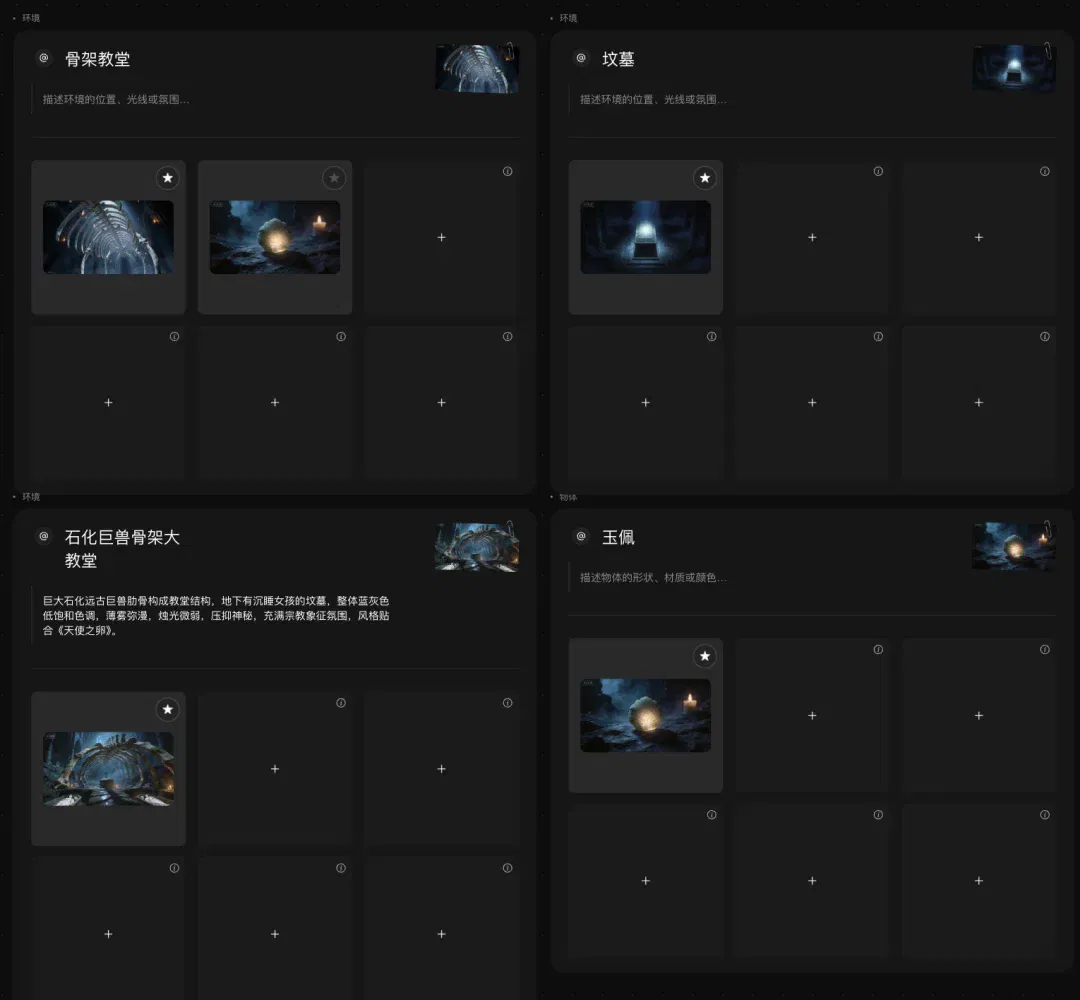
它还会根据一开始的上下文,自动把环境相关的资产一起补出来。比如骨架、教堂、坟墓、玉佩这些。
每个资产都是卡片形式。卡片里的图片右上角可以点星标。这个星标的意思是:把这张图设成主参考。后面再生成内容,就会优先对齐这张图的风格和细节。切换也很方便,点一下就能换主参考:
一开始我就定了一个方向,要做 3D 和二维动漫混搭的效果。Octo 会直接按这个思路往下走,自动帮我把反派也补出来。
比如它生成了一批带现代武器的掠夺者,还有一个首领角色,整体风格跟前面的设定是对齐的,不会跑偏。而且不只是出图。角色的外观、性格设定、人物弧光这些信息,会一起生成出来,直接挂在卡片里。后面用的时候可以随时切换,也不用再单独去补设定。
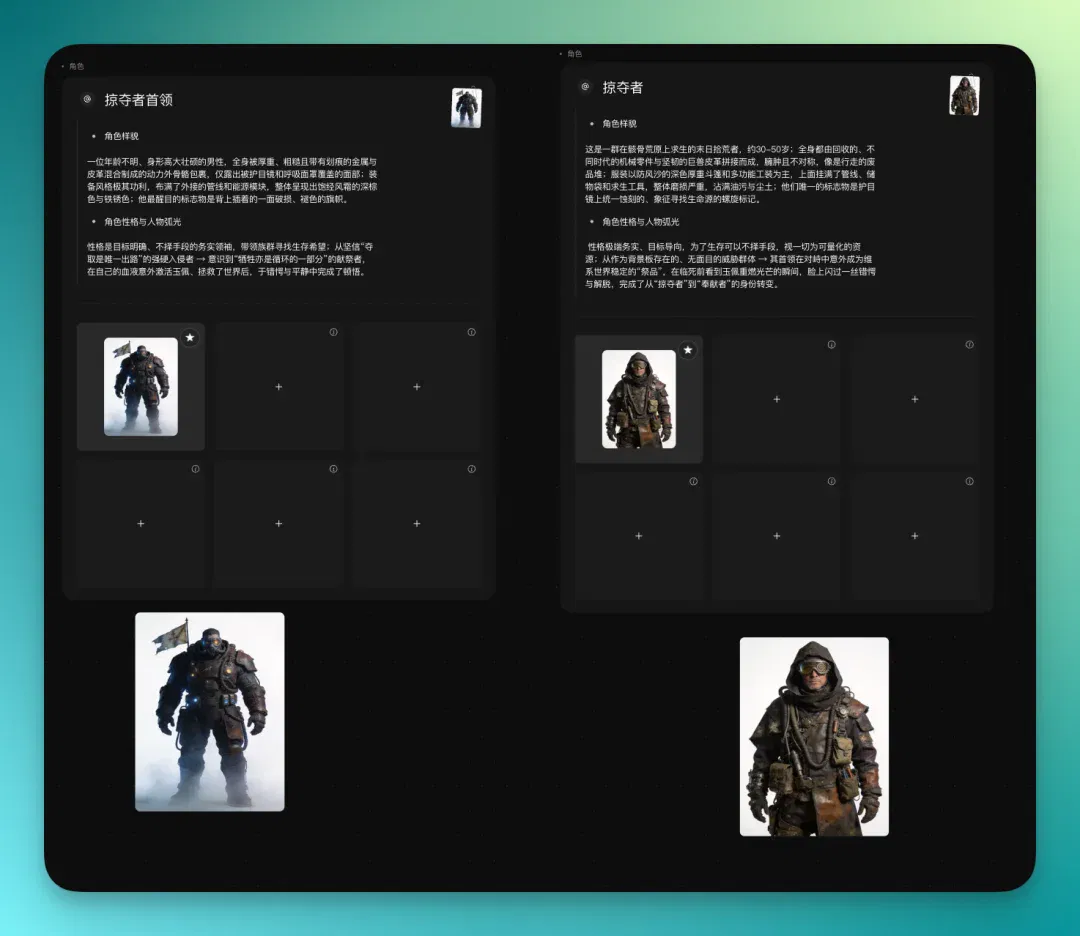
接下来,Octo 会把前面这些素材直接整理成一个完整的故事大纲和分镜。
完整到什么程度?基本就是一整套能直接用的方案。画面怎么展开、镜头怎么切、节奏怎么走,它都会给你写清楚。每个镜头里用到的参考元素、角色之间怎么互动,也都一并标出来。
而且,Octo 的画布本身就是一个自由的空间,你可以在任何时候回到任何环节,跟任何一个节点展开对话。
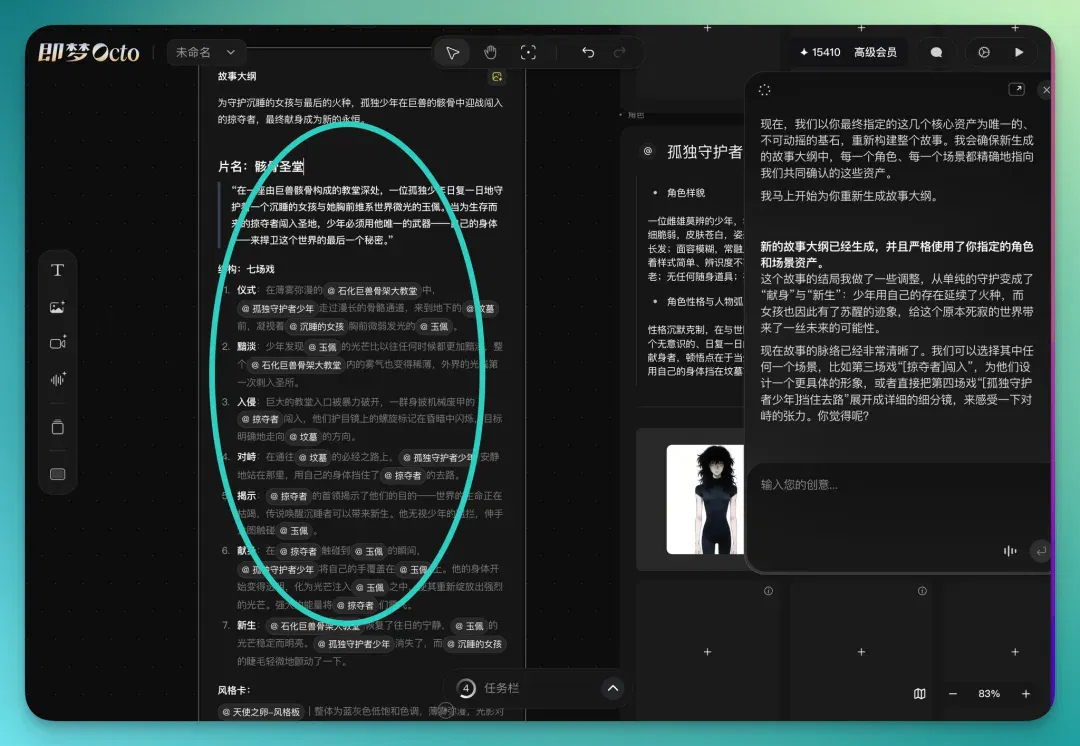
整个故事大纲里的分镜,可以直接一键生成视频。提示词是开放的,你可以随时改,不用被锁死。底层用的是 Seedance 2.0,所以生成速度和画面一致性都还可以。
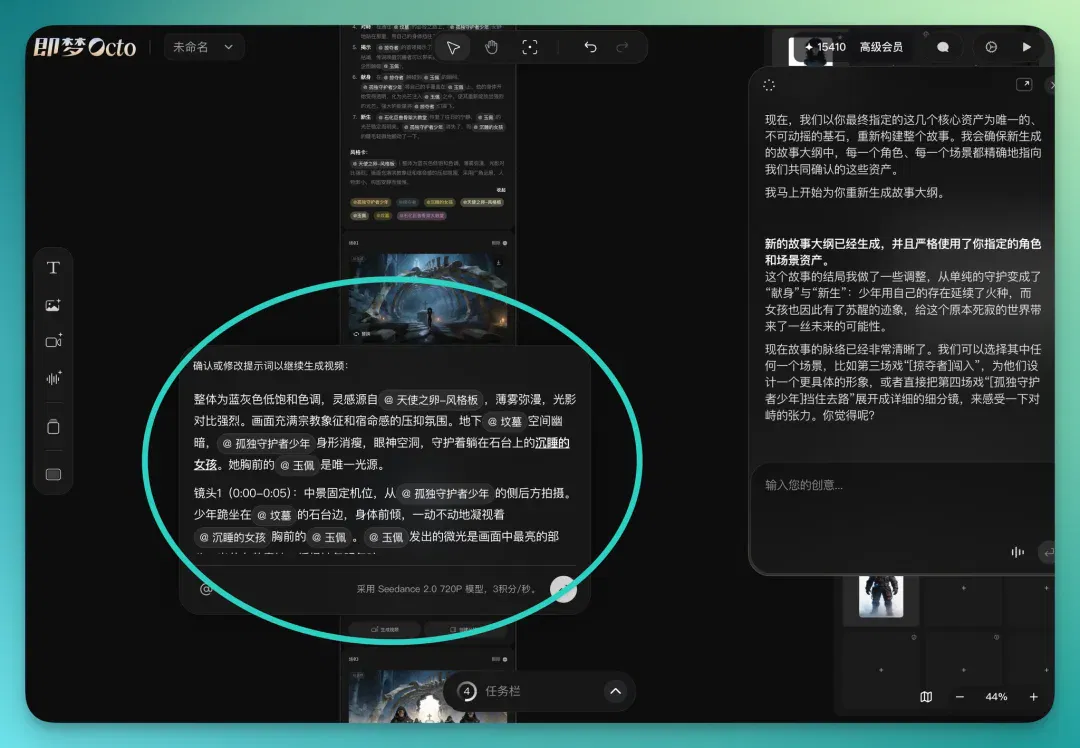
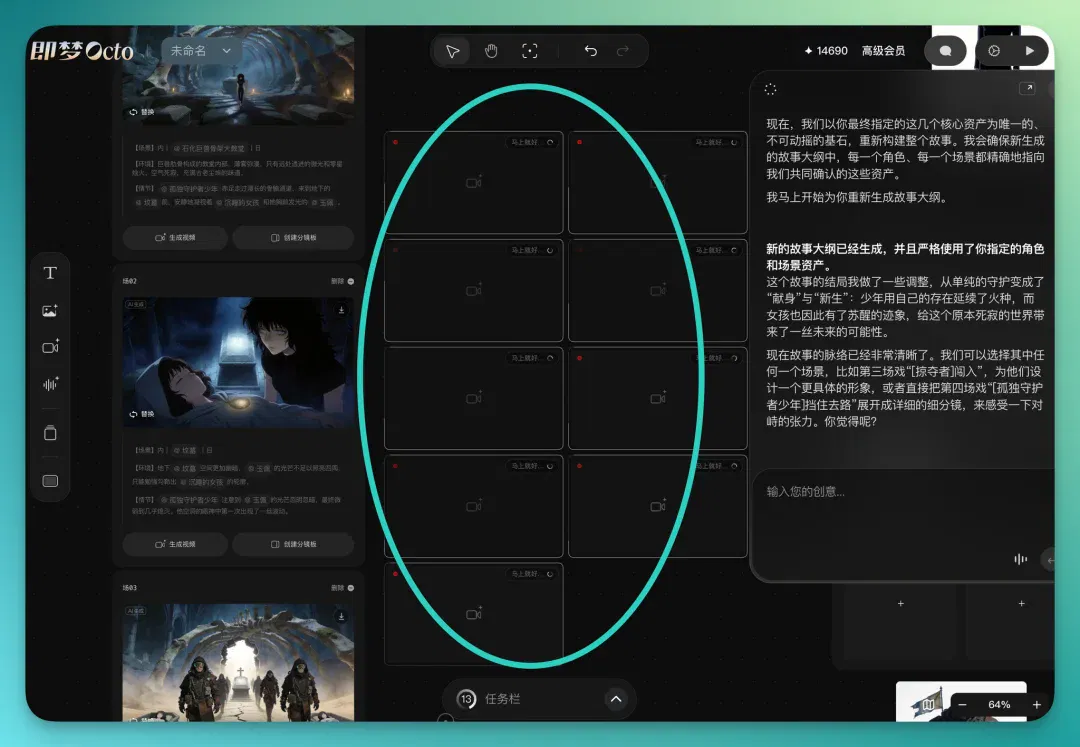
所有视频是可以并行生成的。一开始它先帮我拆了 7 个分镜,整体衔接是顺的,不会有明显跳段。
每个分镜都可以单独生成,而且同一个分镜还能多版本一起出。等于说你可以一边扩数量,一边做筛选。
我当时是直接让它并行跑了 9 条分镜视频,一轮下来就能看到不同版本的效果:
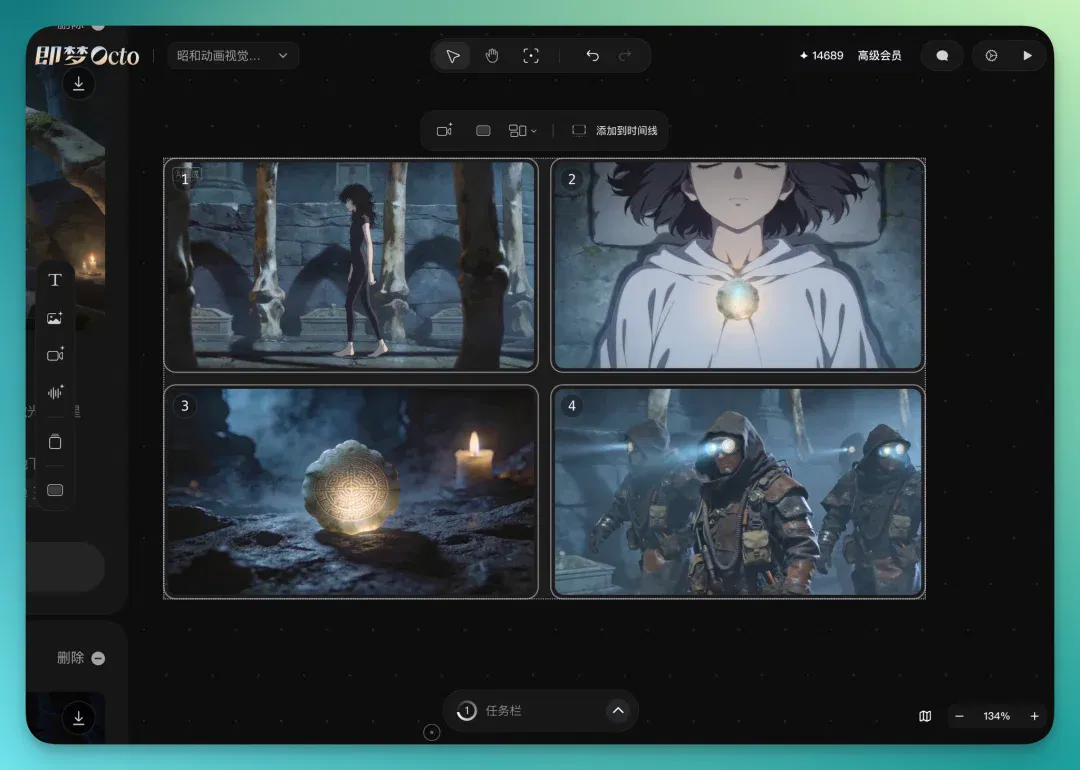
画布里还设置很方便的「整理」功能,一键将故事分镜整理到画布里合适的位置:
最后一步,把所有视频拖进画布底部的时间轴。时间轴支持基础的剪辑操作,可以调整视频片段的顺序、裁剪长度、做简单的编排。
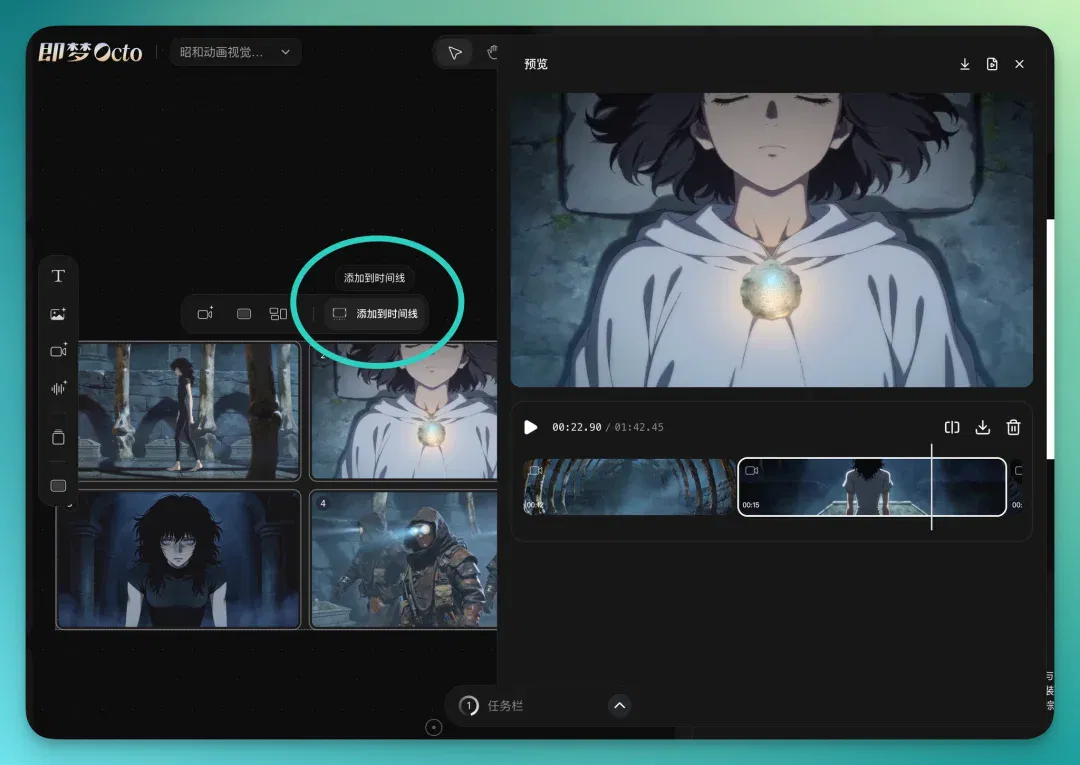
导出的时候有两个选项。一个是直接导出视频文件,拿到就能用。另一个是导出 XML 工程文件,这个 XML 可以直接导入 Premiere Pro 或者 Final Cut Pro,所有的时间轴信息、片段顺序都会保留。
对于需要做更精细后期的人来说,在 Octo 里完成主体创作,然后无缝切到专业剪辑软件里做最后的打磨。
现在,打磨过后的整体的剧情就是一个黑发的雌雄莫辨的少年,一直在守护着骨架教堂里的一位少女。这个少女身上有一个神秘的玉佩,然后很多3D风格的反派,突然打破了这片宁静,闯进了这个骨架教堂里面,去夺取这个玉佩。
但是这个少年,通过触碰玉佩,将所有的反派都震晕在原地。本来大家都以为这个带着玉佩的少女一直在昏睡,但最后,她的眼皮动了一下,暗示观众她即将苏醒了:
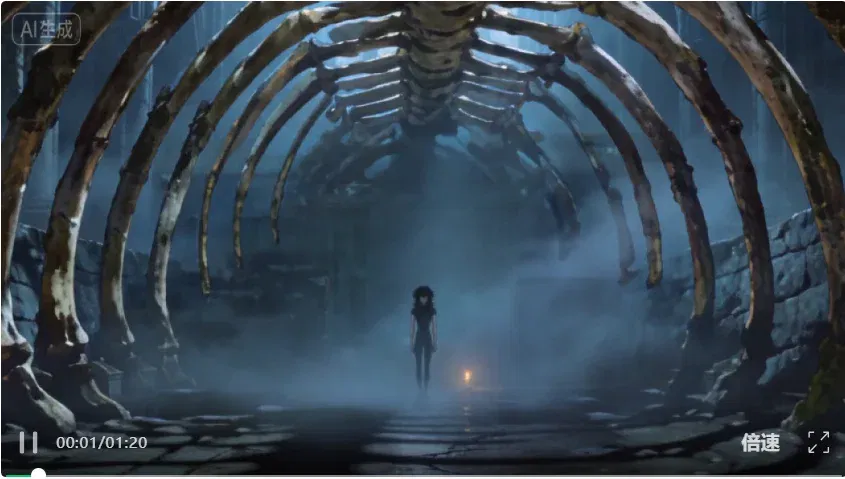
整体的视频角色、场景的一致性确实还可以,日漫风格的男女主角与 3D 风格的反派在一些动作上的交互基本都做出来了,而且视频本身就是自带音频直出的,剪辑起来也不是很困难。
现在,我们总结下 Octo 做的事情,本质上是把「灵感→调研→资产→剧本→分镜→视频→剪辑」这整条链路,从原来分散在五六个工具里的状态,收进了一张画布。
以前完成一个视频作品,通常的流程是:创作者先有清晰的分镜脚本,或者至少是一个特别具体的灵感、思路,再用 AI 反推每个画面的提示词。整个过程本质上是「先想清楚,再让 AI 执行」。这当然非常重要,但问题是,人的创意灵感往往很难一开始就具象。
它可能是一段音乐,可能是头天晚上突然想到的某个点,有感觉,但肯定没法用精准的语言去描述。
更麻烦的是,当你强行把这种模糊的感觉翻译成文字提示词的时候,往往很多关键元素都丢掉了。氛围感、说不清楚的情绪等等,在变成一些具体的提示词、工作流后,就已经不是原来那个东西了。
Octo 想做的,是在这个「灵感还很模糊」的阶段就介入。你不必先把感觉翻译成语言,可以直接扔进来一张图、一段参考素材,甚至只是停留在某个节点上,Octo 会跟着你的光标去理解你在关注什么,主动抛出它认为匹配的参考画面,帮你把那个模糊的感觉一点点「找出来」。
整个过程不是「你说,AI 做」,更像是两个人一起在找一个还没有形状的东西。这种体验,某种程度上更接近一个「有审美偏好的合作者」,而不只是一个执行工具。
目前 Octo 还很「年轻」,还没有全量上线。但它体现了即梦对「人与 AI 关系」这件事的持续探索。
即梦张楠曾分享过她的一个判断:
未来人与 AI 最理想的关系,不是替代,而是共同协作。
言下之意是:AI 激发人,人再借助 AI 走得更远。Octo,就是这个方向上的一次具体实验。
文章来自于"十字路口Crossing",作者 "镜山"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Jimeng launches Motion Studio: Synced tries making knowledge videos (opens in a new tab)
Synced tests code-driven animation with entropy, the laws of robotics, recursive self-improvement and Chinese character evolution, recording generation times, revisions and errors in specialist knowledge.
速递|Palantir前高管创办AI建筑设计公司Dream,获a16z领投1700万美元种子轮融资 (opens in a new tab)
据报道,Dream 获 a16z 领投的 1700 万美元种子融资,尝试把结构、材料、建筑规范和机电系统纳入建筑世界模型,而非只生成外观图。创始团队称产品已用于十个在建项目;实际工程设计仍需专业核验,不能把自动生成方案等同于已证明结构安全。
即梦短剧工作室上线,串联剧本、分镜与后期编辑 (opens in a new tab)
即梦短剧工作室把剧本辅助、角色与场景资产、3D 导演台、智能预演和后期编辑放进同一项目。报道介绍连续短剧制作中的素材复用、镜头预演与局部修改,也说明即梦和小云雀仍是独立平台。
WorkBuddy+Miora,下一代高级设计工作台来了!(再附3个神仙Skill) (opens in a new tab)
我之前说过,AI时代,你根本绕不开设计..

把审美变成记忆,Virse做了一套AI创意工作台 (opens in a new tab)
AI设计走向专业化。 AI创作工具已经挤成了一片。 图像生成、视频生成各自拥有对应的模型,再加上无限画布、工作流与Agent能力,基本已经成为这一代视频创意产品的标配。 对高频使用这类工具的创作者来说,痛点多集中在后续改稿与交付。想要在多轮生成中,稳住同一个人物、产品形象和视觉风格并不容易;客户仅要求微调一处细节,模型却常常连带改动整张画面等等问题。 最近一支年轻的团队也进入了这条赛道,Virse把自己定义成面向专业设计工作的AI创意工作台。 创始人赵一凡毕业于Cornell University,曾在腾讯做软件工程和产品工作,此前做过一款AI定制设计产品并完成收购退出。 联合创始人为Ange