OpenClaw 霸榜,Agent 全面爆发的前夜(附报告原文PDF)
AI 行业,似乎已经提前进入了以个人 Agent 为代表的「后 ChatGPT 时代」。这印证了独立 AI 基准测试机构「Artificial Analysis」的预测结论:2026,Agent 正在全面爆发。近期,他们发布了对 AI 领域发展的全面总结:《2025 年终 AI 发展报告》。
随着 OpenClaw 在 2 月份的持续霸榜:
AI 行业,似乎已经提前进入了以个人 Agent 为代表的「后 ChatGPT 时代」。
这印证了独立 AI 基准测试机构「Artificial Analysis」的预测结论:2026,Agent 正在全面爆发。
近期,他们发布了对 AI 领域发展的全面总结:《2025 年终 AI 发展报告》。
报告总结了过去一年,AI 行业在文本、语音、视频、芯片等各项领域的进展。
过去一年到底都发生了什么呢?一起看下吧。
添加官方客服微信 openai178,免费领取报告原文
行业概况
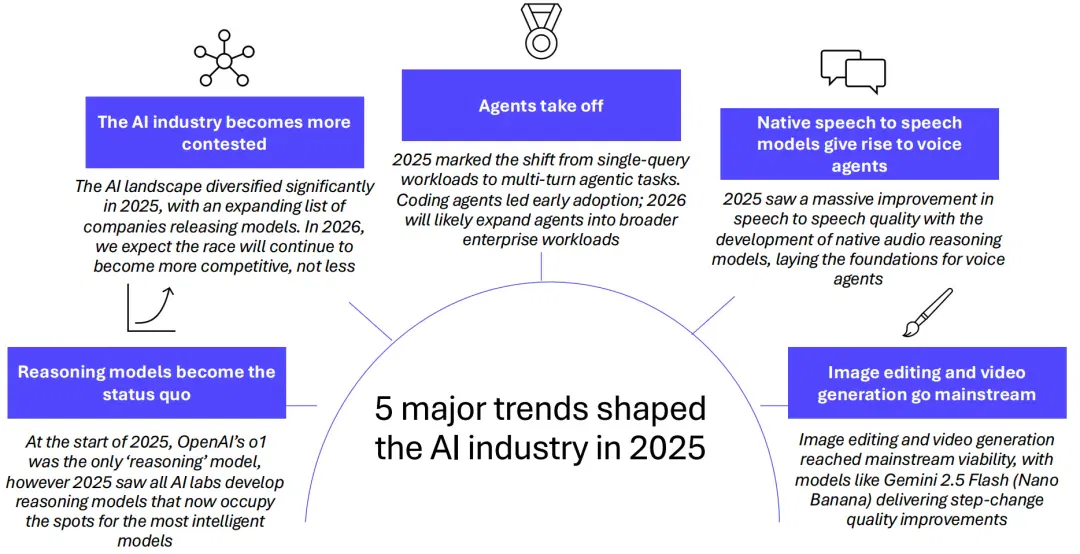
2025 年的五大 AI 行业趋势如下:
1、推理模型已成行业常态。
2025 年初,OpenAI 的 o1 模型还是唯一的推理模型,但这一年里,各大实验室纷纷推出自家的推理模型,如今这些模型已跻身最智能模型之列。
2、AI 行业的竞争正愈演愈烈。
2025 年,AI 格局发生了显著变化:越来越多的公司加入战局,推出自己的模型。展望 2026 年,这场竞赛只会愈演愈烈,不会降温。
3、AI 智能体起飞。
2025 年,AI 应用迎来关键转折点:从单查询工作负载转向多轮智能体任务。代码智能体是这场变革的先行者,而 2026 年,智能体的应用范围有望扩展到更广泛的企业级工作场景。
4、自然语言转语音模型,正在催生语音智能体。
2025 年,原生音频推理模型的发展让语音转语音质量迎来了质的飞跃,为语音 Agent 的兴起奠定了基础。
5、图像编辑与视频生成走向主流。
如今,这两项技术已具备主流应用的条件。以 NanoBanana 为代表的模型,让画质实现了跨越式提升。
一些关键的洞察:
1、Google 依然是 AI 领域垂直一体化布局最深入的玩家:从 TPU 加速器到 Gemini 应用,覆盖了整个 AI 价值链。
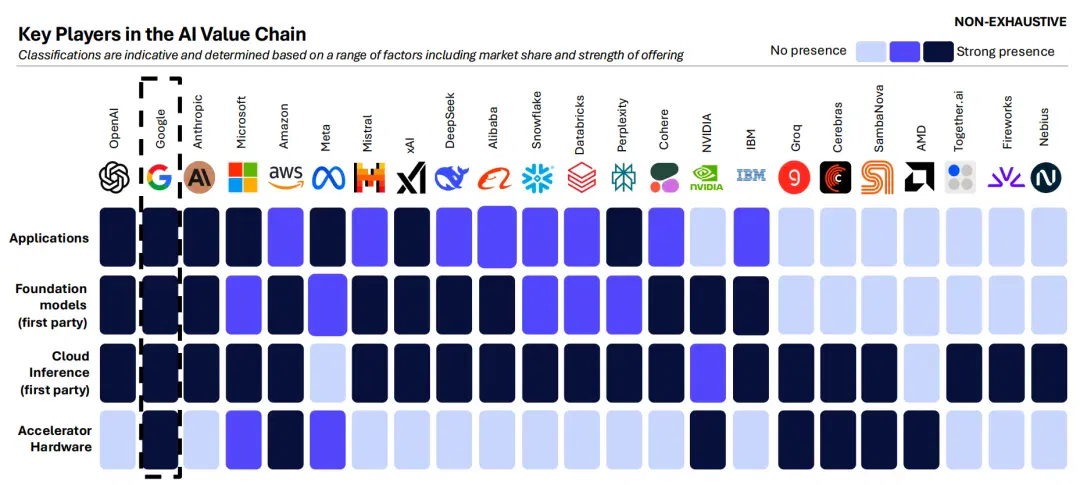
2、AI 领域的竞争正变得越来越激烈。2025 年,一批新的国际实验室将加入赛道,不过,美国和中国依然牢牢占据领先地位。
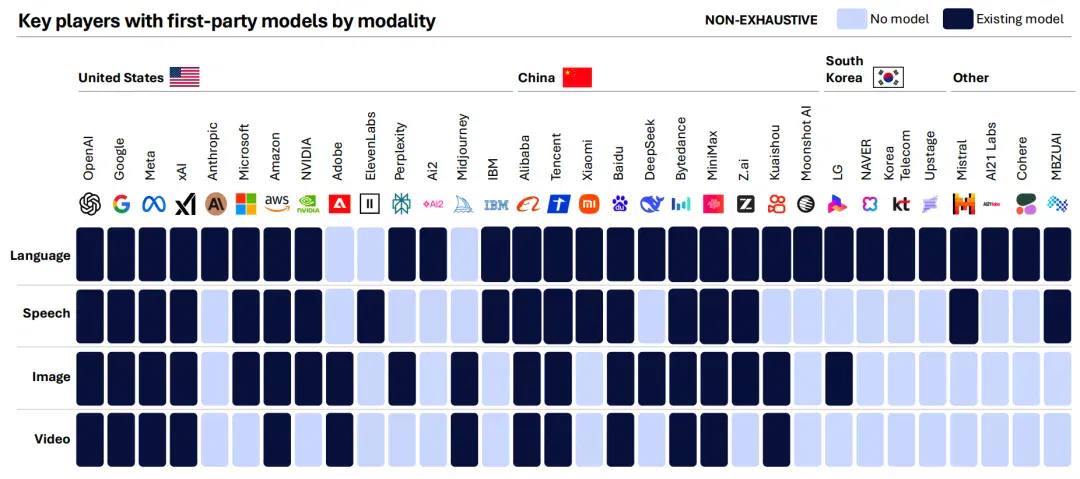
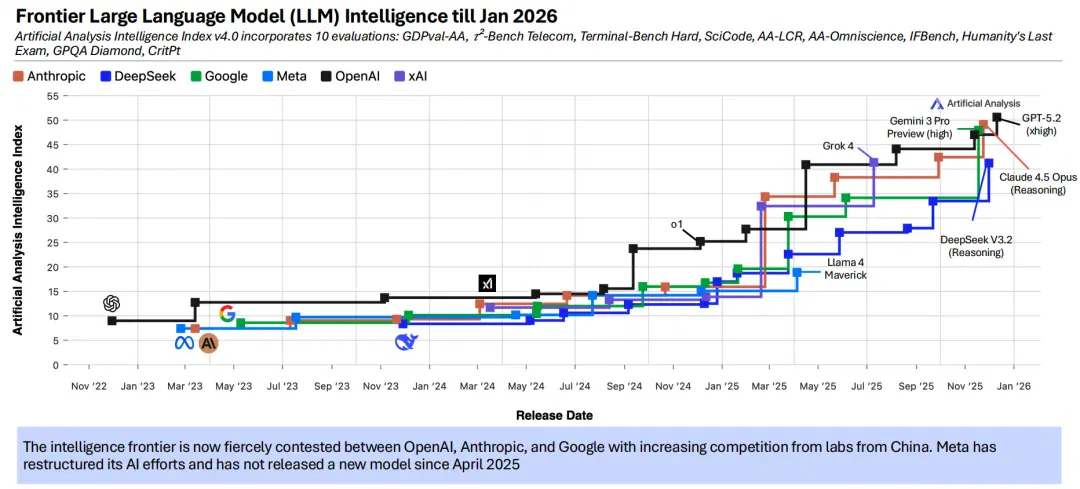
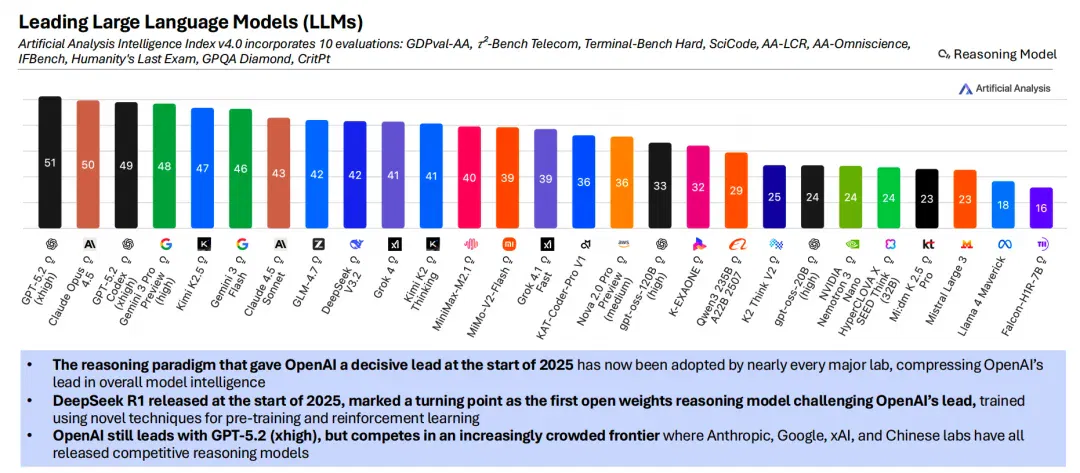
3、OpenAI 在 2025 年全年都拥有最强大的语言模型,但它的领先优势已前所未有的缩小。
语言模型
2025 年,推理范式主导了 AI 行业的发展方向。
它不仅推动智能水平大幅提升、成本持续下降,还催生出智能体 AI 的兴起。与此同时,开源权重的普及和全球实验室的努力,正在缩小与美国前沿机构的技术差距。
2025 年的五大 AI 模型趋势如下:
1、2025 年,模型智能迎来大幅提升。
背后的核心驱动是范式转变:行业开始转向那些在回答前会「思考」的推理模型。
到 2025 年底,OpenAI、Anthropic 和 Google 已凭借「推理优先模型」领跑智能前沿,这类模型会先「思考」再给出答案。这与 2025 年初的格局截然不同:当时占据最智能模型榜首的,还是那些不会「思考」的非推理模型。
与此同时,推理范式显著扩大了平均工作负载规模:模型在「思考」阶段会生成更多输出 token。不仅如此,它还在通用推理、科学推理、长周期智能体任务以及编码领域推动了性能提升。
2、2025 年见证了智能体 AI 的崛起。
各类模型开始越来越多地端到端完成长周期任务。
智能体的应用场景正在不断拓展:从最初针对特定领域(如深度研究)的定向工具,到如今已演变为通用型解决方案。前沿模型现在能够稳定协调跨领域的多步骤工作流。
工具调用训练如今已全面普及:
2025 年推出的大多数模型,都经过了预训练和强化学习优化,专门用于智能体任务执行。
长周期编码任务是智能代理工作流改进的最大受益者。2025 年,无论是初创企业还是行业巨头都纷纷推出编码代理,这类工具的数量明显增多。
3、2025 年,基础模型迎来了普及化浪潮,不过美国和中国仍保持显著领先地位。
全球各地的 AI 实验室(包括欧洲、中东、亚洲)仍在持续推出具备竞争力的基础模型。
不过,前沿能力仍集中在美中两国的头部公司手中:美国有 OpenAI、Anthropic、Google,中国则是 Moonshot AI、Z.ai、DeepSeek、Minimax。
虽然美国实验室在专有前沿模型的开发领域仍处于领先地位,但中国实验室持续推出前沿开源权重模型。
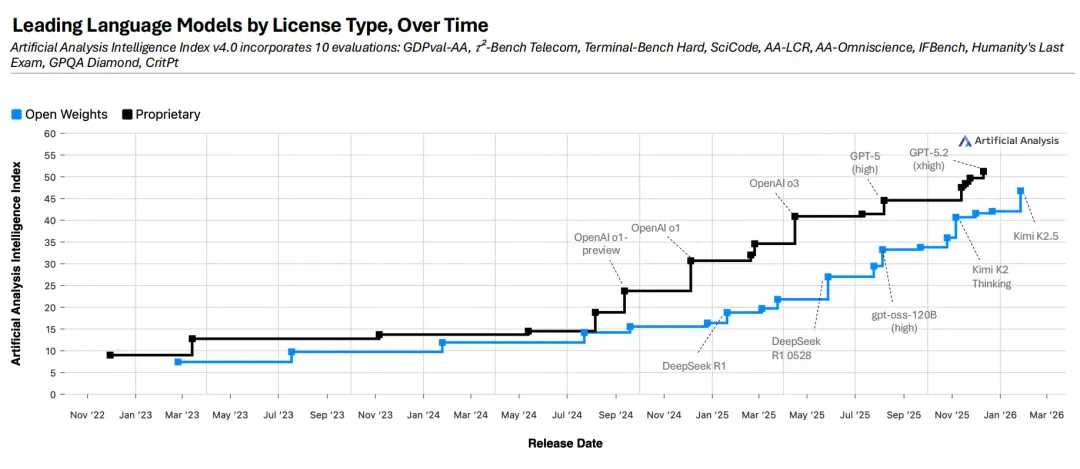
4、2025 年,新的开源权重模型在智能水平上继续与闭源模型并驾齐驱,但前沿领域仍由闭源模型主导。
2025 年,开源权重生态系统持续扩张;到年底时,最具能力的开源权重模型已越来越多地出自中国实验室。
另一方面,2025 年全年,开源权重模型大体上跟上了专有模型的发展节奏,但专有模型在整体智能水平上仍处于领先地位。
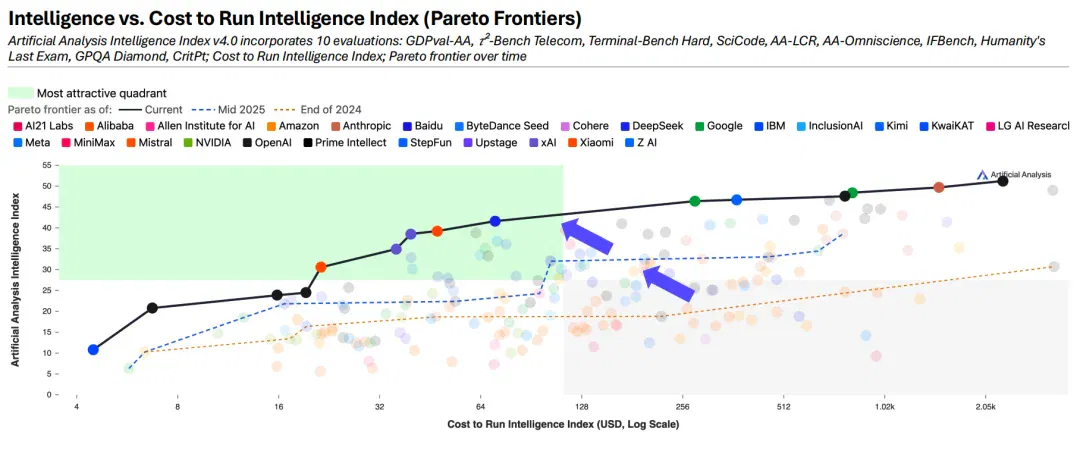
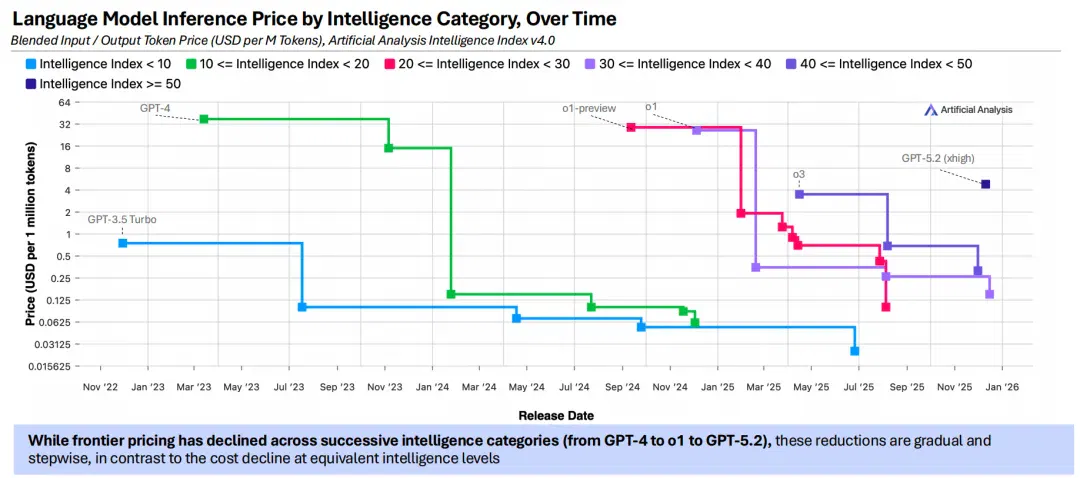
5、o1 级智能的成本出现了显著下降。
2025 年初,o1 级智能的每 token 价格较之前下降了 128 倍。
编者注:最近,Sam Altman 宣布 AI 智能成本下降 1000 倍。
背后的驱动因素主要有两个:一是小模型实现了更高的智能水平,二是软硬件层面的优化。
对于「语言模型」,一些关键的洞察:
1、截至 2025 年底,OpenAI、xAI 与 Anthropic 三家公司凭借最新推理模型,在前沿智能领域占据领先地位,与其他 AI 实验室拉开了明显差距。
2、2025 年推出的 AI 模型刷新了智能与成本的平衡边界:企业现在要么能用相同预算获得更强大的智能,要么能以显著更低的成本获取同等水平的智能。
3、模型规模越大,其全知指数评测分数(AA-Omniscience)就越稳定地处于高位。
编者注:AA-Omniscience 可以理解成「模型知道自己知道,也知道自己不知道什么」的能力得分。
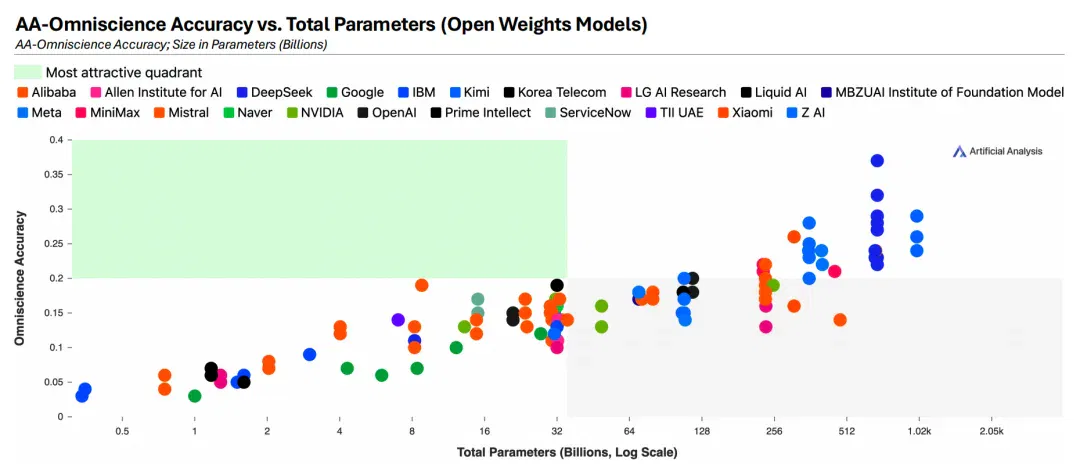
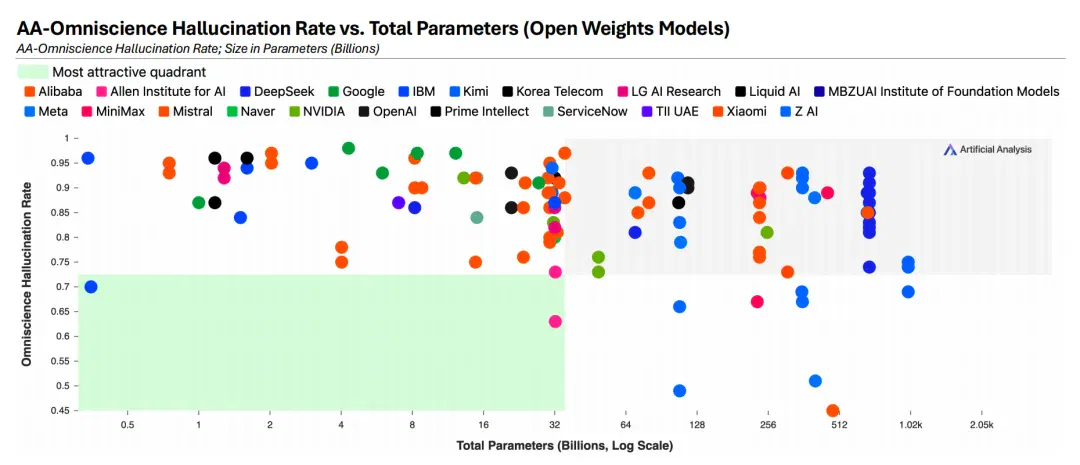
4、但幻觉生成率与模型规模的关联度并不高,这说明其他训练决策的影响其实更大。
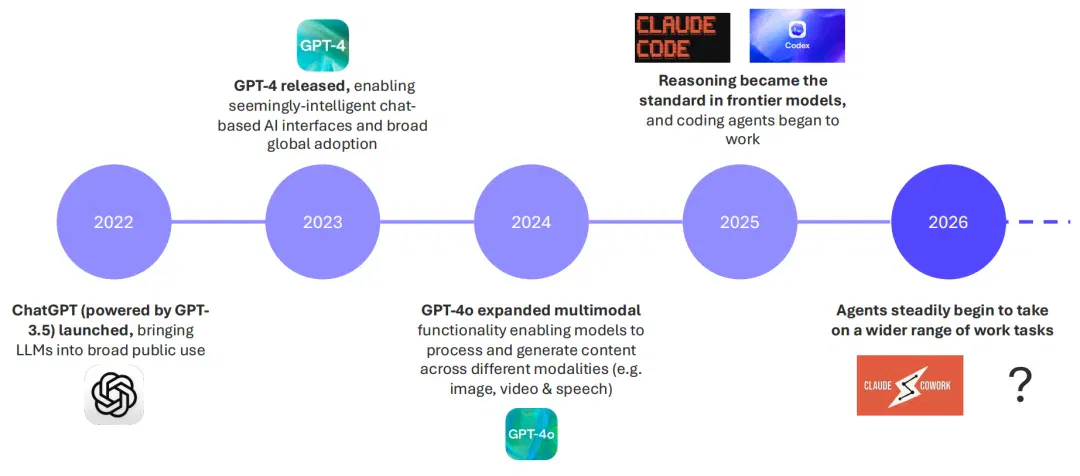
5、2025 年是代码智能体正式落地的一年;2026 年,则将迎来全能智能体的全面启用。
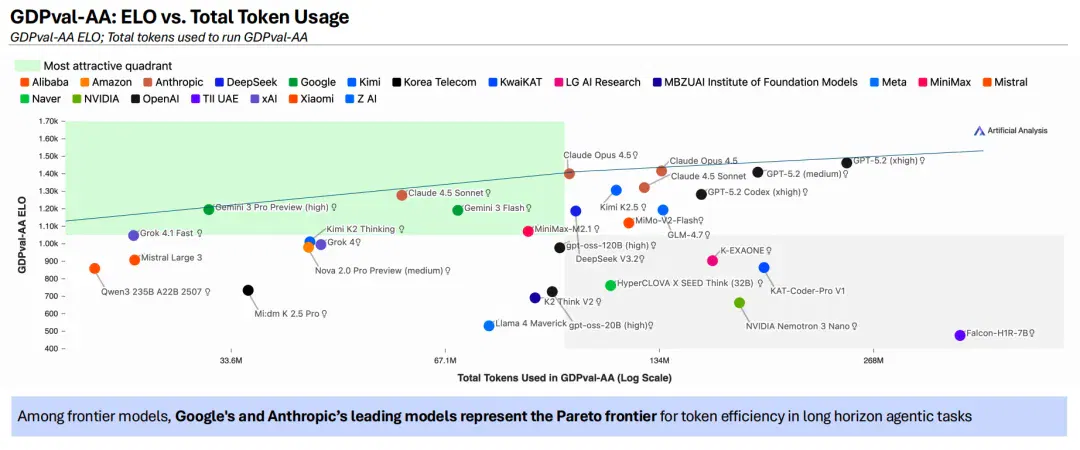
6、当我们转向智能体工作流时,输出 token 的数量多并不意味着智能更高;真正的智能更依赖于对各类工具的有效运用。
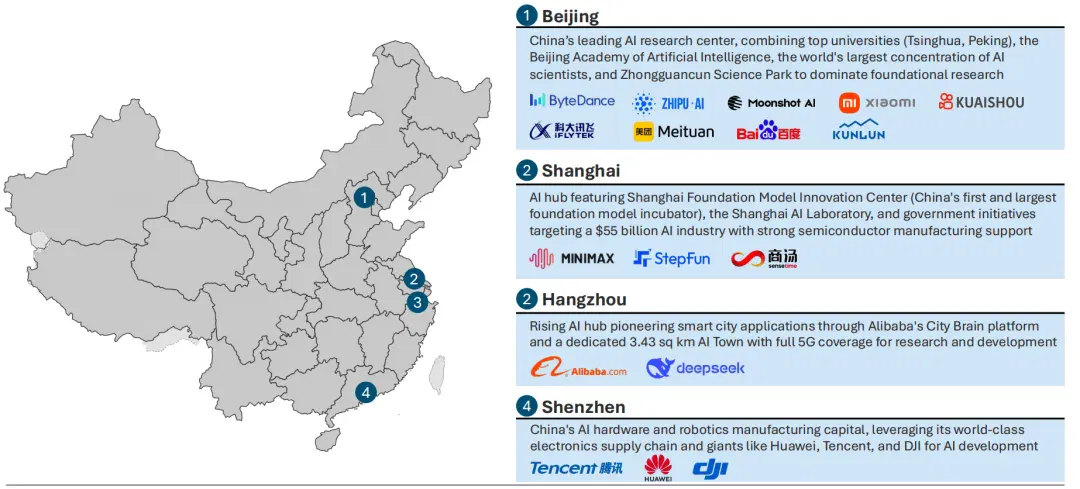
7、北京正崛起为前沿 AI 初创企业的活力中心,而成熟的科技巨头则地理分布更分散,不存在单一的技术创新枢纽。
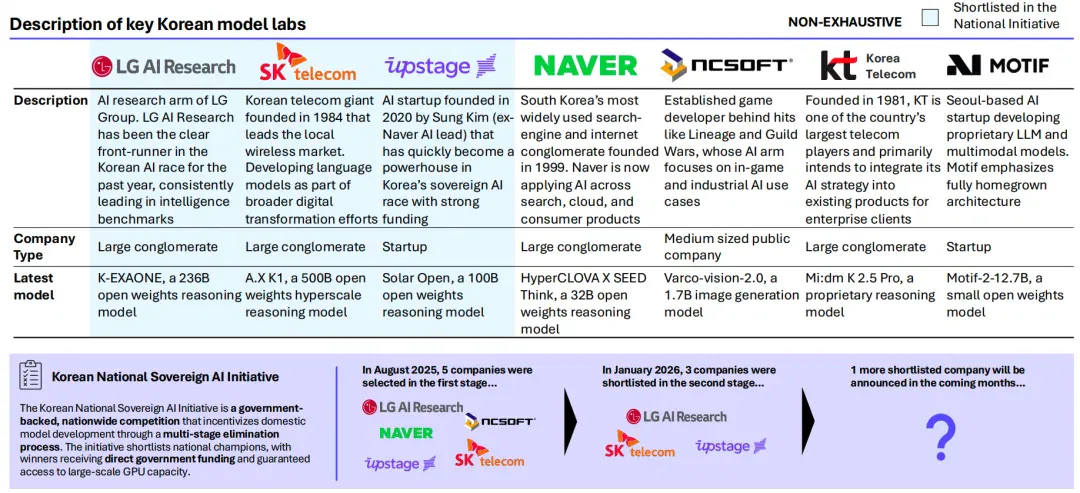
8、韩国政府支持的“国家 AI 计划”已经激活了本土 AI 生态系统,催生出多家接近前沿水平的 AI 实验室。
9、OpenAI 推出了自 GPT-2 以来首个开源权重语言模型,虽推动了开源模型的技术边界,但开源与闭源之间的差距仍未缩小。
10、更高效的模型架构,加上软硬件效率的协同提升,推动模型成本显著下降:o1 级别智能模型的每 token 定价降低了 128 倍。
图像与视频
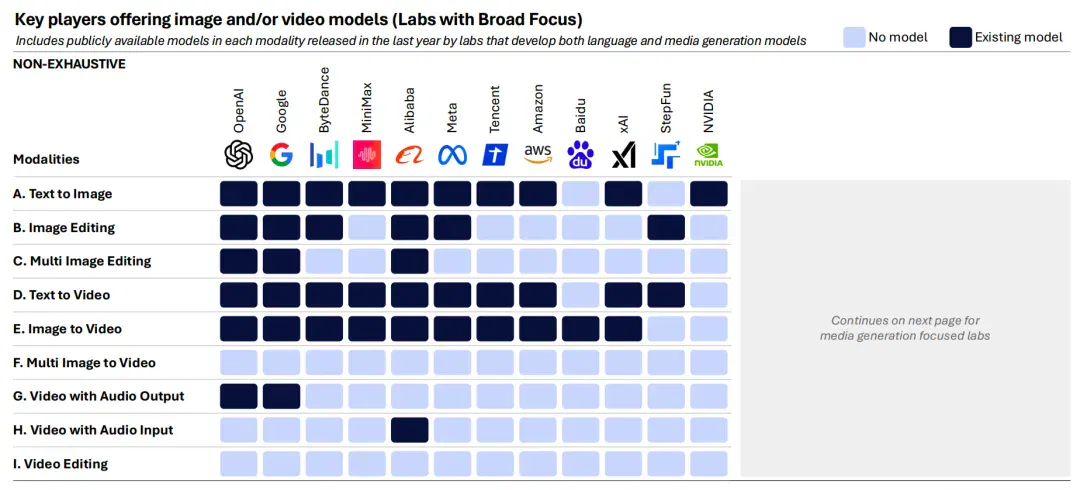
2025 年,图像与视频技术迎来重大升级:
新增了多模态输入(图像转视频、图像编辑)以及输出(带音频的视频)功能。
2025 年的 AI 图像与视频领域的趋势如下:
1、文生图:画质再上新台阶。
文本生成图像模型的质量已显著提升,2025 年末的标杆模型 GPT Image 1.5,比 2024 年末的第一名 FLUX1.1 [pro] Ultra 高出约 150 个 ELO 评分。
随着 OpenAI、Google 等头部实验室入局,开源权重图像模型的进展已经放缓。截至年底,表现最好的开源权重模型是 Qwen Image 2512,在文本转图像排行榜上位列第 12 名。
2、图像编辑模型正式发布。
指令驱动的图像编辑模型近期开始流行。OpenAI 推出 GPT-4o 图像功能、谷歌发布 Nano Banana(即 Gemini 2.5 Flash),这两款产品的上线大幅提升了这类工具的使用率和用户心智份额。
图像编辑中的多图输入功能已逐渐普及,像 Nano Banana Pro 和 Qwen Image Edit 这类模型,能让用户对输出图像实现更精准的控制。
图像生成模型正变得越来越通用,既能支持文本生成图像,也能进行图像编辑。例如 FLUX.2 系列和 Seedream 4.5 就同时具备这两种模态的能力。
3、视频模型已成功跻身主流。
视频模型的质量迎来突破性进展。2025 年末的领先产品 Runway Gen-4.5,在 ELO 评分(一种常用的模型性能评级指标)上比 2024 年末的行业标杆 OpenAI Sora 高出约 200 分。
聚焦图像转视频功能推动了广泛使用:用户不仅能更精细地控制视频生成,还能在不同镜头间保持角色的一致性。
开源权重视频模型目前仍落后于闭源同类产品。其中,LTX-2 Pro 作为开源视频生成领域的 SOTA,在文本转视频总榜中排名第 29 位,在图像转视频总榜中则位列第 28 位。
4、Veo 3 起开始支持带音频的视频功能。
2025 年 5 月推出的 Veo 3,是首个原生支持音频生成的高质量主流视频模型,而这一特性让它迅速走红。
各大视频实验室纷纷跟进,推出了自家带音频的视频模型,比如 OpenAI 的 Sora 2、Lightricks 的 LTX-2、阿里巴巴的 Wan 2.6 和字节跳动的 Seedance 1.5 pro。
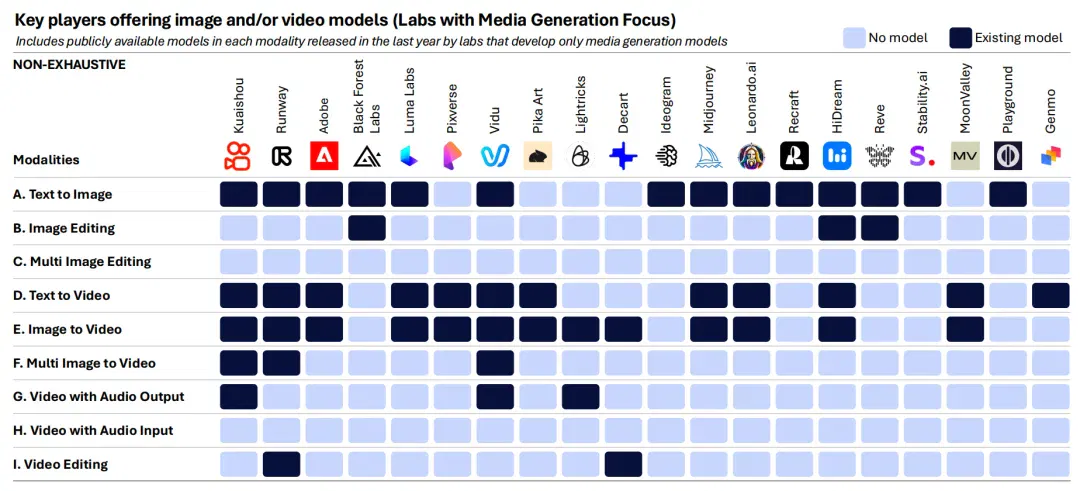
5、中国在媒体生成模型领域与美国旗鼓相当。
中美实验室在图像生成模型领域依然旗鼓相当:字节跳动的 Seedream 4.5 能与谷歌的 Nano Banana Pro、OpenAI 的 GPT Image 1.5 一较高下。
中美实验室在视频生成模型领域依然势均力敌:中国的 Kling 2.5 Turbo 与美国的 Veo 3.1、Runway Gen-4.5 不相上下。
编者注:到了 26 年 2 月份,中国的 Seedance2.0 让世界望尘莫及。
6、与语言模型领域不同,专注于媒体生成的小型 AI 实验室,仍能与那些拥有更广泛模态覆盖范围的大型实验室展开竞争。
语音与音乐
语音与音乐模型在第四季度持续进步:
其中语音到语音推理,和开源权重语音转文字的准确率提升尤为显著。
2025 年的 AI 语音与音乐领域的趋势如下:
1、语音转文字的词错误率持续降低。
多模态模型正将转录作为次要功能进行拓展,像 AWS 的 Nova 2 Omni,即便没有专门优化语音转文本,也能达到有竞争力的准确率,还能实现语音、视觉与文本的统一处理。
面向语音助手应用的超低延迟实时版本已陆续出现,例如 ElevenLabs 的 Scribe v2 Realtime 和 NVIDIA 的 Parakeet Realtime。
2、文本转语音模型,现在能更精细地控制韵律和音频效果。
文本转语音的质量已取得显著提升,新模型持续迭代推出,不断突破技术前沿。
韵律控制在主流 AI 模型中越来越普及,它能通过文本内标记和语音合成标记语言(SSML)标记等方式,实现对情感基调、语速、重音以及副语言元素(如笑声、叹气、呼吸声)的精准控制。
语音克隆技术(包括名人语音合成)正日益普及,这促使人们通过水印技术和来源验证系统,更加重视音频内容的真实性。
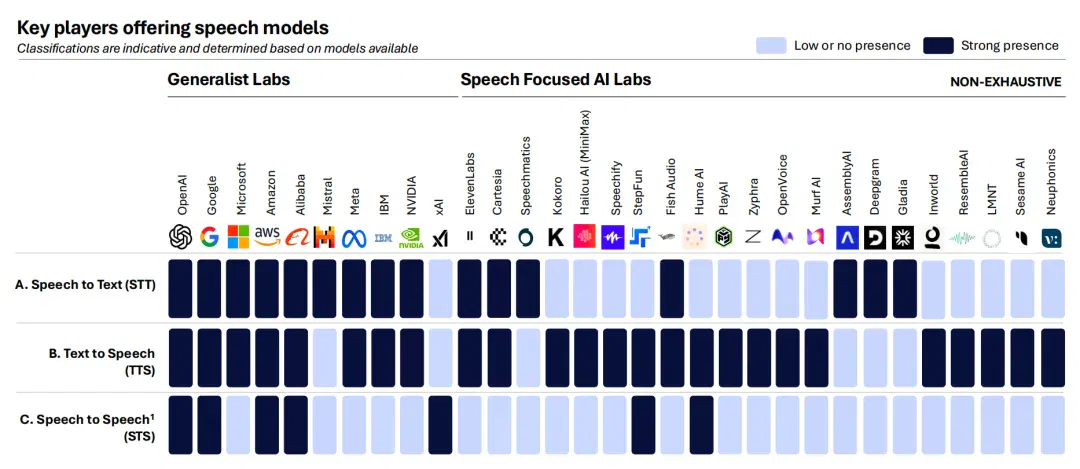
3、原生音频推理技术持续进步,STS 模型也迎来快速成熟。
xAI 在 Big Bench Audio 基准测试中一举夺魁:不仅推理速度更快,还把此前的领头羊 Google Gemini 2.5 Native Audio Thinking 拉下了王座;与此同时,Nova 2.0 Sonic 凭借高性价比脱颖而出,成为新的性价比之王。
目前,语音处理流水线仍是语音智能代理的主流架构。但原生音频推理能力的提升,正验证着端到端音频处理的价值:它能省去大语言模型的中间层,让模型直接利用声学信息进行推理,既增强了上下文理解能力,又降低了延迟。
4、语音 Agent。
在结构化交互场景下的表现已接近人类水平,但在模糊场景、复杂多轮推理以及音质受损的环境中仍存在明显不足,这些方面有待持续改进。
5、音乐模型。
2025 年虽有不少重磅模型发布,但第四季度的头部产品上新相对平静。不过,Suno V4.5、ElevenLabs Music 及 Producer.ai 的 Fuzz 系列等头部模型的营销力度和用户采用率仍在增长。
6、虽然通用 AI 实验室(比如 OpenAI、谷歌)的产品覆盖了所有语音模态,但纯语音 AI 实验室的专注度更高,尤其是在文本转语音领域。
芯片加速器
2025 年,AI 基础设施迎来显著成熟:Blackwell 系统开始批量出货,推理软件愈发完善,行业内的挑战者也在持续迭代升级。
2025 年的芯片相关趋势如下:
1、Blackwell 系统正式投产,性能较 Hopper 系统有大幅提升。
2025 年,B200 芯片开始大规模支撑生产级工作负载,GB200 NVL72 机架级系统也实现全面量产。IBM 的 Granite 4 系列模型是首批公开宣布基于 GB200 NVL72 集群训练的模型之一,而 OpenAI 的 GPT-5.3 Codex 则是首个明确披露使用 GB200 训练的前沿大模型。
英伟达计划在 2025 年第三季度发布 B300 和 GB300 两款新品,具体发货时间将在后续公布。其中 B300 的配置升级显著:配备 288GB HBM3e 内存(较上一代 B200 提升 50%),FP4 精度运算能力达 14 PFLOPs(而 B200 仅为 9 PFLOPs)。
软件支持日趋成熟(尤其是 TensorRT-LLM 框架),Blackwell 系列芯片现在在推理性能的整个帕累托前沿(即性能与效率的最优权衡边界)上,全面领先 Hopper 芯片及其他 AI 加速器。
2、推理软件已向三大开源框架集中。
2025 年,推理软件成熟度大幅提升,最终收敛到三个主流框架:vLLM、SGLang 和 NVIDIA TensorRT-LLM。
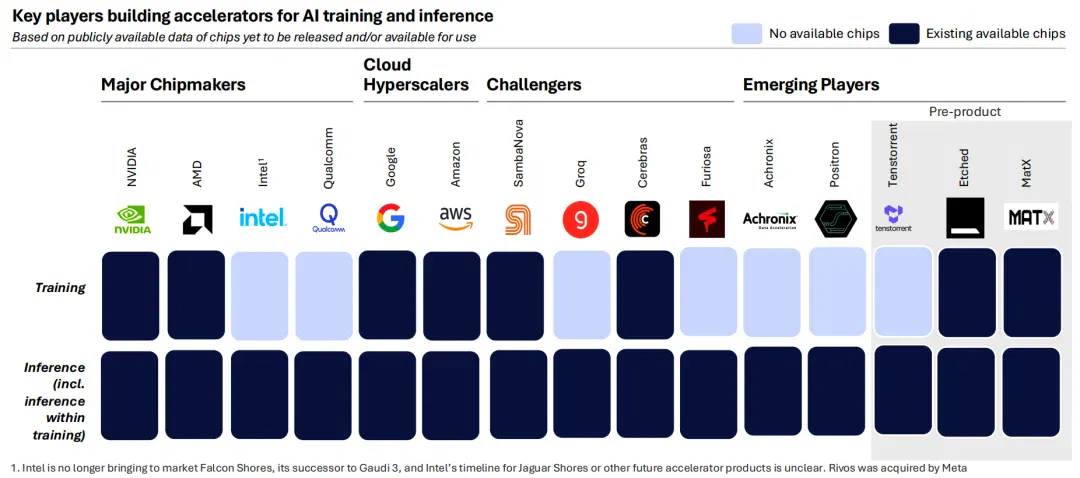
3、NVIDIA 依旧牢牢占据着市场主导地位,但它的挑战者们已在战略层面取得了显著进展。
2025 年 12 月,英伟达以约 200 亿美元收购了 Groq 公司。交易采用 IP 授权加人才收购的模式,核心目标是将 Groq 的 LPU 技术整合到英伟达的产品线中。
Google 的 TPU v6(Trillium,张量处理单元)已于 2024 年底正式发布;正是这些 TPU 为 Gemini 2.5 Pro 和 Gemini 3 Pro 的模型训练提供了算力支持。
Anthropic 在 2025 年与谷歌、亚马逊达成合作协议,获取张量处理单元(TPU)和 Trainium 芯片的使用权,用于模型训练和推理任务;与此同时,赛睿思(Cerebras)联合英伟达、超威半导体(AMD)和博通,与 OpenAI 签署了一份多年期合同,将为其提供快速推理服务。
4、推理需求持续增长,工作负载模式不断演变。这两大趋势正推动分布式和解耦架构在 2026 年前加速落地。
过去只有前沿实验室才能用到的分布式推理优化技术,如今正变得人人可用。这背后离不开 NVIDIA Dynamo 的成熟,以及各类开源项目的推动。
其中的核心技术包括:预填充/解码解耦、跨数十到数百个 GPU 的专家并行,以及通过规模化专家副本实现的新型负载均衡。
文章来自于微信公众号 "特工宇宙",作者 "特工宇宙"
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
terminal-mac gives agents a virtual Mac desktop and MCP control interfaces (opens in a new tab)
The author describes installing terminal-mac on Apple Silicon, viewing its desktop inside a terminal and using MCP controls. The report covers isolation and shared directories, while noting compatibility, resource and permission limits and the outer agent's host access.
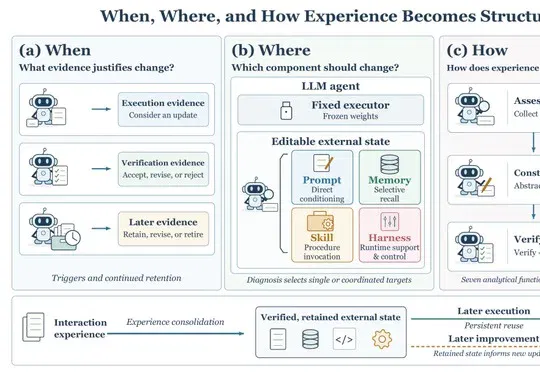
CAS Institute of Automation and partners survey how experience becomes improvement in agent RSI (opens in a new tab)
The paper compares Prompt, Memory, Skill and Harness evolution through a seven-step lifecycle, emphasizing independent verification, regression checks and long-term maintenance.
Tsinghua survey reviews embodied autonomous systems, data and evaluation through an agent lens (opens in a new tab)
The survey organizes research around perception, planning, execution and feedback, proposes levels of human-machine responsibility, and discusses cloud-edge-device coordination, safety and evidence for cross-task validation.
Agent MechSuits 在三款模型上测试命令行风险检测 (opens in a new tab)
该方法用线性探针判断当前步骤风险,并在单层的 10 个隐藏维度实施干预。论文报告平均检测准确率 97.32%,对环境提示注入仍有限制。
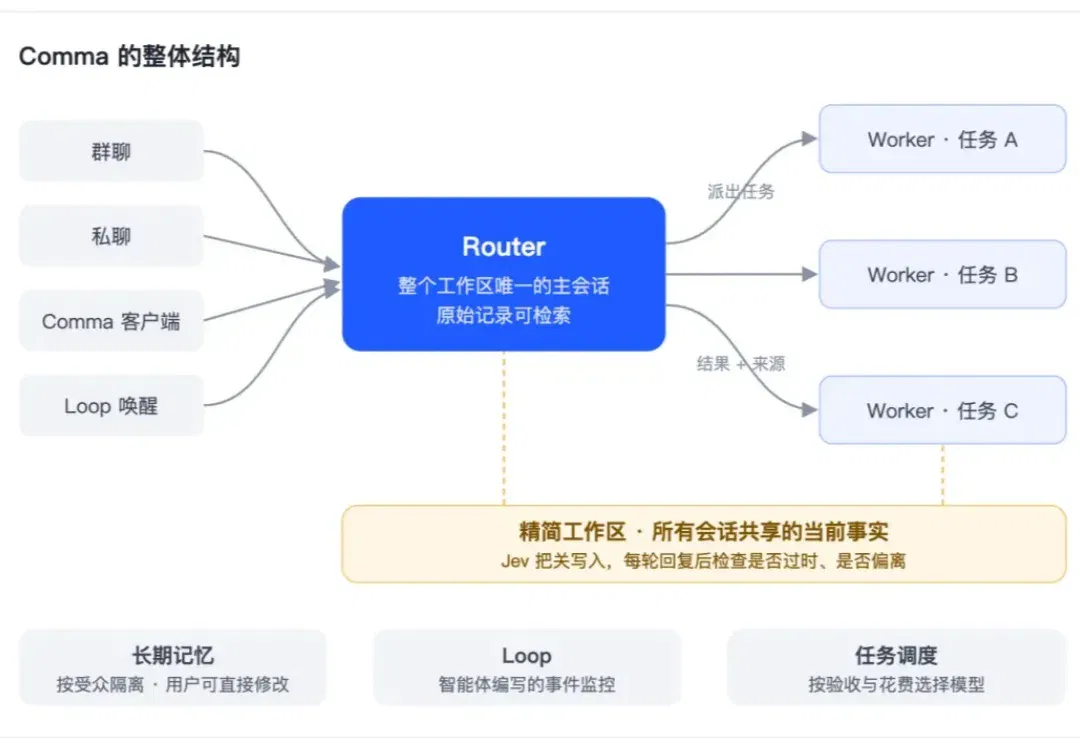
Comma 介绍常驻型 Agent 的主会话、长期记忆与任务调度 (opens in a new tab)
Comma 用常驻Router汇总请求,把具体工作委派给Worker,并通过共享事实清单、按受众划分的记忆与事件监控维持上下文。团队还介绍依据人工验收和费用调整模型分工;这套工程设计不等于记忆与权限判断必然无误。