端到端智驾新SOTA | KnowVal:懂法律道德、有价值观的智能驾驶系统
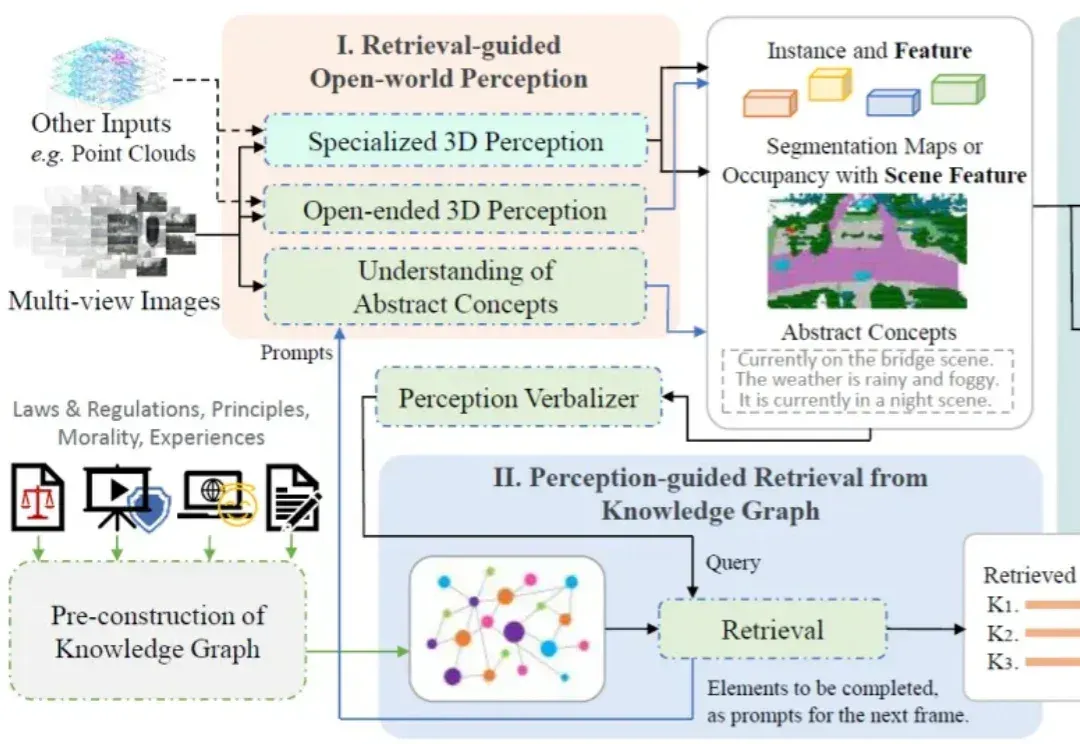
一个智能驾驶系统,在迈向高阶自动驾驶的过程中,应当具备何种能力?除了基础的感知、预测、规划、决策能力,如何对三维空间进行更深入的理解?如何具备包含法律法规、道德原则、防御性驾驶原则等知识?如何进行基本的视觉 - 语言推理?如何让智能系统具备世界观和价值观?
一个智能驾驶系统,在迈向高阶自动驾驶的过程中,应当具备何种能力?除了基础的感知、预测、规划、决策能力,如何对三维空间进行更深入的理解?如何具备包含法律法规、道德原则、防御性驾驶原则等知识?如何进行基本的视觉 - 语言推理?如何让智能系统具备世界观和价值观?
来自北京大学王选计算机研究所王勇涛团队的最新工作 KnowVal 给出了一种有效可行的方案。
- 论文标题: KnowVal: A Knowledge-Augmented and Value-Guided Autonomous Driving System
- 论文链接:https://arxiv.org/abs/2512.20299
本工作提出了一种新型自动驾驶系统 KnowVal,该系统通过感知模块与知识检索模块的协同作用,实现视觉 - 语言推理能力。
团队构建了涵盖交通法规、防御性驾驶原则与道德考量的综合驾驶知识图谱,并为其开发了高效的基于大型语言模型的检索机制。通过设计集成世界模型与价值模型的规划器,从而实现价值对齐决策。同时构建了人类偏好数据集用于训练价值模型。
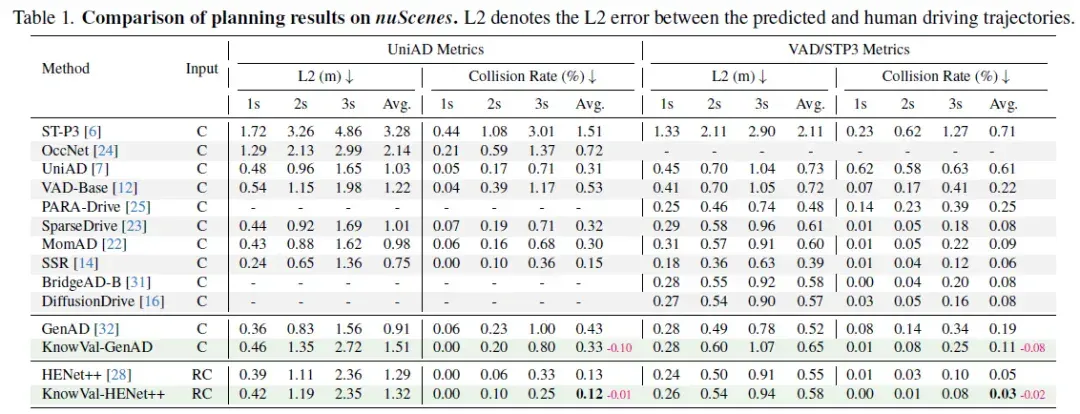
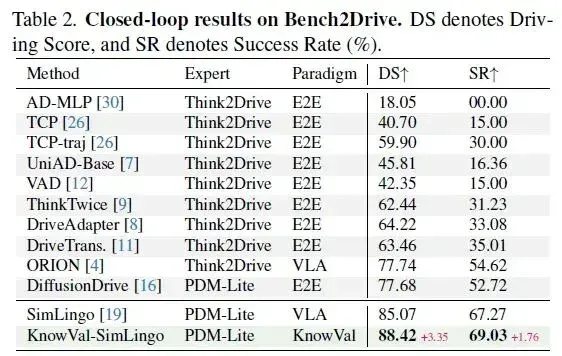
实验表明,KnowVal 兼容现有的端到端和 VLA 方法,在 nuScenes 数据集上实现了最低碰撞率,并在 Bench2Drive 基准测试中取得了最先进的性能表现。
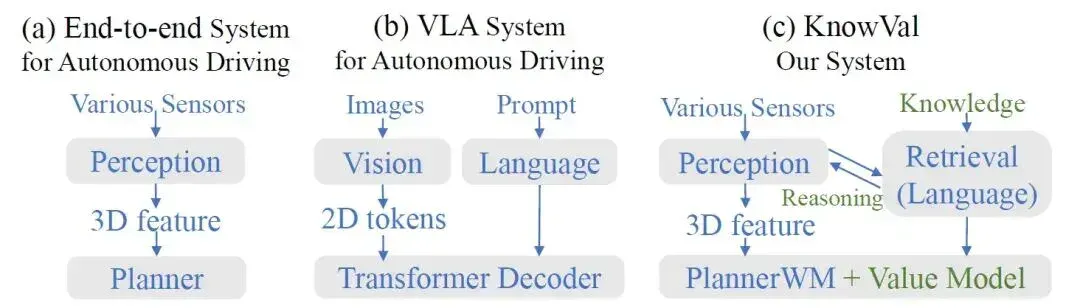
KnowVal 系统框架:
开放三维感知与知识检索
相互引导的视觉 - 语言推理
相比于当前主流的端到端自动驾驶系统和视觉 - 语言 - 动作(VLA)系统,KnowVal 将视觉 - 语言范式升级为开放三维感知 - 知识检索范式,并通过感知和检索的相互引导,实现了基础的视觉 - 语言推理:
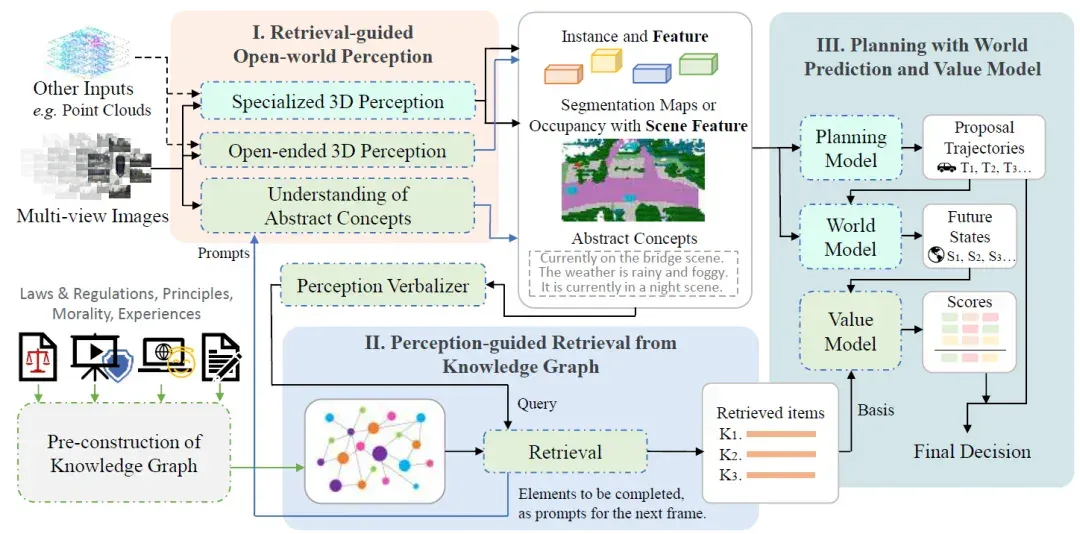
检索引导的开放世界感知
通过自动驾驶领域专用感知和开放式三维感知,能够抽取常见实例与长尾实例的 3D 目标检测结果与实例特征,以及面向开放世界的全场景占据栅格预测与体素特征,抽取特征保证了整个系统的特征传递与可导;同时,通过利用轻型 VLM 实现的抽象元素理解,能够对上一时间帧知识检索分支要求的信息进行补充,针对「是否是隧道、桥梁场景?是否是夜间场景?」等抽象概念进行自然语言描述。
感知引导的知识图谱检索
将感知信息进行自然语言化,对包含了法律法规、道德原则、防御性驾驶原则等知识的知识图谱进行检索,得到多条相关性由高到低排列的知识条目以及其 Token。
基于世界预测和价值模型的轨迹规划
通过规划模块和世界模型模块的多轮迭代,得到多条候选自车轨迹、对应的其他物体的运动预测与隐式世界状态。价值模型以上述信息为输入,针对每条候选轨迹和检索得到的知识,进行价值评估,最终选定规划轨迹。
该系统的各个模块之间保持了显式结果和隐式特征的共同传递,是可端到端微调的 3D 视觉 - 语言 - 动作框架。
驾驶知识图谱构建与知识检索
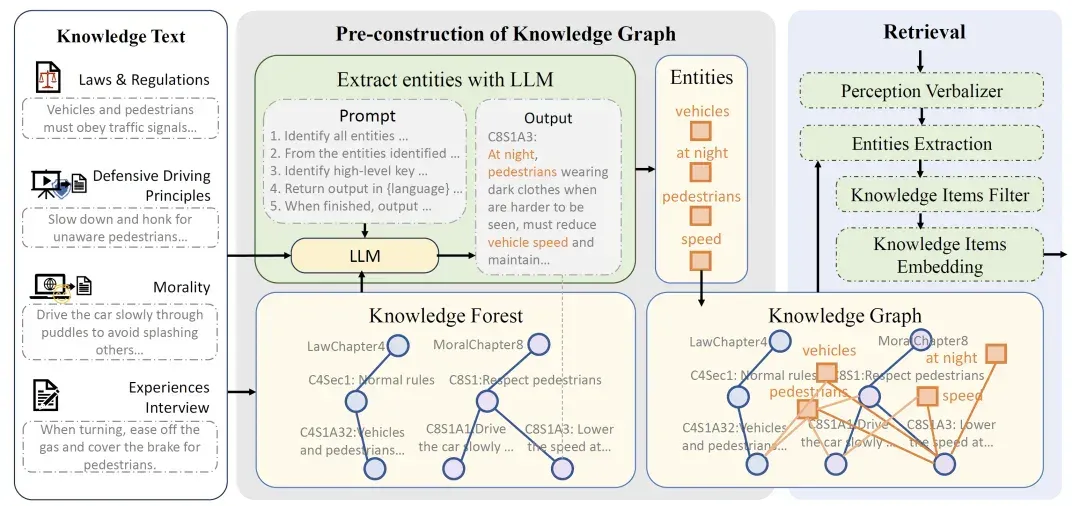
作者团队收集了多样化的驾驶相关资源——包括国家现行交通法律法规、防御性驾驶原则、道德准则以及经验知识访谈——并依据文本结构构建了初始的知识森林。
随后利用大语言模型抽取实体并定义节点与边,形成结构化的知识图谱。在推理过程中,KnowVal 生成富含三维感知信息的自然语言查询,通过实体抽取、知识条目过滤与向量化,从知识图谱中检索相关条目,并按相关性降序进行排序。
价值模型构建与
基于价值模型的轨迹规划
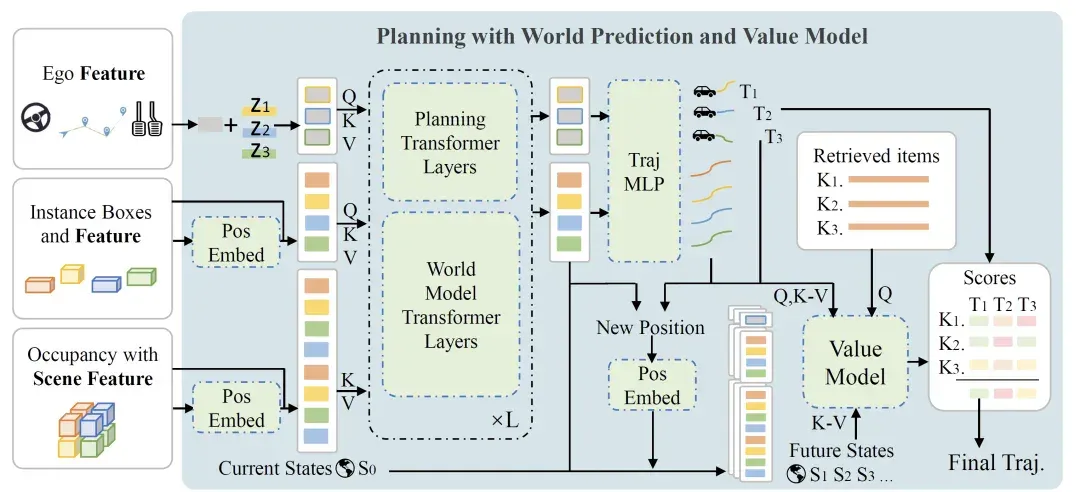
KnowVal 提供了一种与现有端到端和 VLA 模型兼容的改造方式,针对其轨迹规划 Transformer 或 RNN 进行改造,引入对自车查询叠加的多条预设高斯噪声和多样性约束损失函数,使其具备生成多样化候选轨迹的能力。
KnowVal 构建了一个大规模驾驶价值偏好数据集,用以训练价值模型。数据集选取了多个自动驾驶真实场景数据,通过规划模型预测和随机生成的方式获取多条轨迹,并保存其相应的场景状态(隐式特征向量与显式鸟瞰渲染图),并利用前述的检索方法得到多条知识,为每个轨迹 - 知识对进行介于 -1 到 1 之间的价值评分标注,最终得到包含 16 万个轨迹 - 知识对的数据集。
模型推理时,该模块以构造的多条自车特征和感知得到的实例特征与作为查询,以感知得到的全部信息作为键 - 值,通过规划模块和世界模型模块的多轮迭代,得到多条候选自车轨迹、对应的其他物体的运动预测与隐式世界状态;价值模型以上述信息为输入,针对每条候选轨迹和检索得到的每条知识,进行价值评估,并计算每条轨迹的降序加权平均分数,以最终选定规划轨迹。
实验结果
作者团队将 KnowVal 框架应用至 GenAD、HENet++ 与 SimLingo 三个基线模型,并在 nuScenes 开环端到端驾驶基准和 Bench2Drive 闭环端到端驾驶基准上进行了测试。KnowVal 范式能够在 nuScenes 上取得最低的驾驶碰撞率,并在 Bench2Drive 上取得最高的驾驶分数和成功率。
现有基准测试对于法律和道德行为的评估并不够全面,因此,作者也提供了几个定性分析样例,以说明 KnowVal 的实际效果:
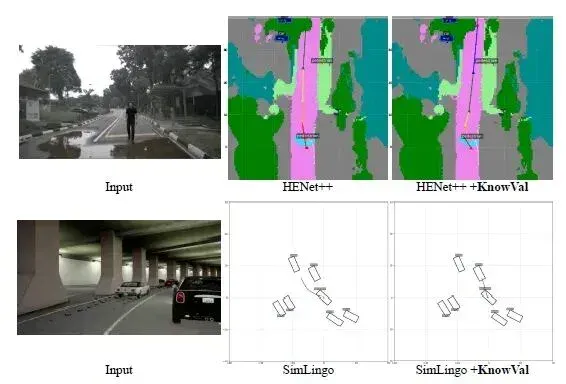
上图中两个样例,前者是在 nuScenes 真实数据上通过场景编辑得到,测试智能驾驶系统是否能够在路过积水时减速慢行、以免溅到行人;后者是在 CARLA 模拟器中隧道场景进行的测试,测试智能驾驶系统是否会遵循「隧道内 / 实线车道不能变道」的法律法规。实验结果说明,原本无法正确处理这些情况的端到端智驾模型,增加了 KnowVal 的知识检索与价值评估后,能够正确应对这些情形。
作者介绍
该论文的第一作者和通讯作者均来自北京大学王选计算机研究所的 VDIG (Visual Data Interpreting and Generation) 实验室,第一作者为北京大学博士生夏仲禹,通讯作者为博士生导师王勇涛副研究员。VDIG 实验室近年来在 CVPR、NeurIPS、IJCV、ICCV、ICML、AAAI、ECCV 等顶会顶刊上有多项重量级成果发表,多次荣获国内外 CV 领域重量级竞赛的冠亚军奖项,与国内外知名科研机构和企业广泛开展合作。
文章来自于“机器之心”,作者 “机器之心”。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Shanghai AI Lab details scientific multimodality and agent training in Sage S2.1 Flash (opens in a new tab)
Shanghai AI Lab and partner institutions released a technical report on the 320B MoE model Sage S2.1 Flash. The team evaluated tool use, scientific research and software operation on 33 benchmarks, with four scores leading the paper’s main comparison models.
ModelScope open-sources EntroPack for storage-budget-aware weight compression (opens in a new tab)
EntroPack combines E8 lattice quantization and entropy coding for adjustable-bitrate weight compression without activation calibration or fine-tuning. The team shows image-model inference and LLM LoRA training; the 9.4% to 4.26% reduction is configuration-specific weight-reconstruction error.
Singularity-Bench: Opus-built engine cuts P90 first-token wait to 0.48 seconds in coding replay (opens in a new tab)
The team replayed 16 concurrent coding sessions with one model on four GB300 GPUs, reporting P90 first-token latency of 0.48s for an Opus 5.5-built engine versus 12s for SGLang, with similar generation rates. The six human-scoped tasks do not establish full recursive self-improvement.
Hao Fei's perspective paper proposes a framework for AI 'cognitive symbionts' (opens in a new tab)
Hao Fei's 59-page perspective paper frames personal AI through Cognitive Symbionts, a cognitive gap and a symbiotic loop. It explores memory, timely intervention, learning, care, consent, privacy and governance, setting out concepts and evidence standards rather than a tested complete system.
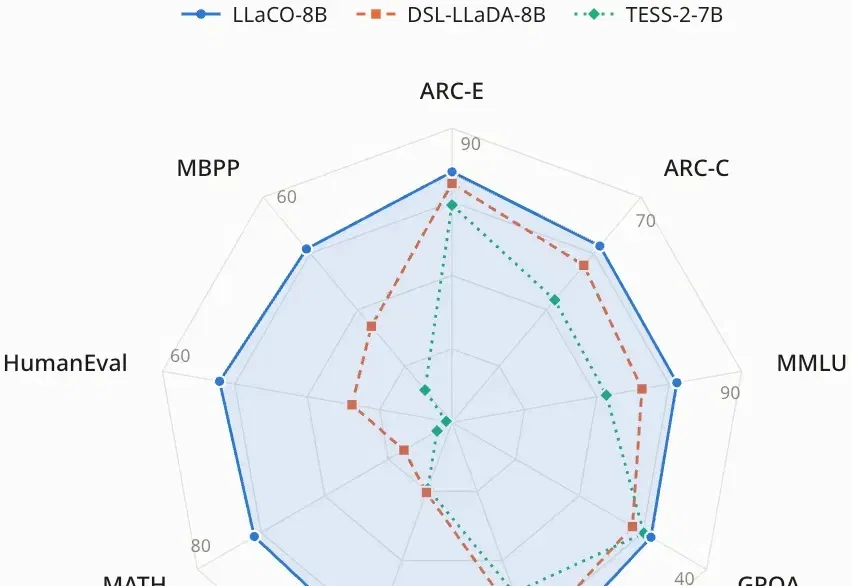
LLaCO team reports an 8B continuous diffusion model scoring 62.12 on MATH, ahead of tested baselines (opens in a new tab)
A BAAI, BUPT and Peking University team proposes LLaCO, adapting a pretrained model with spherical noising and semantic scheduling. It reports gains over tested continuous diffusion baselines on nine benchmarks and a MATH score of 62.12, 10.92 points above Dream-7B, within the paper’s settings.