Know AI. See What’s Next.
Slide 1 of 5: Anthropic’s rise: Claude commercialization, governance and AI safety disputes
Latest news
为什么谷歌搜不到「没有条纹的衬衫」|AI 上新 (opens in a new tab)
极客公园最近体验了一款叫做 Websets 的 AI 搜索工具。与谷歌搜索不同,Websets 试图理解人类的复杂意图。它并非为日常查询设计,而是专门处理传统搜索引擎难以完成的复杂任务,例如寻找具备特定复合经验的专业人士,或筛选符合多重标准的公司实体。
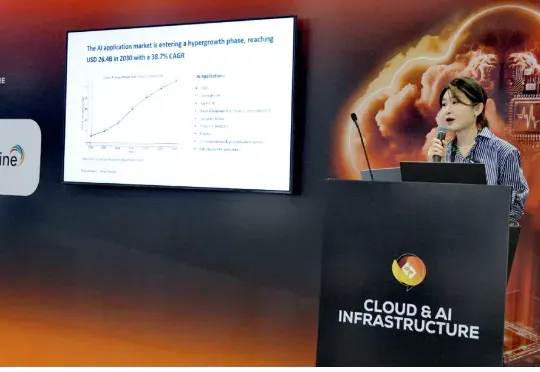
Zenlayer推出分布式推理平台,加速AI创新全球落地 | Alpha Family (opens in a new tab)
新加坡时间 10 月 9 日,Zenlayer 于新加坡科技周——云与 AI 基础设施展正式发布 Zenlayer 分布式推理平台(Zenlayer Distributed Inference)。该平台作为一站式 AI 即时部署解决方案,专注于在全球范围内为大规模 AI 推理提供高性能支持。
又一批AI社交产品悄悄「死亡」了 (opens in a new tab)
又一批AI社交公司与产品悄悄「死亡」了。今年9月,一批AI社交公司发布关停或通知,这之中,既包括大模型明星公司、社交公司等中型企业,如阶跃星辰To C产品「冒泡鸭」、Soul旗下的AI应用「异世界回响」等,也包括一批垂直领域的初创产品,如定位AI情感分析的Lumi、由前苹果设计师Jason Yuan创立的情感陪伴应用Dot等。
大模型追逐星辰大海,GPT和Gemini国际天文奥赛夺金 (opens in a new tab)
人工智能真是日新月异。早上看到网友的评论:我们已经 0 天没有吸引注意的 AI 领域新突破了。记得三个月前,OpenAI 官宣了他们的推理模型在国际数学奥林匹克(IMO)竞赛中获得了金牌。
告别「解码器饥饿」!中国科学院NeurIPS推SpaceServe,高并发克星 (opens in a new tab)
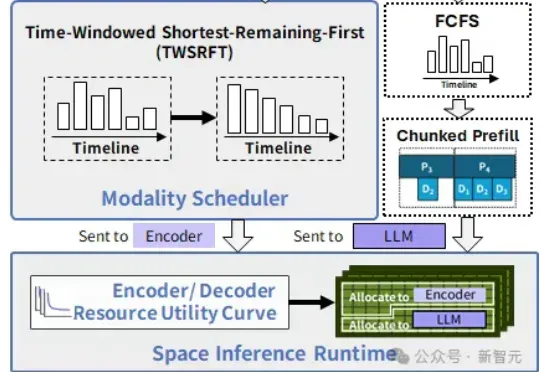
在中国科学院计算技术研究所入选NeurIPS 2025的新论文中,提出了SpaceServe的突破性架构,首次将LLM推理中的P/D分离扩展至多模态场景,通过EPD三阶解耦与「空分复用」,系统性地解决了MLLM推理中的行头阻塞难题。
ICLR 2026惊现SAM 3,分割一切的下一步:让模型理解「概念」 (opens in a new tab)
说出概念,SAM 3 就明白你在说什么,并在所有出现的位置精确描绘出边界。 Meta 的「分割一切」再上新? 9 月 12 日,一篇匿名论文「SAM 3: SEGMENT ANYTHING WITH CONCEPTS」登陆 ICLR 2026,引发网友广泛关注。
抖音&LV-NUS开源多模态新模,以小博大刷新SOTA,8B推理比肩GPT-4o (opens in a new tab)
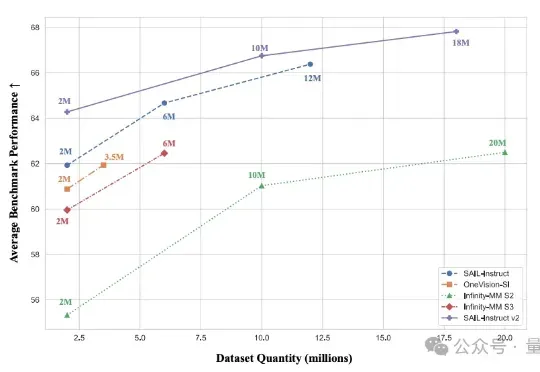
2B模型在多个基准位列4B参数以下开源第一。 抖音SAIL团队与LV-NUS Lab联合推出的多模态大模型SAIL-VL2。
Bug变奖励:AI的小失误,揭开创造力真相! (opens in a new tab)
扩散模型本该只是复制机器,却一次次画出「六指人像」甚至是陌生场景。最新研究发现,AI的「创造力」其实是架构里的副作用。有学者大胆推测人类的灵感或许也是如此。当灵感成了固定公式,人类和AI的差别还有多少?
为MoE解绑:全新「专家即服务」推理架构发布,超细粒度扩展锐减37.5%成本 (opens in a new tab)
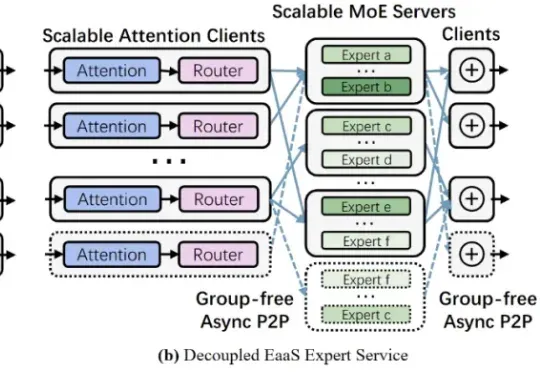
近年来,大型语言模型的参数规模屡创新高,随之而来的推理开销也呈指数级增长。如何降低超大模型的推理成本,成为业界关注的焦点之一。Mixture-of-Experts (MoE,混合专家) 架构通过引入大量 “专家” 子模型,让每个输入仅激活少数专家,从而在参数规模激增的同时避免推理计算量同比增长。
腾讯开源强化学习新算法!让智能体无需专家示范就“自学成才”,还即插即用零成本接入 (opens in a new tab)
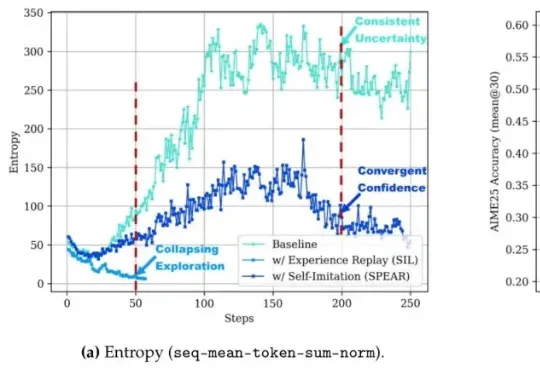
让智能体自己摸索新方法,还模仿自己的成功经验。腾讯优图实验室开源强化学习算法——SPEAR(Self-imitation with Progressive Exploration for Agentic Reinforcement Learning)。
NeurIPS 2025 Spotlight | GeoSVR:稀疏体素的新潜力——超越3DGS系列的高精度三维表面重建 (opens in a new tab)
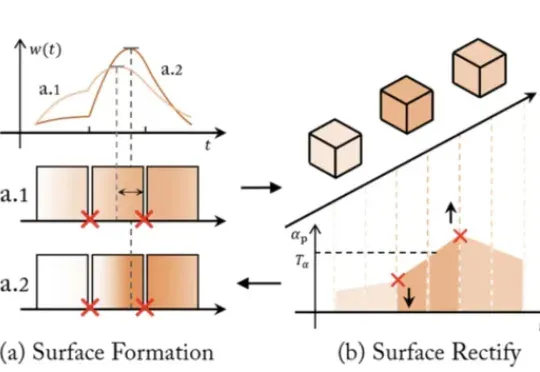
近年来,NeRF、SDF 与 3D Gaussian Splatting 等方法大放异彩,让 AI 能从图像中恢复出三维世界。但随着相关技术路线的发展与完善,瓶颈问题也随之浮现:
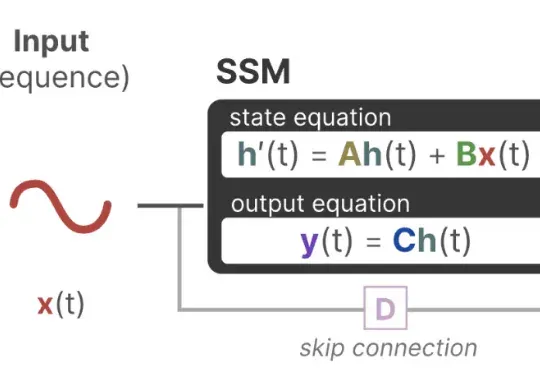
Mamba-3惊现AI顶会ICLR 2026!CMU知名华人教授一作首代工作AI圈爆红 (opens in a new tab)
曼巴回来了!Transformer框架最有力挑战者之一Mamba的最新进化版本Mamba-3来了,已进入ICLR 2026盲审环节,超长文本处理和低延时是其相对Transformer的显著优势。另一个挑战者是FBAM,从不同的角度探索Transformer的下一代框架。
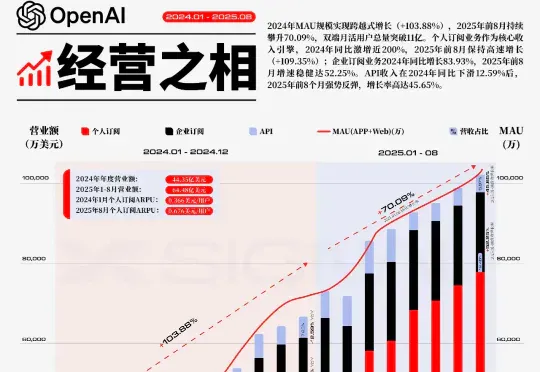
OpenAI 的颠覆革命|狂热的2024·沸腾的2025丨Xsignal (opens in a new tab)
2022年11月,OpenAI的ChatGPT问世,这一事件不仅是技术创新的里程碑,更被视为重塑全球AI战略版图的关键转折点,它标志着新一轮大国AI竞赛的序幕被正式拉开。在此背景下,其增长的规模与速度本身,就是一种颠覆性的战略壁垒。
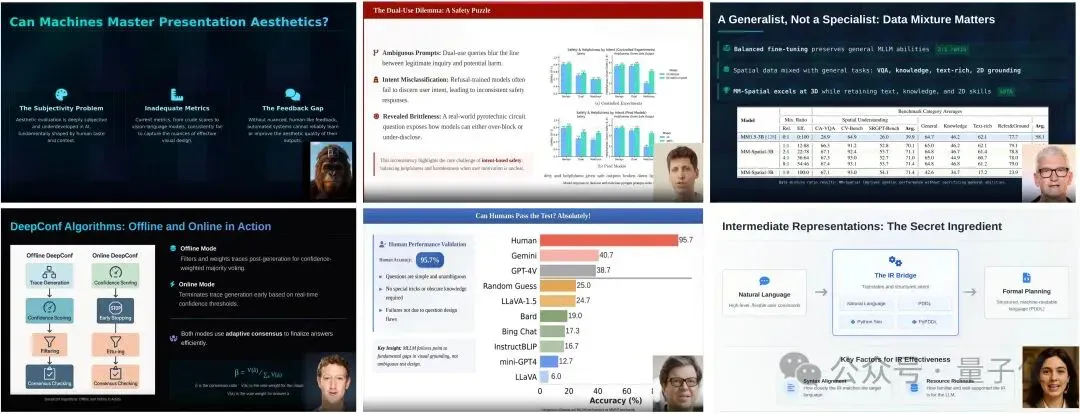
“AI版LeCun”自己讲解论文,自我进化智能体框架生成精美演讲视频 (opens in a new tab)
AI自己讲明白论文,还能生成更美观的幻灯片。加州大学圣塔芭芭拉(UCSB)与圣克鲁兹(UCSC)的研究者提出EvoPresent,一个能够自我进化的学术演讲智能体框架,让AI不仅能“讲清楚论文”,还能“讲得好看”。
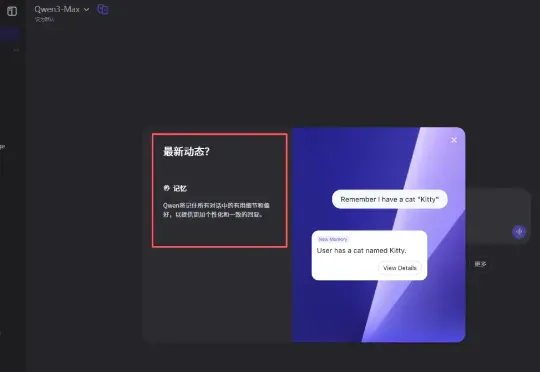
独家|Qwen、豆包内测记忆功能,全面对标ChatGPT,国产AI迈入新阶段。 (opens in a new tab)
近期,我们独家观察到,国内两家科技巨头——阿里巴巴和字节跳动——旗下的AI助手通义千问(Qwen)和豆包(Doubao),同时开始内测“记忆功能”。此举被广泛视为对标行业领头羊OpenAI的ChatGPT,标志着国产AI助手正从“即时问答工具”向“长期私人助理”的角色加速演进。
今天,好像见证了属于SD时代的消亡。 (opens in a new tab)
他们决定,把liblib升级到2.0,有新的品牌,有新的logo,有新的界面,有新的功能。liblib,国内最著名的模型开源社区,也是国内之前最大SD生态开源社区没有之一。但是这些东西都不重要。
第二代InfLLM开源,同尺寸快三倍!零参数,可训练稀疏注意力 (opens in a new tab)
InfLLM-V2是一种可高效处理长文本的稀疏注意力模型,仅需少量长文本数据即可训练,且性能接近传统稠密模型。通过动态切换短长文本处理模式,显著提升长上下文任务的效率与质量。从短到长低成本「无缝切换」,预填充与解码双阶段加速,释放长上下文的真正生产力。
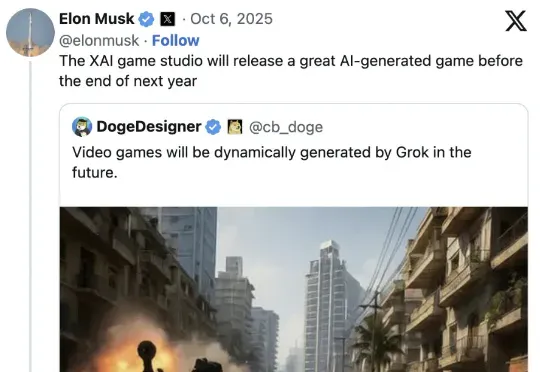
马斯克从英伟达挖人做AI游戏!第一步:研发世界模型 (opens in a new tab)
马斯克的xAI也入局世界模型了!据《金融时报》(FT)报道,为了增加这场“世界模型大混战”的赢面,今年夏天,xAI已经从英伟达挖来了多名资深研究员来助阵。另一边,在悄然下场世界模型后,马斯克几天前又在𝕏上再次重申了去年定下的那个“小目标”——
吴恩达Agentic AI新课:手把手教你搭建Agent工作流,GPT-3.5反杀GPT-4就顺手的事 (opens in a new tab)
吴恩达又出新课了,这次的主题是—Agentic AI。 在新课中,吴恩达将Agentic工作流的开发沉淀为四大核心设计模式:反思、工具、规划与协作,并首次强调评估与误差分析才是智能体开发的决定性能力:
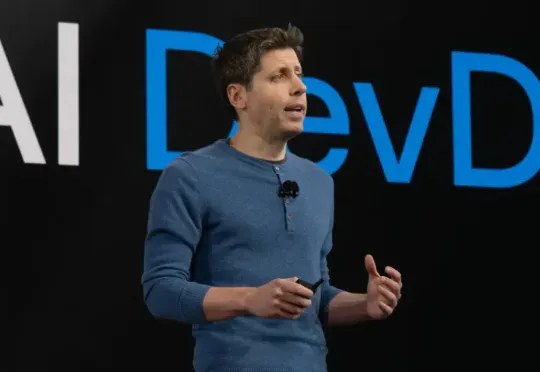
OpenAI预告了AI时代「Windows系统」的诞生|窄播Weekly (opens in a new tab)
这是《窄播Weekly》的第68期,本期我们关注的商业动态是:OpenAI在今年的DevDay上更清晰地向我们展示了如何构建一个AI时代的超级系统。就像OpenAI的CEO山姆·奥特曼在一档播客节目中所说,ChatGPT上线之后经历了两个关键的「惊喜」时刻,