
Know AI. See What’s Next.




Slide 1 of 5: 姜宇辉的AI分身:知识助手与“另一个自己”之间
Latest news
前豆包策略产品负责人孙展鹏创业,未见之境完成首轮融资 (opens in a new tab)
近日,前豆包策略产品负责人孙展鹏的初创公司未见之境完成首轮融资,投资方为红杉中国与Monolith砺思资本。
从 DeepSeek Super-agent 到 Comma:持续会话与多 Worker 的架构实践 (opens in a new tab)
文章将 DeepSeek 的 Super-agent 设计与 AFK 团队 Comma 的公开工程记录作比较,讨论主会话路由、独立 Worker、执行环境分离及多端交互。提前实现和未来产品形态属于报道及团队判断,实际系统仍需检验长期上下文、权限隔离与任务协作。
“我在Anthropic感到不安全”:一位Anthropic早期员工的回忆 (opens in a new tab)
Anthropic早期员工Ivan Vendrov在《Some Memories of Early Anthropic》中回忆,入职八个月后因AI安全使命与商业化、模型竞赛压力带来的精神重压选择离开,并质疑公司将谨慎服从的助手塑造为“受过创伤的官僚”。
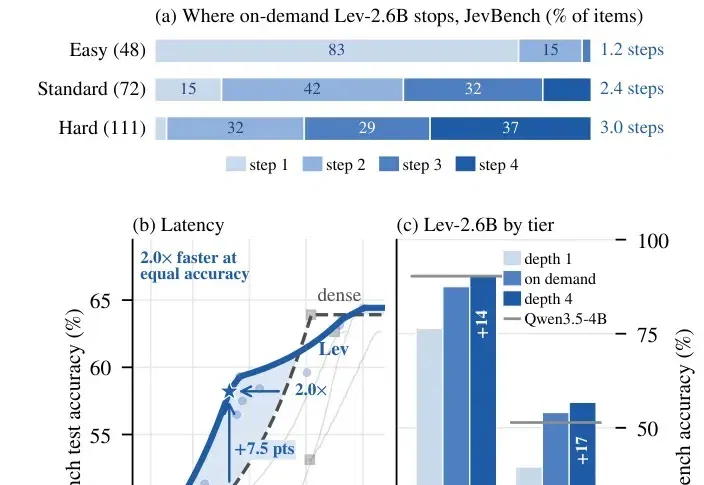
让决策模型学会「难题多想」:Lev用循环代替思维链,一份权重覆盖多个深度 (opens in a new tab)
Lev 将循环深度作为决策模型的计算预算,同一份权重可在不同圈数读出选项概率,再用停止机制按请求分配深度。实验显示额外计算主要帮助较难任务,同时也会改错部分答案;离线节省的循环计算量仍需服务端调度才能转化为实际吞吐收益。
AI融资遇冷意味着泡沫破裂吗?从债务评级、估值与现金流看争议 (opens in a new tab)
文章围绕 OpenAI 融资报价调整、Anthropic 算力融资与债务评级,以及科技公司财报引发的市场波动展开分析,区分贷款评级与公司评级、融资目标下调与相对上一轮估值下降等概念。对未来 IPO 和投资回报的判断仍属作者观点。
清华团队提出代数世界模型 AWM,探索游戏规则与形式化证明 (opens in a new tab)
AWM 将交互环境中的观察写成可执行假设,再通过实验修订与 Lean 4 形式化,尝试在游戏中解释可行路径和无解条件。团队报告了 ARC-AGI-3 任务结果,同时指出证明依赖于已建模的规则,遗漏环境机制时仍需重新探索和验证。
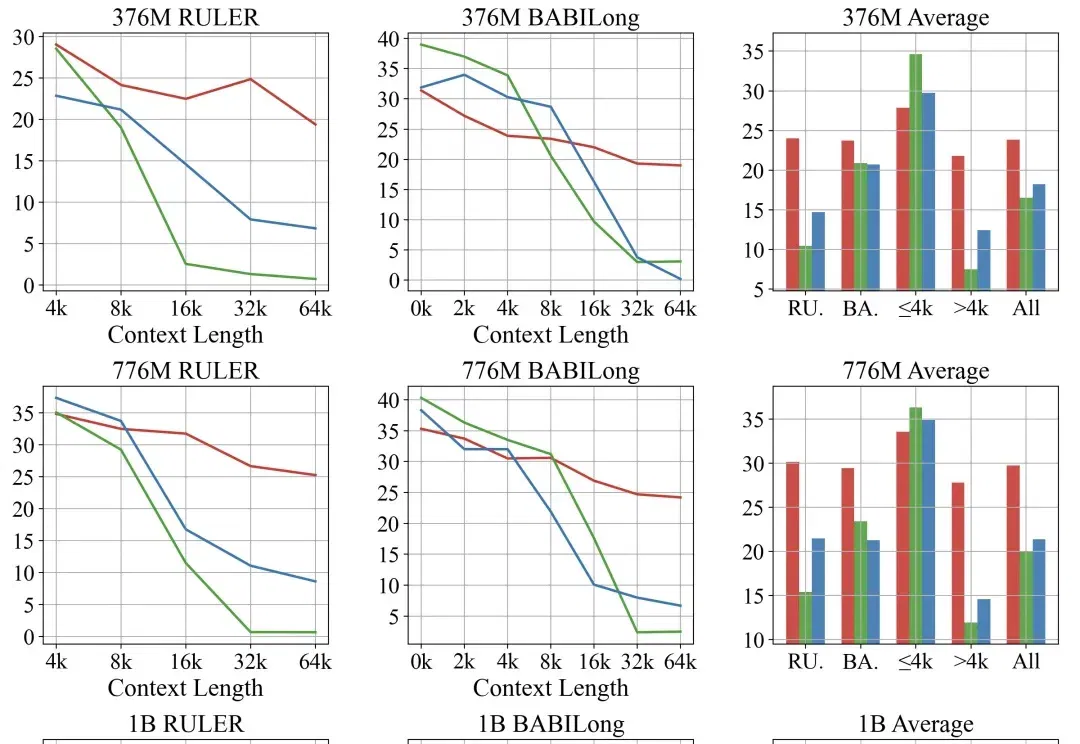
混合架构用线性注意力还是滑窗注意力?复旦创智OpenMOSS团队:我全都要 (opens in a new tab)
OpenMOSS 团队比较全注意力、滑窗和门控线性注意力在长文训练与长度外推中的配合。实验发现,无位置偏置的 NoPE 与带位置偏置模块各有分工;增大窗口、调整损失或限制推理时的相对位置范围,可分别改善不同架构的短板。
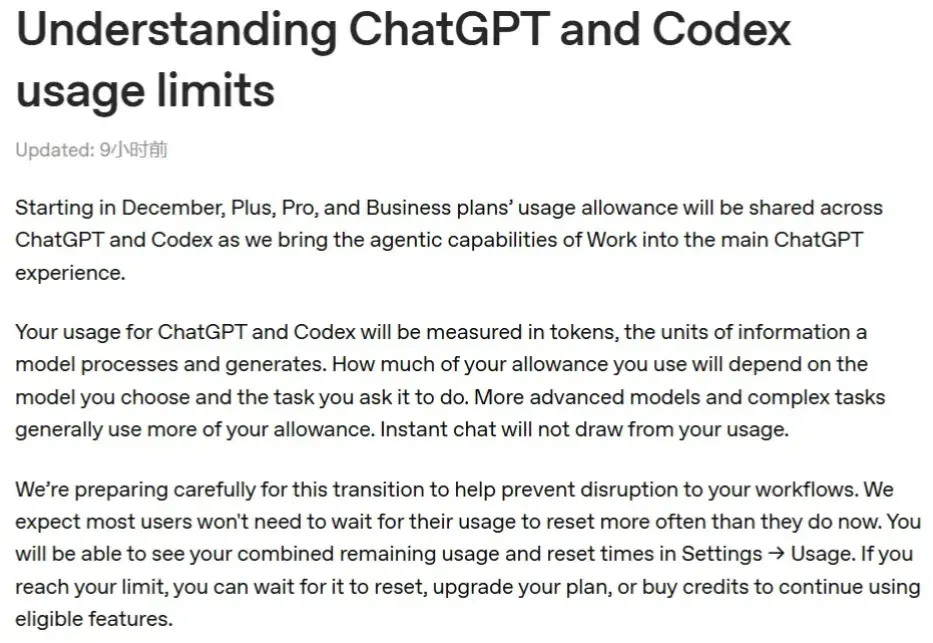
OpenAI 计划12月合并 ChatGPT 与 Codex 用量额度 (opens in a new tab)
OpenAI 公布12月起在 ChatGPT 与 Codex 间共享套餐用量的安排,Instant 聊天不扣减这份额度。近期 Pro 增额也有区别:Pro 100、500 的 Work/Codex 额度翻倍,Pro 200 仅原本较低的额度翻倍;以 token 衡量用量不等于按 API 价格逐次收费。
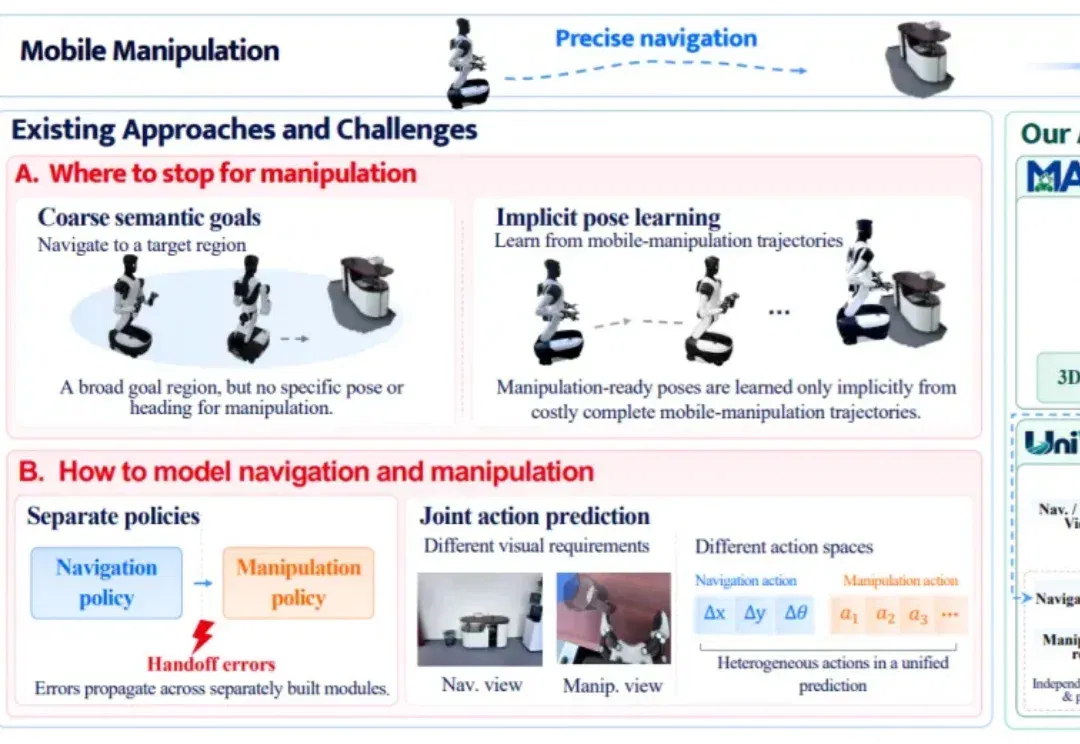
Fysiverse-UniWAM 连接导航与操作,在24项真机任务中测试统一能力 (opens in a new tab)
飞捷科思与复旦团队提出 Fysiverse-UniWAM,用操作锚定位姿 MAP 与共享骨干的双数据流连接导航和操作。团队构建150万余条生成轨迹,并在4种机器人平台的24项真机任务上报告停靠与操作表现,探索降低对完整移动操作示范的依赖。
GPT-6.2 Astra 与 Claude 5.5 出现新线索,发布时间仍待官宣 (opens in a new tab)
Anthropic 官网源码曝光 Claude Mythos 5.5,开发者还展示疑似 Claude Fable 5.5 生成的 3D 与交互作品;OpenAI 的 GPT-6.2 Astra 也现身 Codex 统计和 API 记录,但两家公司均未正式官宣。
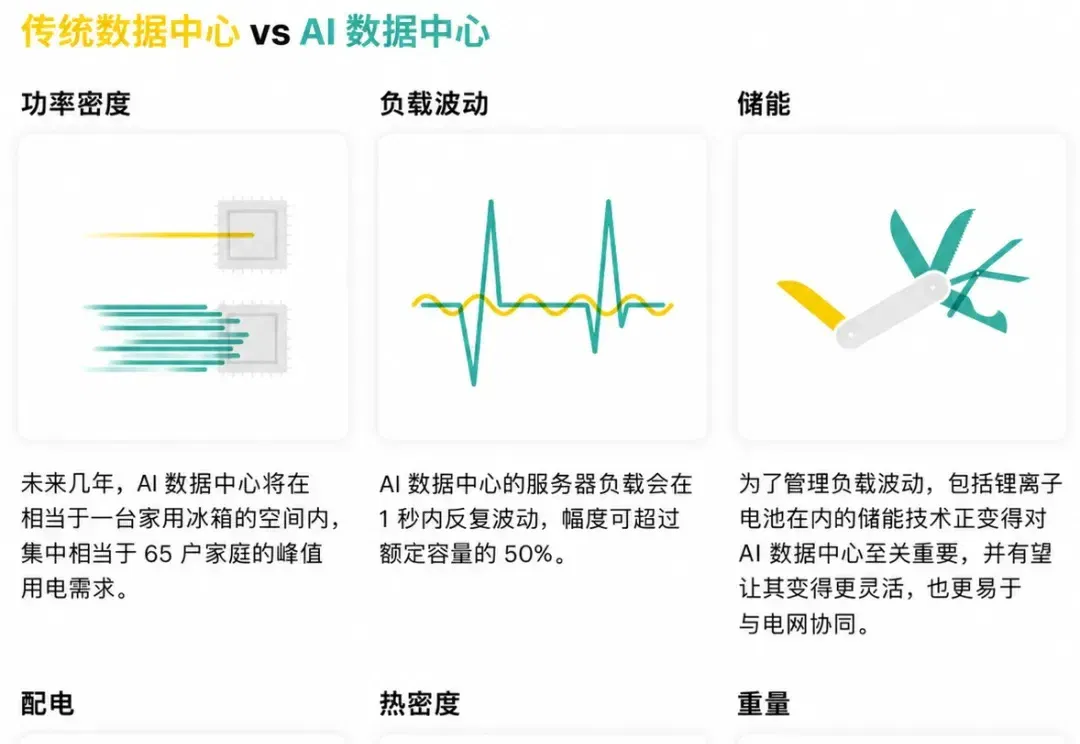
算力的尽头是电力?从第一性原理看AI基础设施 (opens in a new tab)
文章从电力、芯片与内存、散热、电网建设、融资和地方许可梳理 AI 基础设施的约束。结合 IEA 等资料,讨论任务能效提升为何未必降低总用电,以及芯片、数据中心和电网不同建设周期如何形成瓶颈,区分签约容量与实际通电能力。
奥特曼谈 AI 科研投入:未公开的数学发现与后续验证 (opens in a new tab)
奥特曼在 Cheeky Pint 访谈中谈到尚未公开的数学发现及成果发布的两难。文章结合研究者对数学手稿的修订、预印本中的大模型使用披露和生物学实验案例,讨论 AI 提出结果后,人类如何继续核查、解释与验证。
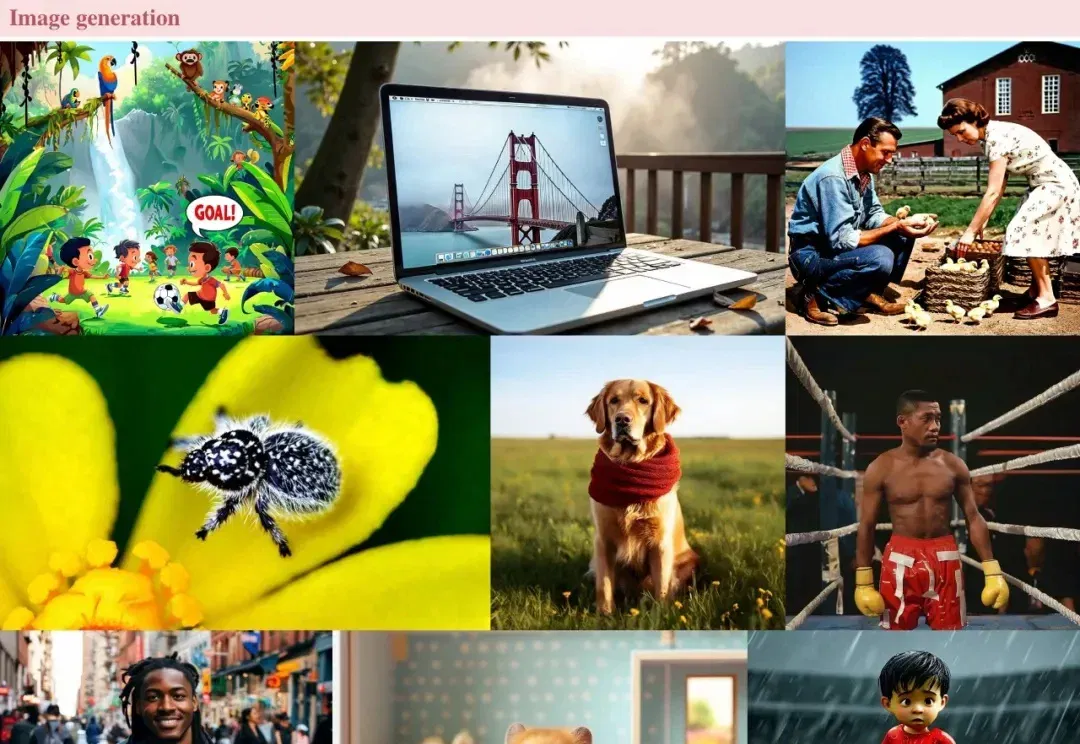
PixelUMM 开源:用原始像素统一图像与视频的理解、生成 (opens in a new tab)
英伟达与滑铁卢大学提出 PixelUMM,以线性投影将图像块和视频时空块接入多模态主干,统一理解与生成而不使用 ViT、VAE。论文比较 patch 大小、输出头和训练规模等设计,报告了与基线相当的综合表现,也指出像素网格伪影等局限。
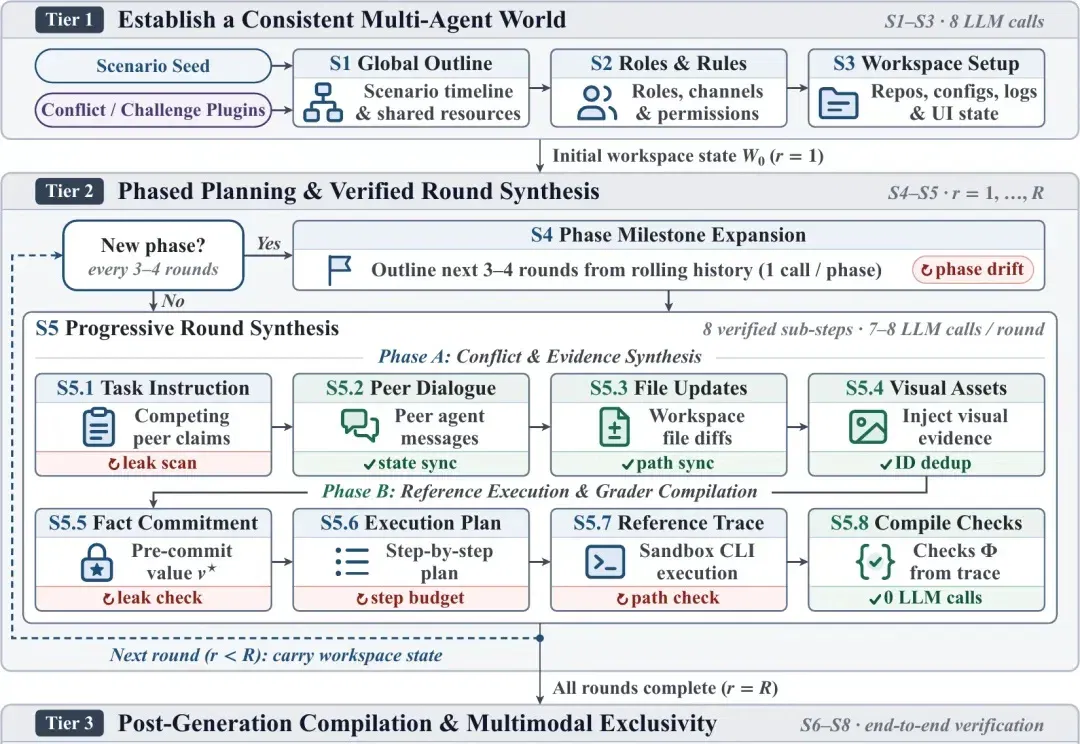
CLASHarness 开源:评测多智能体冲突中的取证、修复与交接 (opens in a new tab)
Google 等机构发布 CLASHarness,以600个可执行任务评测15个模型如何处理队友错误汇报、共享权限和文件冲突。研究显示,发现矛盾、真正修复系统和完成交接是不同难点;看图核实与合理的工具步数预算,对任务结果有明显影响。
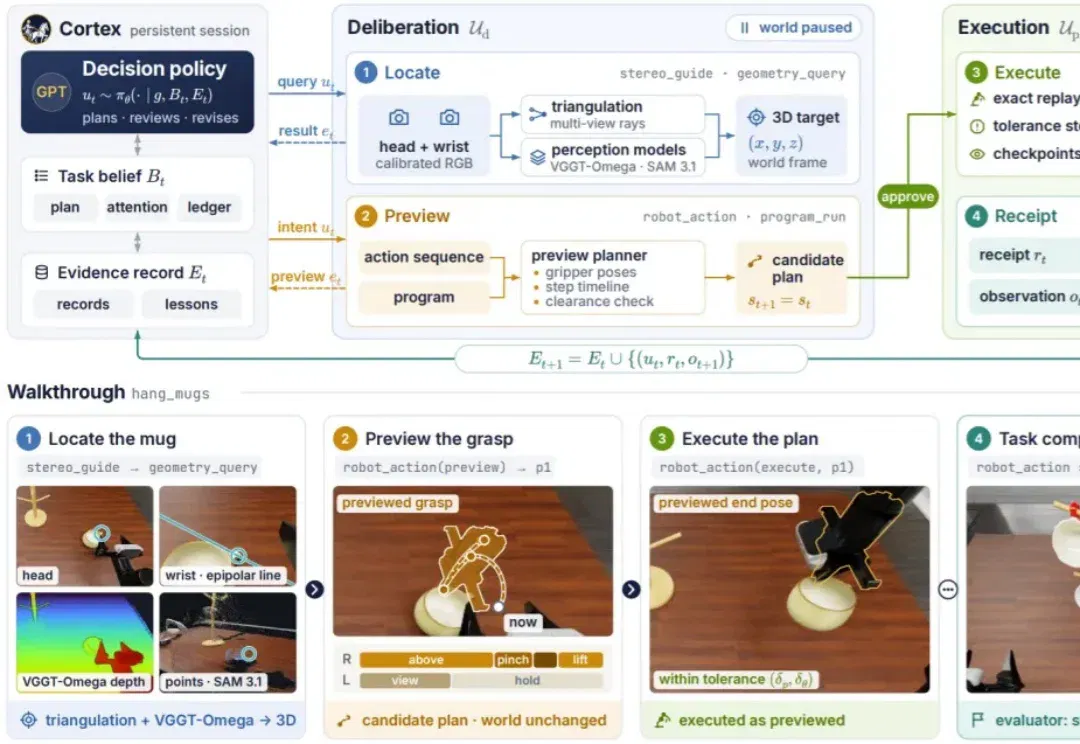
具身RSI的真假之争:机器人是在自我进化,还是在反复刷题? (opens in a new tab)
星衍智能介绍具身 Harness 框架 Auriga,以几何测量、动作预演、执行验证与失败记录支持机器人在线纠错。团队在 RoboDojo 和 RoboCasa365 仿真基准上采用固定系统评测,并讨论从人工推动的通用能力迭代走向自主改进的下一步。
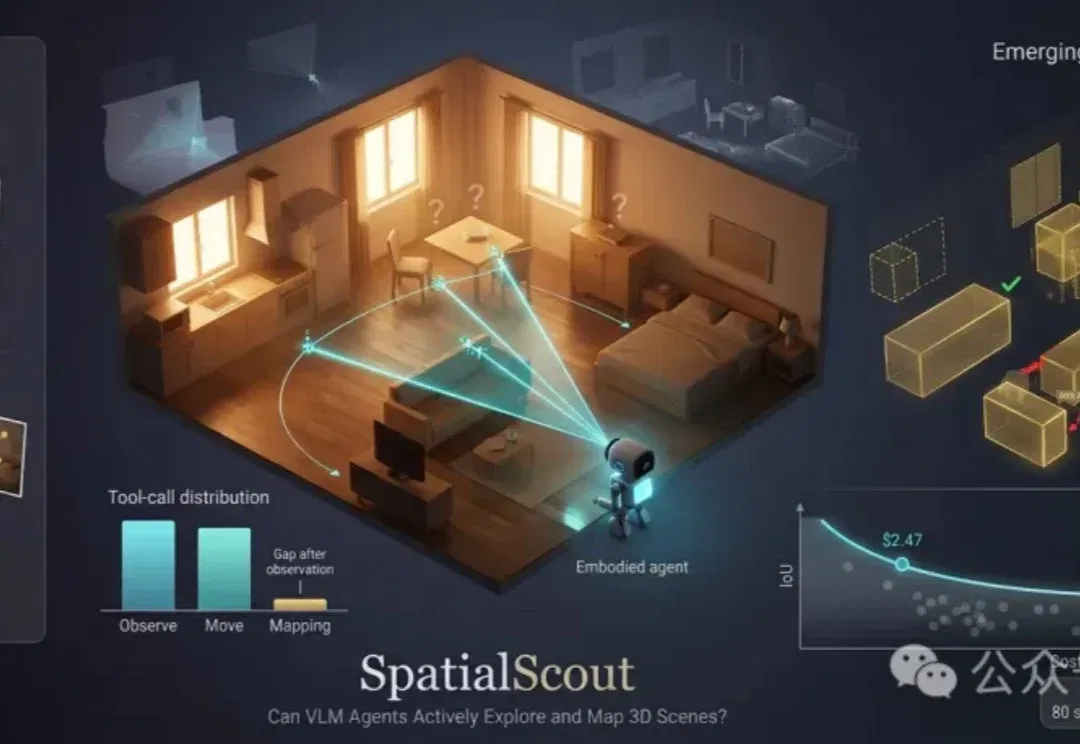
AI进屋后,下一眼该看哪?观察智能体如何建立三维空间认知 (opens in a new tab)
SpatialScout 用80个室内仿真场景评测智能体如何主动移动相机、关联多视角观测,并估计目标物体的三维位置。文章比较不同模型的定位质量与推理费用,指出观察次数增加并不自动改善建图,跨视角对应和几何工具使用仍是关键。
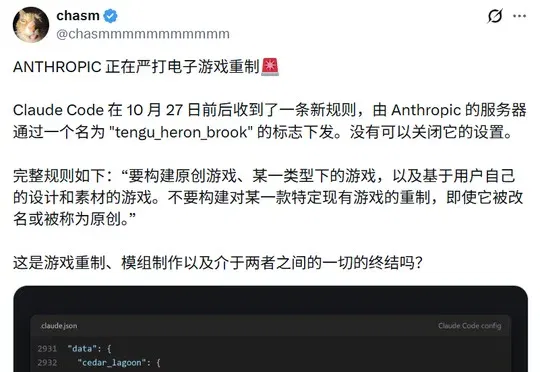
Claude Code 调整游戏生成提示:允许原创,限制复刻特定作品 (opens in a new tab)
据报道,Anthropic 为 Claude Code 使用 Opus 5.5 时加入提示,允许原创、类型游戏及用户自有设计,限制复刻某款现有游戏。开发者 Addy Osmani 表示团队仍会调整边界并收集误拒反馈;文章进一步讨论 Mod、游戏保存与克隆风险,实际执行仍取决于模型理解。
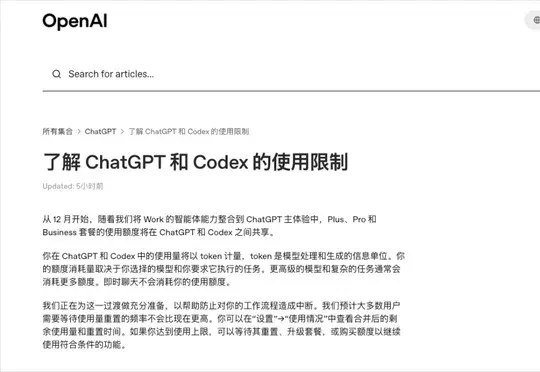
ChatGPT 与 Codex 将共享额度:12月调整及 Instant 聊天例外 (opens in a new tab)
OpenAI 帮助文档称,12月起 Plus、Pro 等套餐的 ChatGPT 与 Codex 将共享按 Token 衡量的使用额度,消耗随模型和任务变化,Instant 聊天不计入。作者从重度使用者角度讨论计量带来的顾虑;实际可用任务量尚不能仅凭共享规则推算,也不等同于订阅统一改为逐次付款。
Jev 联合 Treg 开源人员检索工作流,连接候选筛选与邮箱工具 (opens in a new tab)
TypeSafe AI 与 Treg 展示面向招聘及商业研究的人员检索流程:Agent 调用数据工具,Jev 判断候选匹配度,再按需查找或验证工作邮箱。文中低价及相对 Clay 的降幅来自平台特定测试,邮箱查找、验证和履历补全分别计费;也有用户反馈检索结果不足。
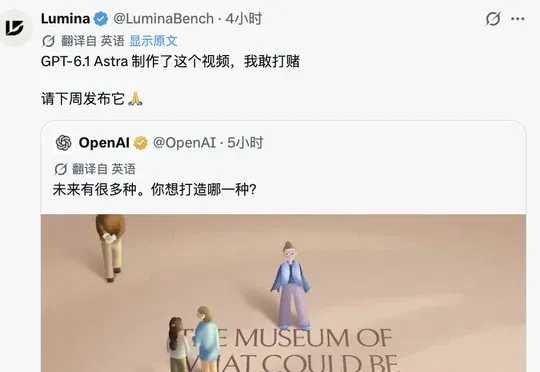
OpenAI 动画引发新模型猜测,12万亿参数仍属未经证实传闻 (opens in a new tab)
OpenAI 发布一段动画后,社交平台出现关于 GPT-6.1 Astra 的发布猜测,另有第三方追踪截图被解读为 GPT-6.2 Betelgeuse 线索。文中所引12万亿参数、跑分、价格与上线时间来自匿名或社交平台爆料,尚无相应官方确认,动画本身也不能证明由哪款模型制作。