Know AI. See What’s Next.
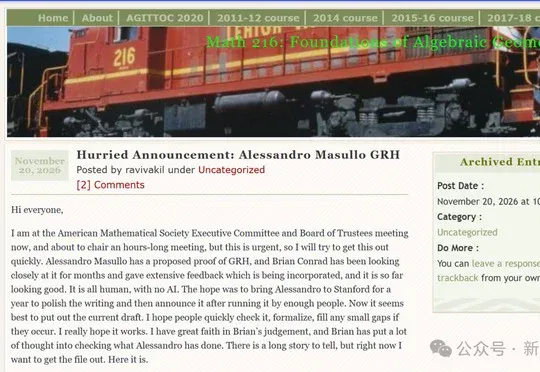
Slide 1 of 5: Alpöge与Claude公布黎曼猜想形式化证明,Lean社区确认核验
Latest news
奥特曼最新深度访谈:AI至今没有iPhone时刻! (opens in a new tab)
在最新的一场长达近1个半小时的深度对谈中,OpenAI首席执行官山姆·奥特曼对大模型的发展轨迹、底层技术演进、商业战略取舍以及公司的早期历程,进行了一场信息量极大的全面复盘。
张小珺:创造超长上下文之前,先抓住一瞬间的直觉 (opens in a new tab)
张小珺的播客(《张小珺商业访谈录》)是关注人工智能前沿的人绕不开的上下文——超长上下文。
「重置之神」Tibo:Codex真的有一个「重置」按钮,实体的 (opens in a new tab)
「我想什么时候按这个按钮都可以,只要我觉得时机合适就行。」 ——OpenAI Codex 产品负责人 Tibo
149美元,AI 版「旅行青蛙」口袋宠物,内置Gemini、支持语音交互、拥有长记忆、MBTI 性格成长 (opens in a new tab)
Sweekar 是由零动未来推出的口袋 AI 电子宠物,整机重量仅89克,小巧的蛋形机身便携性不错,很适合桌面摆放和日常携带。
英伟达震撼首测Vera Rubin,DeepSeek吞吐暴涨30倍! (opens in a new tab)
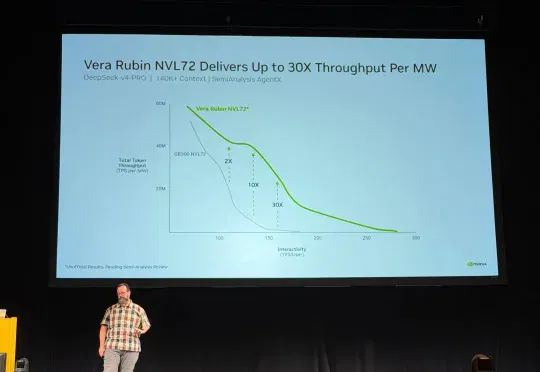
就在刚刚,英伟达史上首次公布了下一代旗舰级机柜 Vera Rubin NVL72 的首次片上实测数据。而且,这次实测直接拉来了DeepSeek-V4-Pro,跑最真实的「智能体编码」任务!结果令人吃惊:对比当前的主力机皇GB300 NVL72,Vera Rubin的每兆瓦吞吐量最高飙升了30倍、Token成本最高暴降了35倍!
匿名打榜的都是二流模型 (opens in a new tab)
不难看出,写这篇的原因主要是被牛来大模型伤到了。
AI人才3次大迁徙:百度被疯抢、六小虎分化、腾讯「腾笼换鸟」 (opens in a new tab)
“这些人在往哪跑?为什么跑” “大模型浪潮狂飙三年半,国内AI人才也经历了三波大迁移。”资深科技猎头赵捷告诉雷峰网。 前两年,大家抢的是预训练人才,先是百度文心团队被疯抢,然后是AI六小虎人才遭遇瓜分,紧接着又是阿里、DeepSeek、字节、腾讯之间的人才大混战。 而现在,大家又开始抢推理、Agent等后训练人才;最近一年不少预训练人才,如Qwen Code负责人惠彬原、混元大语言模型预训练负责人姚星丞、混元多模态理解预训练负责人彭厚文,字节Seed核心专家顾全全等陆续离职,要么创业,要么流向更纯粹的AI研究团队。 是什么促成了这一轮轮AI人才大迁徙?这背后又藏着哪些AI行业更深层的逻辑转变?
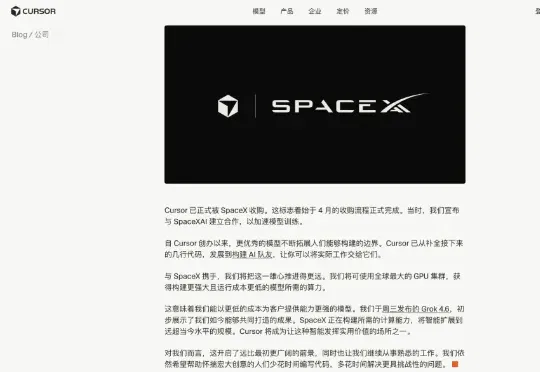
马斯克罕见认怂,天价收购 Cursor 首次发声:Grok 落后了 (opens in a new tab)
据 The Information 报道,本月早些时候,这笔备受行业瞩目的天价收购案正式尘埃落定。随后,马斯克通过视频连线,首次直面了聚集在 Cursor 旧金山总部及各办公区的 1000 多名新员工。在这场内部会议上,马斯克非常坦诚地剖析了当下的竞争格局。
AI教育跑出一匹教育黑马,飞象老师正式发布3.0版本 (opens in a new tab)
今天,飞象老师正式发布3.0版本。这次升级最值得关注的变化,是新增了“教育应用生成”能力。用户只需要在对话框里说清楚自己的需求和想法,几分钟后,就可以得到一个能够直接访问、调用AI、保存数据,并持续修改迭代的教育应用。整个过程中,不需要写代码,也不需要理解数据库、服务器和部署。
“你以为买的是 DeepSeek Flash,到手可能是 1.5 bit 缩水版”:Pi 核心贡献者谈 AI Token 黑箱 (opens in a new tab)
“你以为你买的是 DeepSeek Flash,实际上可能是个 1.5 bit 的 DeepSeek,或者里面掺了 Opus 用于训练。”这是 Pi 核心贡献者 Armin Ronacher 的一个比喻。他形容现在的 token 市场像一种成分不明的商品——量化程度、实际版本、是否掺了别的东西、计费方式,全是黑洞。
刚刚,Codex恢复5小时限额,用户哀嚎 (opens in a new tab)
刚刚,OpenAI Codex负责人Tibo宣布,明天开始将会恢复ChatGPT Work和Codex平台上Plus用户的5小时用量限制。据Tibo所说,这一做法早就在计划之中,目的主要是减轻算力负荷,从而在周使用额度上提供更慷慨的计划。
拿下AI应用最大融资后,LiblibAI把下一站放在了韩国 (opens in a new tab)
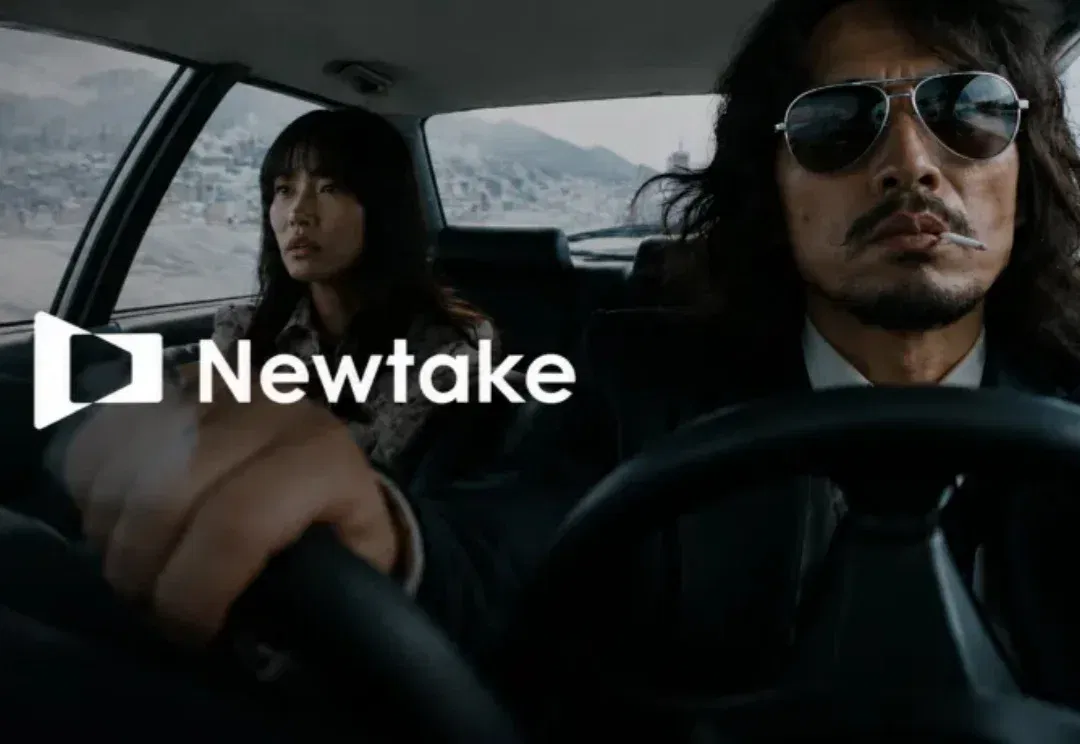
从社区走向的一整套创作产品。 最近在抖音刷短剧时,这类由AI制作的韩剧已经经常能看到:妆面干净,肤质修得很细,镜头里反复出现偶像、恋爱桥段以及韩剧感很强的角色。 韩国自己有着成熟的剧集、偶像和广告工业,对人物的呈现一直占据很大比重。 而AI视频这两年进步最突出的几项能力,恰好也集中在人物稳定性、镜头控制和影像质感上。 短剧的出现又加了一把火,韩国用户偏好的关键词里也长期能看到都市恋爱、高刺激剧情和强人物关系。 这个时候,一款叫Newtake新的视频创作平台开始大力在韩国市场宣发,并启动NEXT SCENE CHALLENGE,总奖金达到1亿韩元,约合7万美元。 该产品最显眼的位置留给了导演工具
字节系之外,RunningHub突围:顶级AI模型争夺“首发阵地” (opens in a new tab)
模型的发布流程,早已在密集迭代中演变为精准的工业流水线:技术报告开路,Benchmark榜单刷屏,紧接着开放API,最后以开源权重收尾。
今年 AGI 大会上,这 10 个创业团队最受关注 (opens in a new tab)
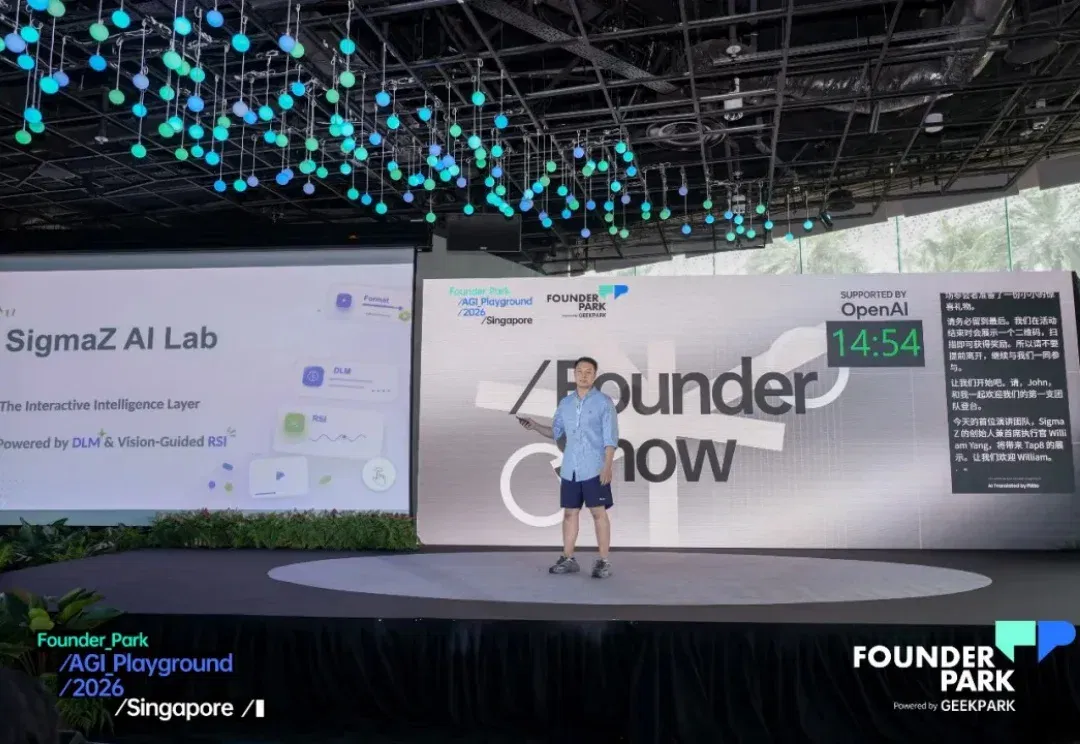
大模型开始吞噬越来越多的东西,创业公司究竟还能做什么?
斯坦福教授直播训练535B大模型,模型训练背后的「黑箱」正在被打开? (opens in a new tab)
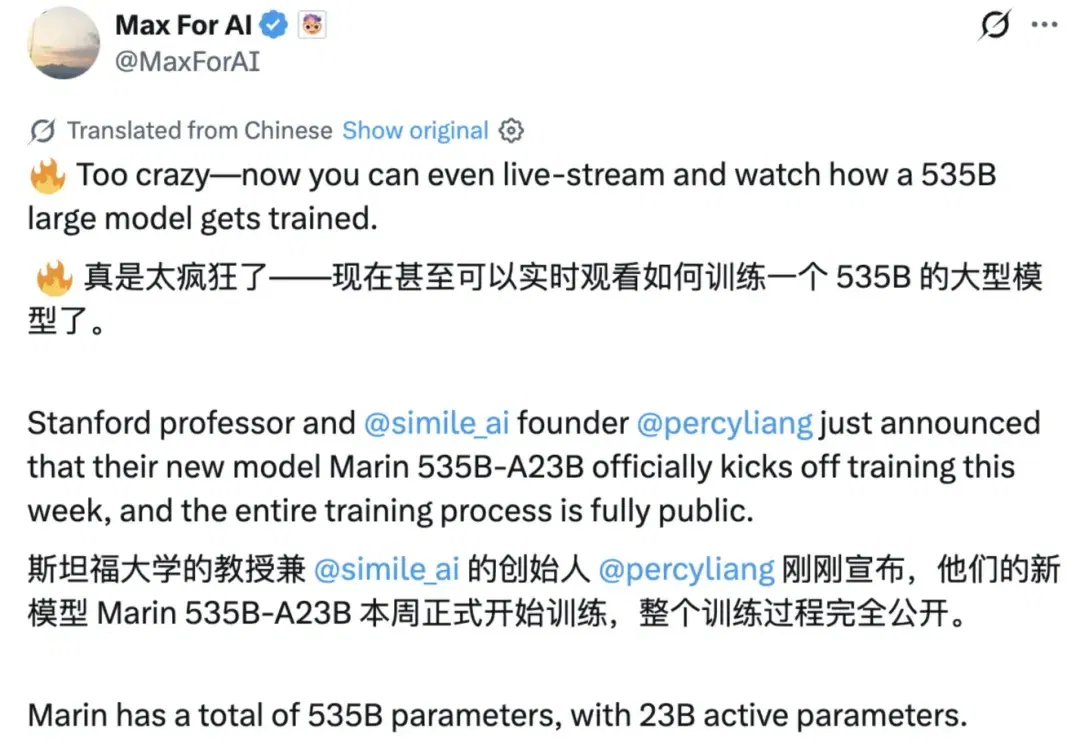
最近两天,X 上网友 Max For AI@MaxForAI 的一篇帖子引发了网友热议:「太疯狂了 —— 现在你甚至可以直播围观一个 535B 大模型是如何被训练出来的。」
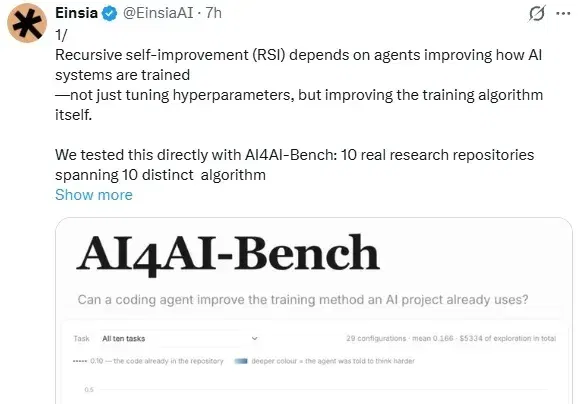
最强AI改进自己仅得0.16分? Einsia AI发布AI4AI-Bench: AI能否设计出更好的AI? (opens in a new tab)
导读 AI 能否改进 AI 自己? AI 已经会写 AI、训练 AI、优化 AI 系统;下一个里程碑,是 AI 能不能开始「设计 AI」。 对于今天的 Coding Agent 来说,它能介入的改进大致有三层: 系统工程解决算子、并行和通信,最终受硬件上限约束;数据工程改进配比、合成和清洗,受高质量信息供给限制;而算法设计改变的是目标函数、更新规则和训练流程本身。 这一层最特殊,一个更好的算法改变的是:在同样的数据和算力下,究竟能换来多少能力。 Adam、DPO、GRPO 这样的进步一旦出现,就能持续影响之后的一代代模型。 所以,如果 Recursive Self-Improvement 真要
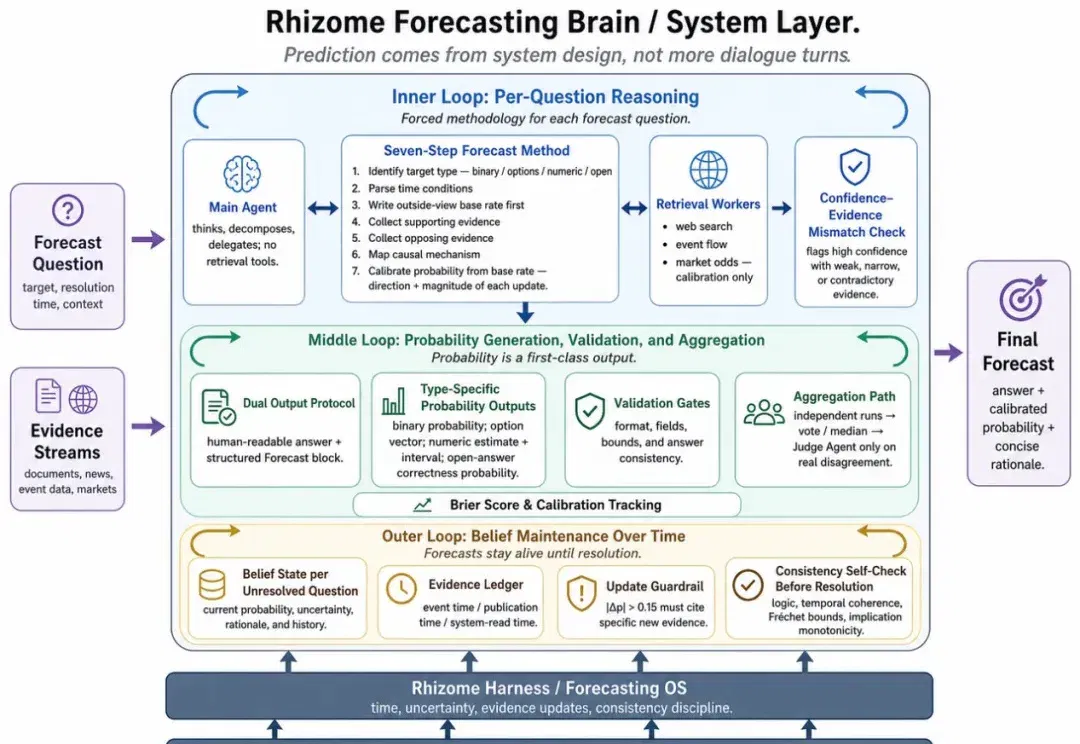
VC开始靠AI预测未来了 (opens in a new tab)
七月,DigClaw的预测框架Rhizome v1,在FutureX评测平台上取得了#1、#3、#7三个席位。
ResNet作者任少卿机器人创业!公司注册就独角兽了 (opens in a new tab)
Resnet作者任少卿,已亲身入局具身智能创业。
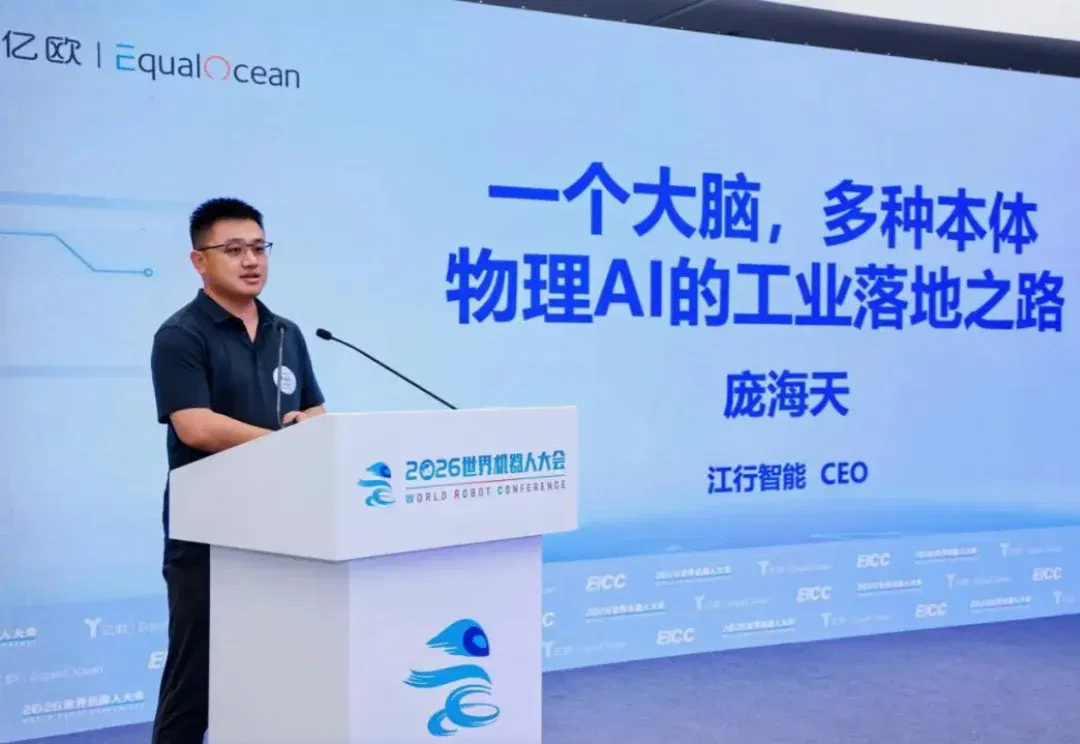
一个大脑,多种本体:江行智能详解物理AI工业落地的系统解法 (opens in a new tab)
算力上限,是物理 AI 落地过程中需要面对的现实约束之一。
菲尔兹奖得主都栽了!Claude终结78年悬案,或成最重要AI数学成果 (opens in a new tab)
一道悬了整整78年的世纪难题,三天就被破了!