Search

Results for “encoder”

Total 10 articles

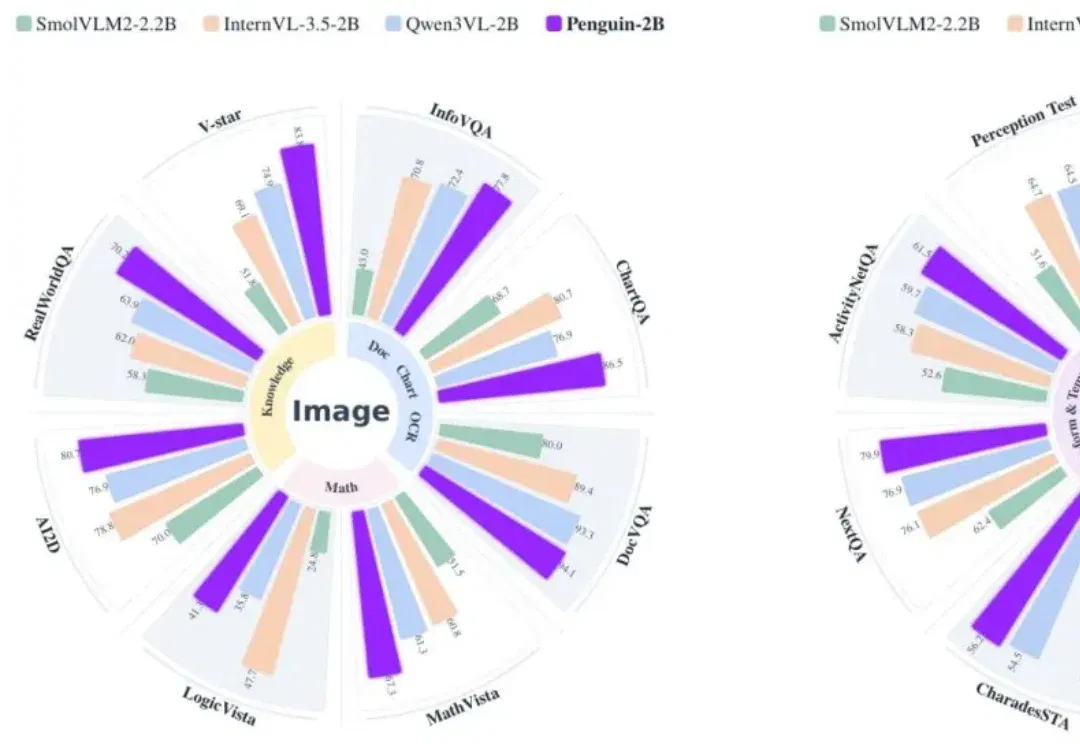
腾讯纯文本LLM训视觉encoder,拿捏图表长视频,达到开源小模型SOTA!

腾讯纯文本LLM训视觉encoder,拿捏图表长视频,达到开源小模型SOTA! (opens in a new tab)

打破多模态视觉+语言拼接套路! 腾讯开源Penguin-VL,直接用纯文本LLM训视觉编码器。 这项研究跳出了先有传统视觉 backbone,再接语言模型的常规路径,直接从text-only LLM初始化vision encoder。 并在2B/8B紧凑参数规模下的文档理解、长视频时序定位等复杂任务中表现出极强竞争力。 从LLM出发的视觉编码器重构 如果把这两年的多模态模型拆开看,一个很有意思的现象是: 大家在语言模型上卷得很凶,但到了vision encoder这一层,路线却出奇一致。 很多VLM最后都会回到那套熟悉配方,先拿CLIP、SigLIP这类通过对比学习训出来的视觉模型做encod
AI guides
0
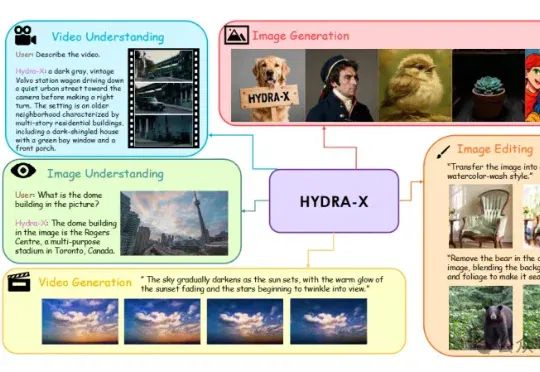
单个tokenizer胜任图像视频理解生成!南大&腾讯混元HYDRA打通多模态统一难题

单个tokenizer胜任图像视频理解生成!南大&腾讯混元HYDRA打通多模态统一难题 (opens in a new tab)

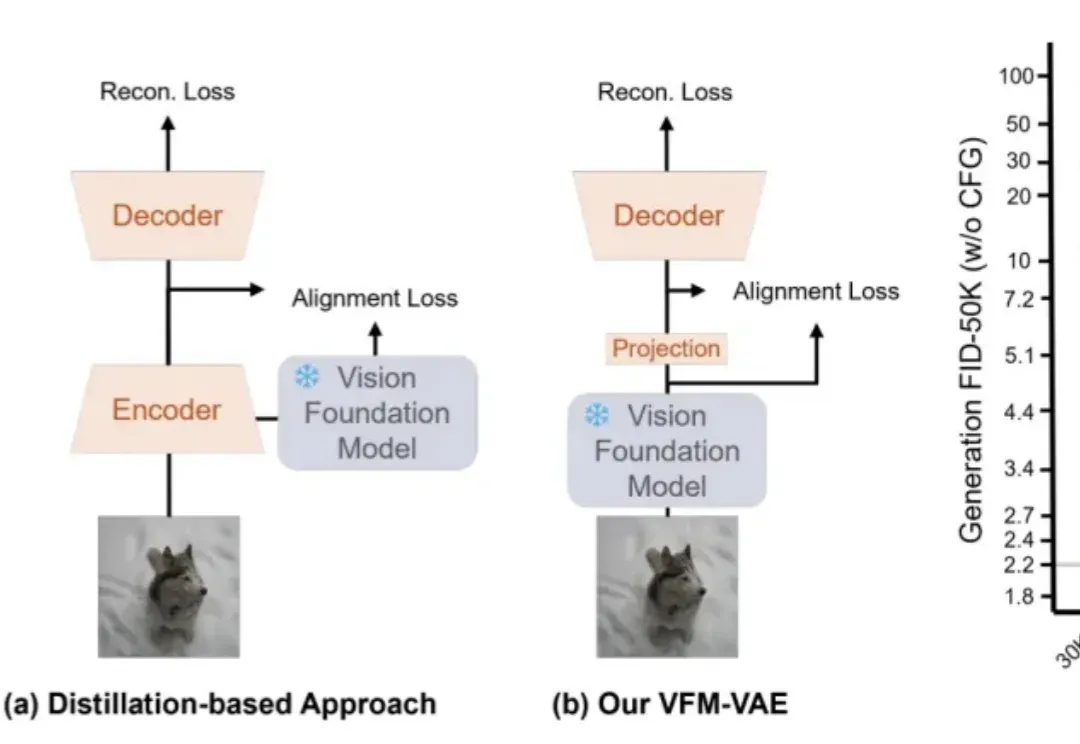
南大王利民团队&腾讯混元的HYDRA系列(HYDRA,HYDRA-X)工作挑战了这个惯例,用一个基于ViT的统一视觉Tokenizer,帮助原生多模态模型更好地“看懂”和“创作”。训练一个基于ViT的Unified Tokenizer,使其同时具有理解和生成的能力,进而同时作为理解和生成的Autoencoder,来支持原生多模态模型(Unified Multimodal Models)的训练。

AI guides
0
多模态模型终于不用「抽帧看世界」?LLaVA-OneVision-2.0全开源全帧率技术解读

多模态模型终于不用「抽帧看世界」?LLaVA-OneVision-2.0全开源全帧率技术解读 (opens in a new tab)

由格灵深瞳灵感实验室主导研发的 LLaVA-OneVision-2.0,是一款面向下一代感知智能的视觉语言大模型。团队充分利用视频 Codec 流和自研 OneVision-Encoder,实现跨帧、跨事件的增量观测和连续证据流建模。本文将详细介绍模型架构、训练方法与能力验证,展示该技术在视频理解、空间推理和目标追踪等任务中的应用潜力。

AI guides
0
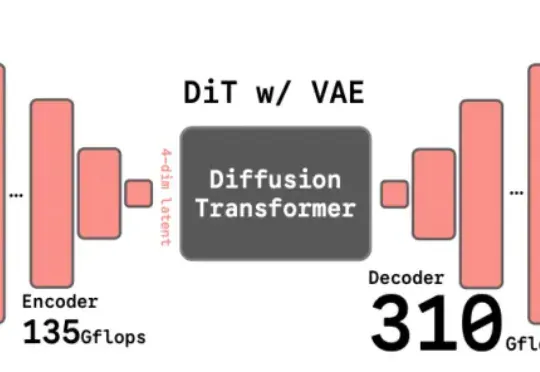
谢赛宁新作:VAE退役,RAE当立

谢赛宁新作:VAE退役,RAE当立 (opens in a new tab)

谢赛宁团队最新研究给出了答案——VAE的时代结束,RAE将接力前行。其中表征自编码器RAE(Representation Autoencoders)是一种用于扩散Transformer(DiT)训练的新型自动编码器,其核心设计是用预训练的表征编码器(如DINO、SigLIP、MAE 等)与训练后的轻量级解码器配对,从而替代传统扩散模型中依赖的VAE(变分自动编码器)。

AI guides
0
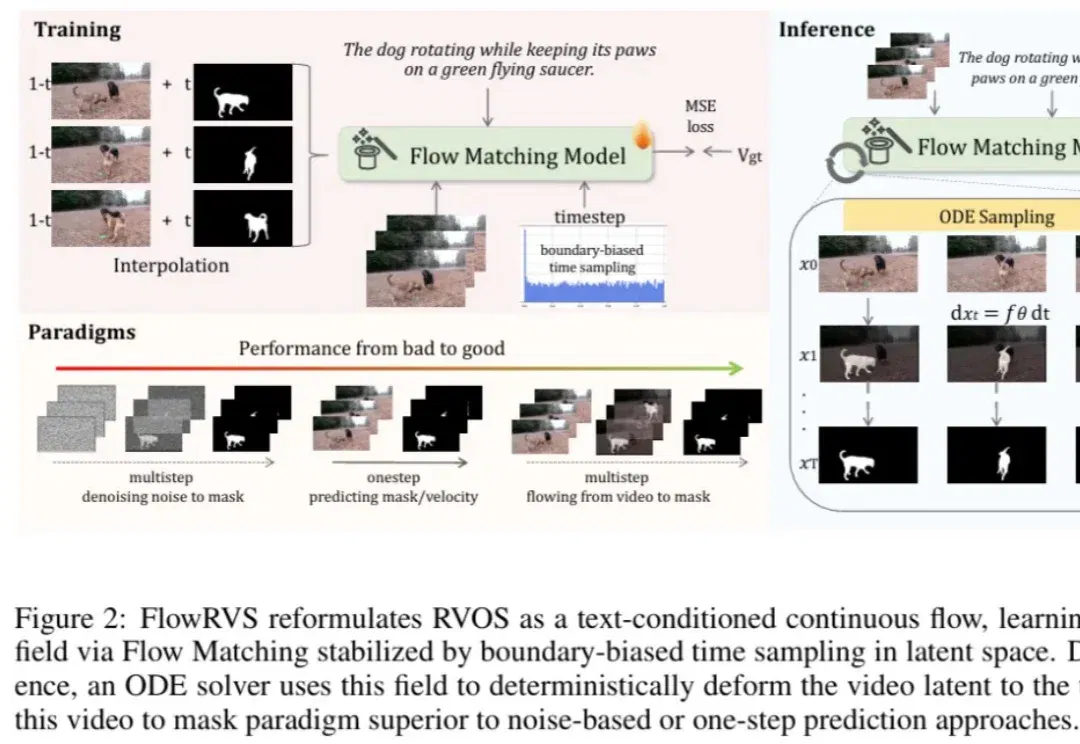
ICLR 2026 | 当视频难以被表征:UCSD、HKUST等机构联合提出FlowRVS,用生成式流匹配重构视觉感知范式

ICLR 2026 | 当视频难以被表征:UCSD、HKUST等机构联合提出FlowRVS,用生成式流匹配重构视觉感知范式 (opens in a new tab)

长期以来,计算机视觉领域陷入了一个 “表征(Representation)” 的执念。我们习惯设计各种精巧的 Encoder,试图将动态世界压缩成一组特征向量。然而,视频作为现实的高维投影,其熵值之高、动态之复杂,让这种试图 “定格” 的表征显得力不从心。

AI guides
0