arXiv被AI水文淹没,新规要求AI生成论文需过同行评审 (opens in a new tab)
当地时间 10 月 31 日,由于涌入预印本平台 arXiv 的计算机科学(CS,Compute Science)的由 AI 生成或 AI 辅助生成的综述论文和立场论文数量变得难以管理,arXiv 更新了关于综述论文和立场论文的审核规则,要求这两类论文必须被期刊或会议接收并完成同行评审之后才能提交到 arXiv 的 CS 类别。
Total 30 articles
当地时间 10 月 31 日,由于涌入预印本平台 arXiv 的计算机科学(CS,Compute Science)的由 AI 生成或 AI 辅助生成的综述论文和立场论文数量变得难以管理,arXiv 更新了关于综述论文和立场论文的审核规则,要求这两类论文必须被期刊或会议接收并完成同行评审之后才能提交到 arXiv 的 CS 类别。
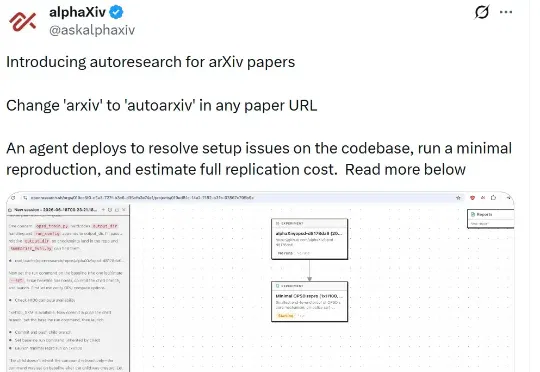
机器之心编辑部 AI 读论文这件事,正在进入下一个阶段。 最近,alphaXiv 推出了一个面向 arXiv 论文的 autoresearch 功能。 它的使用方式非常直接:当用户看到一篇论文时,只需要把论文 URL 里的「arxiv」改成「autoarxiv」,系统就会:
刚刚,Nature报道了一项关于AI“水论文”的新研究,牵头人之一,正是arXiv创始人Paul Ginsparg。老板亲自下场的原因很简单,就是这几年arXiv投稿量激增,导致系统不堪重负,而罪魁祸首很可能就是AI。
arXiv最新政策禁止直接接收未经同行评审的综述和立场论文,以应对AI生成论文的泛滥,但堵不如疏。多伦多大学、清华、北大等18所国内外顶尖高校联合发布新平台aiXiv,支持AI和人类共同撰写、评审和迭代科研成果,采用多阶段AI同行评审机制,提升效率和质量。
三分之一的arXiv论文,竟然是AI写的?
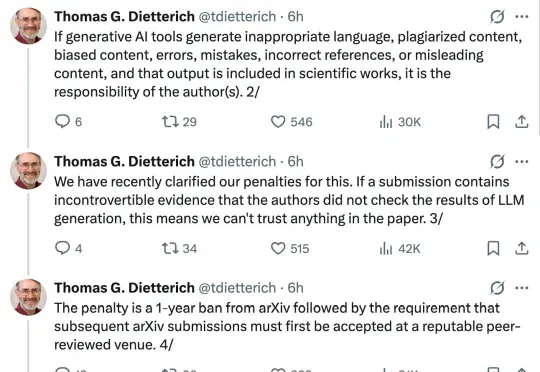
今天凌晨,俄勒冈州立大学杰出教授(荣休)、arXiv 计算机科学分区 CoRR 的机器学习板块首席版主 Thomas G. Dietterich 宣布:根据我们的行为准则,在论文上署名即表示每位作者对其全部内容承担完全责任,无论这些内容是如何生成的。
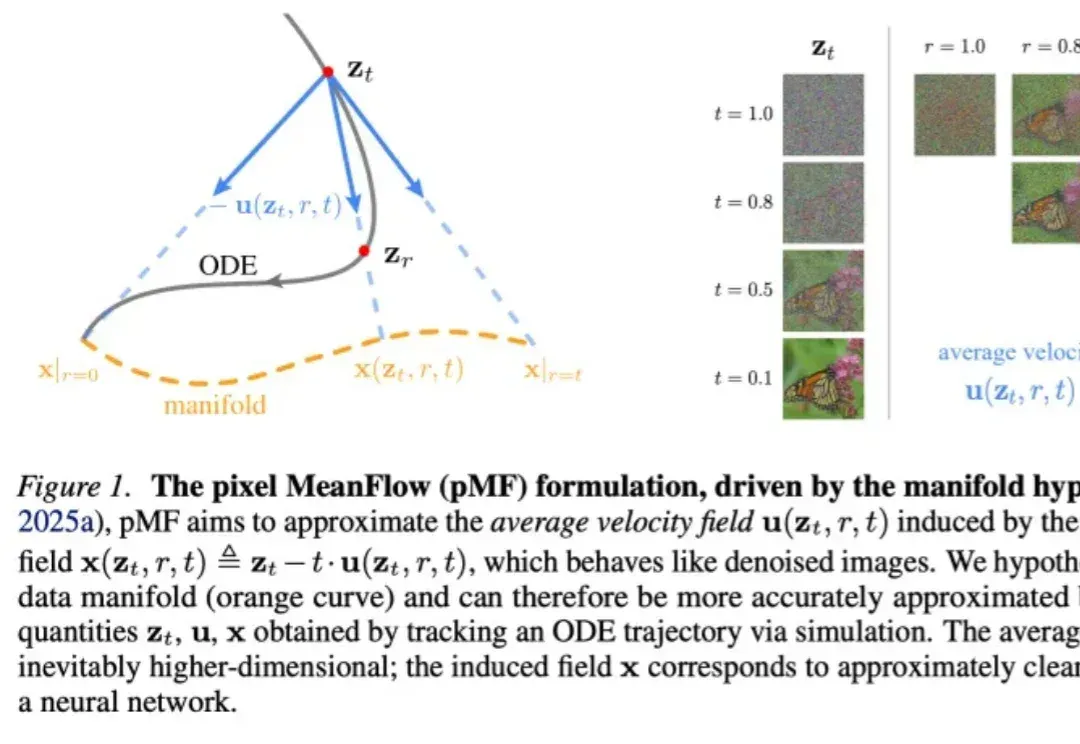
何恺明团队新论文,再次「大道至简」。 此次研究直指当前以 DiT 为代表的主流扩散模型与流匹配模型存在的通病,并提出了一种用于单步、无潜空间(Latent-free)的图像生成新框架。 论文标题:One-step Latent-free Image Generation with Pixel Mean FlowsarXiv 地址:https://arxiv.org/pdf/2601.22158v1 在生成式 AI 领域,追求更高效、更直接的生成范式一直是学界的核心目标。 当前,以 DiT 为代表的主流扩散模型与流匹配模型主要依赖两大支柱来降低生成难度,一是通过多步采样将复杂的分布转换分解为微小
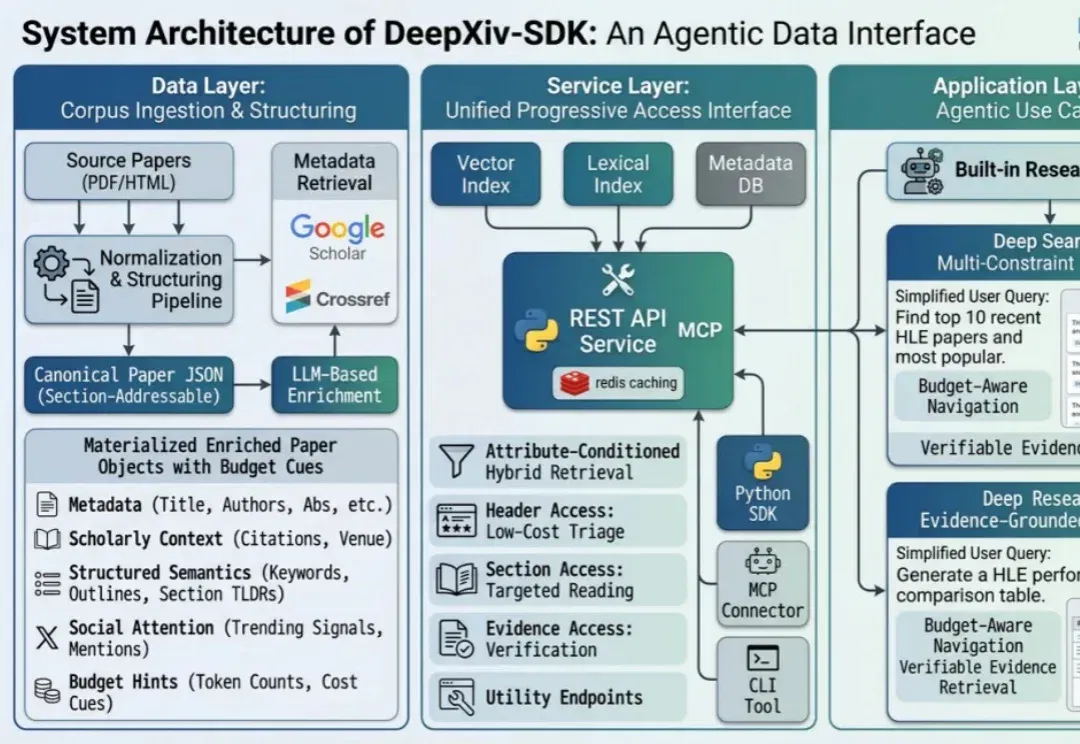
DeepXiv 是专为智能体设计的科技文献基础设施,把论文搜索、渐进式阅读、热点追踪和深度调研变成可调用、可编排、可自动化的能力。
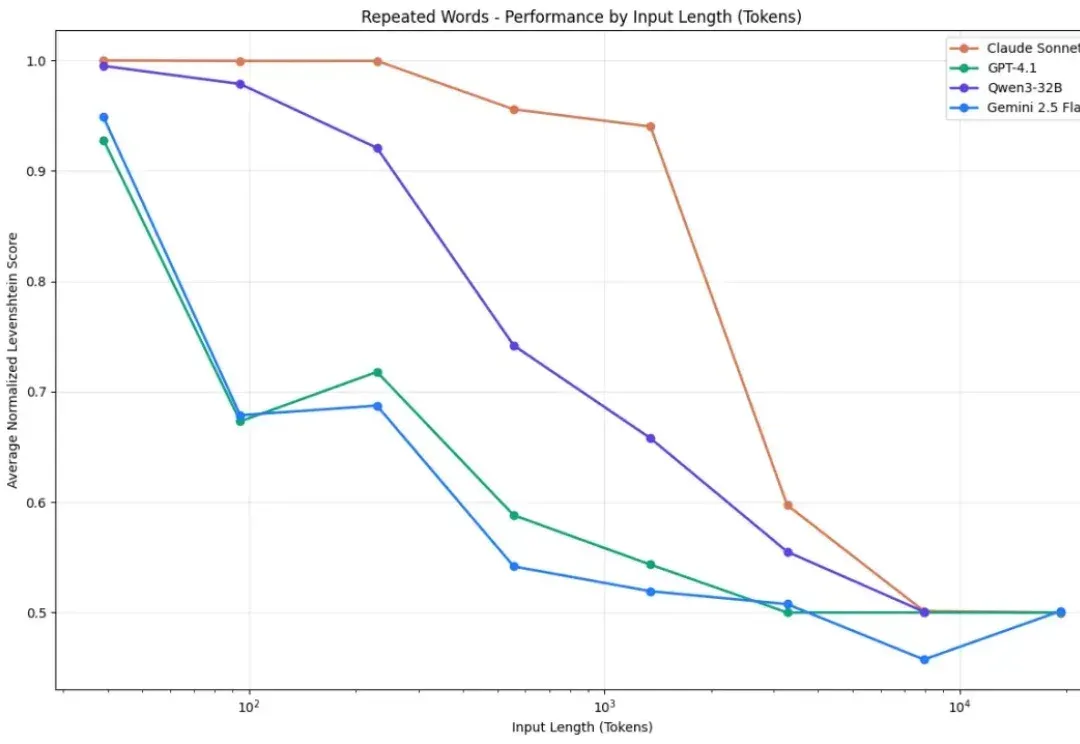
新年伊始,MIT CSAIL 的一纸论文在学术圈引发了不小的讨论。Alex L. Zhang 、 Tim Kraska 与 Omar Khattab 三位研究者在 arXiv 上发布了一篇题为《Recursive Language Models》的论文,提出了所谓“递归语言模型”(Recursive Language Models,简称 RLM)的推理策略。
最近,来自上海创智学院、复旦大学等机构的研究者提出了 Hallo-Live,试图正面解决这个矛盾。论文于 2026 年 4 月 26 日 发布在 arXiv。该方法将 异步双流扩散(Asynchronous Dual-Stream Diffusion) 与 人类偏好引导蒸馏(Human-Centric Preference-Guided DMD) 结合起来