Search

Results for “Vision-Language Models”

Total 5 articles

多模态大模型中Attention机制暗藏「骗局」,需用一个公式修正丨上大×南开

多模态大模型中Attention机制暗藏「骗局」,需用一个公式修正丨上大×南开 (opens in a new tab)

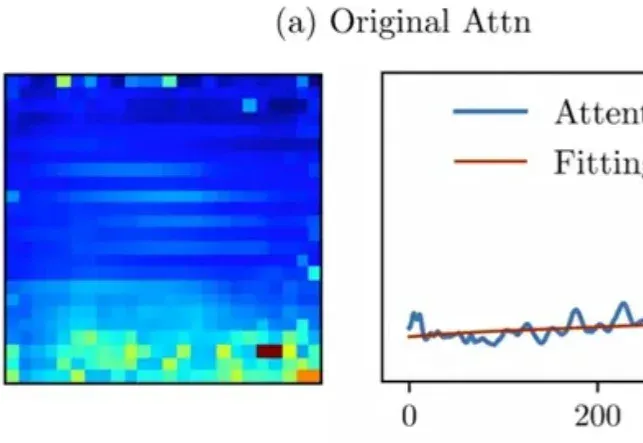
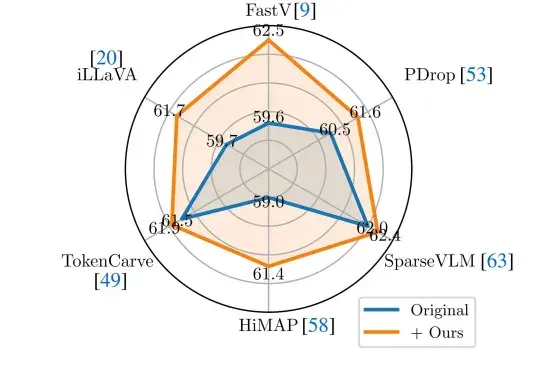
Attention真的可靠吗? 近年来,Vision-Language Models(VLMs)在多模态理解任务中取得了显著进展,尤其是在视觉问答、图像理解和视频理解等场景中,模型通常通过language-to-vision attention来衡量视觉token与文本之间的相关性,并据此进行visual token pruning,以降低推理成本、提升运行效率。 然而,一个长期被忽视的问题是:attention本身是否真的能够作为“语义重要性”的可靠指标? 在最新研究中,上海大学曾丹团队系统分析了主流VLM中attention的行为模式,发现一个关键却容易被忽略的现象——attention并
AI guides
0
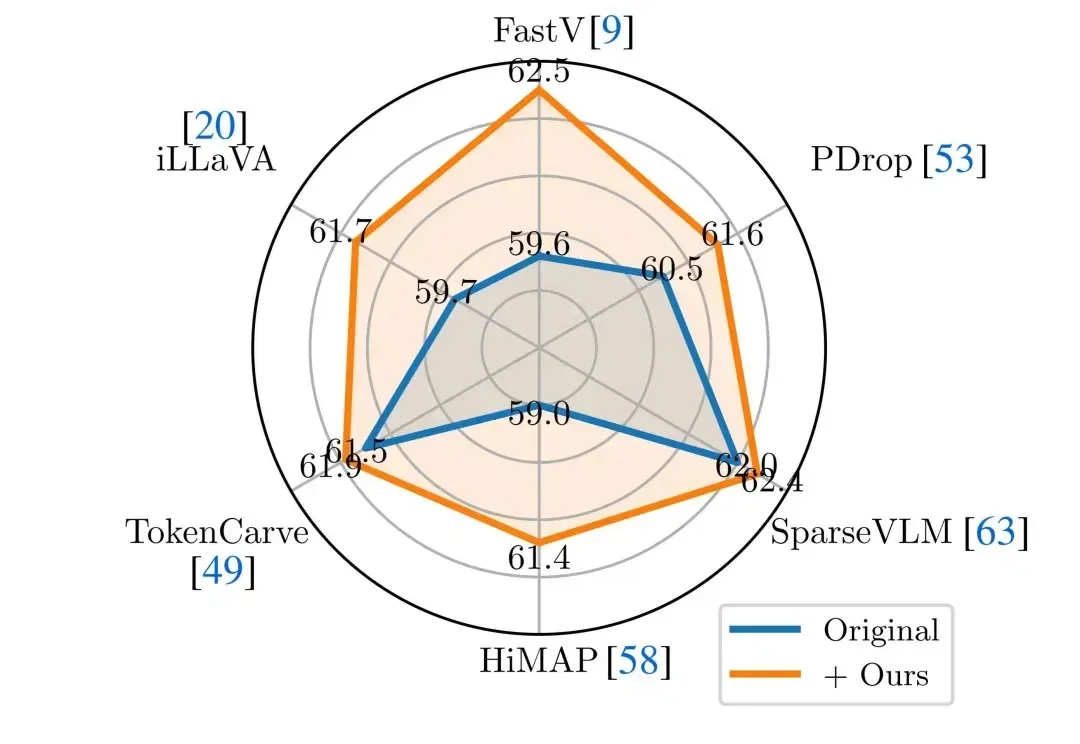
Attention真的可靠吗?上海大学联合南开大学揭示多模态模型中一个被忽视的重要偏置问题

Attention真的可靠吗?上海大学联合南开大学揭示多模态模型中一个被忽视的重要偏置问题 (opens in a new tab)

近年来,Vision-Language Models(视觉 — 语言模型)在多模态理解任务中取得了显著进展,并逐渐成为通用人工智能的重要技术路线。然而,这类模型在实际应用中往往面临推理开销大、效率受限的问题,研究者通常依赖 visual token pruning 等策略降低计算成本,其中 attention 机制被广泛视为衡量视觉信息重要性的关键依据。

AI guides
0
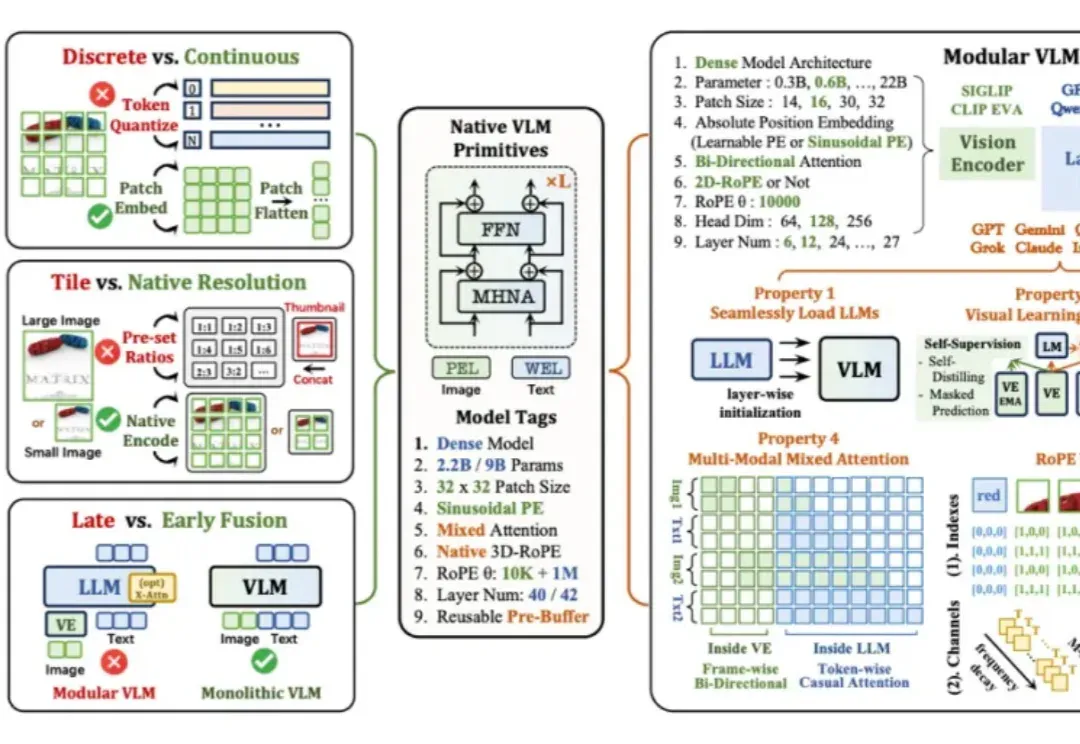
高效训练新标杆!华人团队开源原生VLM-NEO,以少数据追平顶级模型

高效训练新标杆!华人团队开源原生VLM-NEO,以少数据追平顶级模型 (opens in a new tab)

当下主流的视觉语言模型(Vision-Language Models, VLM),通常都采用这样一种设计思路:将预训练的视觉编码器与大语言模型通过投影层拼接起来。这种模块化架构成就了当前 VLM 的辉煌,但也带来了一系列新的问题——多阶段训练复杂、组件间语义对齐成本高,不同模块的扩展规律难以协调。

AI guides
0