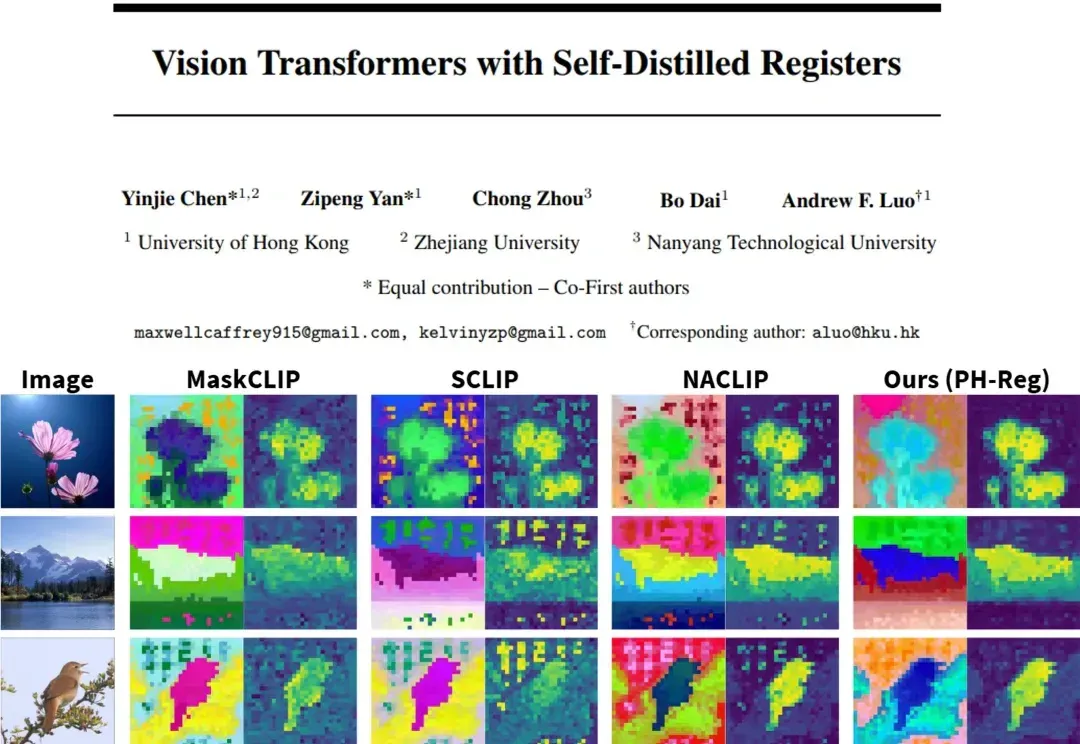
NeurIPS 2025 Spotlight | 香港大学提出无需数据标记的ViT密集表征增强方法 (opens in a new tab)
在视觉处理任务中,Vision Transformers(ViTs)已发展成为主流架构。然而,近期研究表明,ViT 模型的密集特征中会出现部分与局部语义不一致的伪影(artifact),进而削弱模型在精细定位类任务中的性能表现。因此,如何在不耗费大量计算资源的前提下,保留 ViT 模型预训练核心信息并消除密集特征中的伪影?
Total 35 articles
在视觉处理任务中,Vision Transformers(ViTs)已发展成为主流架构。然而,近期研究表明,ViT 模型的密集特征中会出现部分与局部语义不一致的伪影(artifact),进而削弱模型在精细定位类任务中的性能表现。因此,如何在不耗费大量计算资源的前提下,保留 ViT 模型预训练核心信息并消除密集特征中的伪影?
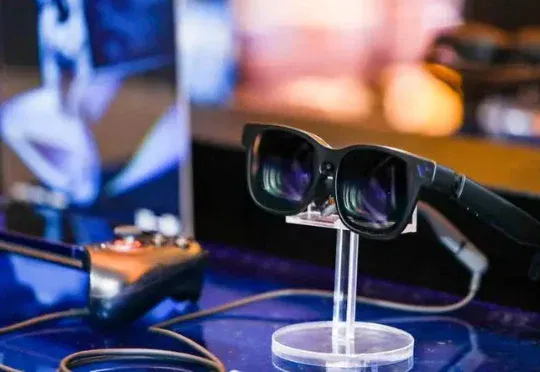
他身前是13英寸笔记本,眼前铺开的则是174英寸的超宽屏幕。这块屏幕来自这幅XR智能眼镜,屏幕上同时铺着三个窗口:左边是Claude Code,代码正一行行往外吐;中间是编辑器,光标在等他的下一次指令;右边是飞书,同事刚发来一条消息。而这并非幻想画面。实际上,这是使用VITURE眼镜进行vibe coding的新潮流。
Insilico Medicine、Liquid AI、巴克衰老研究所等机构在Cell发表论文,推出面向衰老研究的AI工具链LongevityBench、Longevity-LLMs和Longevity Claw,其中参数量仅9B的专用模型L-Qwen3.5-9B在综合排名中超越Gemini 3.1 Pro和Claude Opus 4.6。
Google昨天伴随Gemini3.0pro一同发布了他们的AI IDE产品Antigravity《与Gemini 3.0一起发布的AI IDE「Antigravity」究竟有多厉害?》。其震撼性的三位一体全流程Agent体验让无数开发者直呼“Cursor危险了”。
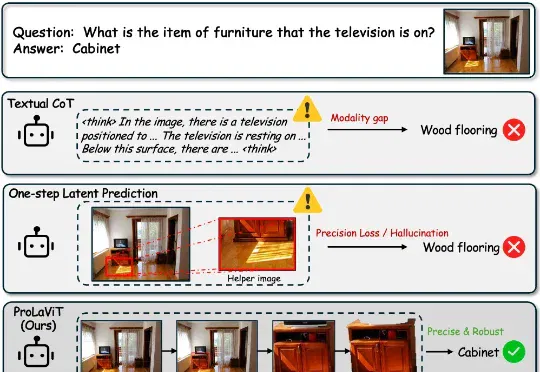
针对这一挑战,腾讯内容服务部 BAC 提出了一个名为 ProLaViT(Progressive Latent Visual Thought) 的全新框架。它的核心思想是:别急着下结论,先在连续隐空间里像人一样「步步推导」。 即让模型遵循 「定位 → 聚焦 → 分离」(Locate → Focus → Isolate) 的因果链,逐步收紧视觉注意力,最终精准锁定目标。
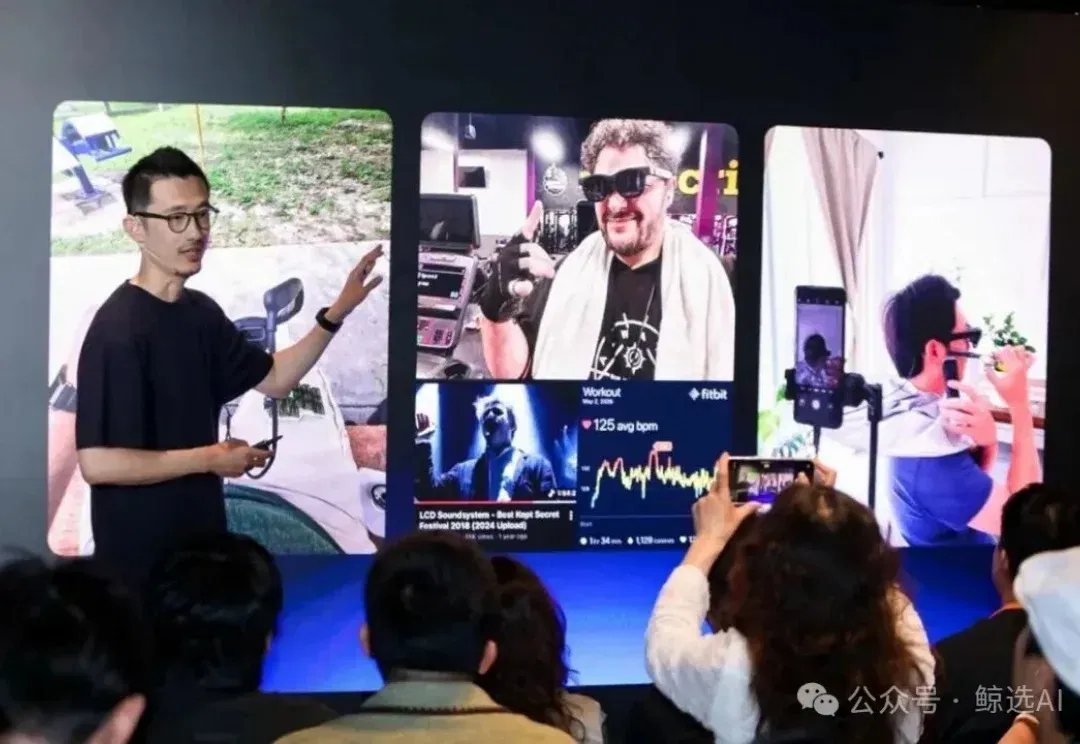
很多人知道,苹果 Vision pro 是 VR 眼镜的市场标杆产品,Meta和Google都曾大举进军AI眼镜,但鲜有人知的是,2025年冲到北美第一的 XR 眼镜,是一家很低调的公司——VITURE。
就在几小时前,Gemini 3.0重磅发布。随着而来的还有其颠覆性的AI原生IDE产品——Antigravity,这不只是一个新工具那么简单。谷歌的这次发布,将三个核心开发工具,AI代理(Agent)、代码编辑器(Editor)和浏览器(Browser) 集成在了一起,构建了由AI驱动、从编码、研究、测试到验证的完整闭环,一举打通了自家的生态。
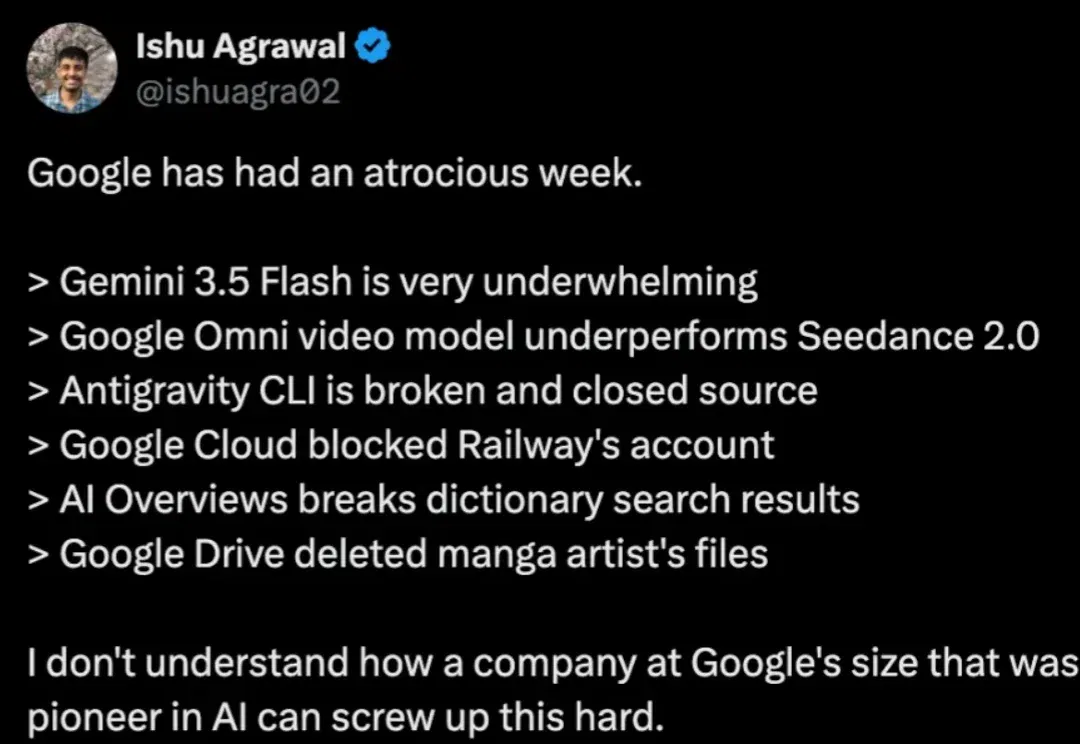
最近,谷歌的日子不太好过。 自从 I/O 大会以来,谷歌经历了连环翻车: Gemini 3.5 Flash 被网友吐槽实际体验、额度消耗和稳定性不及预期;Gemini Omni Flash 原生多模态视频生成与编辑模型,表现不如 Seedance 2.0;Antigravity CLI 闭源、bug 多、且还被抓到演示视频里出现 Codex 文件;Google Cloud 自动风控系统错误封禁了知名 PaaS 平台 Railway 的账号,导致 Railway 服务大面积宕机好几个小时;AI Overviews 搜索 disregard、ignore 等单词时,AI 不正常显示字典释义,把搜索
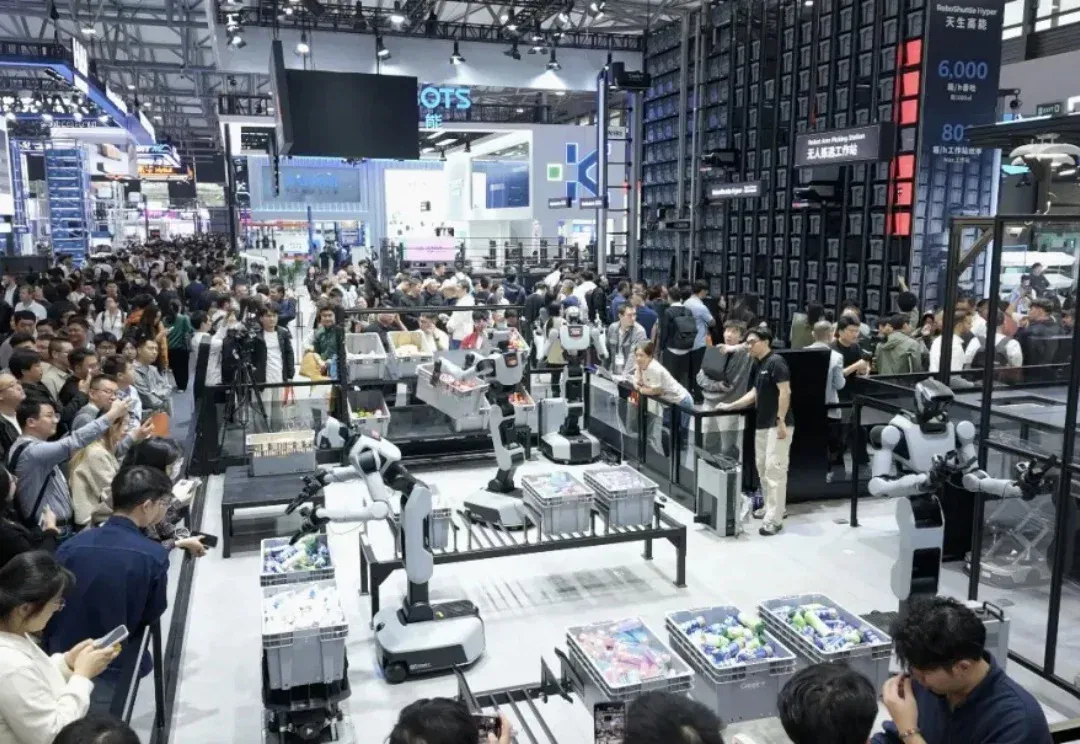
CeMAT 2026 上,极智嘉展示 Gravity 驱动的抓取、长程任务和语言纠偏,并介绍其与仓储机器人及调度系统的衔接。公司提出24/7自主智能仓计划;展台演示和特定实验的成功率,仍需在真实仓库长期运营中检验。
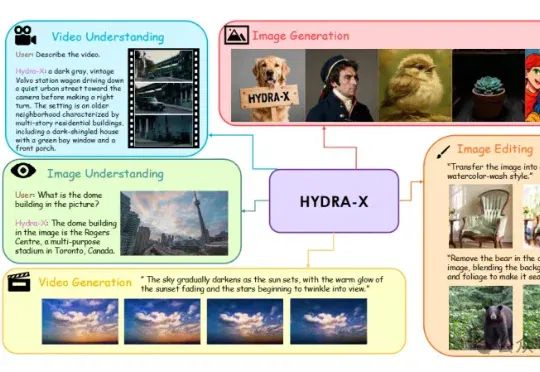
南大王利民团队&腾讯混元的HYDRA系列(HYDRA,HYDRA-X)工作挑战了这个惯例,用一个基于ViT的统一视觉Tokenizer,帮助原生多模态模型更好地“看懂”和“创作”。训练一个基于ViT的Unified Tokenizer,使其同时具有理解和生成的能力,进而同时作为理解和生成的Autoencoder,来支持原生多模态模型(Unified Multimodal Models)的训练。