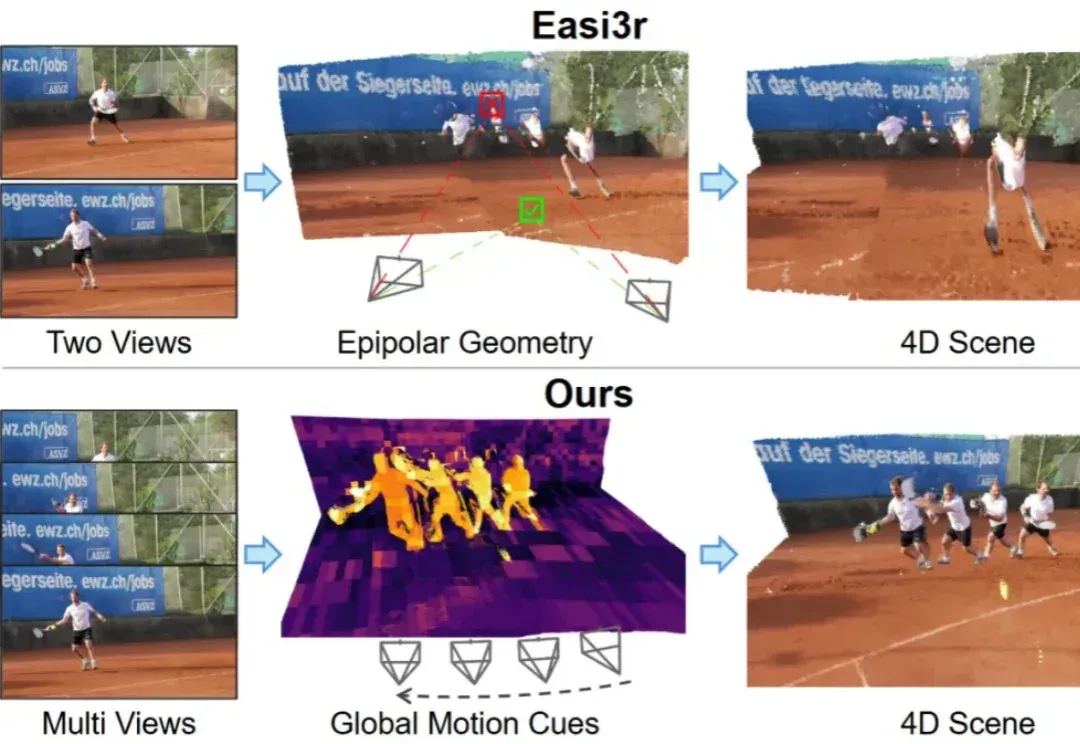
VGGT4D:无需训练,挖掘3D基础模型潜力,实现4D动态场景重建 (opens in a new tab)如何让针对静态场景训练的 3D 基础模型(3D Foundation Models)在不增加训练成本的前提下,具备处理动态 4D 场景的能力?