Siggraph 26 | 视频版Vision-Banana来了?大一统框架UniVidX刷新多项视频任务SOTA (opens in a new tab)
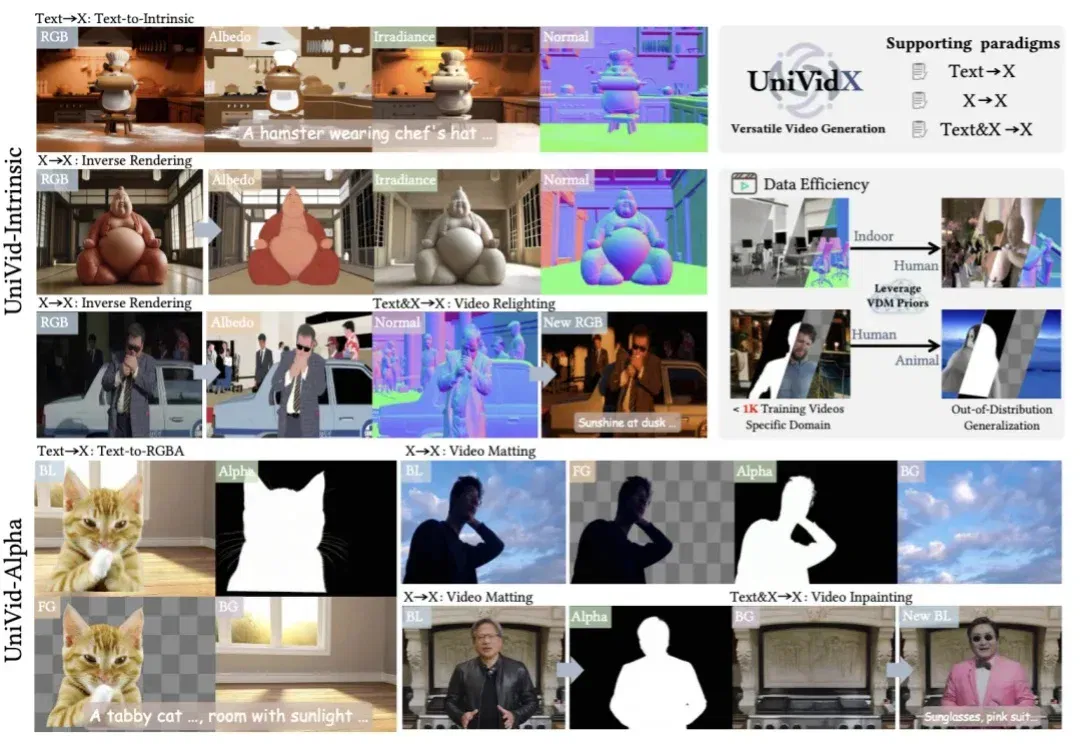
近日,由香港科技大学 MMLab 及合作团队完成的研究工作「UniVidX: A Unified Multimodal Framework for Versatile Video Generation via Diffusion Priors」被计算机图形学顶级会议 SIGGRAPH 2026 正式接收。
Total 3 articles
近日,由香港科技大学 MMLab 及合作团队完成的研究工作「UniVidX: A Unified Multimodal Framework for Versatile Video Generation via Diffusion Priors」被计算机图形学顶级会议 SIGGRAPH 2026 正式接收。
在视频生成与理解的赛道上,常常见到分头发力的模型:有的专注做视频生成,有的专注做视频理解(如问答、分类、检索等)。而最近,一个开源项目 UniVid,提出了一个「融合」方向:把理解 + 生成融为一体 —— 他们希望用一个统一的模型,兼顾「看懂视频」+「生成视频」的能力。
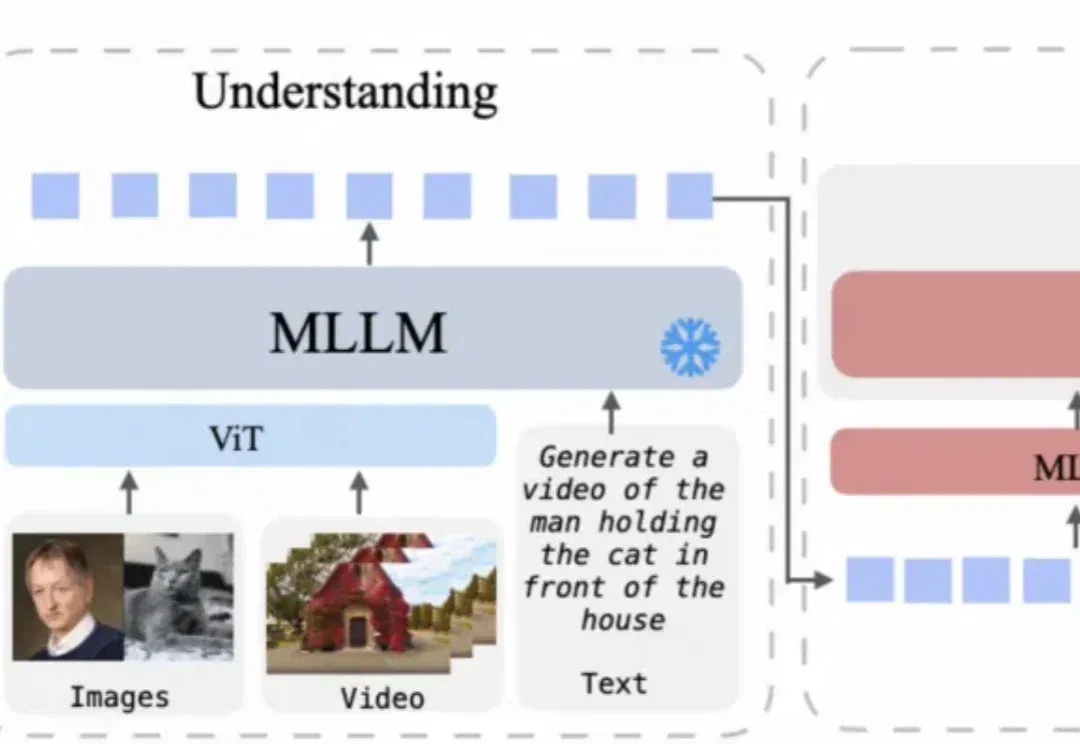
统一多模态模型在多模态内容理解与生成方面已展现出良好效果,但目前仍主要局限于图像领域。