Search

Results for “Tokenizer”

Total 10 articles

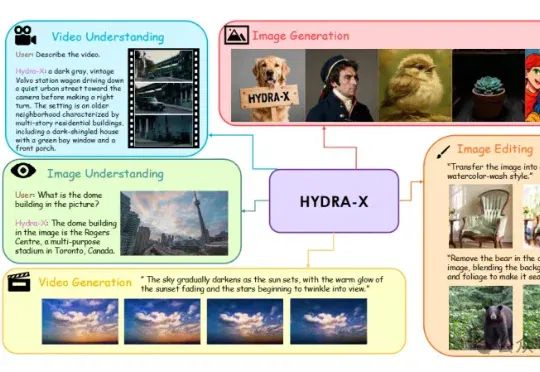
单个tokenizer胜任图像视频理解生成!南大&腾讯混元HYDRA打通多模态统一难题

单个tokenizer胜任图像视频理解生成!南大&腾讯混元HYDRA打通多模态统一难题 (opens in a new tab)

南大王利民团队&腾讯混元的HYDRA系列(HYDRA,HYDRA-X)工作挑战了这个惯例,用一个基于ViT的统一视觉Tokenizer,帮助原生多模态模型更好地“看懂”和“创作”。训练一个基于ViT的Unified Tokenizer,使其同时具有理解和生成的能力,进而同时作为理解和生成的Autoencoder,来支持原生多模态模型(Unified Multimodal Models)的训练。
AI guides
0
有头有脸的大模型公司,集体搞起「匿名公测」

有头有脸的大模型公司,集体搞起「匿名公测」 (opens in a new tab)

渠道选对了,匿名本身就成了一种营销。 最近,海外开发者圈又被一个没有名字的模型刷屏了。 8 月 20 日,OpenRouter 上多了一个叫 Ox Alpha 的模型,100 万 token 上下文、支持图片和视频输入、能调用工具、免费。随后,它被接进 OpenCode、Hermes 等编程 Agent。有人拿它修代码,有人用它跑软件工程基准,还有人盯着 tokenizer 和报错信息,试图猜出它到底是谁家的。 目前,Ox Alpha 的身份还没有得到官方确认。社区最流行的猜测是,它与智谱 GLM-5.x 系列关系很近;依据是 tokenizer、推理模式报错和部分输出习惯的相似性。但这还只是

AI news
0
ICLR 2026 Oral | 大道至简!斯坦福、英伟达、新国立联合推出InfoTok,用信息论重新定义高效视频分词

ICLR 2026 Oral | 大道至简!斯坦福、英伟达、新国立联合推出InfoTok,用信息论重新定义高效视频分词 (opens in a new tab)

在生成式 AI 领域,视觉分词器(Visual Tokenizer)通常采用固定压缩率 —— 无论是单调的监控画面,还是复杂的动作大片,都被切分为等量的 Token。这种 "一刀切" 的做法不仅会造成巨大的计算冗余,也产生了 “信息量” 不同的 Token,不利于下游理解生成任务处理。

AI guides
0
MiniMax海螺视频团队首次开源:Tokenizer也具备明确的Scaling Law

MiniMax海螺视频团队首次开源:Tokenizer也具备明确的Scaling Law (opens in a new tab)

MiniMax海螺视频团队不藏了!首次开源就揭晓了一个困扰行业已久的问题的答案——为什么往第一阶段的视觉分词器里砸再多算力,也无法提升第二阶段的生成效果?翻译成大白话就是,虽然图像/视频生成模型的参数越做越大、算力越堆越猛,但用户实际体验下来总有一种微妙的感受——这些庞大的投入与产出似乎不成正比,模型离完全真正可用总是差一段距离。

AI guides
0
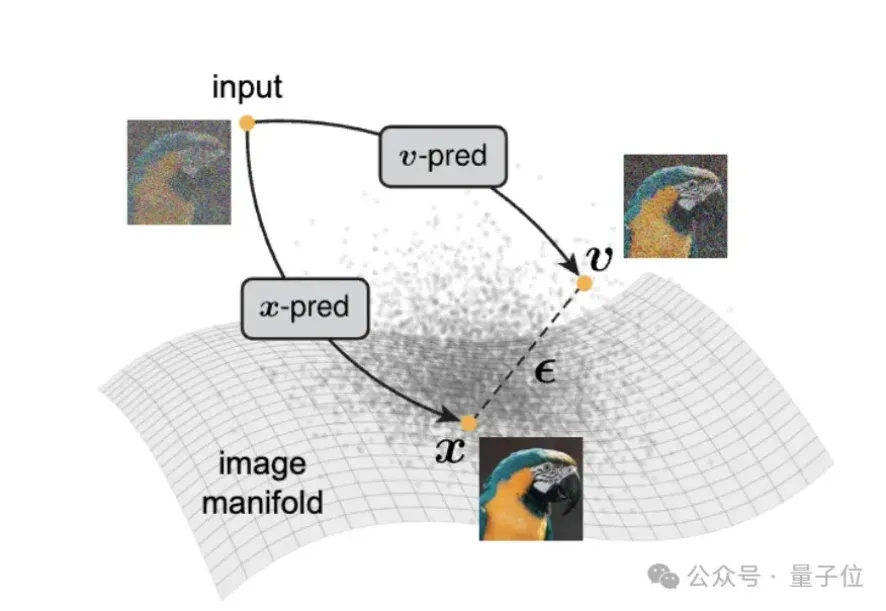
何恺明团队新作:扩散模型可能被用错了

何恺明团队新作:扩散模型可能被用错了 (opens in a new tab)

何恺明又一次返璞归真。 最新论文直接推翻扩散模型的主流玩法——不让模型预测噪声,而是直接画干净图。 如果你熟悉何恺明的作品,会发现这正是他创新的典型路径,不提出更复杂的架构,而是把问题拆回最初的样子,让模型做它最擅长的那件事。 实际上,扩散模型火了这么多年,架构越做越复杂,比如预测噪声、预测速度、对齐latent、堆tokenizer、加VAE、加perceptual loss…… 但大家似乎忘了,扩散模型原本就是去噪模型。 现在这篇新论文把这件事重新摆上桌,既然叫denoising模型,那为什么不直接denoise? 于是,在ResNet、MAE等之后,何恺明团队又给出了一个“大道至简”的结

AI guides
0