DeepSeek开源昇腾基础组件:计算、通信与编译工具同步发布 (opens in a new tab)
DeepSeek开源面向华为昇腾算力平台的基础设施组件,涵盖TileLang编译工具及DeepGEMM、DeepEP、TileKernels、FlashMLA、DeepSelect等计算与通信库,华为亦在CANN社区开源双方围绕昇腾950及超节点的联合创新实践。
Total 4 articles
DeepSeek开源面向华为昇腾算力平台的基础设施组件,涵盖TileLang编译工具及DeepGEMM、DeepEP、TileKernels、FlashMLA、DeepSelect等计算与通信库,华为亦在CANN社区开源双方围绕昇腾950及超节点的联合创新实践。
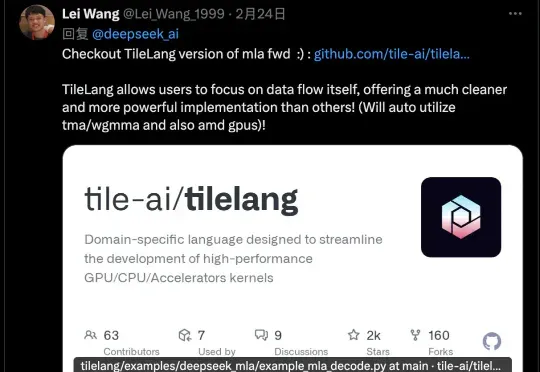
DeepSeek v3.2有一个新改动,在论文里完全没提,只在官方公告中出现一次,却引起墙裂关注。开源TileLang版本算子,其受关注程度甚至超过新稀疏注意力机制DSA,从画线转发的数量就可以看出来。
CUDA又双叒叕被创了… 这回动手的,还是英伟达亲手喂大的AI。 一家成立仅一年的小公司,用AI编程Agent,只花10小时,就搭出了一套「类CUDA软件」。 停停停。 你是说这套英伟达花了近20年搭起来的软件帝国,就这么被复刻了?? 不止如此。DeepSeek也在尝试少写一点底层CUDA。 他们已经开源了一套名为TileKernels的GPU算子库,用TileLang来编写,省去了大量手写底层CUDA代码的工作。 不过类似的「CUDA危机」,咱也不是第一次听了。 每隔一段时间,CUDA都要被拎出来鞭打一番,动辄替代了、击穿了、护城河又被颠覆了… 真的是这样么? 10小时「复刻」CUDA 提起
刚发V3.1“最终版”,DeepSeek最新模型又来了!DeepSeek-V3.2-Exp刚刚官宣上线,不仅引入了新的注意力机制——DeepSeek Sparse Attention。还开源了更高效的TileLang版本GPU算子!